Qwen-Audio-3.1:五个音频模型上线,ASR 降 95% 换了计价单位
解读阿里 Qwen 2026 年 9 月 23 日发布的 Qwen-Audio-3.1:五个音频模型覆盖识别、合成、实时交互与音频创作/理解,本文逐项核对外露规格与可用性,并拆开 TTS 降 70%、Realtime 降 85%、ASR 降 95% 这三个数字各是什么比什么。

2026 年 9 月 23 日,阿里 Qwen 团队发布 Qwen-Audio-3.1 系列1。同一天,千问大模型的官方中文账号给出了同一份清单2:语音识别(ASR)、语音合成(TTS)、实时语音交互(Realtime)三条线各升级一代,另外新增两个模型——做音频创作的 TTS-Next 和做音频理解的 ASR-Next。
把三个数字放回阿里云百炼的官方公告和价目表逐项核对,只有 Realtime 那一项是同一型号调价;ASR 与 TTS 的降幅,是拿新旧两代放在不同的计费单位上比出来的。
五个模型,各自替谁干活
Qwen-Audio-3.1-ASR 管转写。一套模型覆盖 30 种语言和 16 种中文方言,可以按说话人分角色输出「谁在什么时候说了什么」,转写时顺手做润色——去掉语气词与重复、把自我纠正后的句子重组通顺,官方给出的流式识别首字响应约 160 毫秒2。百炼上的
qwen-audio-3.1-asr-flash 输入 0.8 元、输出 2.7 元每百万 token,上下文只有 8192 token,不支持 Function Calling、结构化输出与联网搜索3;面向语音消息与输入法场景的 -message 版支持结构化输出和流式上屏,限流也更高(每分钟 1200 次请求)4。Qwen-Audio-3.1-ASR-Next 换了任务。它要理解的不只是话里的字,还有人物情绪、环境声与机械声,能做声音描述、事件定位、音频问答与推理2。官方评测里它的名字是 Qwen-Audio-3.1-ASR-Flash-Next,接口状态写的是「即将上线」,百炼的模型清单里也还没有它5。
Qwen-Audio-3.1-TTS 的升级落在音色上:同一段参考音色可以跨语言合成,官方把它写成「秒讲数种语言」,情绪、语速、风格用自然语言指令控制12。技术细节来自官方博客:12.5 Hz 的低帧率语音 tokenizer 压低解码开销,语言模型与流匹配模型分五阶段渐进训练,新增 86 个细粒度行内标签(笑声、呼吸、咳嗽这类非语言事件也在其中),支持 16 种语言(7 种为新增)与 20 个中文方言区,单次最长合成 3 分钟,经声码器超分可到 48 kHz6。官方称它在 SEED-TTS-Eval、CV3-Eval 等评测上取得多项最优,并在独立的 Artificial Analysis 语音合成榜上排到第一6。百炼上的
qwen-audio-3.1-tts-flash 输入 1.5 元、输出 12 元每百万 token,同时提供流式与非实时两条接口7。Qwen-Audio-3.1-TTS-Next 把语音合成扩成音频生成:一个模型一次生成人声、音效与环境音,支持多人音色复刻与多轮对话,输出 48 kHz,可以按时间戳安排对白与声音事件的先后2。它在百炼上叫
qwen-audio-3.1-tts-next,输入 6 元、输出 12 元每百万 token,限制也不少——只支持中文与英文、非流式、最大输入 3000 字符、单次生成上限 120 秒(播客场景 240 秒)、参考音频最多 3 条且每条不超过 30 秒,每秒 3 次请求8。Qwen-Audio-3.1-Realtime 保持全双工:边说边听、随时打断,能按语气判断情绪并调整语速与措辞,也能在对话中调用工具去查询或执行任务12。百炼上的
qwen-audio-3.1-realtime-plus 上下文 262,144 token,默认音色 longanqian_v3.1,联网搜索与 Function Calling 不能同时开启9。三个降幅,两种口径
先看能逐项核对的 Realtime。阿里云在 9 月 21 日发布降价通知,北京时间 9 月 22 日 0 点生效,正文只列了两条记录:
qwen-audio-3.1-tts-flash 与 qwen-audio-3.0-realtime-flash10。后者的四项价格全部下调,单位都是元每百万 token:输入文本 3 降到 1.5,输入音频 30 降到 6,输出文本 30 降到 4.5,输出文本加音频 100 降到 12。前者的输入价则从「1 元/万字符」换成「输入 1.5 元、输出 12 元每百万 token」。按百炼对实时语音写明的折算率(一秒音频折 12.5 个 token)5,这次调价把 qwen-audio-3.0-realtime-flash 的音频输入从每小时 1.35 元压到 0.27 元,音频输出从每小时 4.50 元压到 0.54 元。同一型号的这两项分别降了 80% 与 88%,官方把它概括成「约 85%」。
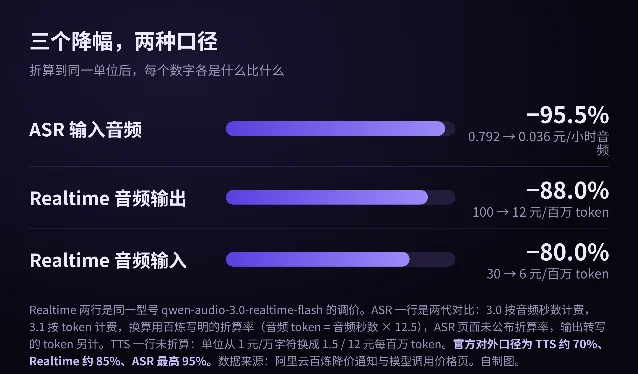
ASR 那一项是两代换口径。3.0 按音频秒数计费,
qwen-audio-3.0-asr-flash 是 0.00022 元/秒,折成每小时 0.792 元,转写内容多少都不影响账单5。3.1 改成按 token 计费,qwen-audio-3.1-asr-flash 输入 0.8 元、输出 2.7 元每百万 token3;输入音频那部分按同一条折算率是每小时 0.036 元,比上一代低约 95%,这大概就是「最高 95%」的来源。输出转写的 token 另算,长转写任务的账单要看说了多少字。这颗折算率本身要留意:百炼只为实时语音模型写明了「一秒音频 = 12.5 token」,ASR 页面没有对应说明,上面这个换算是按同一条产品线的折算率估出来的。TTS 那一项换得更彻底。
qwen-audio-3.0-tts-flash 按输入文本的字符数计费,1 元/万字符,输出不计费;qwen-audio-3.1-tts-flash 改成按输入与输出的 token 分别计费,输出音频的 token 第一次进入账单510。字符与 token 之间没有官方公布的换算关系,输出侧又多出一项,「降约 70%」这个数字我核不到基准。还有一处选型时容易看漏:3.1 的 Realtime 目前只有 Plus 一档,价格与 3.0-Plus 完全相同(文本输入 5、音频输入 40、文本输出 40、音频输出 150 元每百万 token)59。想用 3.1 的实时语音,单价没有变化,那个 85% 落在旧的 Flash 型号上。
把两项降价和两项换口径放在一起,这次「全线降价」的实际形状是:音频账单的计价单位,从「听或说了多久」和「输入了多少字」,换成了「消耗了多少 token」。按时长采购的人会发现 ASR 的每小时成本降到上一代的二十分之一左右;做长转写的人会发现输出 token 第一次要单独算钱。
证据分三档
ASR 的数字要分两档读。公开数据上,官方用 KeSpeech 与 WSYue 的 11 个子集测方言转写与翻译,平均字错误率 4.55%,在其中 6 个子集上最优;另外两组是内部自建的中文方言测试集,16 种方言的平均字错误率 10.38%(11 个子集最优),方言转普通话的平均语义句准率 82.10%(11 个子集中 10 个最优)2。后两组的名次只在这套自建题内成立。
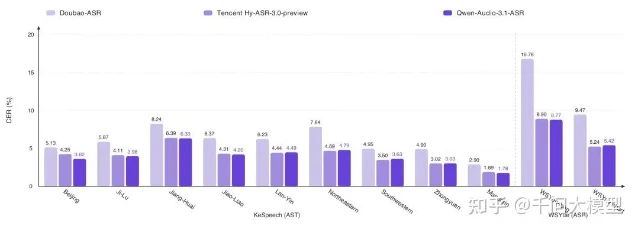
分角色转写的对照更细。在 AISHELL-4、AliMeeting-test、MLC-SLM、MagicData-RAMC 四套公开测试集的 DER 与 cpWER 八项指标里,Qwen-Audio-3.1-ASR-Flash-Next 拿到五项最优、Qwen-Audio-3.1-ASR-Flash 拿到三项,两者都优于官方的 Fun-ASR 级联方案2。以 AISHELL-4 的 DER 为例,两代 3.1 分别是 2.73% 与 3.23%,Fun-ASR 级联是 8.45%,Google 的 Gemini-3.5-Transcribe 是 13.99%2。
第三档只剩措辞。TTS-Next 与 ASR-Next 的能力描述都停在文字上:官方中文稿称两者「基于下代架构」,可核的只有分角色评测表里的名字,没有技术报告,也没有一份公开基准。TTS 的博客页面挂出的论文链接指向的是 7 月 27 日提交的《Qwen-Audio-3.0-TTS》,两段摘要除模型名外基本一致,3.1-TTS 自己的报告我没有找到611。
3.1-Realtime 这半年改了什么
五个模型里唯一有完整技术报告的是 Realtime:9 月 21 日投出、24 日更新到第二版,25 页,署名 Alibaba Token Foundry12。
报告把这一代的改动分成三层。第一层 Think 管听懂与推理,用 Core-Cocktail 监督微调把源文本模型的参数与指令能力接到音频模型上,再用多模态与多教师 On-Policy 蒸馏(报告简称 M²-OPD)从文本教师和冻结的音频参考模型两端给监督,把文字能表达的部分与情绪、语用、声学场景分开授给同一个学生模型12。
第二层 Act 管办事。训练环境由工具池、状态数据库和业务约束三部分组成,种子来自开源工具与 MCP 服务器定义;每个任务有初始状态、用户剧本、预期终态和行为断言,评分按终态、写入权限和行为断言三项依次判,工具报错也算证据。奖励分对话、里程碑、轮次三级喂给 GRPO;拒绝与不支持被单独当成一类正确答案,任务反复失败时先查环境、再考虑留作训练数据12。
第三层 Speak and Coordinate 管什么时候开口。每个工具调用轮被标成必需、禁止或可选,模型可以在工具跑的时候先说一句「正在处理」,但提前声称完成、重复填充和暴露实现细节都会被扣分12。
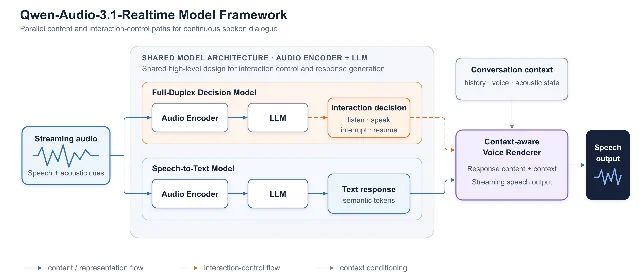
这一代与上一代的关系是延续:3.0 建立了 Core-Cocktail 冷启动与双工交互,3.1 在同一底子上加动作学习与会话策略,报告把它写成「把口语交互从实时回答扩展成在持续对话里理解变化的需求并完成任务」212。
可比的数字来自同一次评测。τ-Voice 的半双工语音转文字改写版上,整体任务成功率从 78.4% 升到 82.0%(零售 72.8% 到 73.7%,航空 64.0% 到 74.0%,电信 90.4% 到 93.9%);语音函数调用基准 SpeechFCEval 从 83.28% 升到 86.00%。EVA-A 上 3.1 是 47.74% 通过率、66.26% 均值,3.0 是 43.10% 与 70.50%——通过率上去了、均值下来了,报告说明这次的会话覆盖范围与上一代不同,只能当描述性结果看。全双工侧,语音转语音的 Full-Duplex-Bench v1.5 上,模型对背景人声的应答率从 73.0% 降到 13.0%,也就是更少去接不该接的话12。
报告自己列了这份证据的边界:评测覆盖面不均匀;双工部分混用公开基准与内部受控集;EVA-A 只覆盖 213 场里的 200 场;没有置信区间、重复随机种子的检验和污染分析;也没有受控消融能把增益分别归给 Core-Cocktail 微调、两条蒸馏路径、环境演化或 rollout 粒度。持久任务的证据来自另一套 Voice Harness 原型,它的前台模型是 3.0,端到端延迟与成本测量都还没有12。
现在能调的,和还在等的
今天在百炼上能调的 3.1 版本是
qwen-audio-3.1-asr-flash、-filetrans、-streaming、-message,qwen-audio-3.1-tts-flash、qwen-audio-3.1-tts-next,以及 qwen-audio-3.1-realtime-plus5;ASR-Next 的状态是「即将上线」2。值得等的有三件。ASR-Next 的接口与它自己的评测数字;TTS-Next 与 ASR-Next 的技术报告,目前只有能力描述;以及百炼会不会把 ASR 的音频折算率写进页面——那决定「降 95%」能不能被使用者自己按小时算出来。
这次的三个降幅里,只有 Realtime 那一项是同一型号的单价下调;ASR 与 TTS 的低价来自计费单位的更换,账单的计量对象从「听或说了多久」变成「消耗了多少 token」。已经按小时或字符做预算的团队,需要重算的是后者。
References
- 1Meet Qwen-Audio-3.1
x.com
- 2Qwen-Audio-3.1:能听懂、能创作、能聊天
zhuanlan.zhihu.com
- 3qwen-audio-3.1-asr-flash 模型信息
help.aliyun.com
- 4qwen-audio-3.1-asr-flash-message 模型信息
help.aliyun.com
- 5模型调用价格
help.aliyun.com
- 6Qwen-Audio-3.1-TTS 官方博客
qwen.ai
- 7qwen-audio-3.1-tts-flash 模型信息
help.aliyun.com
- 8qwen-audio-3.1-tts-next 模型信息
help.aliyun.com
- 9qwen-audio-3.1-realtime-plus 模型信息
help.aliyun.com
- 10【大模型服务平台百炼】部分语音系列模型降价通知
aliyun.com
- 11Qwen-Audio-3.0-TTS
arxiv.org
- 12
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.