GPT-6 Astra开进机器人身体!清华联手无问芯穹等开源RPent,92.6%成功率还快7倍
量子位报道清华、无问芯穹与正行创新联合开源的具身智能体基础设施 RPent:它把大模型规划、VLA 精细操作与三层记忆接到一起,在 LIBERO-PRO 上取得 92.63%,并用任务卡把平均执行时间从 283.6 秒压到 40.9 秒。

转载说明:本文转载自微信公众号「量子位」官方账号(biz_id:MzIzNjc1NzUzMw),原文发表于 2026 年 9 月 21 日 12:42,作者署名「允中 发自 凹非寺 量子位 | 公众号 QbitAI」,原文页注明「本文系量子位获授权刊载,观点仅为原作者所有」。原文链接:[量子位微信公众号原文](http://mp.weixin.qq.com/s?__biz=MzIzNjc1NzUzMw&mid=2247925552&idx=1&sn=5f913fee8d89c1f0fcdd0c6bc7ee6b00),同题文章另见量子位官网 qbitai.com。
大模型已经能在数字世界里连着干活:理解目标、拆解任务、调用工具,再按执行结果调整计划。同一套智能体范式搬到机器人身上,难度就换了一个量级——环境持续变化,状态看不全,一次失败的抓取要重新布置场景,做出去的动作也收不回来 1。
9 月 21 日,由清华大学、无问芯穹、正行创新联合发起的具身智能体基础设施 RPent 正式开源,代码托管在 GitHub 的 RLinf 组织下 2。RPent 把四样东西接在一起:通用大模型的任务理解与规划能力、VLA(视觉—语言—动作模型)等专家模型的精细操作能力、沉淀经验的记忆系统,以及工具与机器人接口,串成从感知、决策、执行到反馈纠错的闭环 1。
量子位原文给出的成绩是:RPent 在 LIBERO-PRO 基准上的任务成功率为 92.6%,端到端任务完成速度优化 7 倍以上 1。这套框架由大规模具身强化学习框架 RLinf 的核心团队打造,背后的算法来自团队 7 月提出的 Harness VLA 工作 3。开源一天后,仓库已有 818 个 star、94 次 fork 和 294 次提交 2。
真机演示:从「会动」到「会做事」
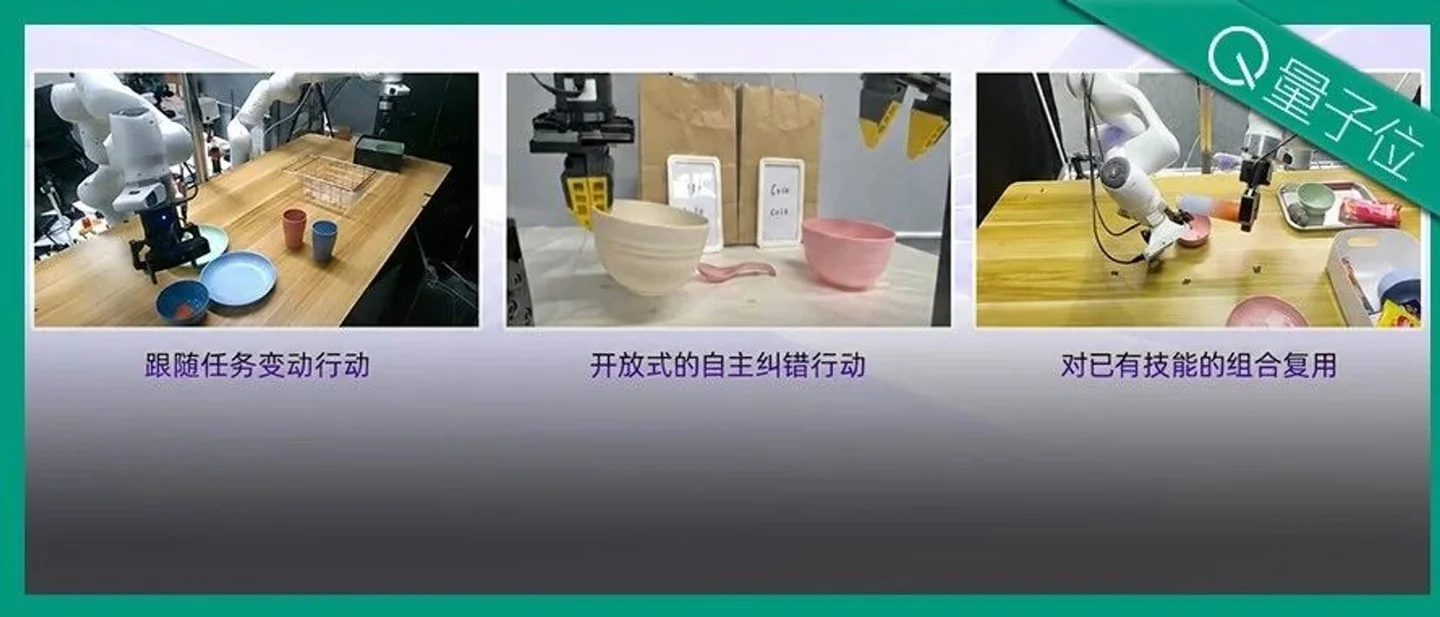
RPent 放出的真机视频里,机器人把钢珠倒进碗里、双臂协同擦盘子,还会主动移开遮挡物,找出藏在碗下的勺子 1。这些任务并没有各自单独训一个专用策略,机器人做的是理解任务、调用已有能力,再根据环境变化调整动作。
三个演示细节能看出它和固定动作序列的差别:
- 把任务换成「将干净餐具放入纸箱」时,冻结的 VLA 沿用了训练时学到的动作,把同一只蓝色盘子放进了金属篮;RPent 先看一遍当前环境,再按新目标挑放置位置,视觉定位出现偏差时还会检查结果、排除错误目标、重新定位手里的盘子。
- 让机器人按瓶身和袋子上的品牌标签分装饮料时,它抓起瓶子会先小幅试抬,确认夹持稳定;原来的运动路径走不通,就调整腕部姿态接着做。
- 目标被碗挡住,它先把两个碗移开,让勺子重新变得可见、可达。
倾倒钢珠用的是原本「拿起并放置容器」的技能,持盘、擦拭和收纳则是把抓取动作与双臂协同、持续接触组合起来。探索成功后,RPent 把验证过的任务逻辑沉淀成任务卡(Task Card);再次执行时启用 Flash Mode 直接复用这套流程,只按当前视觉状态做必要调整,不必每一步都重新调用大模型 1。
两条现成路线各自卡在哪
按原文的梳理,具身智能眼下有两条技术路线 1。
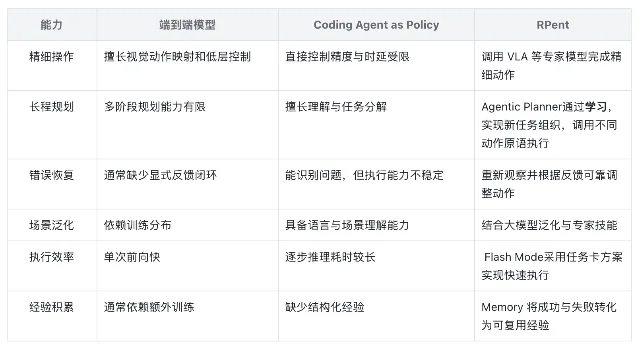
一条是纯 VLA 端到端:用一个视觉—语言—动作模型直接吃下观测、吐出动作,精细操作做得很好,但任务一长、语言一变花、场景被扰动,效果就迅速退化。
另一条是纯大模型 Agent,例如 CAP-X 这类工作。GPT-6 这一代通用模型对具身任务的覆盖率在快速提升,大模型直接输出动作已经能跑通不少任务,短板落在亚厘米级精度、执行时延和「越用越强」这几件事上。
RPent 选择的是分层:通用大模型负责理解任务、制定计划;VLA、WAM 等专家模型负责高精度动作执行;记忆系统沉淀经验;框架负责连接模型、工具与真实环境 1。
四层架构:谁负责想,谁负责做
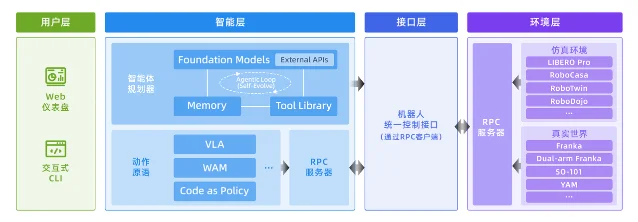
RPent 采用模块化的分层设计,把系统分成用户层、智能层、接口层和环境层 1。
用户层提供类似 Claude Code、Codex 的交互式命令行,另有可选的 Web Dashboard,用来看智能体的推理过程、视觉输入和动作轨迹。
智能层由 Agentic Planner 和 Action Primitive 两部分组成。前者结合基础模型、Memory 与工具库拆解任务,通过 Agentic Loop 完成「规划—执行—反馈—记忆更新」;后者把 VLA、WAM 等学习型操作模型和 Code as Policy 这类程序化技能统一封装成标准工具,让大模型管理解与规划,专家模型管高精度动作。
接口层把智能体的决策翻译成机器人能执行的指令,动作执行、状态读取、环境渲染和设备复位都走统一接口。环境层负责实际执行,目前覆盖 LIBERO-PRO、RoboCasa、RoboTwin、RoboDojo 等仿真环境,以及 Franka、双臂 Franka、YAM、SO101 等真实设备;新增一台机器人,接进
robots/ 目录即可被框架识别调用 1。智能层与环境层跑在各自独立的进程里,模型服务、机器人控制和仿真环境因此可以单独部署、迁移和重启。官方仓库里,仿真与真机的支持状态也列得清楚:LIBERO-PRO、RoboCasa、RoboTwin 标为已支持,RoboDojo 尚未勾选 2。
用 MCP、RPC、MHS 接住物理设备
数字世界里的 Agent 能干什么,很大程度上取决于它能调用哪些工具,MCP 让大模型用一套统一协议访问搜索、代码、数据库等资源。物理世界里的设备各有各的接口:机器人、相机、传感器、仿真器的控制方式不同,同一件事换一台机器人可能就是另一套做法。每接一种设备就重写一套 Agent,智能体很难规模化扩展,RPent 因此用三层接口把智能决策和设备执行分开 1。
- MCP 统一描述可调用的能力。不管底层是 VLA、程序化技能还是别的工具,规划器都按同一套定义来选、来调。
- RPC 连接工具、模型服务与机器人环境,真实设备、仿真平台、本地进程和远程服务可以各自独立部署。
- MHS 面向更广的物理设备提供统一的读写与控制抽象,目标是从机器人扩展到实验仪器、家庭设备和工业系统。
原文用一句话概括这套设计:让智能体像调用数字工具一样调用物理能力 1。在开源仓库里,规划器一端同时支持 Claude Code、Codex 和自定义方案,动作一端则已经接上 Pi0.5、RLDX-1、LingBot-VLA 等模型 2。
记忆:把一次成功变成可复用的经验
物理世界里试错的成本远高于数字环境:一次失败的抓取要重新布置场景,一次错误操作甚至可能损坏设备。经验如果随任务结束就消失,智能体每次都得从零开始。RPent 的 Memory 系统按复用范围把经验分成三层,并为每条记忆记录适用范围、类型、可信度和支撑证据;新经验要经过验证才能提高可信度,相互冲突的记录会被保留和隔离,避免偶然的成功污染已有能力 1。
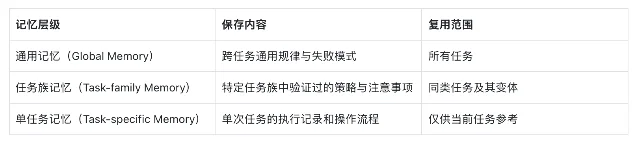
记忆里存的是 Recipe,也就是可迁移的任务方案,而不是某一次执行中的固定坐标。系统记下的是「先根据任务描述和当前画面确认目标,再调整夹爪位置,调用 VLA 完成抓取,并检查抓取结果」这样一段过程;物体位置变了,智能体重新观察环境,再复用同一套逻辑。探索模式下记忆允许更新,评测模式下只读使用已经冻结的经验,演进过程由此变得更可控。
在 LIBERO-Pro Goal 的位置交换任务里,引入记忆机制后,RPent 的成功率从 31.0% 提升到 87.0% 1。记忆资产还支持分发:一个智能体探索出来的经验可以同步给其他智能体。
Flash Mode:少调用一次大模型
大模型的推理速度远慢于机器人动作执行的速度,等模型生成下一步决策,可能成为整个系统的主要延时来源。RPent 的思路是减少不必要的调用——大量机器人任务的目标和执行逻辑相对稳定,变的往往只是位置、姿态和环境状态,每次都从头规划会产生大量重复推理 1。
探索阶段,规划器可以调用大模型、VLA 和程序化技能尝试不同动作组合,成功且经过验证的流程被压缩成任务卡。任务卡保存的是任务阶段、动作原语、关键目标和检查条件,不保存只在一次场景里可用的固定坐标。进入 Flash Mode 后,系统优先按任务卡执行,视觉模块重新定位关键物体,执行模块按当前状态调整动作;只有检查失败、环境偏离或流程走不下去,才重新调用规划器。
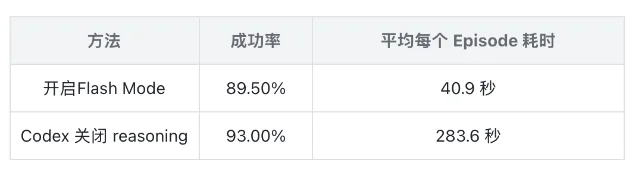
在 LIBERO Object 的 200 次评测里,Flash Mode 把平均执行时间从 283.6 秒降到 40.9 秒,成功率则从 93.00% 降到 89.50%,大约 7 倍加速换来 3.5 个百分点的成功率 1。
榜单上的成绩,要连着配置一起看
榜单上的最好成绩来自规划器用 Codex、基座模型换成 GPT-6 Astra 的配置。在更强调指令变化、布局变化和长程执行的 LIBERO-PRO 上,这个组合拿到 92.63%,比第二名 Claude Code 加 Opus-4.7 的 82.4% 高出 10.23 个百分点,比 π_RLinf 的 50.0% 高出 42.63 个百分点 1。
官方文档把 92.63% 背后的口径写得更细:这个总成绩是 800 次评测中的 741 次成功,由两组互不重叠的批次合并而来——Long 套件 157/200,其余六套 584/600,各套件用的是自己探索后冻结的记忆快照,评测期间不更新 4。同一份榜单上,Flash Mode 配 Molmo2-8B 是 72.63%,纯 VLA 方案 π0.5 是 11.0%、AtomVLA 是 6.3%。
另外三个环境的成绩:
| 环境 | 领先配置 | 成功率 |
|---|---|---|
| RoboCasa365 Target50(厨房长程任务) | Codex + GPT-6 Astra | 59.20% |
| LIBERO | Claude Code + Opus-4.7 | 96.0% |
| RoboTwin | Codex + GPT-5.5 | 62.4% |
表格中的成绩取自 RPent 官方文档榜单;原文另给出两组对照:RoboCasa365 Target50 上,GPT-6 Astra 组合高于 GPT-5.5 组合的 57.1%,也高于小米 Xiaomi-Robotics-1 的 57.4%;LIBERO 上 Opus-4.7 组合的 96.0% 排在 AtomVLA 的 97.0% 之后;RoboTwin 上 GPT-5.5 组合高于 Opus-4.7 组合的 58.4% 与 LingBot-VLA 的 50.4% 4。
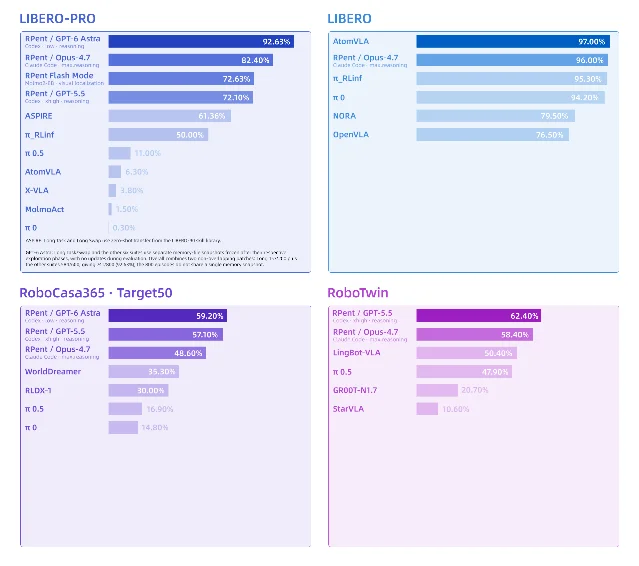
原文据此给出的判断是:结果值得关注的地方在于通用模型、专家模型、工具和记忆系统能在同一个框架里协同,而不是某一个模型单独完成了全部控制 1。
这套基础设施想解决什么
机器人要在真实世界里干活,得看见环境、理解任务、调用不同能力、完成精细动作,还要根据反馈调整策略,并把验证过的经验留下来。原文把 RPent 定位成连接模型、工具、机器人与环境的智能中枢,支撑智能体在真实世界中持续运行、积累经验并递归演进,用一句话收尾:从一次任务,到一类任务;从一次执行,到持续进化 1。
这里面还有几件事原文没有给出答案:真机演示的任务数量有限,记忆资产在不同机器人之间的迁移效果、长时间连续运行下的稳定性,以及这些成绩搬到真实产线上的表现,都还没有公开数据。
想自己核对的,原文是量子位公众号 2026 年 9 月 21 日 12:42 发布的《GPT-6 Astra 开进机器人身体!清华联手无问芯穹等开源 RPent,92.6%成功率还快 7 倍》,量子位官网有同题文章;项目代码在 GitHub RLinf/RPent,算法出自论文 Harness VLA,各环境的完整成绩与评测配置见官方文档榜单。
References
- 1GPT-6 Astra开进机器人身体!清华联手无问芯穹等开源RPent,92.6%成功率还快7倍
mp.weixin.qq.com
- 2
- 3
- 4RPent 评测成绩 - RPent 中文文档
rpent.readthedocs.io
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.