MiMo-V2.6 工具调用复读复盘:洪泛被 RL 放大到 24.6%,修法从 231 万美元换成 9 万
解读小米 MiMo 2026 年 9 月 27 日的工具调用复读复盘:奖励只看正确率时,低于 32 次阈值的洪泛怎样被 RL 从 11.1% 放大到 24.6%,以及官方为什么放弃 231 万美元的阈值方案、改用一条 9 万美元的特化教师路线。

2026 年 9 月 27 日,小米 MiMo 团队挂出一篇官方复盘《Diagnosing and Mitigating Tool-Call Repetition in MiMo-V2.6》,中文版叫《MiMo-V2.6 工具调用重复问题复盘》12。中文版的副题把这件事定成一个训练问题:Scaling RL 过程中的必经之路,reward 关注正确率的「奖励盲区」。
它要修的行为是模型在智能体场景里反复发起相同或高度相似的工具调用。MiMo-V2.6 上线后,这个问题在 MiMo Desktop、MiMo Code、OpenCode 这些场景里被用户撞上:工具一直在跑,上下文一直在涨,任务却推不动2。
同一天挂出来的还有两个权重仓:MiMo-V2.6-Pro-MOPD 与 MiMo-V2.6-Flash-MOPD,创建时间分别是北京时间 9 月 27 日 11:58 与 12:01,许可写着 MIT,仓库标签里标着 FP8345。两者都进了 MiMo-V2.6 的模型集合,名字带
MOPD 后缀,与原来的 RL 后缀并列6。模型在 API 平台上的更新比这批权重更早,官方说从 2026 年 9 月 25 日 06:00(UTC+8)起就已经生效,模型名保持 mimo-v2.6-pro、mimo-v2.6-flash 不变;作为对用户的道歉,官方重置了 MiMo Desktop 当前用量窗口的剩余额度1。这篇复盘接在 9 月 22 日那次 MiMo-V2.6 首发之后。那次官方公开了一次不到六天、30 步的 RL 运行的成本构成,并说明为什么全程冻结 MoE 路由;这一次公开的是同一次 RL 顺手训出来的一个副作用,以及补救它花掉的钱7。
三种行为要分清,而表里的 0.05% 只是下界
官方先把三个容易混的行为摆开2。并行工具调用是提高效率的正常方式:一次读几个相关文件、同时跑几个互不依赖的查询,即使都走同一个工具,只要服务的信息需求不同就不算复读。工具调用洪泛(tool-call flooding)指集中发起的调用数量明显超出任务需要,或超出执行环境能有效处理的范围,后果是执行排队和反馈堆积。工具调用复读指缺乏合理必要性的重复:可用信息和环境状态没有实质变化,也没有合理重试或复核的需求,模型仍然不断生成语义相同或高度相似的调用。失败之后的重试、必要的状态轮询、改完代码再跑一次测试,都排除在复读之外。
要稳定地自动判定「语义相同或高度相似」,代价很高。官方改用了一个更窄但能回放的口径,叫单轮内精确重复2。单位是同一个 assistant 轮次里、模型还没收到任何工具反馈的那批调用;两个调用的工具名相同、参数经 JSON 规范化之后完全一致,就算重复。设这一轮的调用总数是 N、去重后剩 U 个,比率就是 (N − U) / N。
这个口径站得住的原因有两个。同一轮内的调用之间没有工具反馈,重复就难以用「拿到结果后重试」解释;单轮输出可以逐条回放,别人能照着复现。它量不到的地方也有三块:拿到反馈之后在后续轮次里重发同一操作、或者循环跑同一组操作的跨轮重复;参数改了一点但信息需求没变的近似重复;以及 code-mode harness 下的调用,模型对外只发一个
exec 工具,真正的调用藏在脚本里,统计只看到 exec 这一层2。官方因此把 (N − U) / N 标注成可观测复读的下界,完整的复读率比这个数更高。按这个口径,RL 阶段两个模型在不同 harness 上的复读率是:
| Harness | MiMo-V2.6-Flash-RL | MiMo-V2.6-Pro-RL |
|---|---|---|
| OpenCode1 | 1.02% | 0.54% |
| MiMo Desktop1 | 0.19% | 0.19% |
| Claude Code1 | 0.27% | 0.10% |
| OpenClaw1 | 0.17% | 0.08% |
| Codex1 | 0.23% | 0.07% |
| MiMo Code1 | 0.11% | 0.07% |
| DeepSeek Harness1 | 0.17% | 0.07% |
| Hermes1 | 0.16% | 0.05% |
| Zcode1 | 0.07% | 0.05% |
这张表的读法有两处。官方另有一句内部测试的整体水位:response 级别的复读率超过 0.05%1。表里最低的一格恰好是 0.05%,最高的 1.02% 在 Flash 跑 OpenCode 时出现,两者差了二十倍。同一个模型换一套 harness,复读率就能差这么多,这张表最值得记住的是这一行跨度。
惩罚只管到 32 次以上,下面那一截被训大了
发现问题之后,官方去看 RL 里的既有规则,并且看到一处自己埋下的边界。原来的做法是:rollout 过程里如果某一轮的工具调用超过 32 次,就提前终止这条 rollout,把 reward 直接置 0;做梯度更新时,前序轮次被 mask 掉,惩罚只落在触发规则的那一轮,范围覆盖该轮的全部 token,包括思维链 token2。
问题出在阈值的位置。官方把已经出现过复读的内部测试样本回放到训练的不同阶段(step 0、5、10、15、20),看同一批样本上这些行为的复现率2。Flash 的回放样本里,仍然出现洪泛(单轮超过 10 次调用)的比例在 step 0 就已经有 11.1%,到 step 20 攀到 24.6%;按 harness 拆分,MiMo Code 一开始就有 30.6%,训练后期放大到 41.7%。
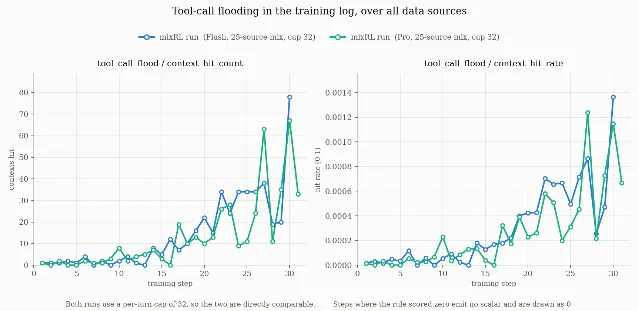
口径要跟着这个数字一起记。这批样本是先按复读筛出来的,所以 11.1% 到 24.6% 说的是「在已经有复读迹象的样本上,洪泛随训练被放大」,它量的是放大趋势,它的绝对值代表不了全体请求的洪泛率2。
放大为什么能发生,官方给的是一条与阈值有关的相关证据,并且自己把措辞留在了推测上。他们在 Flash 训练 trace 的一个数据源上统计「单轮超过 8 次调用」的轮次占比,看到它在 step 0 就有一小部分、随后一路爬升;32 次这条线以下的行为不会触发任何惩罚,于是随着训练继续被放大,最后长成越过 32 次的严重洪泛2。官方在同一段里也写明,洪泛 trace 里可能伴随重复或高度相似的调用,而这一段量的是调用次数的异常增长,两者在官方那里始终分开。这条区分对读后面的数字有用:被放大的是调用量,复读是它可能带来的一种后果。
奖励机制为什么放过这一段,复盘给的答案是「奖励盲区」:奖励看的是任务最终做对没有,而一个用了 59 次工具调用才把任务做对的轨迹,只要最终判对,照样拿到那份奖励。中间那些无效的等待与上下文消耗,落在奖励函数覆盖不到的范围里。
最直接的那条修法,算了账之后被否掉
最直接的回应是把阈值调严。官方在一个独立的小数据源上做了一次实验:把触发惩罚的门槛从单轮 32 次收到 8 次,从 MiMo-V2.6-Flash 的 step 28 检查点恢复训练2。单轮超过 8 次的轮数明显下降,整体 reward 也没有出现明显损失,说明这条路确实能压住洪泛;代价是效果要等约 20 步才逐渐显现。
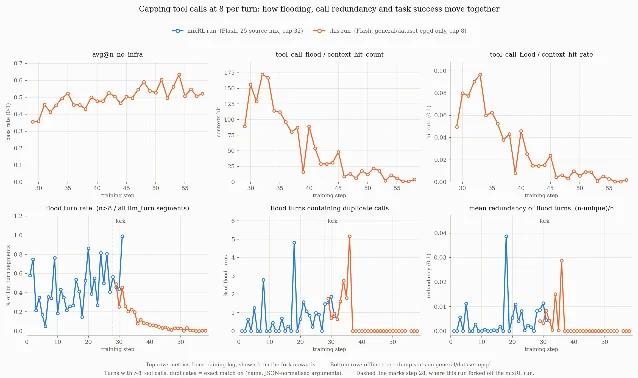
general/dataset-epqd 的离线 trace 统计在约第 37 步降到 0,上排训练日志里的命中计数与命中率要到约第 48 步才接近 0——「约 20 步才见效」说的是上排这一组1。这一步的账决定了它的命运。要把这个改动用到全量,等于重启 20 步 MixRL,官方估算的成本是约 231 万美元2。这个数覆盖哪些 run,官方没有明说;按整场 30 步 MixRL 的 Pro 约 262 万美元加 Flash 约 85 万美元、合计约 347 万美元折算 20/30,得到约 231 万美元,两者接近——这个折算口径是本文自己算的,官方只写了「重启 20 步」这两个条件7。
更麻烦的是泛化。官方用收紧阈值后的几个检查点回放内部测试数据,复读率从 13.45% 降到 3.83%,复读现象仍然存在2。这张表本身有四个格子,正文引的是样本量最大的那一格:
| 检查点 | 测试集 1 · 历史 0 | 测试集 1 · 历史 1 | 测试集 2 · 历史 0 | 测试集 2 · 历史 1 |
|---|---|---|---|---|
| flash-ga-grpo-s301 | 2.27%(1/44) | 28.57%(4/14) | 13.45%(30/223) | 25.00%(13/52) |
| flash-ga-grpo-s351 | 9.30%(4/43) | 33.33%(5/15) | 7.86%(18/229) | 17.65%(9/51) |
| flash-ga-grpo-s401 | 11.11%(5/45) | 33.33%(5/15) | 4.58%(11/240) | 17.86%(10/56) |
| flash-ga-grpo-s451 | 0%(0/45) | 28.57%(4/14) | 4.40%(11/250) | 11.67%(7/60) |
| flash-ga-grpo-s501 | 0%(0/43) | 28.57%(4/14) | 3.83%(9/235) | 16.98%(9/53) |
这张表值得逐列看一眼,因为它比正文那句话说得更多。13.45% 到 3.83% 只出现在测试集 2 · 历史 0 这一列——它也是分母最大的一列(223 到 235 条)。同表另外三列的走向不一样:测试集 1 · 历史 0 在 s35、s40 反而升到 9.30% 与 11.11%,到 s45 才回到 0;测试集 1 · 历史 1 一路停在 28.57%,分母只有 14 到 15 条,一两个样本变动就能让这个百分比大幅跳动;测试集 2 · 历史 1 从 25.00% 降到 16.98%,同样没有走完。
还有一处官方没有点出来、数据里却摆着的读数。「历史 1」指回放请求的可见历史里已经有一轮出现 ≥10 次调用;把这四列横向比一比,每一行里历史 1 的复读率都明显高于历史 0:13.45% 对 25.00%、3.83% 对 16.98%、2.27% 对 28.57%1。上下文里已经出现过一次洪泛,会让复读更容易再发生一遍。这条读法对做长程智能体的人有直接用处:一段被污染的上下文本身就是风险因素。
被采用的方案:先训一个只关心这一个行为的教师
第二条路把问题从环境规则搬到了训练信号上。官方先训一个单轮的特化 RL 教师,奖励只有两档:发生复读给 0,既没有复读、也没有错误的工具调用行为给 1;同时加一个 KL 损失,把这个教师拉在原来的 RL 模型附近2。训练只走了 12 步,大约 7,000 条样本,回放样本内外的复读率就降到 0。这里的「0」指的是回放集上的 0,也就是训练集与留出集的复读样本;生产环境里的复读率是热力图上的读数,后面会讲到。
教师的用法是把它的行为蒸馏进主模型。官方把 final run 的 MOPD 训练回退了 5 步,引入这个复读特化的教师,用 teacher-prefix 方式的 OPD 继续训练2。技术报告 §5.6 给这套蒸馏一个更长的名字:Multi-Prefix Multi-Teacher On-Policy Distillation(MOPD2),它是更早的 MOPD 的扩展,把三路数据接在同一次更新上8。
三路的区别在于前缀从哪来,以及谁给打分。Standard MOPD 让 mixRL 教师监督学生完整的自主 rollout。Teacher-Prefix OPD 的前缀来自教师 rollout:一条有 k 个 assistant 轮次的轨迹给出 k 个历史前缀,学生只从每个前缀生成一个新的轮次,教师在同样的历史下对学生写出的这一段做 token 级打分。SFT-Prefix OPD 的前缀来自 SFT 演示,演示提供历史,学生自己写后续。这场复读修复走的是第二路38。
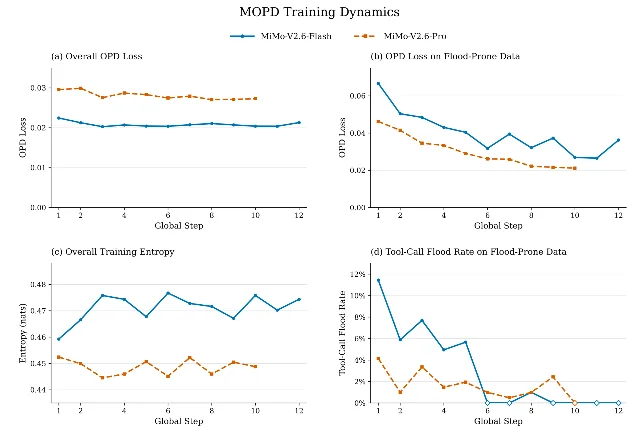
为什么这条路更便宜,答案在问题的作用范围上。阈值方案改动的是环境规则,要动就得把整场 MixRL 重跑一遍,成本摊在全部训练上;蒸馏方案只训一个窄任务的教师,再把它并回主模型,成本只落在需要的那一段。官方给出的整次训练成本是约 9 万美元,并把它写成上一个方案 MixRL 训练成本的 4%2。这个 4% 的分母是那条被否掉的路线(约 231 万美元):90,000 ÷ 2,310,000 ≈ 3.9%。换个分母会算出不同的数——按整场 30 步 MixRL 的约 347 万美元算,这个比例会落到 2.6%,读的时候要分清官方指的是哪一个。
停止这件事发生在一个位置上
复盘里有一组读数把机制拆到了单条轨迹的 token 层面。官方从 RL 的轨迹里抽了一个样例,修复前的模型在这条轨迹上连续发了 59 次工具调用才输出结束符2。
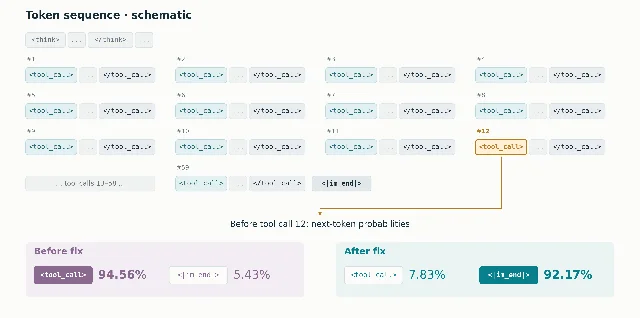
单个位置的概率只说明这一步,官方另外算了整条轨迹上的累计停止概率 F_k = 1 − ∏(1 − p_i),i 从 1 到 k,含义是模型在这一轮调用数低于 k 个工具时停下来的概率2。修复后的模型在 8 次调用以内停下的概率是 99.87%,并且在第 5 到第 20 个调用位置上每一步都有强烈的停止意愿;修复前的模型累积到第 8 次只有 0.32%,累积到第 59 次也才到 53.72%1。
这组概率比较的是那个特化教师与修复前的策略,教师是经过 12 步单轮 RL 训出来的。上线的 MOPD 模型能把这种停止倾向保留多少,由后面那组热力图回答,数字的量级完全不同。
上线之后,热力图上还剩多少
最终效果给在两张热力图里,横轴是输入长度分档,纵轴是 harness,左幅是 MOPD 之前、右幅是之后1。
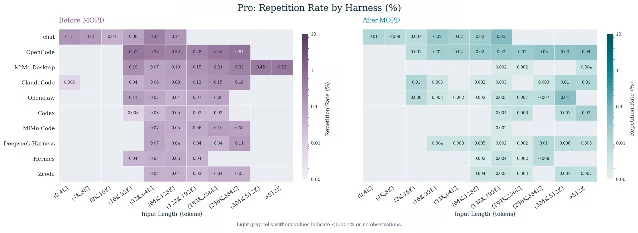
修后的复读率大幅下降;前文那个降到 0 的读数属于特化教师,上线的模型在这里留下的是很小的非零值。同一张图也说明另一件事:复读率原本随输入长度上升,修前在长上下文一侧最高,修后这条随长度抬头的趋势被压平了——对做长程任务的人来说,这一点比总平均值更有意义。
另外两句要按它们实际的证据强度读。官方写「除了复读以外 benchmark 也持平(不降智)」,中文版和权重卡都只给了这句结论,没有附表、没有数字2。这句话的方向可信,力度比同篇其他读数弱,要拿它对外说话之前最好先在自己的评测上核一遍。再看这个行为在报告里的位置:技术报告 §6.1 描述了 Penalty Module 与其中的组合式 early stop 策略,§4.3.3 写的是实际应用的两类惩罚——组内相对长度惩罚,以及针对格式错误与工具调用错误的分段行为惩罚;至于「单轮超过 32 次」这个具体数值,只出现在博客里,报告没有给出8。
要动手的人还有两件事需要知道。两个新检查点已经在 Hugging Face 上,许可 MIT、权重量化格式标 FP8,推荐采样是温度 1.0、top_p 0.95;部署配方里 SGLang cookbook 与 vLLM recipe 两个链接仍指向 MiMo-V2.5 的页面,镜像名也还是
mimov2539。撰写时两个 MOPD 仓的下载量与点赞数都还是 0,第三方复现要等5。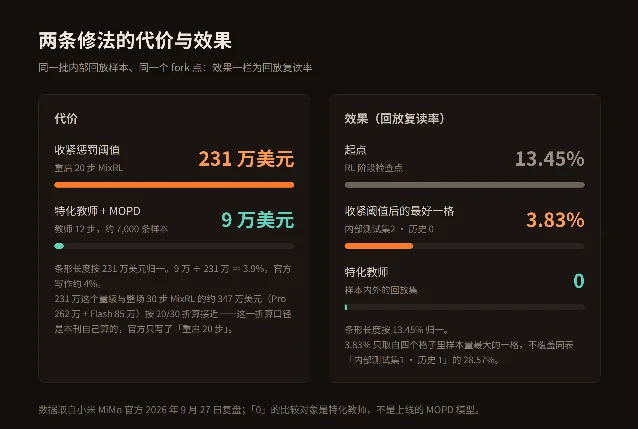
可以带走的三个检查动作
第一件事在阈值上。这场复读的漏口是通过量「阈值以下的量有多少」找到的——官方去数了单轮 8 到 32 次之间那一段的占比,看到它在训练里一路爬升,才判断出规则放过了正在长大的那一截2。任何一条只在上界拦一下的规则都有同样的问题:拦得住极端值,放过了正在向极端值靠近的那一段。给自己的惩罚项量一次阈值以下那一段的分布,是这场事故里最便宜、也最不依赖规模的一步。
第二件事在指标上。单个位置上的 top-1 概率只说明那一步,累计停止概率 F_k 才能说明模型在一整条轨迹上的停止倾向;修复前那条轨迹在第 8 次调用处累积停止概率只有 0.32%,这个数比任何一格的 top-1 都更能说明「它不知道什么时候该停」1。如果自己的 agent 也出现过该停不停,这个指标可以直接照搬,它只需要一条轨迹上的逐位置概率。
第三件事在诱因上。这段材料里被放大的那个行为,落在奖励函数既不给分也不扣分的位置上——任务最终做对,中间那些工具调用的消耗就不进账。这类行为的共同点是它能让相关指标都看起来正常,工具在跑、结果可能也对,付出的只是延迟和上下文。把「自己的奖励覆盖不到但成本真实存在」的行为列出来核对一遍,是这场复盘能给出的一般方法;官方在结尾写明,希望这篇复盘能为分析和解决 RL 过程中这类问题提供启发2。
这一版还没有回答的
References
- 1Diagnosing and Mitigating Tool-Call Repetition in MiMo-V2.6
mimo.xiaomi.com
- 2MiMo-V2.6 工具调用重复问题复盘
mimo.xiaomi.com
- 3XiaomiMiMo/MiMo-V2.6-Pro-MOPD
huggingface.co
- 4XiaomiMiMo/MiMo-V2.6-Flash-MOPD
huggingface.co
- 5Hugging Face 模型接口:XiaomiMiMo 按创建时间排序
huggingface.co
- 6MiMo-V2.6 collection
huggingface.co
- 7Introducing MiMo-V2.6 series
mimo.xiaomi.com
- 8MiMo-V2.6 技术报告 §5.6
huggingface.co
- 9SGLang MiMo cookbook
docs.sglang.io
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.