Diffusion Controller:冻结扩散主干加 1200 万参数侧网络,在监督微调与奖励加权上超过 LoRA
解读 Google Research 2026 年 9 月 29 日官方博客与配套论文《Diffusion Controller》:把扩散模型的引导与微调统一成一道控制问题,推导出的侧网络在 Stable Diffusion 1.4 上只训 1200 万参数就超过了 LoRA;本文同时拆开它的两把评测尺子与灰盒接口的真实要求。

9 月 29 日,Google Research 在官网博客发了一篇《How Diffusion Controller unifies and simplifies AI image generation》,署名两位软件工程师 Chih-wei Hsu 和 Moonkyung Ryu;页面日期是 9 月 29 日,RSS 里这一条的发布时刻是北京时间 9 月 30 日凌晨 2 点 38 分12。它写的是一篇更早的论文:《Diffusion Controller: Framework, Algorithms and Parameterization》,3 月 7 日提交到 arXiv,只有 v1,第一作者 Tong Yang 的主页把它列在 ICML 2026 名下34。
这篇工作的落点很具体:把预训练的扩散模型完全冻住,只训一个 1200 万参数的侧网络,由它把每一步的输出往奖励高的方向推一点。作者在 Stable Diffusion 1.4 上跑了三条微调路线,侧网络在监督微调与奖励加权两条路线上,对预训练模型的 HPS-v2 胜率都超过了 LoRA;PPO 这条路上反过来落后。
要压住的取舍
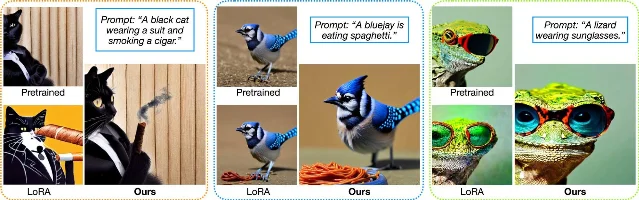
博客开头的例子是「一只戴墨镜的蜥蜴」。模型可能给出一只逼真的蜥蜴却没有墨镜,也可能为了戴上墨镜把蜥蜴的脸拧变形1。作者要处理的取舍就在这里:把提示词里的约束压进去,画面本身容易跟着塌。
他们把现有的工具箱分成两堆。一堆在推理期动手,调的是文本提示词对生成过程的影响力,代表做法是 classifier-free guidance1。另一堆在训练期动手,用 LoRA 这类参数高效的适配器、奖励加权回归或者策略梯度去改模型的行为1。两堆方法各有各的目标函数,凑在一起用时靠经验试。
把去噪过程写成一道控制问题
扩散采样是一串逐步去噪的步骤:模型从纯噪声出发,每一步预测一点噪声、往前走一步,最后停在图上。论文把这串过程改写成一道受控的马尔可夫决策过程,控制量落在每一步的转移分布上5。
作者用的架子是线性可解马尔可夫决策过程(linearly-solvable MDP)。控制做的事,是给预训练模型原本的转移核乘上一个指数权重,把它往奖励高的方向掰;掰出去多远,按 f-散度收费,正则强度 τ 决定这股拉力有多强。这个收费项把两股相反的力压进同一个式子:目标驱动的那部分,和「别离预训练模型太远」的那部分。
从这道题的最优性条件出发,作者导出两类可以直接落地的微调更新:一类是带 f-散度正则的策略梯度,其中包含 PPO 式的裁剪规则;另一类是奖励加权的回归目标,在 KL 散度下,作者证明它与原问题有同一个极小值点5。
这两类更新把已经在用的做法收进了同一条谱系。DDPO 对应 τ 取 0 时的策略梯度,DPOK 对应加了 KL 正则的版本;Lee 等人与 Fan 等人算法 2 里的加权回归把奖励本身当作权重;Uehara 等人给出的指数加权就是论文的式(20)5。把一批看上去各不相关的经验做法放回同一个式子里,是这篇论文声称的第一个贡献5。
三条路线在实验里的设置写得很细。监督微调用 HPD v2 里的胜出图像与提示词,批大小 128、跑 1000 步;奖励加权拿 HPS-v2 当奖励模型,批大小 64、跑 2000 步,正则系数取 5×10⁻⁴;PPO 也用 HPS-v2 当奖励,批大小 64、跑 2400 步,KL 正则系数取 10⁻⁴。三套都冻住文本编码器与 VAE,只训潜空间的分数函数,采样时 CFG 引导强度固定为 7.55。
最优解的形状:预训练项加一个门控修正
工程上更有用的一步在参数化。在 KL 正则的情形下,作者推出最优分数函数的形状:它可以写成预训练分数的一份加权,再加上一个由当前含噪图像、修正项 h 和门控 z 组成的修正项;h 和 z 的对数几率都能表示成同一组傅里叶特征 φ 的线性组合,而这组特征只通过逆向均值 μ₀ 依赖当前的含噪图像5。对含噪图像的依赖全部从 μ₀ 这一个口子进来。
这条推导给出一个直接的工程结论:修正网络应该以 μ₀ 为输入,输出拆成一个标量门控和一组修正通道,再接回预训练分数。论文把它写成 ϵ_θ = ϵ₀ + λ·s_θ(μ₀, c, t),λ 是推理期的引导强度,生成时可以调5。
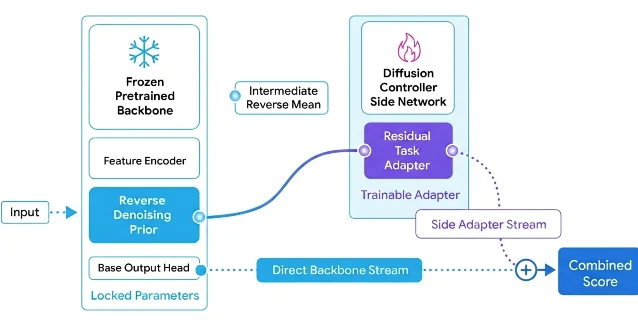
侧网络本身是一个轻量 UNet,跑在 64×64 的潜空间上,编码器两个下采样块、解码器两个上采样块、中间一个带交叉注意力的块;末层权重初始化为 0,训练第一步的输出因此与预训练模型完全一致5。
这套设计的卖点是访问级别:主干可以完全冻住,只靠读它每一步的中间输出就能把侧网络训出来5。论文把这种情形叫灰盒,并为它划了边界。
| 访问级别5 | 能看到什么5 | 论文里的对应方法5 |
|---|---|---|
| 白盒 | 可以改动主干内部的参数 | DiffCon-J 与 DiffCon-S:另外插入 LoRA,与侧网络一起训或者分开训 |
| 灰盒 | 主干封住,但能读到逐步去噪的中间量,例如每一步的噪声预测或逆向均值 | DiffCon:侧网络以逆向均值 μ₀ 为输入 |
| 黑盒 | 只有文本进、图像出 | 论文没有给出可行的做法 |
博客正文把封闭的商用模型笼统称作黑盒或者灰盒,并说这套侧网络可以贴上去1。论文自己的灰盒定义要窄一些:主干封住,但必须能读到逐步去噪的中间量,侧网络才有输入的来源。实验里对得上的模型只有 Stable Diffusion 1.4 这一个。
同样 1200 万参数,接法不同差出 10 个百分点
论文里最能说明这套推导有用的,是 DiffCon 与 DiffCon-Naive 的对照。两个网络共用同一个 UNet 骨干,参数量都是 1200 万,三套训练算法完全一样5。差别只有两处:喂进去的是逆向均值 μ₀ 还是含噪图像 x_t;输出是带门控的控制器形式,还是一个直接加到预训练分数上的残差5。
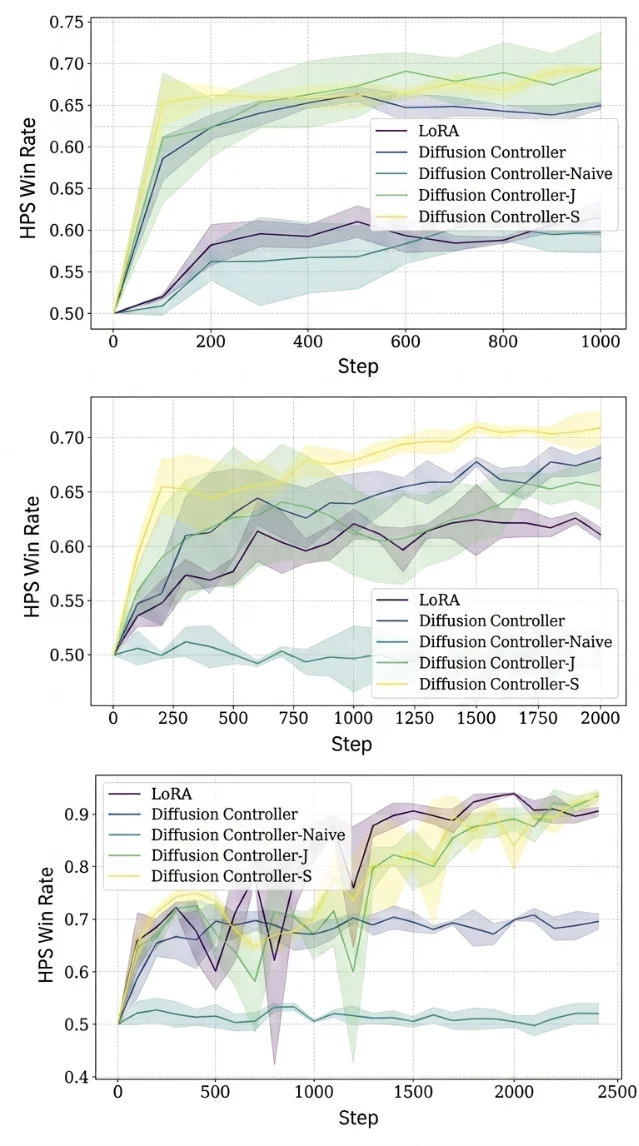
结果在三条路线上都拉开。监督微调上,带门控的 0.6667 对 0.5655,差 10.1 个百分点;奖励加权上 0.6815 对 0.5060,差 17.6 个百分点;PPO 上 0.6957 对 0.5201,差 17.6 个百分点,衡量的都是对预训练模型的 HPS-v2 胜率5。参数一个没加,涨的是推导出来的接法。
成绩单上有两把尺子
| 方法5 | 参数量5 | 访问级别5 | 监督微调5 | 奖励加权5 | PPO5 |
|---|---|---|---|---|---|
| 预训练模型 | — | — | 0.500 | 0.500 | 0.500 |
| DiffCon | 1.2×10⁷ | 灰盒 | 0.6667 ± 0.0028 | 0.6815 ± 0.0111 | 0.6957 ± 0.0152 |
| DiffCon-Naive | 1.2×10⁷ | 灰盒 | 0.5655 ± 0.0165 | 0.5060 ± 0.0190 | 0.5201 ± 0.0203 |
| LoRA | 1.7×10⁷ | 白盒 | 0.5766 ± 0.0137 | 0.6109 ± 0.0059 | 0.9048 ± 0.0084 |
| DiffCon-J | 1.6×10⁷ | 白盒 | 0.6964 ± 0.0293 | 0.6555 ± 0.0210 | 0.9353 ± 0.0079 |
| DiffCon-S | 1.6×10⁷ | 白盒 | 0.6964 ± 0.0018 | 0.7091 ± 0.0155 | 0.9315 ± 0.0164 |
± 后面是标准差。
博客说灰盒侧网络在监督微调与奖励加权两条路线上超过了 LoRA,表 1 里的数字与这句话对得上:0.6667 对 0.5766,0.6815 对 0.61091。博客还说这个成绩是在「改动的内部层数明显少于 LoRA」的前提下拿到的,论文表 1 给的可比口径是参数量,1200 万对 1700 万15。
PPO 上出现反转:灰盒 DiffCon 拿到 0.6957,LoRA 拿到 0.90485。博客把「超过 LoRA」这句话限定在监督微调与奖励加权两条路线上,与表里的数字对得上1。博客里那个「完全解锁的版本对基线取得 90% 胜率」的说法,对应的是白盒的 DiffCon-J 与 DiffCon-S,两者在 PPO 上分别是 0.9353 与 0.931515。
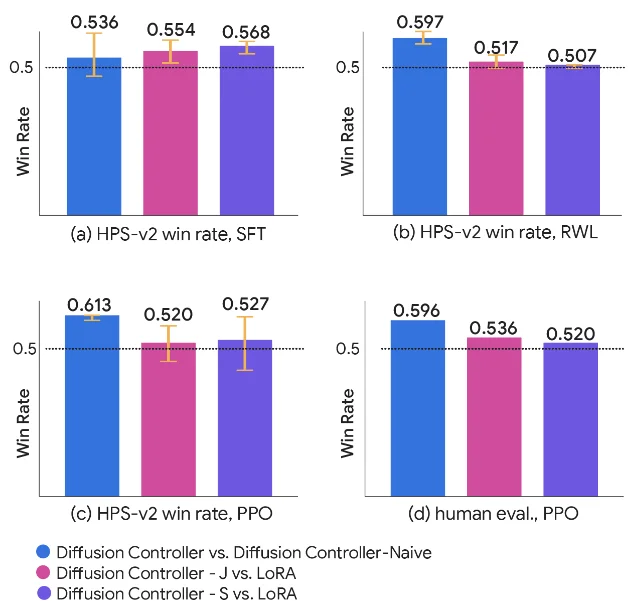
这张图和上面那张表量的是两件事。表 1 量的是每个方法相对预训练模型的胜率,图 4 量的是方法两两对打。灰盒那一条只在图 4 里和 DiffCon-Naive 比过,与 LoRA 的直接对打在论文里找不到;「灰盒超过白盒」这句话,是从两者各自对预训练模型的胜率推出来的。
这份材料还没有回答的
评测的独立性是第一个口子。奖励加权与 PPO 两条路线的奖励模型就是 HPS-v2,而主指标也是 HPS-v2 胜率,训练目标与评测指标落在同一个模型上5。论文另外报了 CLIP、PickScore 与 CLIP-Aesthetics 三个读数做一致性检查,人工评测只覆盖 PPO 一种算法:50 条提示、每条提示每个网络结构用不同种子出 4 张图、超过 50 名受薪评审、三组成对比较5。监督微调那一列的训练数据是 HPD v2 的胜出图像与提示词,与 HPS-v2 是两回事5。
适用面同样有限。实验只在 Stable Diffusion 1.4 上做,权重公开,灰盒这一档是靠冻住主干模拟出来的;侧网络跑在 64×64 的潜空间上5。博客主张的「贴到访问受限的封闭模型上」,实验里对得上的模型只有前面那一个。
推理期那个旋钮也要说清。论文对每个检查点报告的,是在若干引导强度 λ_model 里挑出来的最好成绩:监督微调与奖励加权试了 1/λ 从 0.1 到 1.0 的十档,PPO 试了四档5。线上部署时只有一个固定档位,未必拿得到同样高的数。
作者列出的下一步
References
- 1
- 2The latest research from Google(RSS)
research.google
- 3
- 4Tong Yang (杨桐) 个人主页
pptmiao.github.io
- 5
- 6HPSv2
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.