sub2api 打算替你改小 max_tokens 再试一次,开关默认是开的
四个中转实现本窗口零发版,唯一新动作是 sub2api 一张未合并补丁:上游嫌 max_tokens 太大时它自动改小再重试一次,开关默认就开着——这里把两条正则怎么改、thinking budget 怎么跟着缩、升级后想关只关这一支该怎么发请求逐条列清,外加四条补丁也覆盖不到的路。
11 月 4 日 14:39,sub2api 仓库开出一张还没合并的补丁,做的是这么一件事:上游嫌你给的
max_tokens 太大,它替你把这个数字改小,再拿同一份请求发一次。触发它的是两句固定的拒绝文案1:
max_tokens: 131072 > 128000, which is the maximum allowed number of output tokens for claude-opus-5-5 non-streaming requests cannot set max_tokens to 128000 or above; use stream=true or a lower max_tokens
今天跑着的 v0.2.19 里没有这段逻辑,重试环只整流 thinking budget,
max_tokens 原样送到上游。改动在 PR #8511 里:14 个文件 +678/−3,一笔提交,状态仍是 open,与当前主干还没对齐2。
本窗口四个中转实现零发版。所以这篇回答三件事:今晚要不要动配置;下一个版本会让什么自动发生;想拦下来该改哪个字段。
先自查:日志里有没有这两句
两条命令就能判。把日志文件换成你自己的路径:
grep -c "which is the maximum allowed number of output tokens" <你的调用日志>
grep -c "non-streaming requests cannot set max_tokens to" <你的调用日志>
第一条命中,说明有客户端把
max_tokens 设到了某个模型的上限之上。第二条命中,说明某个非流式请求把它顶到了 128000 或更高。第二种最常见于新会话。新会话要重建请求选项,会把客户端默认的输出上限套进去,数字一下就过线。issue #6852 是 9 月 8 日开的,报障人用的 v0.2.3,到今天仍然 open、零评论、无标签1。
顺带说清这两句各自卡的是什么。第一句是模型级硬上限,报的是「你要的 N 超过这个模型能输出的 M」,报障人测的模型上限是 128000。第二句是接口形态限制,由
stream 决定,跟客户端选哪个模型无关。补丁怎么改:两条正则,改小,只重试一次
补丁在请求层加了两个正则,都开不区分大小写,分别认上面两句话3。
第一句里两个数字都取出来:请求要的 N、模型上限 M,
max_tokens 写成 M。第二句只给一个 N,写成 N−1。max_tokens: 131072 > 128000, … → max_tokens: 128000
max_tokens: 128000 or above → max_tokens: 127999改写前先看当前值,已经不超过 M 就一个字不动。
thinking.type 是 enabled 时,光改 max_tokens 会和 thinking budget 打架,所以 budget 也按 budget × M / N 等比缩小。缩完仍不小于 M 就写 M−1;缩到 1024 以下则整份放弃,这次不重写。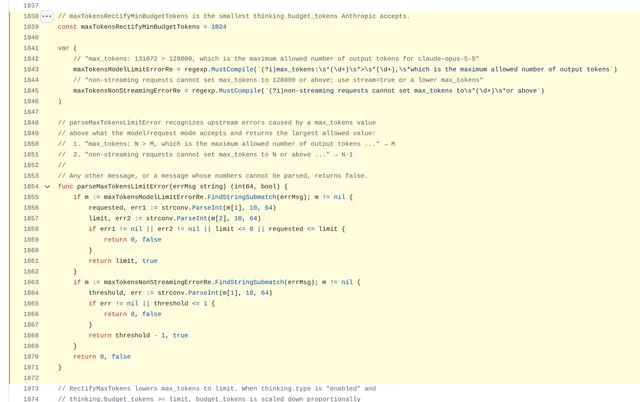
max_tokens: N > M 与 max_tokens to N or above,各自取出上限与要写的值;下面几个分支处理 thinking budget 的等比缩小与 1024 下限3重放有预算。一个请求最多 5 次尝试、总预算 10 秒;矫正成功只重放一次,第二次再回 400 就原样交给客户端,不会一直套下去。
命中时运维日志里会多一条分类为
max_tokens_limit_error 的事件,重写后的请求体替换掉原来那份。升级之后想统计每天撞几次,按这个分类数就行,不必翻响应体。对上游来说,最坏情况是同一个请求被看到两次,第二次的
max_tokens 比第一次小。计费按实际消耗走,第一次被拒的那次不产生 token。升级就生效,默认是开的
新键叫
max_tokens_enabled,挂在整流器设置下面,默认值是 true4。关键在于读配置的方式:代码先拷一份默认值,再把库里存的 JSON 叠上去。老部署那条 JSON 里没有这个键,叠完还是默认值,读回来就是开。升级之后没人去点,它也会动手。
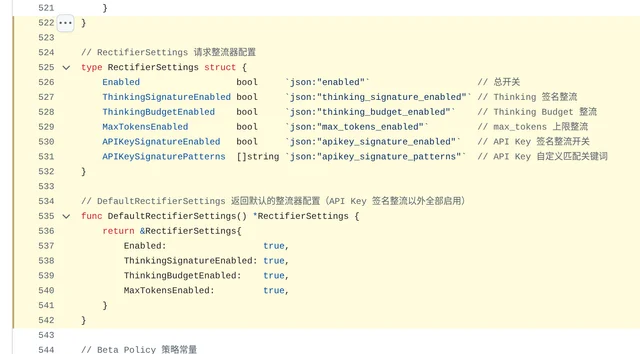
DefaultRectifierSettings() 里四支整流都是 true,新加的 max_tokens_enabled 也写在同一份默认值里;旧库 JSON 缺这个键时,叠上去仍是 true4想只关这一支,有个坑要先知道。设置接口上
max_tokens_enabled 是可选布尔,请求里不带就保留原值;其余四个开关是普通布尔,整份覆盖5。也就是说,只发一个
{"max_tokens_enabled": false},会把总开关与另外三支一起关掉。那三支管的是 thinking 签名、thinking budget 与 API Key 签名的整形,一起关掉等于把这几处整形同时停掉。
正确顺序是先
GET 读当前配置,把总开关和另外三支原样带回,只改这一个字段再 PUT。写完再 GET 一次核对两处:这个新键确实变成 false,总开关仍是 true。还有一点值得知道:读设置出错时,判定的写法是 fail-open,也就是按开启处理。所以「关掉」这件事只有写进配置才算数,别指望接口偶发失败时它会自己安静。
今天这版没有:v0.2.19 只整流 budget
v0.2.19 的重试环里只有一处整流调用,管的是 thinking budget6。
零命中的验证也简单:整包搜
RectifyMaxTokens、parseMaxTokensLimitError、max_tokens_enabled 三个词,全部为 0。今天撞上这两句,客户端拿到的就是上游原文,中转一个字都不改。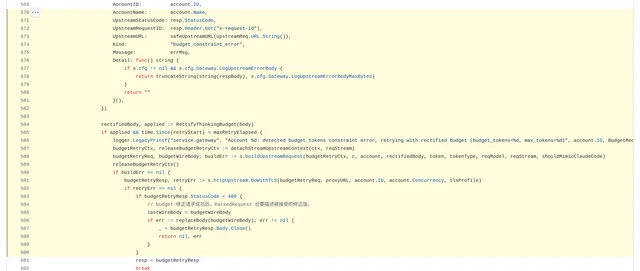
RectifyThinkingBudget,max_tokens 超限的报错走同一条原样返回路径6四条路补丁也不覆盖,按 PR 自己的说明写:
/v1/chat/completions与/v1/responses:这条路上游恒定stream=true,非流式那句不会出现;但max_output_tokens超过模型上限那一句仍会发生,这类请求以后照样原样报错- 开着透传的 Anthropic API Key 账号
- Bedrock
- Antigravity 的 Claude 路径,它有自己的 budget 矫正器
顺带两条:BytePlus 还得伪装成 OpenAI;#5953 只是把 dev 并进了分支
BytePlus 那两张单都开在 main 上、都还没合并。一张加 ModelArk 账号平台,43 个文件 +486/−87、9 笔提交7;另一张加预付费资金池与异步预留,58 个文件 +4843/−78。
v0.2.19 的平台常量表里没有 byteplus。所以今天想让 Ark 接进来,只能把账号当 OpenAI 兼容账号建,手填 Ark 的 base URL,模型名和计费都得自己对。
#5953 是 9 月 18 日开的老 PR,落在 dev 分支上9。它的语义是主路径被额度、冷却、5xx、429、402 打空时,回落到实时的
cli-subscriptions 同名模型别名,客户端仍然看到原来的 model id,实际走的通道由响应头 x-cliproxy-upstream 标出来。11 月 4 日 15:12 那次更新只是把
origin/dev 并进分支,没有新代码。3 笔提交里第三笔就是这次合并。本窗口的版本位与队列
| 仓库 | 当前版本 | 发布时间(北京) | 主干头 | 本窗口 |
|---|---|---|---|---|
| CLIProxyAPI | v8.0.53 | 11-03 20:27 | 与 v8.0.53 同提交 | 无发版、主干无新提交 |
| sub2api | v0.2.19 | 10-28 18:16 | 4a4a83ee | 无发版 |
| codex-proxy | v2.1.23 | 11-03 19:35 | 2bed0ed0,dev 20a50532 | 无发版 |
| codex2api | v3.1.3 | 11-04 10:22 | 20e4b399 | 无发版、无新提交 |
四行同一个口径:发行时间取发行接口里的发布时间字段,主干头取
git ls-remote 的 refs/heads/main 与 refs/tags/<tag>^{}。CLIProxyAPI 的 dev 比 v8.0.53 多 11 笔,与上一期一致,本窗口没有追平。队列里补一条更正。上一期写 CLIProxyAPI #7239 的自动评审「仍有未解决意见」,这条是错的:14:16 那笔提交之后,评审结论是未解决意见为否、发现问题为否、状态已完成10。那个时刻早于本窗口,只作更正,不当本期新闻。
本窗口内四仓的条目更新只有 sub2api 五条与 CLIProxyAPI 两条,其中 #7239 的更新落在那次评审回执上,#5953 只是并了一次 dev。codex-proxy 与 codex2api 窗口内零更新。
上游:三家都安静,额度也没动
OpenAI 状态页全绿、无降级组件,最近一条是 11 月 3 日 08:46 到 13:39(北京)的 ChatGPT 文件上传报错,已恢复11。
额度这边没有新动静:今天 UTC 没有重置,最近一次已验证的全局重置是 10 月 28 日 14:35(北京),累计 61 次、10 次可支取14。
今晚要动的只有一件事。日志里出现这两句,可以先把上游客户端那侧的
max_tokens 调下来,或者把这类请求改成流式,两条都不需要等版本。等这个补丁合并进发行版,它自己会处理;想让它别自己动手,就按上面那个顺序把这一支关掉,别只发一个键。References
- 1sub2api 议题 6852:非流式请求的 max_tokens 上限报错
github.com
- 2sub2api PR 8511:把超上限的 max_tokens 改小
github.com
- 3补丁分支的 gateway_request.go:两条正则与解析函数
github.com
- 4补丁分支的 settings_view.go:默认值与新增字段
github.com
- 5v0.2.19 的整流器设置路由
github.com
- 6v0.2.19 的 gateway_forward.go:重试环里唯一的整流分支
github.com
- 7sub2api PR 8459:ModelArk 账号平台
github.com
- 8sub2api PR 8512:BytePlus 预付费资金池
github.com
- 9
- 10CLIProxyAPI PR 7239:号池耗尽的答复形态
github.com
- 11OpenAI 状态页:ChatGPT 文件上传报错
status.openai.com
- 12Anthropic 状态页
status.anthropic.com
- 13Google Cloud 状态:事故列表
status.cloud.google.com
- 14Codex 重置追踪站
codex-reset.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.