PerceptionBench:多模态模型的视觉能力,最高也没过 60 分
Kimi 的 PerceptionBench 把视觉能力拆成 10 类、3,000 道原子化题目,结果显示最高总体准确率仍低于 60%,而且部分答对并不稳定,说明多模态模型还需要从「会答」走向「稳定看见」。

先给结论:多模态模型的「看见」仍不稳定
Kimi 在 2026 年 7 月 16 日发布了 PerceptionBench,试图把多模态大模型的视觉能力从一个笼统的总分,拆成更小的「原子化」感知任务:数数、定位、属性判断、深度与 3D、OCR,以及判断图中是否存在某个对象等。它的核心主张很直接:先测模型到底看到了什么,再讨论模型能不能推理。1
这套基准包含 3,000 道经过验证的问题,覆盖 10 类感知能力,评测了 16 个前沿模型。官方表格中最高的总体准确率是 GPT-5.6-Sol 的 59.7%,没有一个模型达到 60%。更值得注意的是,Kimi 还称有相当一部分第一次答对的答案经不起重复提问:模型可能是在猜,而不是稳定地从图像中提取证据。1
这不是一个「谁的多模态总分最高」的榜单,而是一种诊断工具。它试图回答的是:模型在哪一种视觉动作上容易错,以及答对时是否真的可靠。
为什么要把视觉能力拆开
很多视觉问答题表面上是一个问题,实际上混合了多层能力。比如「图中有几个人」主要考计数;「紫色线连接到杯子的哪一部分」主要考空间定位;「右下方方框里的数字是多少」主要考 OCR。如果模型答错,单看最终答案很难判断问题出在看不清、数错、位置关系没建立,还是凭常识补出了一个并不存在的对象。
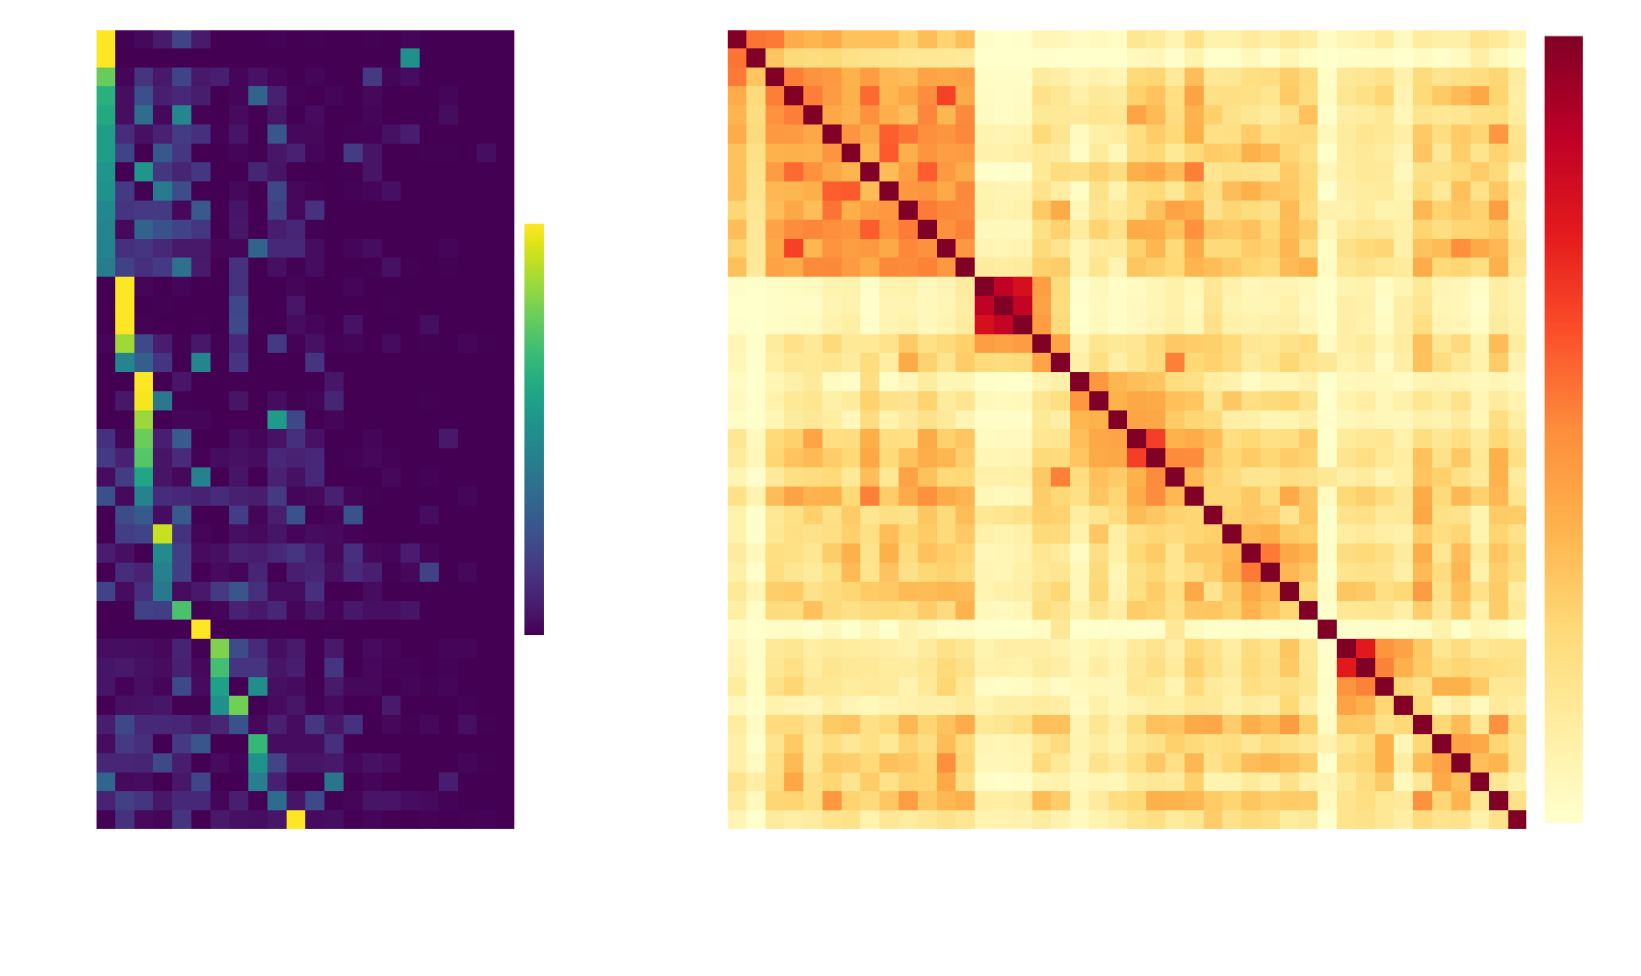
PerceptionBench 的做法是反过来追溯错误:Kimi 声称先在 40 多个已有 benchmark 中归因模型失败,寻找最早发生的视觉错误,再从这些失败中归纳能力类别,而不是预先拍脑袋定义一套分类。官方给出的已有 benchmark 之间平均两两加权 Jaccard 重叠度只有 0.20,说明不同基准捕捉到的感知错误切片彼此重叠有限;这也是它想做「能力中心」基准的理由。1
3,000 道题,覆盖哪十种感知能力
官方把数据集描述为高质量、经过验证的 3,000 个样本,并强调题目应当可以「只靠看」回答,不需要额外推理或外部知识。题目经过拆解和难度平衡,目标是把感知错误与复杂推理尽量分开。1
| 能力类别 | 样本数 | 占比 | 更接近在测什么 |
|---|---|---|---|
| Visual Relation,视觉关系 | 330 | 11.00% | 物体之间的连接、方向或关系 |
| Counting,计数 | 330 | 11.00% | 数量、分区或重复元素的个数 |
| Attribute,属性 | 330 | 11.00% | 颜色、形状等可见属性 |
| Depth & 3D,深度与三维 | 330 | 11.00% | 遮挡、接触地面和空间层次 |
| Localization,定位 | 330 | 11.00% | 线、点或对象落在什么位置 |
| Comparison,比较 | 279 | 9.30% | 形状、方向或对象是否相同 |
| Fine-grained Recognition,细粒度识别 | 290 | 9.67% | 区分相似对象或特定部件 |
| Context Integration,上下文整合 | 255 | 8.50% | 结合图中多个局部线索回答问题 |
| OCR | 255 | 8.50% | 读取图中的数字或文字 |
| Hallucination,幻觉检测 | 271 | 9.03% | 识别图中并不存在的对象或属性 |
表中最后一类很关键。它不只是问「模型看到了什么」,还问模型能不能克制自己,不为图像补上一个不存在的对象。对真实应用来说,这种「不乱说」的能力与 OCR、定位同样重要。样本分布与类别名称来自 Kimi 官方页面。1
结果:总分接近,不代表短板相同
PerceptionBench 的总体结果首先给出一个并不宽松的上限:GPT-5.6-Sol 为 59.7%,Kimi-K3 为 58.5%,Claude-Fable-5 为 57.2%,随后是 Gemini-3.1-Pro 的 56.2% 和 GPT-5.5 的 55.8%。即使在榜首,模型也没有跨过 60%。1
| 模型 | 总体准确率 | 最高的分项信号 | 较突出的短板 |
|---|---|---|---|
| GPT-5.6-Sol | 59.7% | 定位 76.7% | 幻觉检测 26.9% |
| Kimi-K3 | 58.5% | 定位 70.6% | 幻觉检测 42.1% |
| Claude-Fable-5 | 57.2% | 定位 70.4% | 深度与 3D 51.5% |
| Gemini-3.1-Pro | 56.2% | 属性 61.8% | 深度与 3D 50.0% |
| Seed-2.1-Pro | 55.0% | OCR 66.7% | 深度与 3D 43.6% |
| MiniMax-M3 | 33.1% | 定位 40.0% | 上下文整合 26.6% |
| GLM-4.6V | 32.5% | OCR 39.2% | 深度与 3D 29.1% |
这些分项数字不应被读成完整的模型能力画像:它们来自 Kimi 设计的这套题目,且页面没有展开每个模型的调用参数、提示词或更细的统计显著性。但它们足以说明一个工程事实:总分相近的模型,可能在定位、OCR、深度理解和幻觉检测上走着完全不同的路线。选型时只看一个多模态总分,容易把真正影响产品的短板藏起来。1
还有一个容易被忽略的信号:最高分模型在「幻觉检测」上的分数只有 26.9%,而 Kimi-K3 在这一项是 42.1%。这并不意味着 Kimi-K3 的整体视觉能力更强,也不能据此推出哪个模型更适合所有场景;它只说明,在「图中没有这个东西」的题型上,模型之间的错误分布可以与总体排名不同。
重复提问暴露了「答对」和「看懂」的差别
PerceptionBench 最有价值的设计,不一定是把能力分成十类,而是把稳定性也纳入问题:Kimi 表示,一大部分第一次回答正确的答案,在重复提问后无法保持。页面将此解读为当前模型经常依靠猜测,而不是稳定感知。
这里需要把结论的强度控制在原文范围内。公开页面没有给出这部分的具体比例,也没有展开重复提问次数、采样参数、题目是否改写或答案一致性的统计口径。因此,现阶段更稳妥的读法是:重复提问结果构成了一个重要风险信号,但还不能把它直接换算成某个模型的「感知可靠率」。
对产品团队来说,这个信号比一次性准确率更接近上线问题。一个模型偶尔能读对小字、数对对象,不能说明它在自动审核、GUI 操作、票据识别或机器人感知中会稳定工作。至少应增加三类检查:
- 同图重复询问:固定图像和问题,检查答案是否稳定;
- 局部改动回归:只改变颜色、数量或位置,确认模型是否随视觉证据变化;
- 不存在对象测试:给出容易诱导常识补全的场景,检查模型能否回答「没有」。
这套 benchmark 的价值与边界
它解决了什么问题
第一,它把「多模态模型不行」拆成可行动的错误类型。定位弱,可能需要补空间 grounding;OCR 弱,需要检查视觉分辨率和文字读取链路;幻觉检测弱,则要重新设计拒答与证据校验,而不是笼统地继续扩大语言模型规模。
第二,它提醒我们不要把推理能力和感知能力混在一起。复杂视觉问答答对,可能是模型根据题目格式、常识或语言模式推断出来的;原子化题目则更适合检查它是否真的读取了图像中的局部关系。
第三,它适合做回归测试。模型版本升级后,团队可以观察总体分数之外的能力迁移:某个版本可能 OCR 变好,却在深度与 3D 或幻觉检测上退化。这样的分项变化比单一总分更能指导数据和训练配方调整。
它还不能证明什么
PerceptionBench 不是完整的多模态能力评估。它强调「不需要推理或外部知识」,因此无法替代对长链条视觉推理、视频理解、跨图检索、工具使用和真实工作流的测试。它的题目来自对既有 benchmark 失败的归因,也意味着分类和样本构造仍然带有设计者的视角。
此外,页面对数据验证和难度平衡给出了原则性说明,但没有在正文中展开标注流程、各类别的详细题目构成,或重复提问实验的完整协议。读者可以把它当成一个有明确诊断目标的公开基准,但在据此做模型采购、上线门禁或能力宣称前,仍应复现题目、检查数据污染,并补上与自身业务图像分布相关的测试。
读者应该怎样使用这个结果
如果你只是比较模型,先看分项而不是总榜:需要读小字就关注 OCR,需要理解空间结构就关注定位、视觉关系和深度,需要高风险自动化就把幻觉检测和重复提问稳定性列为单独门槛。
如果你在训练模型,PerceptionBench 更像一张排障地图:它告诉你错误发生在哪类视觉动作上,但不会自动告诉你应该增加什么数据、换什么视觉编码器或采用哪种后训练方法。下一步仍要把失败样本拉回自己的图像分布,确认 benchmark 上的收益能否迁移。
如果你在做研究,真正值得继续追的是「稳定感知」:模型能否在题目措辞变化、重复询问和轻微视觉扰动下保持一致,并且在证据不足时明确承认看不见。PerceptionBench 把这个问题放到了台面上,但它的公开页面目前只给出了方向性结论,完整的稳定性测量还需要更多可复现细节。
一句话总结: PerceptionBench 的重要性不在于又排了一个多模态榜单,而在于把「模型答对了」和「模型确实看到了」区分开;目前最强模型的总体准确率仍停在 60% 以下,稳定、可解释的视觉感知仍是下一阶段的硬问题。
References
- 1PerceptionBench 官方博客
kimi.com
- 2Kimi Research 官方列表
kimi.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.