清华姚期智团队新作:代数世界模型,让AI像牛顿一样思考
清华姚期智、袁洋团队 10 月 29 日的 AWM 论文:让 AI 在规则未知的游戏里自建世界模型,再用 Lean 4 证明哪一关根本赢不了——附 25 个游戏 183 关的成绩、与两家强模型的正面对照,以及这套证明的边界。

本文转载自微信公众号「量子位」。原文发表于 2026 年 11 月 1 日,作者 Jay,《清华姚期智团队新作:代数世界模型,让 AI 像牛顿一样思考》。
10 月 29 日,清华交叉信息研究院团队把一篇论文挂上了 arXiv。1
论文题目译过来是《代数世界模型:从探索到证明》,四位作者依次是潘冠成、谭淇心、袁洋、姚期智。1
一句话说完它做了什么:让 AI 在一个规则未知的小游戏里自己摸索,把摸索出的规则写成能被机器逐条检查的数学模型。
再用 Lean 4 证明哪些关能过、哪些关过不去。2
新意在「自己摸索」这一段。大模型写 Lean 证明此前已经做到,依赖的题目、定义、形式化规格都由人给好;这篇把定义也交给了 AI。2
量子位这篇报道写于 11 月 1 日下午,把论文的动机、方法和数字都过了一遍。下面按原文的顺序重述,和论文对照过的数字会标出来。
这里的世界模型是一套规则
「世界模型」眼下最常指生成视频的那一类。这篇论文里指的是另一个东西:一套能推演的规则集。2
规则集由三部分构成:带类型的对象(棋盘、格子、按钮)、描述动作如何改变状态的规则、判断胜负的目标谓词。2
同一套东西写两遍。Python 版本用来跑、用来和观察对账,Lean 4 版本用来证明。2
这样安排换来的是可查。规则摆在明面上,人可以逐条质问它对不对;结论错了,还能顺着证明找到是哪条前提写错。3
第谷的笔记本:会玩,跟想明白是两件事
原文从一个游戏集讲起。ARC-AGI-3 的关卡不给规则、不给目标,玩家只能自己试。4
顶流模型在这里的成绩确实高。GPT-6 Astra 在官方标准 harness 下平均 68.3 分,配上 adapter harness 后 100.0 分。
Claude Opus 5 在无代码执行的标准 harness 下是 40.7 分。2
Astra 玩的时候会把机制整理成符号化的笔记:对象在哪、怎么互动、哪个动作接哪个动作。4
原文把它比作第谷的实验记录本。第谷记录了海量行星位置,精度惊人;行星运动三大定律要等开普勒从这些数据里提出来。4
记录与定律的差别落在能不能推。笔记能说清刚才发生了什么,定律能说清没试过的那一步会怎样。2
把预算改到差一步,看谁能证明它赢不了
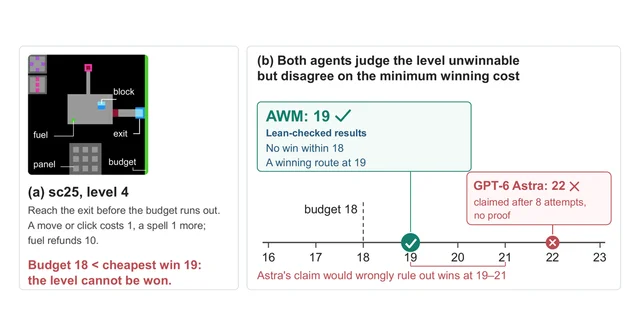
论文造了两道「差一步」的题。sc25 第 4 关最省的赢法要 19 步,研究者把预算改成 18;第 5 关最省 36 步,预算改成 35。2
这两个门槛由引擎穷举确认,覆盖四种初始朝向和 13 个动作。2
实验条件是每个关卡跑三次、每次最多八轮尝试。2
场上三个选手:AWM 用 Opus 5.5 驱动;另外两个是 Opus 5.5 本体和 GPT-6 Astra,都给了游戏界面、写代码和造模拟器的工具。2
| 系统 | 闭合的 Lean 证明 | 首轮判对下界 | 反馈后判对 | 首次判断落在第几轮尝试 |
|---|---|---|---|---|
| AWM | 6/6 | 4/6 | 6/6 | 2.02 |
| Claude Opus 5.5 | 0/6 | 1/6 | 1/6 | 5.32 |
| GPT-6 Astra | 0/6 | 0/6 | 2/6 | 8.02 |
「闭合」的意思是证明里没有 sorry,也没有 native_decide 这类绕过内核的计算,每一步都由 Lean 内核检查。2
AWM 六次全部给出了闭合证明,12 次基线运行里一条都没有。2
基线也有说对的,只是少。12 次里只有 5 次说「赢不了」,其中 4 次给的下界不对。2
原文举了最典型的一例:Astra 试了八轮,断言至少要 22 步,而真实门槛是 19。4
这个差距会改变结论。按 22 算,预算 19、20、21 三档都会被判成不可能,其中 19 恰好能赢。3
AWM 也错过两次:第 4 关给 20,第 5 关给 47。2
错因写在论文里:学到的规则太严,漏掉了游戏最省路线要用的转移,前提本身就不完整。2
只告诉它「还有更省的赢法」,不给步数、不给路线,它回头改规则、重做证明。2
四轮之内,两条下界改成 19 和 37。37 是按它把获胜动作也计一次成本的算法算的,等同游戏的 36。2
同样的反馈也给了基线:Astra 改对两条,仍然没有证明;Opus 5.5 一条都没改对。2
三步:写假设、拧结构、交给 Lean
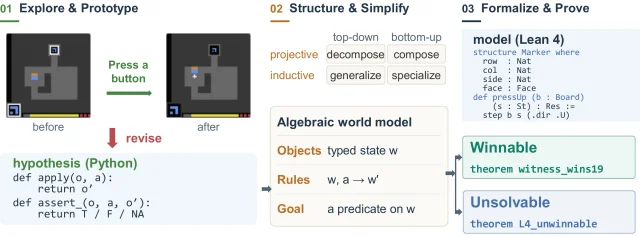
第一步是探索与原型。每玩一批,把关于机制的猜测写成一条「概念」:一句自然语言的断言、适用范围、检查器,以及可选的预测器。2
新观察一进来,所有概念重查一遍。跟观察冲突的概念必须先改掉或撤回,才允许继续动手。2
第二步是结构化与简化。把概念整理成带类型的对象和共享规则,再用四种范畴论引导的变换压缩表示。2
第三步是形式化与证明。模型写进 Lean 4,「这关有解」交一条见证路线,「这关无解」交一个不变量或成本下界。2
能覆盖没走过的路,靠的是后一种。下界一旦成立,预算内的所有动作序列都被排除,包括从没试过的那些。2
范畴论在这里干的活:十一条规则压成一条
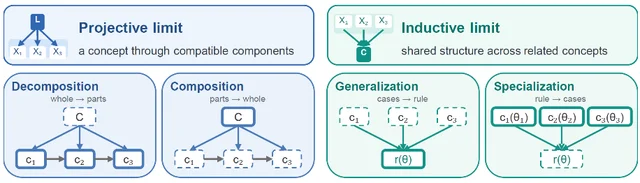
原文用「数学的数学」介绍范畴论,落到两个工具:投射极限把一堆概念和它们的关系拼成新东西,归纳极限从一堆东西里找共同结构。4
论文里对应四个动作:分解、组合、泛化、特化。每个动作都要在 Lean 里编译一条辅助陈述,由内核确认它确实是那个极限。2
lp85 这一局能看到压缩的实感。四类按钮——传送带、星星、中枢、面板——在探索阶段写了 11 条概念。2
泛化把它们并成一条规则 press_permutes,按被按下的按钮取参数。2
合并有验收线:原来的 11 条在诊断集上拒绝掉的 55 条错误转移,新规则一条不落全部拒绝,还多拒了 21 条。2
收益也具体。证明某个改色版本赢不了时,用一条共享规则比用 11 条概念少两到三倍引理。2
25 个游戏、183 关,数字要连着条件读
主结果是 25 个公开游戏、183 个关卡。AWM 用 Claude Opus 5 从头打,平均 99.9 分,23 个游戏满分,最低一局 97.6 分。2
效率也记了。被认证的过关路线共 7,448 步,是人类基准 17,135 步的 43%,在报告这项指标的系统中最少。2
含探索在内,它一共动了 24,604 次。2
榜上另有两家可对照:Memento 3 满分、7,518 步,是人类的 44%;Rodionov 的方案 99.0 分、8,347 步,是人类的 49%。2
三个系统的平均分都在 99 以上,AWM 比 Memento 3 低 0.1 分、步数少 70 步。2
「认证」落在具体产物上。Lean 把 183 关的获胜路线逐关重放,220 条规则完成形式化,产出 1,374 个定理。2
用到的公理只有三条:propext、Classical.choice、Quot.sound。三条都来自 Lean 自身的逻辑,没有哪条证明自带新公理。2
泛化另有测试。把 lp85 和 ft09 的模型冻结,拿去跑没见过的新屏幕。
两种改过布局的 lp85 上,4,160 次转移全部预测正确;两种改了机制的 ft09 上,4,031 次转移全部被拒。2
还有一组对照显示「简化」本身有用。同样在未见过的屏幕上,简化前的概念只能接受 67–70% 的有效转移,简化后的最终规则是 99.47–99.95%。2
它证明了什么,以及在哪儿停住
Lean 检查的是「在学到的模型里」这句话。项目主页写得很直白:这些证明没有说明模型就是游戏本身。3
它的证明,是基于它「观测到的世界」成立的。如果探索得不够全面,遗漏了某些关键规则,那这个模型描绘的也只是一个「局部真理」,而不是完整的世界。
量子位原文用这句话交代边界:证明成立的范围,就是它观察到的那部分世界。4
从模型通往游戏的那座桥,论文叫 sufficient cover:只要模型能逐步复现游戏里每一条最优获胜路线,模型里的不可能证明就能搬到游戏上。2
在引擎导出的图上逐条核过之后,六条不可能证明里有五条能这么搬过去。2
适用面也写清楚了:离散动作、即时可观测反馈、确定性环境。更丰富的隐藏状态、延迟反馈、随机动态还没有测。2
想自己复核的人有入口。项目主页给出 25 局每一局的模型文件、运行记录和重跑步骤;一次 Lean 检查一到十分钟,最多约 12GB 内存。3
其中一条附加实验值得单独记下。往参考模型里塞一条错规则,让 Claude Opus 5.5 去游戏里找反例。
不给证明依赖时,42 次里成 16 次;给了之后 29 次;直接告诉它哪条错,是 30 次。2
两个本科生,两位指导老师
两位共同第一作者都还在读书。潘冠成来自浙江大学,目前休学在清华做研究;谭淇心来自清华姚班。4
袁洋是清华大学交叉信息研究院、人工智能学院副教授,兼上海期智研究院具身智能与智能制造中心主任。4
姚期智是 2000 年图灵奖得主、中国科学院院士,现任清华大学交叉信息研究院院长、人工智能学院院长。4
原文把整件事收在一个循环里:观察→假设→实验→抽象→证明→再观察。4
AI 在人给好的定义上做形式化证明,这条路已经跑通。这篇把定义变成要学、可查、能改的东西,代价是结论只在模型里成立。2
想判断它能走多远,看那条从模型到游戏的桥就够:六条证明搬过去五条,剩下一条还留在模型里。2
References
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.