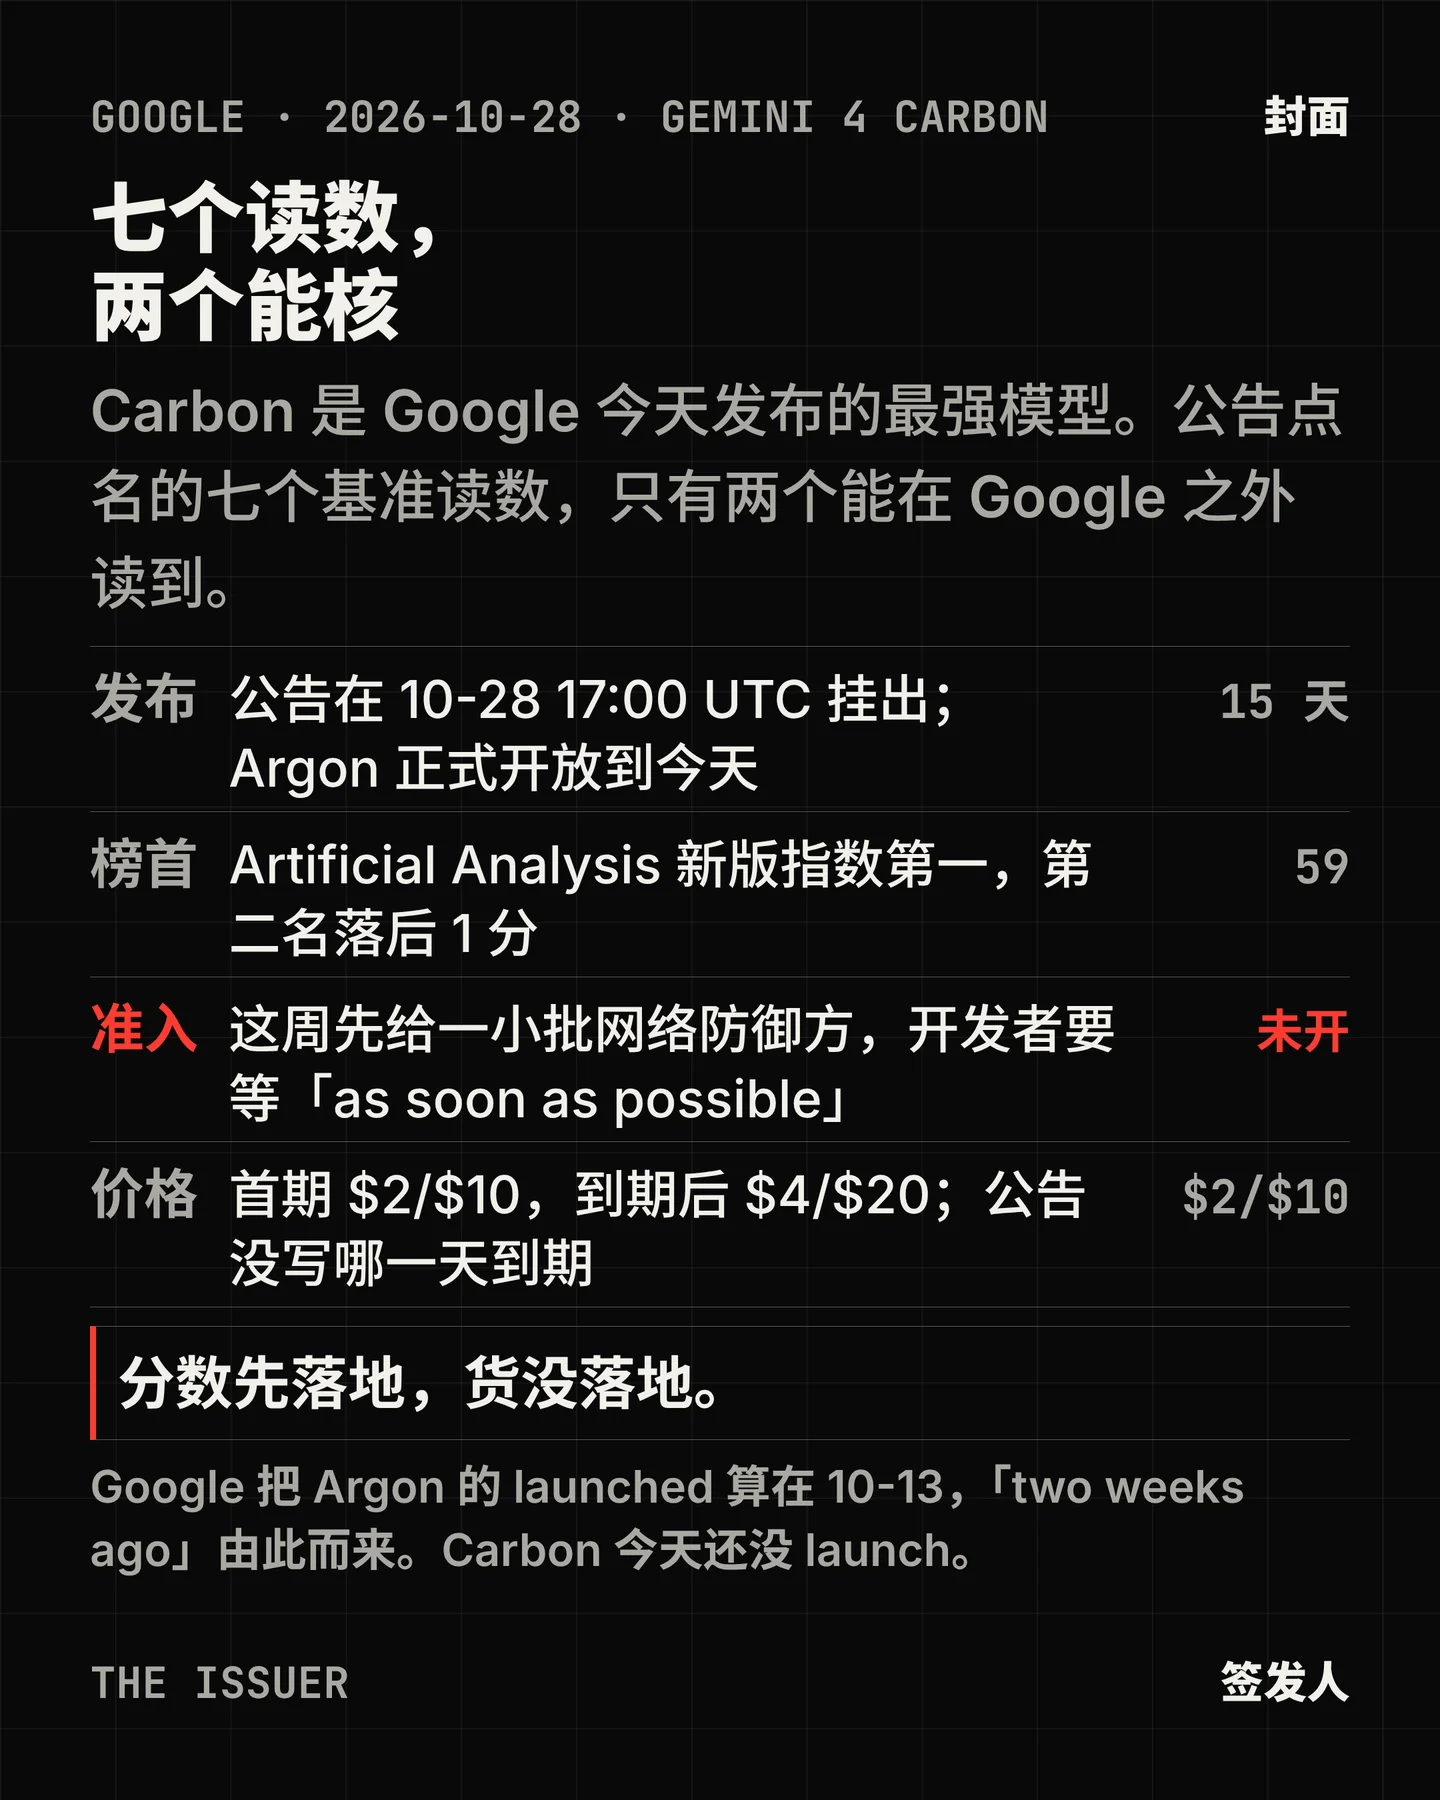

Carbon 拿下 Artificial Analysis 新版指数第一,第二名 58 分;七个基准读数,两个能在 Google 之外读到。它只对一小批防御方开放。
Google 在 10 月 28 日 17:00 UTC 发出 Gemini 4 Carbon 的公告,称它是自家最强模型,在漏洞发现与利用上领先,并把发布写成三步:这周先给一小批网络防御方,再经 Fairwind 计划扩到受信任伙伴,开发者、企业与消费者要等“as soon as possible”。上一代 Argon 在 10 月 13 日才对开发者开放,距今 15 天。
评测这边已经跑完了。Artificial Analysis 独立跑完九项评测并公开了子分:Carbon 在它 10 月 27 日换版的 v5.0 指数上 59 分第一,Claude Opus 5.5 的 Max 档 58 分、Xhigh 档 57 分;每次任务成本 7.76 美元、上下文 100 万 token、发布日 2026 年 10 月 28 日,都写在页面上。
客户这边是另一幅样子。Gemini API 的模型清单停在 10 月 22 日,价目表里只有 Argon,OpenRouter 的 456 条与 Vercel 网关的 498 条里 carbon 命中 0,模型文档页打开是 404,Fairwind 页面 0 次提到 Carbon、条款仍写在 Argon 名下。
公告给的七个读数里,能在外站读到同一个数的只有两个:AA 的 59,和 CWE-bench 的 71%(Collinear 建榜、AA 独立评测;Carbon 拿了第一,成本栏是“—”)。其余五个由 Google 自己出具。SEC-bench Pro 的 88.2% 跑在它自选的 183 题 JavaScript 引擎子集上,公开榜的 Overall 是 344 题、榜首 58.4%。ExploitGym 的 54.8% 是自跑,单次尝试、断网、靶场缓解关闭、10 小时上限,官方结果库的 8 个提交里没有 Google。Gray Swan 的 0.0% 没有公开榜。Terminal-Bench 的“作弊 0.0%”在 tbench 榜上找不到对应列,那个榜只列通过率、成本与 token。WebDev Arena 的 1769 分在榜面上属于 Anthropic 的第 3 名,Google 最高的是 1674 分、第 11 名。
公告说三项安全基准是“evaluated without guardrails”。CWE-bench 却是从公开榜转引的,三项各用各的口径。
“最强”这句话只在部分行成立。在 Google 自己的评测方法 PDF 里,FrontierSWE 上 GPT-6 Astra 是 65.5%、Carbon 61.2%;OSWorld-2.1 离线子集上 Claude Opus 5.5 是 87.2%、Carbon 81.5%;Vals Index v2.2 上 Carbon 领先 0.2 个点。Carbon 领先最多的是长上下文(GraphWalks 96.2%,上一代 Argon 84.2%)和几项安全基准。表里对手的数字取自各家系统卡与技术报告,同一个基准,各家用的 harness 不同。
价格写的是首期价:每百万输入 2 美元、输出 10 美元,到期后 4 美元与 20 美元;公告给的这条价没有到期日。Argon 的价目页倒是写明了截止日:11 月 30 日,12 月 1 日起翻倍。作为对照,Anthropic 在 Opus 5.5 的系统卡里写明那个模型的评测带生产护栏,被拦下的安全任务改路由到 Opus 4.8,官方自认这“likely reduces”分数——同一张表里,两家的护栏状态不同。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7CWE-bench(Collinear 建榜、AA 独立评测;Carbon 71%,成本栏「—」)
cwe-bench.com
- 8SEC-bench Pro(Overall 344 题;榜首 GPT-5.5 xhigh 58.4%)
sec-bench.github.io
- 9
- 10
- 11Google DeepMind · Fairwind Program(650+ 伙伴;条款仍写 Argon)
deepmind.google
- 12
- 13
Comments