奇绩信号Alpha Sight 2026年8月11日【文字版】
本期精选 8 月 10 日 arXiv recent 分组的十二篇 AI 论文,观察技能演化、推理预算、世界模型、证据记忆与 VLM 压力测试如何把中间状态变成可检查接口。

本期判断
2026 年 8 月 10 日 arXiv recent 分组里,最值得跟踪的共同变化不是模型又大了一点,而是系统开始把中间状态做成可检查的接口。
CoBa 把推理预算分给采样、验证和停止;TEPA 允许记忆被撤销;SADT 检查注意力指向的语义,而不是只看注意力大小;AutoIntervene 让机器人在失去示范支持时主动交回控制权。
这批论文的分歧也很清楚:有的把证据接口做在训练目标里,有的做在运行时路由里,还有的把它做成数据集和审计记录。
本期从 cs.AI、cs.LG、cs.CL、cs.CV、cs.RO 的 2026 年 8 月 10 日 recent 分组中精选十二篇,覆盖九个板块。入选论文详情页的 v1 日期均显示为 2026 年 8 月 7 日;正文以下以列表分组日期界定「最新」范围,以详情页和原文 HTML 核实方法、数字与图表。
阅读顺序建议:先看头条里的 SkillProx、CoBa、SimWAM 和 LitTraceQA,再按自己的任务进入认知模型、具身、Infra 或 Agent 板块。
头条
1. 让 Agent 技能像代码一样回归测试:SkillProx
信号源:香港科技大学、澳门大学
🔧
认知提取
Agent 的长期技能不再只是越写越长的提示词,而可以像一段需要回归测试的代码:先执行,再诊断,再修补;如果结果变差,就回滚。
SkillProx 最有用的地方,是把「删除什么」从普通编辑动作里单独拿出来,用留一法效用审计判断某个知识单元究竟有没有贡献。
论文摘要
• 论文针对两个缺口:已有技能演化缺少明确的「诊断—结果」反馈,也没有把知识合并、降级和删除当成独立操作。1
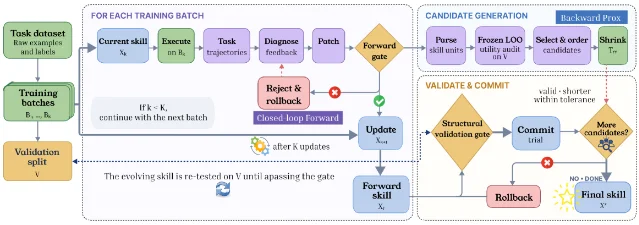
• SkillProx 在固定任务批次上反复执行诊断驱动的编辑,并根据实际结果接受更新或回滚退化;随后把技能拆成可审计知识单元,在验证集上做冻结的留一法效用审计。2
• 论文在分布内和分布外基准、多个骨干 LLM 上报告:相对最强的梯度式基线,平均准确率提升三点零个百分点。1
核心方法
• 前向阶段在同一任务批次上重跑技能更新,把任务结果反馈给下一轮诊断;这使「修改看起来合理」和「修改真的有效」分开。
• 反向阶段把长技能解析成较小的知识单元,用冻结验证集估计每个单元的边际效用,再按验证结果执行 consolidation、demotion 或 removal。2
• 近端思想提供了一个明确的压缩约束:技能要提高任务成功率,也要避免无效知识无限堆积。方法图中的 forward gate、structural validation gate 和 rollback 是这个约束的可执行版本。
实验成果
• 主要结果是平均准确率相对最强梯度式基线提升三点零个百分点;论文同时报告了分布内、分布外和多个骨干模型的结果。1
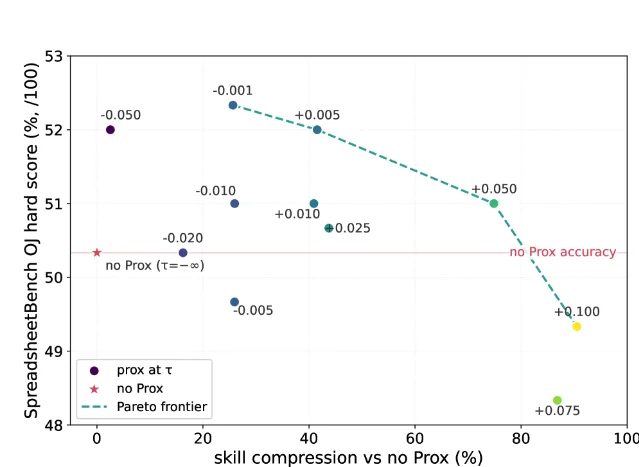
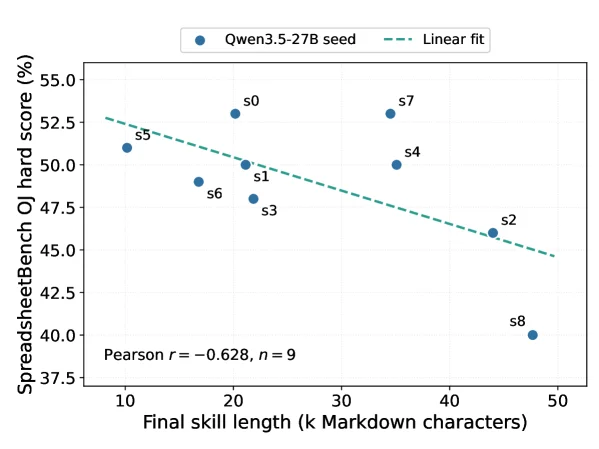
• 原文 Figure 2 把准确率和技能压缩长度放在同一张 Pareto 图上;Figure 3 进一步比较验证门前后的 OJ hard accuracy,使用一百个固定任务、每个任务三个测试用例,严格成功要求三个用例都 cell-perfect。2
总结与反思
• 结果总结:SkillProx 把技能演化从单向追加改成带回滚和删除的闭环,平均准确率相对梯度式基线提升三点零个百分点。
• 局限性:论文的结果依赖任务批次、验证集和知识单元拆分;技能是否能在更开放、更长周期的任务中稳定维护,原文没有给出充分证据。
• 前沿见解:Agent 技能的下一步竞争点可能不是谁能写出更长的 skill,而是谁能证明某一条规则应该继续留在上下文里。
2. 推理时扩展的关键不是多算,而是把下一笔算力花对:CoBa
信号源:长沙理工大学、上海交通大学
⚖️
认知提取
多数 test-time scaling 方案把预算押在一个旋钮上:多采样、想更久,或者换更强的验证器。
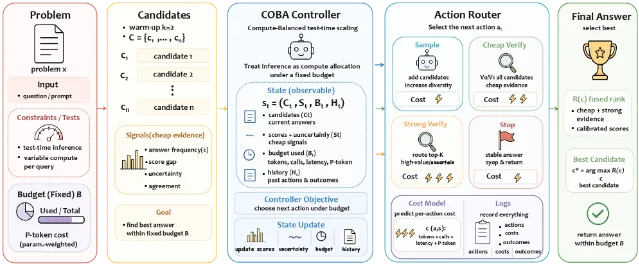
CoBa 把问题改写成一个路口:下一单位计算应该用于生成候选、廉价验证、强验证,还是直接停止。
论文摘要
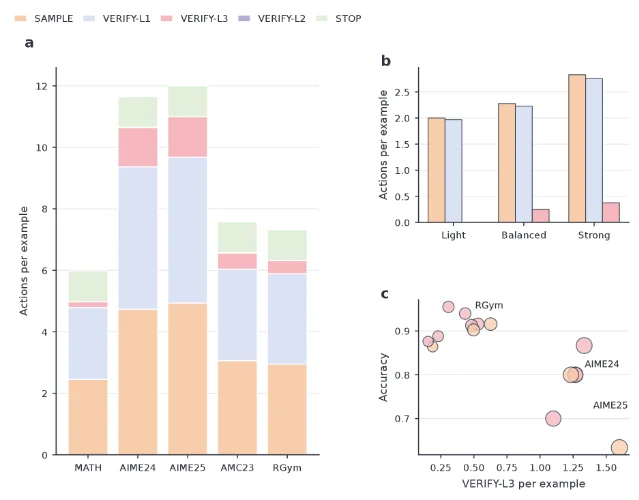
• CoBa 先生成少量候选,再广泛使用廉价证据;只有不确定或价值较高的候选才进入强验证,路由器还会根据预算、历史和不确定性更新状态。3
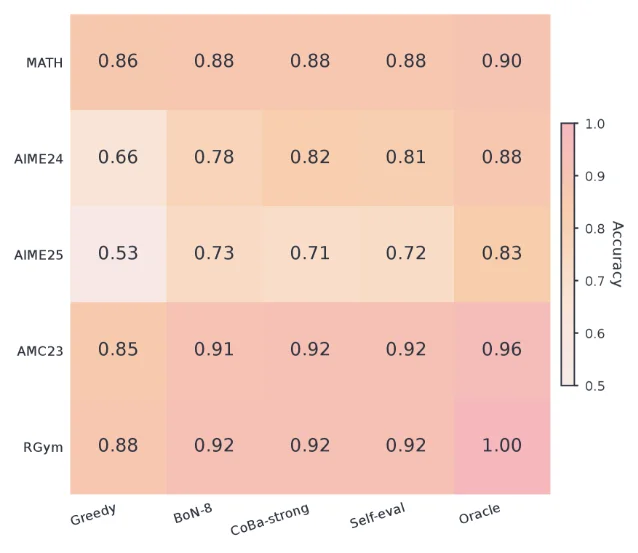
• 评测覆盖 MATH-500、AIME 2024/2025、AMC 2023 和过程符号推理,共三千一百二十九次 example-generator evaluation。3
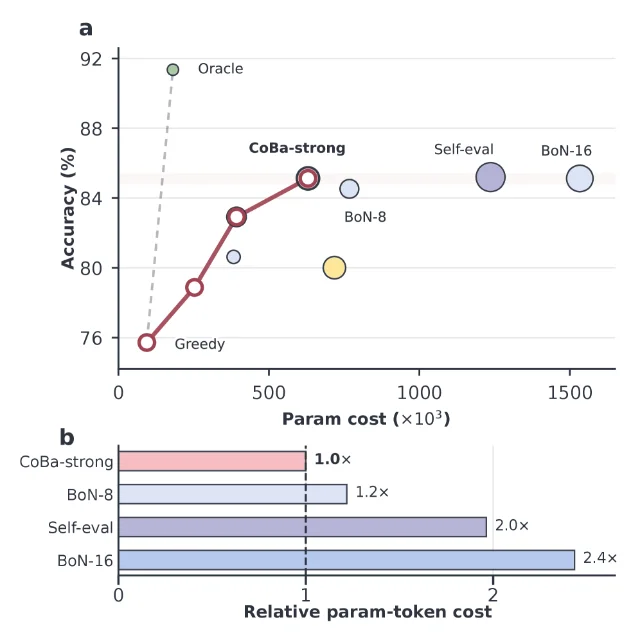
• CoBa-Routed-Strong 达到八十五点一三的宏平均准确率,与自评加权投票的八十五点二零在统计上相当,但参数加权 token 少四十九点一%。3
核心方法
• 候选生成阶段先保留小规模候选池,控制器观察候选答案、廉价分数、不确定性、已用预算和历史动作。
• Action Router 用统一成本模型比较四种动作:增加多样性的 sample、覆盖所有候选的 cheap verify、针对高价值或高不确定候选的 strong verify,以及在答案稳定时 stop。4
• 这套设计不替换生成器和验证器,只改变调用时机;因此收益主要来自预算分配,而不是额外训练一个更大的推理模型。
实验成果
• 相对 best-of-16 majority voting,CoBa 在宏平均准确率上相差不超过零点零一个百分点,同时参数加权 token 少五十八点九%;但成对检验仍保留了 best-of-16 的小幅优势,代价也更高。3
• 配对 bootstrap 检验显示 CoBa 相对单样本解码有统计增益;它与 pool oracle 的剩余差距则暴露出路由器仍未完全识别「什么时候值得继续算」。3
总结与反思
• 结果总结:CoBa 证明在固定预算下,路由本身可以带来接近 best-of-16 的准确率,同时显著减少参数加权 token。
• 局限性:实验集中在数学和过程符号推理,且路由依赖可获得的廉价验证信号;开放域任务中这些信号是否足够稳定,仍未验证。
• 前沿见解:推理时扩展正在从「把一条链拉长」转向「在生成、验证和停止之间管理一笔有限预算」。
3. 视频世界模型只在训练时出现:SimWAM
信号源:华中科技大学、东风研发中心
🚗
认知提取
世界模型最贵的部分往往不是训练,而是部署时还要不断生成未来画面。
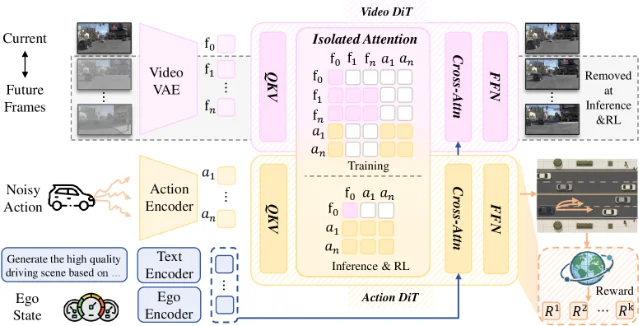
SimWAM 把视频专家留在训练阶段,只把它提供的动态先验交给轻量 action expert;推理时删掉视频分支,规划器直接预测轨迹。
论文摘要
• SimWAM 用预训练视频专家和轻量动作专家做联合 flow matching,通过隔离 attention mask 让动作预测不依赖未来帧;两者共享统一注意力接口,但不共享参数。5
• 视频生成只作为训练信号,部署与强化学习阶段保留 action expert;论文还用组合式驾驶奖励做强化学习,超越单纯轨迹模仿。6
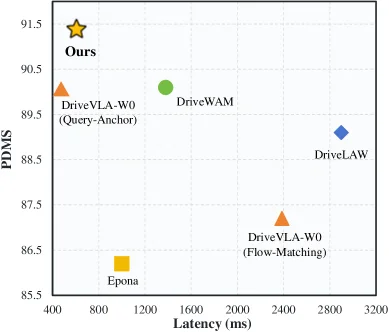
• 在 NAVSIM 上达到九十一点五九一 PDMS,并以明显低于世界模型规划器的延迟完成规划;同时在 nuScenes 上零样本迁移。5
核心方法
• 视频 DiT 学习未来驾驶场景,动作 DiT 学习轨迹生成;隔离 attention mask 让动作 token 只依赖当前观测和动作条件,不偷看未来帧。
• 两个专家通过统一接口协作,却不共享参数,因此未来视频骨干可以替换,动作专家也可以独立扩大,而不必改动学习目标和推理流水线。5
• 强化学习阶段继续只使用动作专家,在 hard subset 上优化组合式驾驶奖励,减少「模仿了平均轨迹但没有真正推进」的问题。
实验成果
• NAVSIM navtest 上的 PDMS 为九十一点五九一;原文 Figure 1 同时把 PDMS 和推理延迟放在一起比较,主张的是效率—性能组合,而非单一榜单名次。5
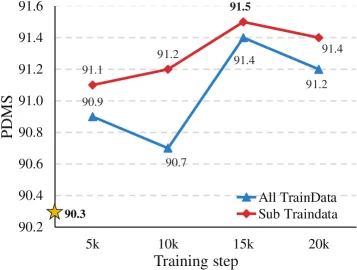
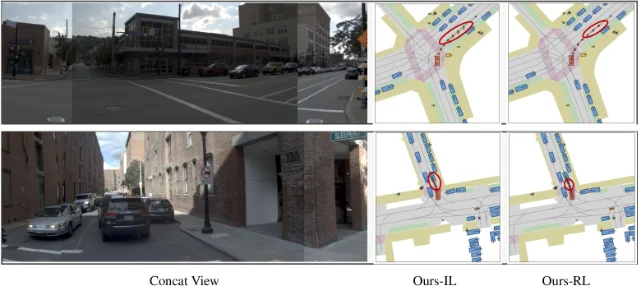
• Figure 3 显示 hard subset 训练的强化学习曲线持续高于全量 navtrain 场景;Figure 4 的定性例子中,RL 版本在保持可行驶区域内推进得更远。6
总结与反思
• 结果总结:SimWAM 把视频世界模型的训练收益和部署成本拆开,在 NAVSIM 上达到九十一点五九一 PDMS,并支持零样本迁移。
• 局限性:论文的核心证据来自自动驾驶规划基准,不能直接推出在通用机器人控制中的同样收益;零样本迁移也仍是单一场景协议下的结果。
• 前沿见解:世界模型不一定要在每个时间步都「想象」未来,关键是把未来建模能力压缩成部署时真正需要的动作接口。
4. 科研问答的终点不是答案,而是证据链:LitTraceQA
信号源:滑铁卢大学、亚马逊、香港城市大学、阿姆斯特丹大学
链接:LitTraceQA: A Benchmark for Multi-Stage Grounding and Verification in Scientific Question Answering
📚
认知提取
科学问答里,一个数字答对了,不代表系统找对了论文、图表或实验条件。
LitTraceQA 要求系统同时交付论文 ID、证据位置和答案,把「会答」拆成可检查的检索、grounding 和生成三段。
论文摘要
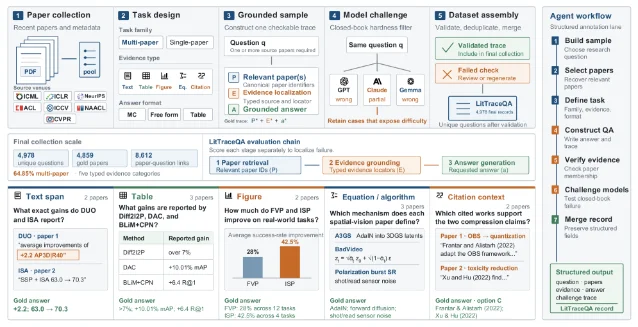
• 输入是研究问题和论文 metadata pool,输出包括 canonical paper identifiers、supporting evidence locations,以及自由文本、选择题或结构化表格答案。7
• 公共开发集有五十五个样例,其中二十六个是 hidden-source single-paper 问题,二十九个是 multi-paper 问题;更大的注释集合包含四千九百七十八条唯一问题记录,覆盖四千八百五十九篇唯一 gold paper。7
• 证据类型覆盖表格、图、正文片段、公式或算法、引用上下文,并将 paper retrieval、evidence grounding 和 answer correctness 分开评估。8
核心方法
• 任务设计有 hidden-source single-paper QA 和 multi-paper QA 两种场景,避免系统只依赖已给定的单篇文档。
• 生成—ground—challenge 流程先生成候选问题和 gold annotation,再检查证据是否属于声明的论文,并用 closed-book challenger 过滤只靠记忆也能答对的问题。8
• 每条记录保存问题、答案类型、gold papers、typed evidence、locator、grounding strings 和验证元数据;这使错误可以定位到检索、证据或生成,而不是只给一个总分。
实验成果
• 五个主要证据类型的更大集合包括:表格题一千三百三十九条、图题一千一百三十二条、正文片段题九百三十三条、公式或算法题八百一十九条、引用上下文题七百五十五条。8
• 最终集合有三千零二十九道选择题和一千九百四十九道结构化表格题;三千零八十条记录在所有 closed-book challenger 上都答错,一千八百九十八条恰有一个 challenger 答对。8
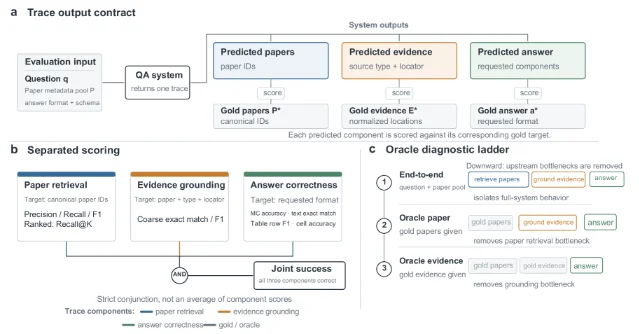
图三:评估协议把 paper retrieval、evidence grounding 和 answer correctness 分开,并提供 oracle-paper 与 oracle-evidence 诊断阶梯。8
总结与反思
• 结果总结:LitTraceQA 把科研问答从「答案像不像」改成「论文、证据和答案是否连得起来」。
• 局限性:论文明确标注 Work in Progress;公共开发集很小,较大集合的记录和证据 locator 仍需要进一步规范化。
• 前沿见解:面向科研的 Agent 如果没有证据定位和跨论文追踪,生成再流畅也只能算阅读摘要器,不能算研究助手。
认知模型
5. 世界模型不必逐步滚动:直接训练终点预测:DPWM
信号源:加州大学戴维斯分校
🧭
认知提取
短步预测像每走一步就拍一张照片,长程 rollout 则会把早期误差一张张叠起来。
DPWM 直接把任意长度的动作序列压成一个 embedding,预测终点观测;论文的核心判断是,长程系统应该用最终使用的时间尺度来训练。
论文摘要
• 论文指出,局部 few-step loss 与递归长程部署之间存在目标错位:每一步都拟合得不错,不等于滚到终点还准确。9
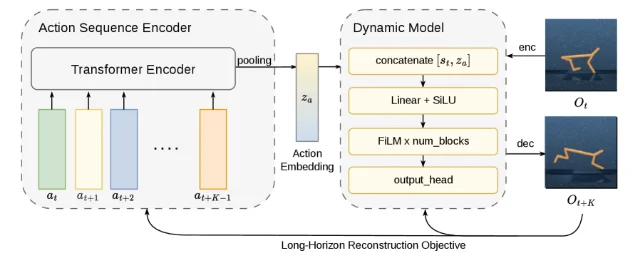
• Direct Prediction World Model 用 Action Sequence Encoder 压缩可变长度动作序列,再由 Dynamic Model 从初始观测直接预测终点,不生成中间观测,也不在梯度中展开递归 rollout。10
• 在连续控制和像素基准上,DPWM 的长程终点预测优于递归 world-model baseline,而且 horizon 越长,优势越明显;把同一终点目标重新训练到递归 baseline 上,也能获得相似改善。9
核心方法
• Action Sequence Encoder 用 Transformer 编码任意长度动作前缀,通过 pooling 得到单一 embedding。
• Dynamic Model 将初始状态与动作 embedding 拼接,经过 Linear、SiLU、FiLM blocks 和 output head,直接输出终点状态。
• 作者还控制了 backbone 和 objective 的混淆:递归 baseline 如果改用同样的长程 endpoint objective,也会变好,说明训练目标可能比具体 backbone 更关键。9
实验成果
• 原文 Figure 3 以 normalized state-space MSE 比较多个训练 horizon,在 humanoid_walk 和 cheetah_run 上观察到 horizon 增大时 DPWM 的终点误差增长更缓。
• 一条可核对的表格记录是:在 Cheetah、random train/random eval、horizon 为一时,DPWM-K=100 的 raw state-space MSE 为零点零二七七,ADM-K=3 为零点零三四五,MoSim 为零点零五一九。10
• 论文同时给出 Pong 的四十一步至五十步可视化,以及完整七十步轨迹生成,检验直接终点预测是否能保持视觉状态一致性。10
图二:不同最大训练 horizon 下的 normalized endpoint MSE,曲线用于观察长程误差如何随评估 horizon 增加。10
总结与反思
• 结果总结:DPWM 将训练目标和部署时间尺度对齐,直接预测终点,长 horizon 下比递归 rollout 更稳。
• 局限性:直接预测牺牲了中间状态轨迹,难以回答「哪一步出了错」;对需要逐步规划或中途纠偏的 Agent,它不能单独替代可展开 world model。
• 前沿见解:world model 的评价单位可能从「下一帧」转向「最终后果」,但这会把可解释性和纠错粒度留给另一套接口。
多模态
6. 注意力一样,语义不一样:用 Logit Lens 抓住 LVLM 物体幻觉:SADT
信号源:中国科学院大学、中国科学院自动化研究所、香港科技大学
👁️
认知提取
视觉幻觉不一定来自模型没有看图,也可能来自它看到了相似区域,却没有把区域里的语义解码成正确物体。
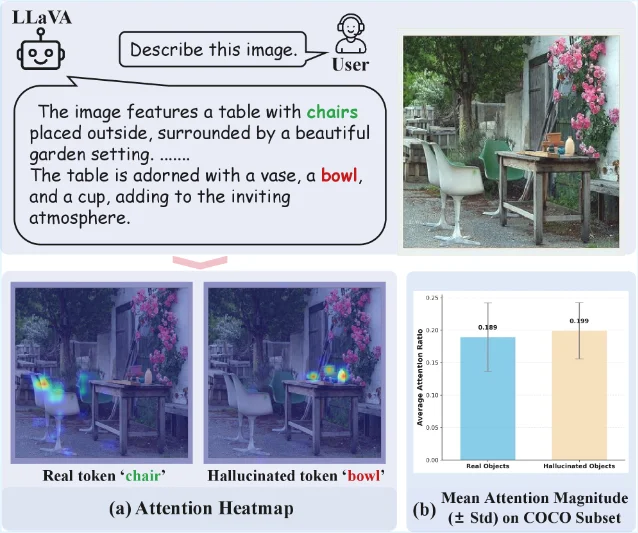
SADT 的诊断很具体:真实物体和幻觉物体的视觉注意力强度可以接近,区别出现在高注意力区域被 Logit Lens 解码之后的语义是否与目标 token 一致。
论文摘要
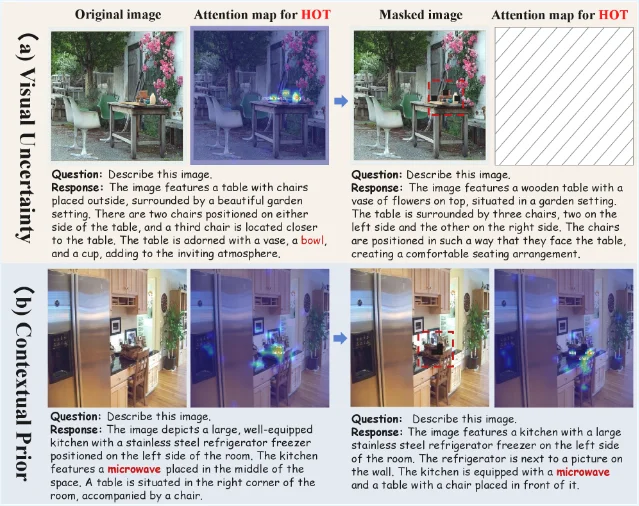
• 论文在 LLaVA-1.5-7B 上分析 COCO2014 的五百张图像,用 CHAIR 标注真实物体和幻觉物体,并将幻觉分成 visual uncertainty 与 contextual prior 两类。11
• visual uncertainty 由相似或混淆区域触发,屏蔽高注意力区域可消除;contextual prior 由强共现先验触发,即便屏蔽最初区域,注意力也会漂移到别处,幻觉仍会持续。12
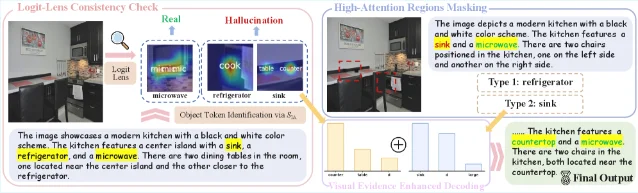
• 方法是无需训练的 Detect-Mitigate 框架:用 Logit-Lens Consistency Check 检测,再用 HARM 或 VEED 做针对性处理。11
核心方法
• 在 image-attention stage 的中后层,模型分别把高注意力区域的视觉特征投射到词表,用 token 语义一致性区分真实和幻觉。
• 检测阈值包括注意力阈值零点一五、保留区域数三和语义相似度阈值零点八;这些是该实验协议的设置,不是普遍最优值。12
• HARM 针对 visual uncertainty 屏蔽高注意力区域;VEED 针对 contextual prior 增强视觉证据解码,两个缓解动作不是一个统一的盲目遮挡操作。
实验成果
• 论文报告在多个 hallucination benchmark 上达到 state-of-the-art,但摘要没有在该入口列出统一的单一总分;正文图表承担了检测和缓解的分项比较。11
• 这项工作的硬证据不是「注意力更大」,而是 Figure 1 中真实与幻觉对象的注意力均值接近,以及 Figure 4 中 Logit Lens 解码语义对真实 token 一致、对幻觉 token 偏离。12
总结与反思
• 结果总结:SADT 把视觉幻觉的诊断从注意力幅度推进到注意力内容,且不需要训练新模型。
• 局限性:实验主要依赖 LLaVA-1.5-7B、COCO2014 和 CHAIR;阈值迁移到更强或不同架构 LVLM 的稳定性仍需独立验证。
• 前沿见解:视觉 grounding 的关键问题可能不是「模型有没有看」,而是「模型把看到的东西解码成了什么」。
具身智能
7. 让机器人在失去示范支持时自动交棒:AutoIntervene
信号源:悉尼大学、范德堡大学
🤖
认知提取
Action-chunking 策略可以让动作更连贯,却也可能在已经偏离示范分布后继续输出一段看起来很顺的错误动作。
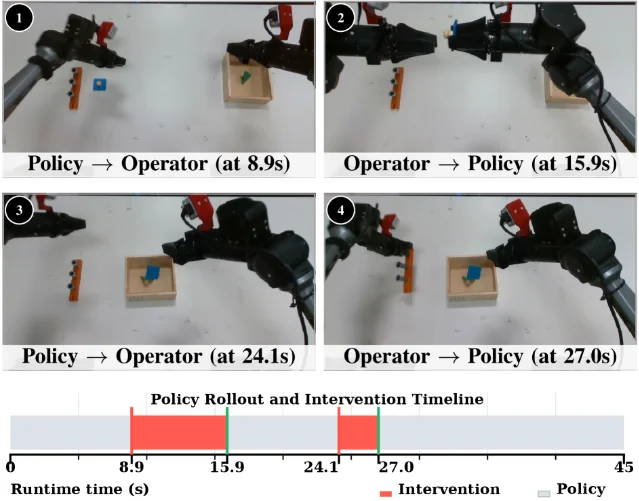
AutoIntervene 用成功轨迹建立 visual-action support memory:不支持时把控制交给操作员,恢复到支持区域后再交还给策略。
论文摘要
• 系统为策略到操作员、操作员到策略分别校准切换阈值;前者使用当前任务阶段的局部支持,后者使用全局支持,避免把一次恢复误判成长期可自主状态。13
• 实验覆盖九个真实世界双臂操作任务,七个主基准任务加两个长时程扩展任务;每个任务有三十六条初始轨迹,三十条训练、六条固定校准。14
• 保留的 intervention segments 只针对 learner-induced states,并被用于下一轮策略更新,形成选择性 DAgger 式数据聚合。14
核心方法
• visual similarity 与 proposed/reference action consistency 共同决定 action chunk 是否落在成功示范支持内。
• phase-local support 用于 policy-to-operator 切换,global support 用于 operator-to-policy 恢复;两种方向的阈值由留出专家示范的经验分位数校准,而不是手工指定。
• 评估平台是两只 AgileX PiPER-X 六自由度机械臂、三枚 RGB 相机、二十八维双臂状态和十四维关节与夹爪控制指令。14
实验成果
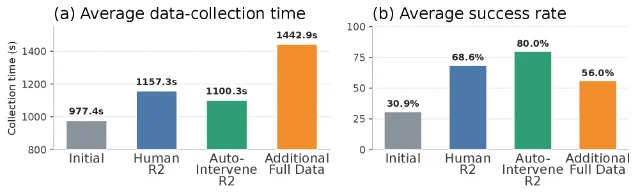
• 七任务平均成功率从初始策略的三十点九%提升到 AutoIntervene 第二轮的八十点零%;同一轮人工切换为六十八点六%,额外完整示范数据为五十六点零%。14
• AutoIntervene 第二轮的平均额外操作员控制时间为一百二十二点九秒,而额外完整数据方案记录一千四百四十二点九秒;论文据此报告约少七十四%的额外控制数据时间。14
• 消融显示去掉 visual support 后 cut-in recall 降为零;去掉 action risk 后 cut-in recall 为零点九零、cut-out recall 为零点五六,说明两类信号分别约束进入和退出。14
图二:七任务跨轮次成功率和控制数据时间,AutoIntervene 在第二轮达到八十点零%平均成功率,同时保持较低的额外控制时间。14
总结与反思
• 结果总结:AutoIntervene 把人工接管变成校准的双向控制接口,在九个真实双臂任务上以更少操作员时间获得更高适应后成功率。
• 局限性:任务数量和机器人平台仍有限;成功示范构成的 support memory 可能无法覆盖真实部署中的长尾扰动。
• 前沿见解:具身系统的安全策略不应只问「策略能不能做」,还要问「当前状态是否仍在它见过的支持区域里」。
AI4Science
8. 让统计检验成为可审计的 Agent 工作流:Fisher-R1
信号源:斯坦福大学、威斯康星大学麦迪逊分校
🧪
认知提取
代码跑通、p-value 算出来,并不等于统计结论正确。
Fisher-R1 把「选什么检验、p-value 是否符合数据假设、最后是否拒绝原假设」放进可执行环境,用 verified statistical reward 训练 Agent。
论文摘要
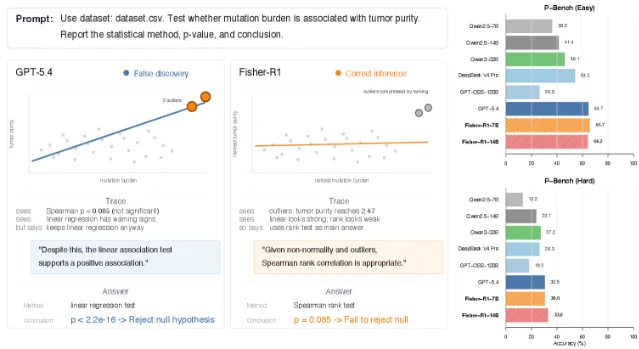
• P-Bench 包含四百二十五个开放式、真实感较强的假设检验任务,覆盖经济学、生物学和医学;每题要求 Agent 选择统计方法、计算 p-value 并下结论。15
• Fisher-R1-14B 通过合成任务和强化学习训练,目标不是让代码更容易执行,而是让统计假设、p-value 和结论三者一致。
• 在 P-Bench 上,Fisher-R1-14B 相对 DeepSeek-V4-Pro 的单次成功率平均相对提升二十一%,最困难任务最高提升二十六%。15
核心方法
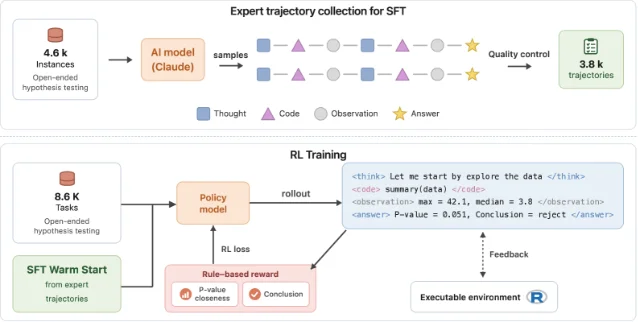
• 每个 P-Bench 任务提供分析请求、CSV 数据和由 canonical reference analysis 得到的隐藏答案键;Agent 在记录式 sandbox 中写、执行 R 代码,并返回统计方法、p-value 和 reject/fail-to-reject 决定。16
• 训练先收集包含思考、代码、观察和最终答案的高质量专家轨迹做 SFT,再在可执行环境中用规则奖励做 RL。
• 奖励同时检查 p-value accuracy 和 conclusion correctness,避免「程序执行成功」成为唯一优化目标。16
实验成果
• 论文将 proprietary 和 open-source baseline 放在同一 P-Bench 协议下比较,并报告 Fisher-R1-14B 相对 DeepSeek-V4-Pro 平均二十一%的单次成功率相对提升。15
• Figure 1 的 hard split 诊断说明,错误往往发生在方法选择和统计假设层面,而不是代码有没有执行完成。
• 这项实验的可复现关键是数据集、执行沙箱和隐藏答案键;脱离这些条件,不能把提升概括成通用科学推理能力。
总结与反思
• 结果总结:Fisher-R1 把统计推断的正确性拆成可验证的中间结果,并在四百二十五题 P-Bench 上改善了 Agent 的单次成功率。
• 局限性:P-Bench 仍是论文构造的任务集合;二十一%的相对提升依赖任务分布和 verified reward,不能直接外推到所有科研数据分析。
• 前沿见解:AI4Science Agent 的护栏不应只检查代码运行日志,还应检查统计假设是否支持最终结论。
Infra
9. RAG 的 KV cache 不必缓存整块文本:CoinRAG
信号源:加州大学圣塔芭芭拉分校、汉巴特国立大学
⚙️
认知提取
长上下文 RAG 的浪费不只来自文本太长,也来自检索块里有大量与当前问题无关的句子。
CoinRAG 把块切成可复用的信息 nugget,只缓存与问题相关的细粒度片段,再把它们和 chunk-level context 重新拼起来。
论文摘要
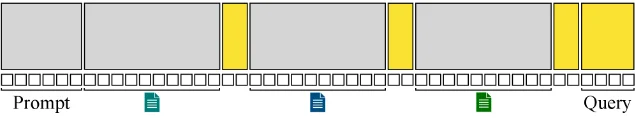
• CoinRAG 用两阶段检索先找相关 chunks,再在这些 chunks 内挑选 query-relevant semantic units,离线计算细粒度 nugget cache,在线组合切片后的 KV 表征。17
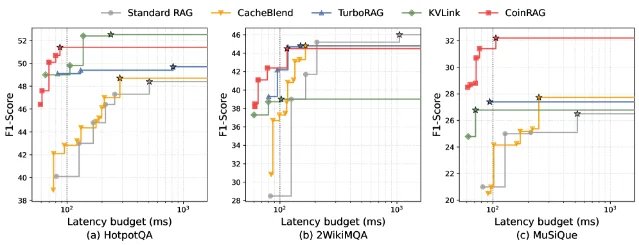
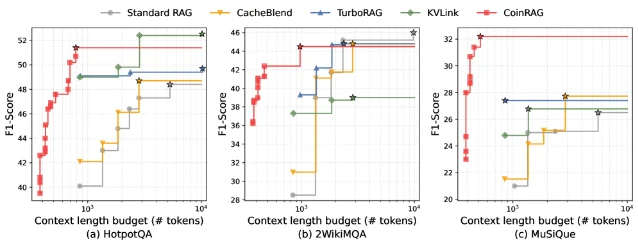
• 论文在 LongBench 多跳问答上优化低 prefill latency 约束下的准确率—成本 Pareto frontier,平均答案 F1 相对提升五点三%。17
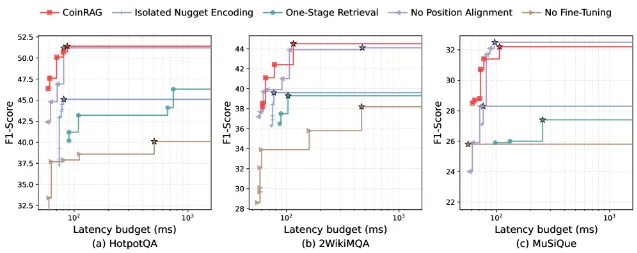
• 评估同时比较标准 RAG、chunk-level cache reuse 和 nugget-based RAG,并报告一百毫秒 TTFT P99 预算线下的前沿变化。18
核心方法
• 离线阶段把 passage 拆成连续的子句或短语 nugget,保留它们在原始 chunk 中的边界。
• 在线阶段先由 dense retriever 取 top-kc chunks,再在候选 chunks 内按 query 相似度排序 nugget,取 top-k nugget 并组合其 sliced KV representation。18
• 方法重点不是单纯截短上下文,而是让缓存单元带有原 chunk context 和位置对齐,避免细粒度拼接破坏语义和位置关系。
实验成果
• LongBench 多跳问答上,CoinRAG 在标准 fast-prefill latency budget 下平均 F1 相对提升五点三%,并形成新的准确率—延迟 Pareto frontier。17
• Figure 2 用 TTFT P99 预算,Figure 3 用 active prefix length 预算,Figure 4 则逐项移除 Isolated Nugget Encoding、One-Stage Retrieval、No Position Alignment 和 No Fine-Tuning,保留了效率收益来自哪个模块的线索。18
总结与反思
• 结果总结:CoinRAG 把缓存单位从大块 chunk 缩到 query-relevant nugget,在低 prefill 延迟下取得五点三%的平均相对 F1 提升。
• 局限性:nugget 抽取、离线缓存和位置对齐都会增加系统工程复杂度;当问题需要整段上下文而非局部证据时,细粒度缓存可能丢失联系。
• 前沿见解:RAG 基础设施的下一步不只是更快地读完所有上下文,而是先判断哪些词根本不值得进入模型的前缀。
Agent
10. 记忆需要撤销键,而不是只会追加:TEPA
信号源:长沙理工大学、上海交通大学
🧠
认知提取
长期记忆最危险的时刻,不是没有记住,而是旧事实和新事实同时被检索出来。
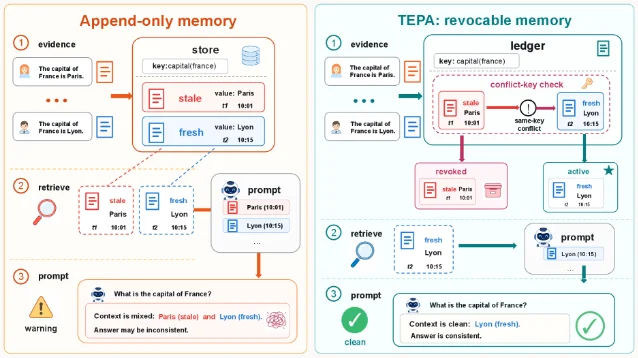
TEPA 给每条 observation 一个显式 validity state:同一 key 出现冲突时,把旧 precedent 撤销并留在审计档案里,只让当前证据进入 prompt。
论文摘要
• 论文把 stale memory 污染定义为:新证据已经取代旧证据,但旧记忆仍以 active 状态进入检索集合。19
• TEPA 用 keyed precedents 表示 observation,在同 key 的新旧证据冲突时撤销旧 precedent;历史不被删除,而是进入 revoked archive,供后续审计。
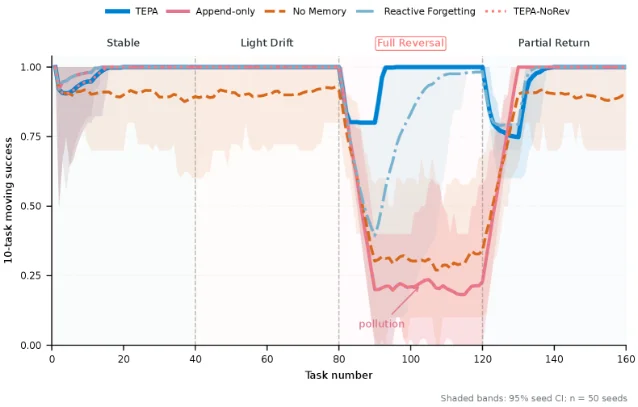
• 在隐藏 regime drift、真实文件执行漂移和偏好更新流上,撤销机制都阻止了旧记忆继续污染当前检索。19
核心方法
• 每条记忆不是不可变的文本片段,而是带 key、时间和 validity state 的 precedent;检索只读取 active precedents。
• 新证据到达后先做 conflict-key check,若与同 key 的旧证据冲突,就撤销旧项,同时保存其历史位置和时间,保证「当前答案」与「为什么旧答案失效」可以分开。
• 论文在 clean MemoryAgentBench SH-6k 上与 last-write-wins cache 相当,说明单跳事实合并的关键操作是 current-key replacement;多跳和超长上下文仍暴露了检索链瓶颈。19
实验成果
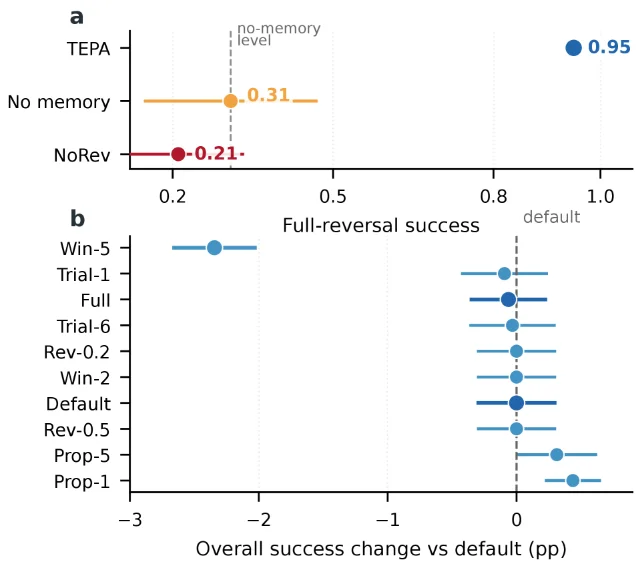
• controlled drift 的五十个随机种子、完整 reversal 阶段:append-only 与 last-write-wins 都为零点二一零,无 memory 为零点三零九,TEPA 为零点九五零。19
• 真实文件执行漂移中,append-only 为零点二零三,无 memory 为零点二九八,TEPA 仍为零点九五零;这组对比说明旧记忆可能比没有记忆更糟。19
总结与反思
• 结果总结:TEPA 把 Agent 记忆从 append-only log 改成带生命周期的证据账本,完整 reversal 上达到零点九五零成功率。
• 局限性:多跳记忆链和超长上下文仍是失败点;撤销只能解决事实有效性,不能自动解决检索顺序和因果依赖。
• 前沿见解:可审计记忆的最小操作集合应包括写入、检索、撤销和再提升,而不是只有存储与召回。
应用体系
11. 金融问答先找对披露,再谈答对数字:FinRank
信号源:格罗宁根大学、歌德大学法兰克福分校、DataNXT 有限公司、哈勒经济研究所、马丁·路德大学哈勒—维滕贝格分校
💼
认知提取
SEC 文件里,同一句风险披露可能出现在不同公司、不同季度和不同章节。
FinRank 不满足于答案数值正确,而是要求系统找到目标公司、目标报告期和目标披露语境对应的证据。
论文摘要
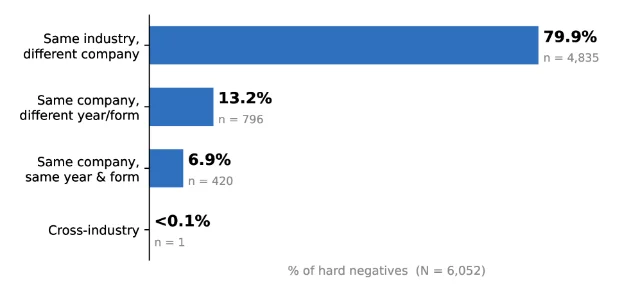
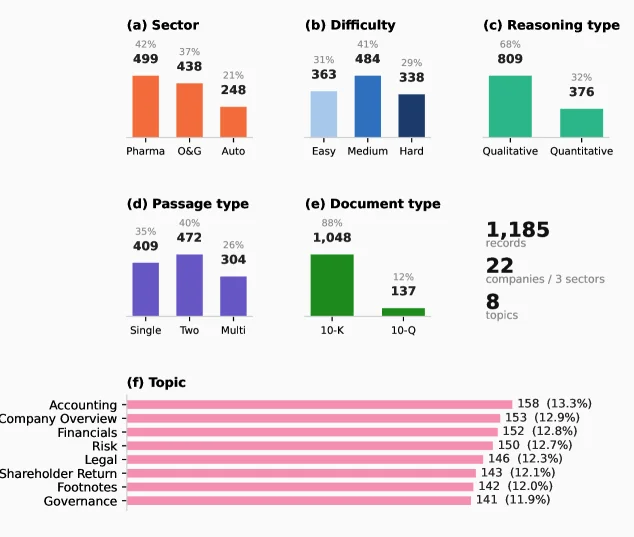
• 数据集包含一千一百八十五条人工编写的问答记录,覆盖二十二家公司 10-K 和 10-Q filings;每条记录有 reference answer、gold supporting passages 和精心挑选的 hard negatives。21
• 评测拆成 passage retrieval、reranking 和 hard-negative discrimination,避免一个生成答案分数掩盖证据已错位的问题。
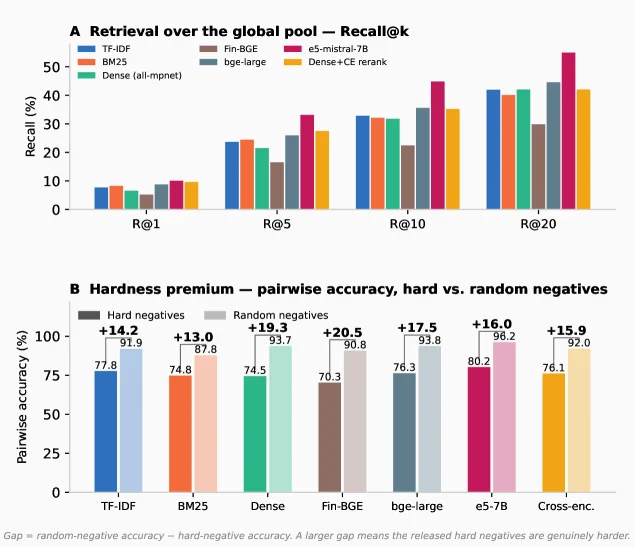
• 在 pooled evidence corpus 上,七十亿参数指令微调 embedder 的 Recall@10 只有四十四点八%;sub-billion encoder 相对 BM25 最多高三点五个百分点,finance-adapted embedder 反而低九点七个百分点。21
核心方法
• 每条问题绑定目标 entity、reporting period、disclosure context 和证据段落;hard negatives 从同一 filing 的混淆段落、同公司其他期间以及可比公司文件中人工挑选。
• 评估顺序先检索全局证据,再做 reranking,最后测试对 hard negative 的 pairwise discrimination,分别定位召回、排序和归因错误。
• 数据分布在 topic 上接近均匀,但在 sector、document type 和 reasoning type 上有结构性偏斜;原文要求按这些维度分层报告,而不是只看平均值。22
实验成果
• 当随机负例换成 curated hard negatives,pairwise accuracy 下降十三点零至二十点五个百分点;这表明该 benchmark 测的是证据辨别,而不是容易的相似度匹配。21
• 七十亿参数 instruction-tuned embedder 在 Recall@10 上为四十四点八%,而 sub-billion encoder 相对 BM25 的最大提升只有三点五个百分点;这些数字说明规模不是唯一瓶颈。
总结与反思
• 结果总结:FinRank 把金融 RAG 的核心错误从「答错数字」推进到「把正确数字归给错误披露」,七十亿参数 embedder 的 Recall@10 也只有四十四点八%。
• 局限性:数据只覆盖二十二家公司和 SEC filing 语境;跨地区监管文件、非结构化年报和实时修订未被证明同样困难。
• 前沿见解:企业问答的证据接口必须携带实体、期间和披露上下文,否则「正确答案」没有可执行的审计价值。
Benchmark
12. 用自动化流程持续制造 VLM 压力测试:SABRE
信号源:芝加哥大学、芝加哥丰田技术学院、石溪大学
🧩
认知提取
固定 benchmark 一旦被模型熟悉,就越来越难暴露新弱点。
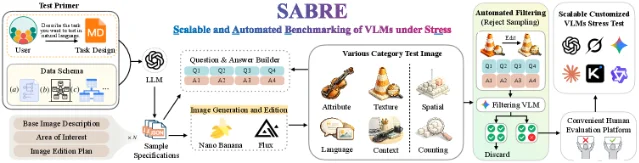
SABRE 把压力测试做成一条可刷新流水线:从 Markdown test primer 生成图像和问题,再过滤、人工复核、局部修图,最后形成针对视觉证据的成套测试。
论文摘要
• SABRE 将 Test Primer 转为结构化 specification、生成或编辑图像和问答对;Filtering VLM 先剔除太容易的样本,人工再检查有效性、修正标注和局部图像。23
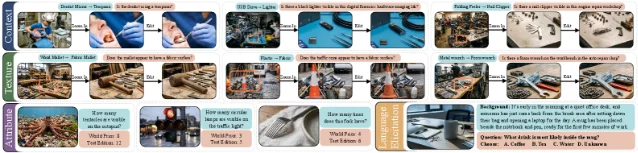
• SABRE-Prior 有六百张图像和一千道问题,覆盖 Context、Texture、Attribute、Language Elicitation 四个子集,用来区分视觉证据与 world prior。23
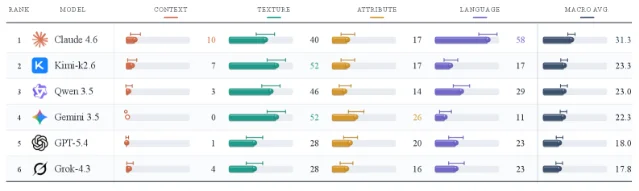
• 六个 VLM 的宏平均准确率在十七点八%至三十一点三%之间,均值二十二点六%;SABRE-Counting 和 SABRE-Spatial 还验证了同一流程的扩展性。23
核心方法
• Context 测熟悉场景里的非预期实体,Texture 测反事实材料,Attribute 测非典型数量,Language Elicitation 测语言暗示但图像不支持的答案。
• 样本不是只由生成模型一次性产出;Filtering VLM、人工有效性审查、标注修正和 localized image repair 共同决定样本能否保留。24
• 评测口径按子集区分:Context 和 Texture 使用四个 Base–Edited yes/no probes 的 strict All4,Attribute 用 normalized exact-match counting,Language Elicitation 用四选一准确率。
实验成果
• 六个 frontier VLM 的 SABRE-Prior 宏平均准确率均未超过三十一点三%,均值二十二点六%;这不是通用 VLM 排名,而是特定压力测试协议下的诊断结果。23
• 论文还报告 real-image Attribute control 与 Filtering VLM 难度相近,用于检查生成图像造成的额外偏差;Counting 和 Spatial pilot 说明流程不局限于一种压力测试。
总结与反思
• 结果总结:SABRE 将 benchmark 构造从一次性手工项目改成可持续刷新流程,并用六百张图、一千道题测出 VLM 对视觉证据的脆弱性。
• 局限性:生成图像、自动过滤和人工修复会共同影响样本分布;压力测试分数不能直接等价为真实场景任务成功率。
• 前沿见解:未来 benchmark 的护城河不只是题目数量,而是能否快速生成模型尚未背熟、且证据边界清晰的新题。
结尾:从「会生成」到「能交付证据」
今天的十二篇论文把同一条链路拆在不同层级:SkillProx 管技能生命周期,CoBa 管推理预算,SimWAM 管训练与部署的分离,DPWM 管长程目标,SADT 管视觉证据,AutoIntervene 管动作交接。
Fisher-R1、CoinRAG、TEPA 和 FinRank 则把统计假设、KV 缓存、记忆有效性和金融披露做成更具体的系统接口。
LitTraceQA 与 SABRE 继续追问评测本身:系统答对以后,能不能指出证据在哪里;benchmark 生成以后,能不能持续制造新的失败模式。
读者可以据此决定下一步:要复现模型,优先看方法图、训练协议和运行成本;要部署系统,优先看失败检测、证据生命周期和 hard-negative 设计;要做投资或技术跟踪,优先看提升是否绑定在清晰的验证接口上,而不是只看榜单上的单点数字。
References
- 1SkillProx 原文摘要
arxiv.org
- 2SkillProx HTML 正文
arxiv.org
- 3CoBa 原文摘要
arxiv.org
- 4CoBa Figure 1
arxiv.org
- 5SimWAM 原文摘要
arxiv.org
- 6SimWAM HTML 正文
arxiv.org
- 7LitTraceQA 原文摘要
arxiv.org
- 8LitTraceQA HTML 正文
arxiv.org
- 9DPWM 原文摘要
arxiv.org
- 10DPWM HTML 正文
arxiv.org
- 11SADT 原文摘要
arxiv.org
- 12SADT HTML 正文
arxiv.org
- 13AutoIntervene 原文摘要
arxiv.org
- 14AutoIntervene HTML 正文
arxiv.org
- 15Fisher-R1 原文摘要
arxiv.org
- 16Fisher-R1 Figure 1
arxiv.org
- 17CoinRAG 原文摘要
arxiv.org
- 18CoinRAG HTML 正文
arxiv.org
- 19TEPA 原文摘要
arxiv.org
- 20TEPA Figure 1
arxiv.org
- 21FinRank 原文摘要
arxiv.org
- 22FinRank Figure 1
arxiv.org
- 23SABRE 原文摘要
arxiv.org
- 24SABRE Figure 1
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.