「表示会收敛」被证成定理,前提是那两句话说的是同一个场景
LeCun 与 Balestriero 把「柏拉图表示」从猜想变成了定理:正样本只要是同一场景的两次观测,分别训练的不同模态编码器就只差一个旋转。本篇核对定理的每条前提、42 倍与 109M 对 72B 的口径,以及作者写在「已知局限」里的那条最重保留意见。

「表示会收敛」这件事,第一次有了一个覆盖实际训练目标的证明。而这条证明的结论,到不了今天的语言模型。
10 月 29 日,arXiv 上出现一篇 37 页的论文:《Proving and Improving the Platonic Representation Hypothesis with JEPAs》。1
作者两人。Randall Balestriero 署名布朗大学与 AMI Labs;Yann LeCun 署名纽约大学与 AMI Labs,也就是他自己那家做世界模型的公司。2
LeCun 这个结论讲过很久。2024 年 1 月,他拿四岁孩子四年看到的数据,跟最大的语言模型读过的全部文本比了个大小,结论是「文本太低带宽、也太稀缺」。5
这一篇把重点挪到了正样本怎么挑。
01 这次发布的重量
「定理」这个词在这里担得起。它的传播量担不起。
论文是 v1,37 页,3.6 MB,提交时间 2026 年 10 月 29 日 03:49:53 UTC,北京时间当天中午 11 点 49 分。1
线程首帖到 10 月 31 日凌晨拿到 471 个赞、2.04 万次浏览、88 次转推、12 条回复。3
LeCun 那条转推被看了 2,511 次。4
Hacker News 上没有这条论文的条目,X 上也没有长文讨论。
媒体侧的跟进只有一篇:AI Weekly 的「Found First」栏目在 10 月 30 日晚上八点发了一篇编辑博客,标题把 42 倍直接写了进去,并注明这是媒体还没覆盖的一手来源。6
我找到的第三方总结只有一条,把证明逻辑复述了一遍,并指出它与正则化方法 SACReg 的关系。7
这条线也不孤立。2025 年 11 月,同一组人拿出 LeJEPA,一套不用启发式的自监督训练配方,这一篇的全部实验都建在它上面。10
10 月 11 日,同一个小组的另一篇 LeHami 把 JEPA 的预测器换成了辛哈密顿流。11
02 定理证的是什么
定理的内容几乎全在前提里。它做的事,是把「同一个世界」这四个字写成了一个能被检验的条件。
设定很短。世界是一组有限的状态 z;每个模态通过一个注入式渲染把状态变成观测,图像是像素,文本是词元。2
JEPA(联合嵌入预测架构)是 LeCun 推的那条路线:不重建像素,只在嵌入空间里做预测。它只在正样本对上训练,也就是两个被声明为「同一场景的两次观测」的输入。目标函数是一项预测误差,加一项防塌缩。
定理 1 的陈述是:两个以上的模态只要共用一个正样本分布,且目标函数的最优解在旋转意义下唯一,就存在一个世界的嵌入,每个模态各自训练出的最优编码器,都是它的一个旋转。2
任意两个模态之间,只差这两个旋转的乘积。
证明只有一句话:每个编码器复合上自己模态的渲染,都在最小化同一个目标函数,所以它们都是那同一个最优解。2
重量落在「唯一」两个字上。
命题 1 把唯一性落在三个条件:平方误差、嵌入白化(均值零、协方差是单位矩阵)、正样本网络(状态是节点,正样本对是边)的谱有缺口。满足这三条时,最优解就是这张网络的前 k 个特征向量,也只差一个旋转。2
定理 2 处理正样本不完全一致的情况:两个正样本网络差多少,嵌入就差多少,再除以谱的缺口。作者在 300 个随机世界上验过,误差都落在界以下,最多到界的 18%。2
作者在引言里先交代了此前的位置:最接近的证明,覆盖的是用 SGD 训练的深层线性网络。2
前提于是数得出来:有限世界、注入式渲染、总体最优解、各模态正样本同分布、最优解唯一。
作者自己划掉了三样。
预测器取的是恒等;真正当世界模型用的 JEPA 会学一个预测器,常常还带动作条件,「我们的分析不覆盖」。2
LeJEPA 的防塌缩项按嵌入的前两阶矩(均值和协方差)纳入;它原本要求嵌入服从一个完整的高斯分布,那种更强约束下的唯一性,作者留成了假设。
最后一处最要紧:没有一组实验严格满足第 2.1 节的假设,他们用的是 LeJEPA,图像侧多半拿裁剪当正样本。
这是一条诚实的定理。它把覆盖不到的部分,写在了前三页。
03 好视图这个词,是全文真正的发明
定理本身只说明了一件事:目标函数里看不出模态,解里就不该有模态。真正的信息在论文怎么处理正样本上。
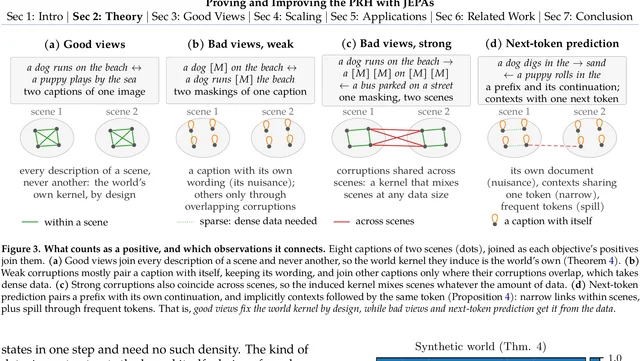
好视图:同一个世界状态的两次观测。两张照片、一段视频的两帧、同一张图的两条人写描述。2
坏视图:同一次观测的两次破坏。一张图的两个裁剪、一句话的两次掩码。
两者的差别,定理 3 给了一个下界。
两个白化过的编码器,在配对观测上的最优旋转误差,至少是 2k 乘上「1 减去被世界状态解释的比例」。那个比例记作 ρ,等于 1 当且仅当编码器只是世界状态的函数。2
翻成人话:每一个花在自己模态细节上的方向,都留在那儿了。旋转只能转,换不回世界的维度。
命题 3 补上判据。坏视图保住细节的强度,超过它保住世界第 k 个方向的强度时,维度就落到细节上。2
裁剪保住的是视角和光照,掩码保住的是措辞;两者都强于它们对场景的保留。
同一个场景的两张不同照片,共有的只剩场景。
04 语言模型是怎么被放进来的,作者自己标了「猜」
这里是分水岭。从这里开始,证明结束了,剩下的是类比加实测。
命题 4 拆的是交叉熵。
带线性 softmax 头的下一词损失,可以逐项写成「预测项」加「配分函数的对数」。前者对应 JEPA 的预测误差,后者对应防塌缩项。形式上,下一词预测就是一个双编码器的 JEPA:一个编码器把上下文变成向量,另一个把词表里的每个词变成向量。2
它还给了两条性质。温度趋于零时,配分项收敛到最大 logit,损失变成间隔。在满支撑条件下,最优解满足两个向量的内积等于对数概率,加一个只与上下文有关的偏置。
命题 4 的第三条最要紧:这个解集在任何可逆线性变换下都不变。
下一词预测的嵌入,最多被识别到一个可逆矩阵,连「只差一个旋转」都到不了。定理 1 的结论到这里失效了。2
作者的措辞很规矩。他们两次把这一步写成「启发式地」,一次写「这是要去检验的预测,不是推论」。2
所以准确的说法分两层:下一词预测的形式是 JEPA,这有证明;它跟视觉对不齐,这有实测。中间那一步是猜的——猜得有道理,也写明了是猜。
05 那个 ρ 是能量出来的
全文最硬的一段,是一个别人能重算的数。
Flickr 的每张图有五条人工描述,正好是「同一场景的五次观测」。2,014 张验证与测试图,就能估出被世界状态解释的那部分占多少。2
取 k=32 时,好视图编码器的 ρ 是 .804,坏视图 .655,下一词预测 .608,种子之间差 ±.005。
定理 3 的下界于是给出 12.6、22.1、25.1。三个数跟后面的 33.5、39.4、40.3 是同一个量:嵌入差的平方期望,0 表示完全对齐,2k(这里是 64)表示毫不相关。2
界成立,排序一致,界本身很松:实测是下界的 1.6 到 2.7 倍。
松不要紧。这一段只用五条人写描述之间的差,是全篇最不依赖语料来源的一组数。
「坏视图把维度花在措辞上」这个判断,全文只在这里被直接量出来。
06 42 倍的三层口径
42 倍这个数是对的。它是三个数里的一个,另外两个更保守。
论文用的基准是原论文留下的 WIT-1024:1,024 对图文,指标叫 mutual 10-NN,两边嵌入各自找最近十个邻居,看两组邻居重合多少,随机基线是 .01。2
同一份语料、同一个 109M 编码器:好视图用 2,160 万样本把 mutual 10-NN 做到 .109,下一词预测用 9 亿样本做到 .111。
样本数是 42 倍。词元数是 14 倍,因为一个好视图样本要读三条文本。唯一图片数是 435 倍:9.4 亿张对 216 万张。
三个数放在一起才公平。好视图那侧,2,160 万样本对应 216 万张图的文本,等于把同一批文本过了约十遍;下一词那侧是 9 亿个样本,取自 9.4 亿张图对应的文本。
还有一处口径:下一词那侧只评了一个检查点。论文自己写着「我们没有评更早的下一词检查点」,所以 42 倍是从一个点比出来的,没有曲线。2
那一侧三个种子的分数是 .109、.111、.112。好视图的 .109 正落在下沿。
论文还给了一条对齐的缩放定律:45 个格子拟合到 RMSE .007,然后先登记、再训练 85 次,预测误差 .0093;同一次跑换两个种子的差是 .0096。
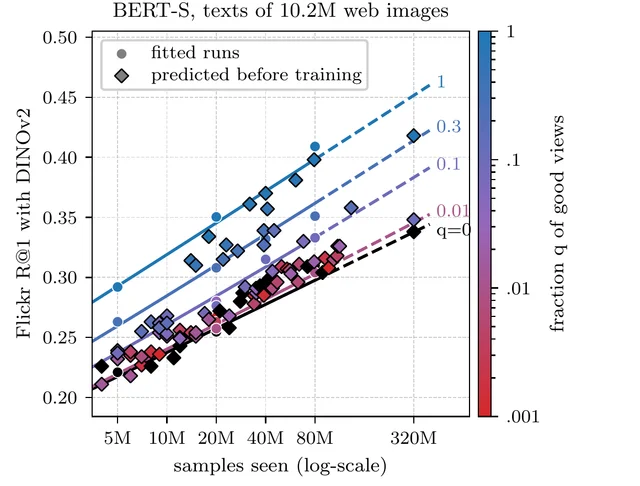
定律的外推有条边。到 3.2 亿样本、也就是把语料过了 31 遍时,它开始高估好视图那侧;公式里没有为重复数据留项,指数也说不清。2
07 109M 对 72B:先看表,再看附录
这是论文摘要里最抢眼的一句,也是口径叠得最多的一处。
在原论文《The Platonic Representation Hypothesis》的 WIT-1024 上,109M 的文本 JEPA 与 DINOv2 的 mutual 10-NN 是 .184。2
对照:Qwen2.5-72B 是 .154,Llama-3-70B 是 .151,CLIP 的文本编码器 .124,all-mpnet 是 .118。换成 CLIP ViT-H 当图像端,好视图 .230、Qwen2.5-72B .210;换成 COCO 的 5,000 对,好视图 .161、Qwen2.5-72B .108。
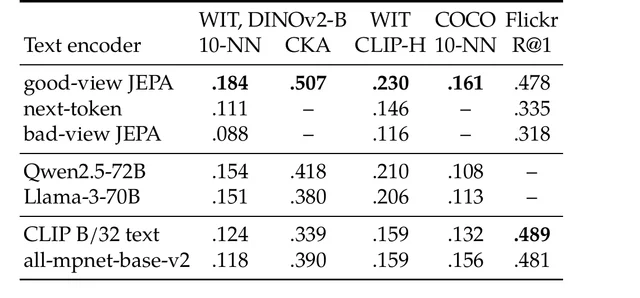
那个 .184 是论文主配置下三个种子的均值:.179、.181、.191。
附录里有另外几个数。
第四个种子用了双倍的防塌缩权重,在 WIT 上只有 .121。四个种子合起来,均值掉到 .168。2
四个种子平均之后,配 CLIP 的 B、L、H 三档图像端分别是 .198、.202、.212;最好的语言模型是 .193、.203、.210。两档赢 .005 以内,一档低 .001。
权重也不是事先定的。原文写着:看到那个 .121 之后,他们把第一个种子的权重沿用到了其余所有 940M 规模的跑次,并注明「这个权重是在 WIT 上选出来的」。2
最后是基准本身。WIT-1024 只有 1,024 对,作者用 200 个 800 对子集算了 95% 区间:好视图与 3B、7B 语言模型之差,区间都跨零。2
所以主配置的 .184 对 .154 站得住;四个种子都算进去,.168 仍高于表里每个语言模型,只是与 CLIP 的三档图像端拉平。至于「每一档图像端都赢」,取决于用几个种子、用哪个权重。
08 最重的那句,写在「已知局限」里
训练文本里,三条有两条是模型写的。作者自己把它列成「主要保留意见」。
语料来自 Recap-DataComp:每张网页图配一段 alt-text,再加两条重述。重述由一个跑在 LLaMA-3-8B 上的图像描述器写出,它的视觉端是 CLIP ViT-L/14。2
也就是说,那个「从没见过像素」的文本编码器,读的文本是看过这些图像的模型写的。
作者写得很直白:这是主要的保留意见,因为那些文本本身带着图文训练蒸馏出来的信息。2
他们给了对照。把重述全部拿掉,只用 alt-text 加一条纯文本改写去当好视图,WIT 上的对齐是 .060;用重述是 .107。
这处保留意见的作用范围也清楚。与语言模型、与 CLIP 文本编码器的比较,依赖这批文本;好视图、坏视图、下一词预测三者之间的比较用的是同一批文本,那部分不受影响。
还有一处小重叠:1,024 条 WIT 描述里至少 43 条出现在 Recap 的 alt-text 里,删掉后九个文本模型的变动都小于 .002。2
图像那侧有同类的自我限定。按他们自己的定义,实验里的图像编码器和 DINOv2 都是坏视图,正样本是一张图的裁剪;超参只为好视图调过。
09 与 DINOv2 对齐,到底意味着什么
这个问题论文没有回答,而所有头条数字都建在它上面。
mutual 10-NN 量的,是两个空间看世界的方式像不像;「哪个模型更懂世界」是另一件事。
目标那一侧恰好是个麻烦。DINOv2 的正样本是一张图的多个裁剪,按这篇论文自己的定义,它是坏视图 JEPA。12
定理 3 说,对齐误差的下限由两边 ρ 的较小者决定。DINOv2 的 ρ,论文没有测。
于是 .184 说的是:这套文本嵌入与 DINOv2 的嵌入更接近。比的是一致性,参考系就是 DINOv2。
对齐与好用,也是两件事。同一批编码器在 2M 张网页图的文本上训完,STS-B 句子相似度是:好视图 .612,坏视图 .501,下一词预测 .377;好视图那档的数据加到 5,000 万张图,是 .632。同规模的 BERT-base 是 .551,在十亿句对上训过的 mpnet 是 .834。2
10 这套理论现在能用的地方
被这篇论文改变的是参数怎么分配,不是榜单。
第一个应用:一个不用图文对训练的描述器。
解码器只在文本上训,把冻结的 JEPA 嵌入还原成那句话;训练时按对齐误差加噪,噪声强度直接由公式定出来(σ≈3)。要描述一张图时,图像过 DINOv2,乘上那个旋转,再解码。2
唯一在图文对上拟合过的部分,只有那个旋转。
用 Qwen2.5-1.5B 当解码器、DINOv2 ViT-g 与 DINOv3 ViT-L 当冻结图像端,在 COCO 上是 CIDEr .838。对照:CapDec 是 .918,DeCap 是 .912,这两家都用 400M 图文对训过编码器。2
更能说明问题的是那组替换实验。把那个旋转换成一个自由线性映射,Flickr 上分数更高(.531 对 .504),COCO 上掉两成(.635 对 .802)。
形状锁死的那个映射跨得过去;能自由拟合的那个,只拟合本域。
第二个应用:连对都没有。
用别人那套无对方法、原代码、原超参,109M 的文本 JEPA 在 COCO 上拿到 FOSCTTM .018,零样本 ImageNet-100 top-5 是 64.4%,CIFAR-100 top-5 是 67.2%。2
论文引的那份无对基准(Schnaus 等)里,21 组视觉与语言模型的最好成绩是 56%。同条件重跑他们最强的 Qwen3-8B,ImageNet-100 是 47.6%。
CLIP 的文本编码器在同一张表上是 68.7%,仍然更高。2
11 该盯什么
四个可以跟的信号,按先后排。
最近的是独立复现。现在是一组人、一个 v1、两天、没有同行评审,媒体只有一篇汇编式博客,第三方讨论只有一条总结帖。定理不难验;实验要复现,先得有那 9.4 亿张图,再跑一遍描述器。
其次是去掉重述之后的读数。.060 对 .107 是现成的起点:如果好视图相对坏视图的优势,在纯人工文本上依然成立,「效率」这个结论就稳;如果不成立,效率这个结论就得重写。
第三是好视图在真实数据里从哪来。作者自己在回复里承认:实际设置里正样本是用户设计的,怎么找到对的正样本,是一个大的开放问题。13
最后是「对齐」这个指标本身。与一个坏视图编码器对齐,测到的是世界,还是那个编码器的偏好——这件事目前没有答案,而所有头条数字都建在它上面。
定理把问题从「要多大的模型」,挪到了「哪两句话说的是同一个场景」。
后者便宜得多,也难自动化得多。
References
- 1
- 2论文 PDF
arxiv.org
- 3
- 4@ylecun 转推
x.com
- 5@ylecun 2024-01-25 帖
x.com
- 6
- 7@HaiyuWu1 总结帖
x.com
- 8galilai-group/prh-proof · GitHub
github.com
- 9PRH 在线演示 · Hugging Face
huggingface.co
- 10LeJEPA · arXiv
arxiv.org
- 11LeHami · arXiv
arxiv.org
- 12DINOv2 · arXiv
arxiv.org
- 13@randall_balestr 回复
x.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.