Google DeepMind 把水印写进了蛋白质:能验出来,也能洗掉
Google DeepMind 把 SynthID 水印写进 AI 设计的蛋白质序列与预测结构;本期核完它的实测数字、论文自己列出的失效清单,以及它要插进去的那层 DNA 合成筛查现在是什么状态。

Google DeepMind 把水印从图片和文本搬到了蛋白质上,让 AI 设计的分子带着一段能被验出的水印;同一天,《自然》的新闻版上线一篇报道:这层水印可以被抹掉。
2026 年 9 月 30 日,Google DeepMind 发布 SynthID Bio,把自家的 SynthID 水印技术带进合成生物学。1
官方博文的上线时间是当天 15:00(UTC),即北京时间晚上 11 点。1
同一天,这项工作以论文形式在线发表在《自然》上,标题是《Function-preserving watermarking of AI-generated proteins》。2
论文共 21 位作者,署名机构只有一家:Google DeepMind(伦敦);David Stutz 与 Alexander I. Cowen-Rivers 为共同一作,通讯作者是 David Stutz 与 Pushmeet Kohli。2
当天 17:27(UTC),Demis Hassabis 在自己的 X 账号上转发团队公告,写下一句判断:3
Biosecurity is one of the most urgent challenges for the AI era. Bringing SynthID to biology so AI-generated proteins can be watermarked is a critical step - and we're open sourcing SynthID Bio tools so the research community can build on this work.
(生物安全是 AI 时代最紧迫的挑战之一。把 SynthID 带进生物学、让 AI 生成的蛋白质能被水印标记,是关键一步;我们正在开源 SynthID Bio 的工具,让研究界能在此基础上继续做。)
这句话里有三个动作:先把生物安全称作这个时代最紧迫的挑战之一,再说把 SynthID 带进生物学是关键一步,最后说工具正在开源。
而同一天,《自然》的新闻版也上线了一篇报道,标题是《Secret watermark labels proteins as 'made by AI'》,副标题写着:这枚数字标记可以被抹掉(the digital marker can be erased)。4
01 这条发布是什么
SynthID Bio 是一族方法:序列侧一套,结构侧一套。
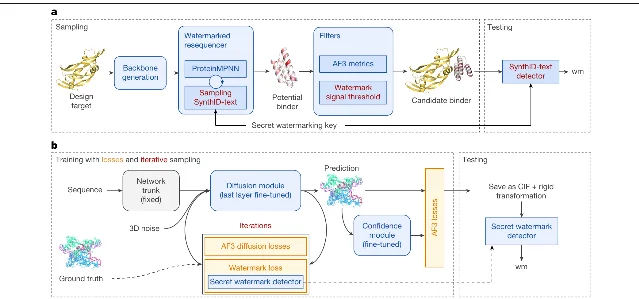
官方把 SynthID 在文本水印上用过的那套采样技巧搬到氨基酸序列上,得到 SynthIDBio-sequence;又微调了 AlphaFold 3 的扩散网络,让模型预测出的 3D 坐标本身携带水印,得到 SynthIDBio-structure。1
序列侧的证据来自湿实验。
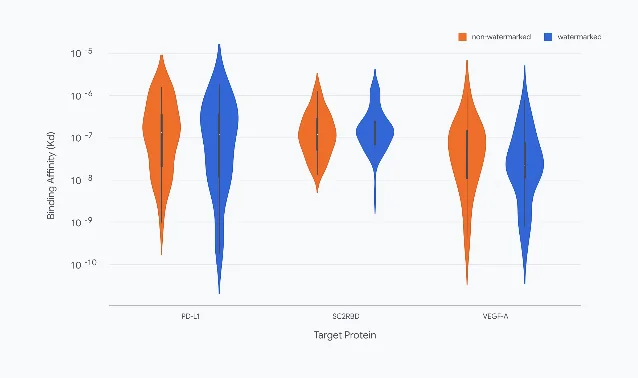
论文选了三个靶点:血管内皮生长因子 A(VEGF-A)、新冠病毒刺突蛋白受体结合域(SC2RBD)、程序性死亡配体 1(PD-L1)。2
水印可以按参数分档,论文把不同的参数组合称为「水印设置」。每一组设置下,体外评价都包含 222 条无水印序列与 267 条水印序列。2
其中两个参数需要先交代:一个是采样温度,取 0.1、0.3、0.5 等值;另一个是水印会不会改变采样分布——不改的称「非差异型」,会改的称「差异型」。2
结论写在论文正文里:用双尾 Wilcoxon 秩和检验看,水印设计与无水印设计在表面等离子共振(SPR)测得的结合亲和力上,群体层面没有显著差异。2
检出率那边,论文给的读数是:按 0.1% 假阳率校准出阈值之后,这些体外设计的真阳率直接达到 100%。2
例外只有一处,论文自己写了出来:指向 SC2RBD、使用差异型 0.1 档的水印设计,其中位 KD 显著低于非差异型 0.5 档——也就是结合得更强。2
官方博文据此写下一句带「首个」的话:水印设计与无水印版本在命中率、结合亲和力、天然序列多样性上相当,「成功造出了首个既有水印又具备生物学功能的蛋白结合体」。1
这句「首个」有三个限定:蛋白结合体、带水印、功能保持。少任何一个,这句话都不成立。
结构侧是另一条路,验证方式也不同。
论文报告,按 0.1% 假阳率校准后,三个结构水印模型的真阳率都超过 99.8%。这三个模型按训练时注入坐标的均匀噪声幅度分档,s 取 0.001、0.01、0.1 埃。2
「开源」在这里分成了三份:代码、体外数据、模型权重。
代码和数据在 GitHub 仓库
google-deepmind/synthidbio,许可为 Apache-2.0,仓库里另有一个体外数据目录(1,628 个文件,含三个靶点的 SPR 动力学曲线),单独以 CC BY 4.0 发布。5权重的发布走另一条路。
仓库 README 的英文原话是:「For full instructions on downloading model weights and running watermarked structure predictions with AlphaFold 3, please refer to the AlphaFold 3 Repository.」(下载权重、用 AlphaFold 3 跑带水印结构预测的完整说明,请见 AlphaFold 3 仓库。)也就是说,权重要走那套需要申请、并接受使用条款的既有渠道。5
02 水印怎么写进去,又怎么读出来
序列侧的做法,论文把它叫「锦标赛采样」。
这里先说清工具:ProteinMPNN 是一个常用的蛋白质序列设计模型,给它一个骨架,它逐位生成对应的氨基酸序列。本来它每一步是在一个概率分布里挑;SynthID Bio 接进去之后,用一个只有模型方知道的密钥参与这个挑选,把分布往特定的方向上偏。2
挑选的规则是打分:每一个候选氨基酸会被评 0 分或 1 分,让若干候选互相比较,得分高的留下。密钥不同,最终留下的那串序列就不同。2
关键在于,这套偏置不会把蛋白质改坏。
因为筛选环节还挂着 AlphaFold 3 的结构指标,只有同时过得了结构与水印两道阈值的候选才能留下;官方博文的原话是:「In experiments, these adjustments did not compromise the protein's biological function」(在实验中,这些调整没有损害蛋白质的生物学功能)。1
读的时候需要的也是这把密钥。
检测方重新计算序列上的统计量,水印序列的得分会整体偏高,无水印序列的分数则落在 0.5 附近——论文把 0.5 定为没有水印时的期望值。2
这是一个「零比特」方案。
论文把它写得明白:SynthIDBio-sequence 不支持编码比「有无水印」更多的信息。2
所以它能回答的问题是「这段设计是不是出自这个模型的这把密钥」,答不了「出自谁的手」。
结构侧换了个思路:把水印写进模型本身。
论文在 AlphaFold 3 的扩散损失旁边,加了一项水印损失,一起训练扩散模块与置信度模块;跑起来之后,任何人用这个微调过的模型做预测,出来的坐标里都带着水印。2
训练成本有确切数字:用 256 张 A100 微调约一天,而 AlphaFold 3 的全量训练约 20 天。2
检测器的交付与模型分开。
论文的英文原话是:「The detector remains secret and is not shared with users of the fine-tuned AF3 model.」(检测器保密,不分享给微调版 AlphaFold 3 的使用者。)2
03 论文自己列出的失效清单
把论文的「局限与未来工作」与讨论两节摊开,能看到一份完整的攻击面清单。
| 攻击或扰动 | 论文报告的结果 |
|---|---|
| 用 ProteinMPNN 重新测序(对 38,396 个设计做的重新测序攻击) | 论文写「这一做法有效地移除了水印」。带过滤器时估算命中率降到 97%(SC2RBD)、70%(PD-L1)、66%(VEGF-A);不带过滤器只剩 33%、20%、3%。2 |
| 约束弛豫(OpenMM 配 Amber99sb 力场) | 论文写「成功地摧毁了水印」。2 |
| 在已生成的结构上加高斯噪声(标准差 0.1 埃) | 会破坏小 s 的水印;但以 s=0.1 训练的模型仍能维持 88.5% 的真阳率。2 |
| 结构过短(少于 16 个残基) | 检出率普遍下降;残基数到 32–48 以上就很快超过 99%。2 |
| 设计完成后手工改动,例如加一段 C 端表达标签 | 水印信号按改动所占的相对大小成比例稀释。2 |
| 只对订单的一部分打水印 | 假阴性风险上升。2 |
| 使用者直接关掉 | 序列侧的机制接在采样的解码环节里,论文写它「很容易被使用者移除或关闭」。2 |
| 蓄意稀释后闯关 | 论文假设了一种手法:把一段短的有害序列接到带水印的设计上,赌水印信号被稀释后订单仍能快速放行。2 |
| 区分不同使用者 | 结构侧同样是零比特方案,无法区分多个用户。2 |
这张表里最值得停一下的是第一行。
重新测序的成本不高——论文自己点出,ProteinMPNN 已经有浏览器版,这进一步压低了发动这类攻击的技术门槛。2
论文紧接着写道:文本与图像水印上也有同类的「再生攻击」,尽管相关防线近年有重大进展,这类攻击依然有效。2
代价那一侧,论文也给了两个数字,方向相反。
水印筛选会压低通过率:非差异型 0.5 档、0.1% 假阳率下,通过率下降 41.7%,按论文给的等式换算,要拿到同样多的可用设计,候选数量得增加到约 1.7 倍。2
但整条流水线里最贵的一步是 AlphaFold 3 的结构验证,而被水印阈值挡下的候选不需要跑这一步,所以论文的结论是:序列侧在实践中增加的开销可以忽略。2
论文还给这层水印写了一句定位:基因合成行业历史上追求的是抬高入行门槛,SynthIDBio-sequence 的目标与之一致。2
官方博文只留了一句:「接下来的关键挑战,包括让水印对蓄意篡改更稳健。」1
还有一处可以在论文里直接读到的细节:它的同行评审信息实名列出了三位评审人——James Diggans、Eric Horvitz、Florian Praetorius,其余保持匿名;而 James Diggans 同时是官方博文里被引的 Twist Bioscience 高管,也是论文致谢里「就生物安全视角进行过富有成效讨论」的对象,还是 2025 年那篇《科学》论文《Strengthening nucleic acid biosecurity screening against generative protein design tools》的合著者。2
04 它要补的那个缺口,现在的状态
官方博文给这层水印的位置,是一个「瑞士奶酪」式的比喻:多层独立的防护互相盖住对方的孔洞,模型层的缓解措施是一层,客户尽调是一层,水印是嵌在设计本身里的验证层。1
SynthID 进生物这条线,7 月就已经铺开。
2026 年 7 月 16 日,Google DeepMind 与姊妹公司 Isomorphic Labs 联合发布生物韧性(bioresilience)方案,里面已经写明:正在把 SynthID 水印技术适配到生物学,这可能帮助 DNA 合成商筛查有风险的 AI 生成序列。6
这份方案里要补上的那层防护,名叫 DNA 合成筛查。
它做的事是:一份合成订单交上来,供应商拿序列去比对已知的危险清单,比对不上就人工复核。7
这套规则出自国际基因合成联盟(IGSC)。按该联盟自己的说法,全球商业化的长链核酸合成产能,大部分掌握在它的成员手里;协议要求对 200 个碱基对以上的序列做筛查,比对的是联盟自建的受限病原体数据库(Restricted Pathogen Database)。7
协议现行版本是 2024 年 9 月 3 日的第 3.0 版,属于行业自律,没有法律强制力。7
采纳率是更硬的问题。
国际生物安全与生物安保科学倡议组织(IBBIS)在 2025 年 6 月给欧盟生物技术法案提意见时给出的数字是:那时只有 15% 的合成 DNA 供应商实施了风险序列筛查。8
美国这一侧,规则的支点在科研经费上。
据美国国会研究服务处 2026 年 9 月 15 日更新的快报,美国的生物安全领域至今没有一部统管全局、带可执行罚则的联邦法律;管合成筛查的主要是 2024 年 4 月 29 日白宫科技政策办公室发布的框架,它把联邦资助的生命科学研究绑定在「向合规供应商采购」上。9
2025 年 5 月 8 日的行政令 EO 14292 要求科技政策办公室修订或替换这份框架,而该快报写着:直到这份快报更新时,科技政策办公室仍未更新 2024 年框架。9
门槛也不一致:美国那套框架要求供应商与台式合成设备商从 2026 年 10 月起按 50 个碱基对标记订单,而 IGSC 协议用的是 200 个碱基对。10
同一份快报里还有一个容易被忽略的归属问题。
2026 年 6 月,一批生命科学研究者、AI 公司、生物技术公司与 IGSC 部分成员联署公开信,要求立法者把合成核酸订单及其制造设备的筛查变成强制;签署人里包括 Demis Hassabis、Sam Altman 与 Dario Amodei。而国会研究服务处特别指出,这封信把责任放在 DNA 合成公司身上,而不是生物设计工具或 AI 模型上。11
这层防护的有效性,独立评估给的是保留意见。
第二版《国际 AI 安全报告》写的是:当前的 AI 韧性努力参差不齐,且大多未经检验;关于多数措施在 AI 语境下的有效性,具体证据很少。12
而官方博文自己引用的那篇 2025 年《科学》论文,做的是相反方向的发现:它识别出一处漏洞,AI 重新设计的序列无法被当时的筛查工具可靠检出,论文作者随后开发并部署了补丁。13
05 这个「首个」的边界在哪,三家同行各加了哪一层
DNA 水印有一条更长的历史。
2001 年,美国有一项名为「DNA-based steganography」的专利获得授权;2007 年,DNA-Crypt 算法把水印写进 DNA,用于识别转基因生物的未授权使用;2024 年,有人提出用密码学方法认证合成 DNA;2025 年 9 月,一篇被 NeurIPS 2025 接收的论文提出 DNAMark 与 CentralMark,前者用同义密码子替换在保持功能的前提下埋水印,后者让水印能从 DNA 一路遗传到翻译后的蛋白质。14
所以 SynthID Bio 的可辩护新意有三处。
一是把水印写进模型权重:结构侧微调 AlphaFold 3 的扩散网络,水印随预测过程直接产生;二是拿湿实验证明了埋水印的设计仍然结合得上目标;三是正在与斯坦福大学的 Hie 实验室(Brian Hie 主持)与 Arc Institute 合作,把同一套方法接进基因组模型 Evo 2,为 Evo 2 设计的噬菌体基因组打水印,博文称早期细菌培养实验已确认这些噬菌体仍有功能,技术手稿待发。1
三家前沿实验室在生物安全上,各自加的是不同的层。
| 谁 | 加的是哪一层 | 一手依据 |
|---|---|---|
| Google DeepMind | 设计物证层:让 AI 设计物自身携带来源信号 | SynthID Bio 与生物韧性方案 1 |
| Anthropic | 发现能力层与客户准入层:2026-09-23 公布 Claude 发现的 ART 酶系统(约 950 个智能体、21 小时、2.1 亿 token);2026-09-17 推出生命科学验证计划,把安全手段从实时拦截改为离线监测,并要求对相关流量保留 30 天数据 | 两条官方公告 1516 |
| OpenAI | 阈值分级与立法:Preparedness Framework 把生物与化学列为独立追踪类别,达到 Critical 一档即在明确出对应防护前停止进一步开发;2026-09-09 公开支持加州 AB 1864,要求基因合成服务商与台式合成设备商遵循联邦筛查标准 | 框架文件与政策文 1718 |
Anthropic 那两条需要补一句出处上的分辨。
外界常把它的生物阈值叫 CB-1 与 CB-2;这两个简称出自 2026 年 8 月的风险报告,政策文本本身用的是「非新型化生武器生产」与「新型化生武器生产」这套命名。19
同一份报告的自评是:目前按模型已经达到 CB-1 阈值来处置,尚未达到 CB-2;两个威胁模型的总体风险评级都是「低」,CB-1 那一栏写的是「低,但高于此前估计」,原因是发现了一处影响近一年的防护缺口。19
Google DeepMind 自己那套框架,走的是预警阈值加补充安全论证的路子。
其前沿安全框架 3.1 版把化学、生物、放射与核(CBRN)风险合并成一个风险域,临界能力等级定为「CBRN 增益 1 级」——在中低资源行为者的参考情景里提供增益、产生严重量级的额外预期伤害,对应推荐的安保等级是 2 级以上;框架明说,具体缓解措施可能在触及等级时才确定。20
对这个方向,也有分量相当的人给出相反的判断。
2026 年 9 月 14 日,Yann LeCun 转发了邢波(Eric Xing)的一段反驳,后者写道:让大模型生成一份病毒的假想基因组蓝图,与真的造出一个病毒,是完全不同的两件事,材料、制造与「纸面到物理」转化的真实可行性才是需要跨越的鸿沟,这条长链上可以也应该加上更多检查点。21
LeCun 自己补的一句是:生活在比特与 token 的离散世界里的 AI 人,并不总能理解真实世界有多么肮脏混乱。22
他们的论证落在「瓶颈在哪一环」上,与「水印是否稳健」是两回事。
按邢波与 LeCun 的逻辑,来源标记加在链条最上游,而真正的窄口在下游的材料与工艺。21
06 发布当天,外面怎么读它
最先把它读成「可以被绕开」的,是《自然》的新闻版。
那篇报道写道:这枚分子水印可以被抹掉;想擦掉「AI 造」这个标签的人,在很多情况下可以把一个带水印的蛋白质喂给另一个设计工具,生成一段新的序列,保住结构与功能,却隐去了它的合成来源。4
报道引述的外部意见并不一致。
兰德公司的生物安全学者 Steph Guerra 认为,水印能让生命科学界各方的利益一致起来——她说水印可以支持创新与科学可复现性,「同时也能带来安全收益」。4
前 IBBIS 研究者 Tessa Alexanian 的说法是「我们处在一个全新的狂野世界里」,她把它定位为分层框架里多出来的一件工具,并转述了她接触过的合成商的普遍态度:你能给我们任何帮我们看懂这些订单的信息,都是好的。4
专业媒体这一侧,当天单独成文的只有一家。
Ars Technica 的 John Timmer 在 15:54(UTC)发文,一边讲清机制,一边列出它读出的几处漏洞:整套系统只和密钥分发与维护得一样安全;过短的蛋白可能埋不进足够的水印氨基酸;可以把水印序列和无标记序列拼起来稀释;大量 AI 蛋白设计软件并不使用 ProteinMPNN,暂时接不进来;统计判定的阈值直接决定误报与漏报。23
文章结尾写的是:「目前还不清楚这在实践中会特别有用,至少在原样的形态下是这样。但这件事能跑起来本身就挺有意思。」23
生物安全界给的是正面定位,但带一个前提。
核威胁倡议组织(NTI)在同一天写道:水印本身并不能阻止对生物 AI 工具的蓄意滥用,但把它纳入生物安全生态有重要益处;前提是,这枚水印要嵌在已经具备其他运行性滥用防护的生物设计工具里——这时它的存在才能当作一个「这段序列大概是安全的」的保证信号。24
写那篇的两位作者用了一个刹车作比:知道刹车好使,你才能开得更快。24
真正把它当产品来问的问题,出现在 Hassabis 那条帖子的回复里。
@Tristan_Fifield 的嘲讽最直接:把先进的生物技术开源,看起来是个天才主意,我们这个物种最近在这方面的记录好得很。3
Hassabis 那条帖下面,有人的问法是常见的编辑会不会洗掉它:换几个残基、截掉一截之后,这枚水印还在不在。3
另一位问的是它够不到的那一半:开源模型没有水印,你打算怎么办。3
还有一位问的是落地接口:要让它在合成这一层真正起作用,你们设想的是 DNA 合成厂采纳一套统一的检测接口,还是每家实验室各拿一把自己的密钥。3
这些问题在论文里都能找到一个方向,但没有一条在当天被回答。
发布方这一侧,站出来的只有两个人。
Pushmeet Kohli 在 17:07(UTC)发出公告,截至北京时间 10 月 1 日上午 8 点 55 分,这条帖有约 1,199 个赞和 25 万次浏览;Hassabis 的引用帖有约 1,979 个赞、13 万次浏览。25
作者一侧只有第一作者 David Stutz 本人发了帖,表示「今天在《自然》上,我们介绍 SynthID Bio」,互动是 45 个赞。26
机构账号只转不发:Google DeepMind 的官方账号当天关于这件事的动作是一次转发,没有自己的解释帖。27
同行没有接话。
截至北京时间 10 月 1 日上午 8 点 55 分,Anthropic 与 OpenAI 的官方账号都没有就 SynthID Bio 发声;两家在这段时间里各自发的是别的东西——Anthropic 的账号时间线最新一条停在 2026 年 9 月 28 日的模型发布,OpenAI 当天发的是模型蒸馏的处置公告。2829
X 之外的传统媒体侧,写这条发布的人少得多。
截至同一时刻,Techmeme 当天收录的这条新闻下,只有 Ars Technica 一家媒体单独成文,其余入口只有 Google DeepMind 官网与 Pushmeet Kohli 的帖。30
这层水印真正改变的是一份订单的停留时间:一段比对不上的序列要不要排进人工复核、排多久,取决于拿到密钥的那一方会不会去看它一眼。
References
- 1Introducing SynthID Bio · Google DeepMind
deepmind.google
- 2
- 3
- 4
- 5google-deepmind/synthidbio · GitHub
github.com
- 6Our approach to bioresilience · Google DeepMind
deepmind.google
- 7Harmonized Screening Protocol v3.0 · International Gene Synthesis Consortium
genesynthesisconsortium.org
- 8
- 9
- 10Gene Synthesis Screening Information Hub · Key Policies · Johns Hopkins Center for Health Security
genesynthesisscreening.centerforhealthsecurity.org
- 11
- 12International AI Safety Report 2026
arxiv.org
- 13
- 14
- 15
- 16
- 17OpenAI Preparedness Framework v2\
cdn.openai.com
- 18
- 19Redacted Risk Report August 2026 · Anthropic
anthropic.com
- 20Frontier Safety Framework v3.1 · Google DeepMind
storage.googleapis.com
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
- 30
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.