2,046 个 agent 各读一个基因扰动:文献 711 倍、专家盲评 75%,32 分钟测的是单任务
OpenAI 与 Scripps、PerturbAI 把一份全脑 CRISPR 图谱拆成 2,046 个任务,一个扰动配一个 agent;这篇拆开它的四道检验、711 倍文献量怎么算出来的,以及 32 分钟这个数到底量的是什么。

10 月 21 日,OpenAI 在自家研究栏目发布一篇文章,讲它和 PerturbAI、Scripps Research 合作做的一件事:把一份全脑 CRISPR 图谱的解读,拆给 2,046 个各自独立的 AI agent。1
配套论文 10 月 15 日挂上 bioRxiv,14 位作者,模型是 GPT-Rosalind 5.5。2
数据来自 74 只小鼠、7,720,300 个细胞核、1,947 个基因扰动。3
跑通这件事早就不难。难的是证明它读的是数据、写出来的是生物学。
两个数先摆出来。专家盲评里,75% 的判断选了分布式 agent 写的报告。任务量从 1 个扰动拉到 893 个时,单 agent 引用的文献停在 11 篇,分布式那组约 7,800 篇。
一个扰动配一个 agent
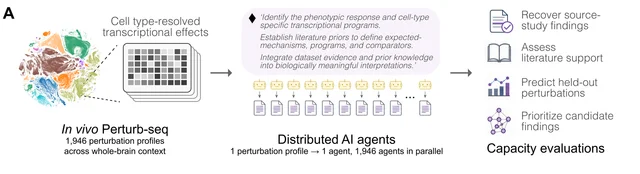
论文把这种做法叫「分布式生物推理」:先把实验拆成互不相干的任务,再让每个 agent 各管一个。
输入是已经算好的差异表达矩阵:每个扰动在每类细胞里的 log 倍数变化与显著性。
过滤沿用原研究的门槛,只保留扰动细胞数 ≥40 的「扰动×细胞类型」组合。剩下 1,946 个非对照扰动、100 个安全靶点对照,共 2,046 个任务,覆盖 23 类神经元。4
每个 agent 拿到的是一份完整的工作台:目标基因与扰动编号、该扰动的全部差异表达统计、装了 pandas 与 AnnData 的 Python 3.12 环境、OpenAI 的生命科学技能包,以及文献检索权限。
它还可以自己决定怎么分析。论文明确写了,agent 不要求按固定顺序走流程。
一次运行的配置是:推理档 xhigh、上下文 256,000 token、输出尽量简、40 个进程各跑 30 个任务,全部在 2026 年 5 到 7 月跑完。4
每个 agent 交回一份八段式报告:主要观察、定量证据、受影响的基因与生物程序、细胞类型特异性、与其他扰动的关系、文献支持的解读、置信度与保留意见、建议的后续实验。
这些报告再被归一化、去重,连成一张知识图谱,最后由合成 agent 跨扰动找趋同、分歧与上下文依赖,给每条关系打一个优先级分。全库留下 3,397 条关系型发现。
先把原稿锁在门外
数据就是被扣稿那篇原文产的。所谓「恢复结论」,算不算拿自己的数据考自己?
先承认这一层:数据确实是同一份。作者的理由是避免「人做的预处理」和「agent 做的预处理」之间产生漂移,所以直接喂原文的差异表达矩阵。
真正的考验在另一头。模型的知识截止是 2025 年 12 月,原文 2026 年 3 月才上线,但 agent 跑在 2026 年 5 到 7 月,文献检索是活的。
于是作者在网络层做了拦截:bubblewrap 白名单、只读的输入目录、独立的可写目录,再用 mitmproxy 架 TLS 代理,屏蔽原文的 DOI 与预印本编号、长短标题、整个 jinlabneurogenomics GitHub 组织、Hugging Face 数据集路径,以及 perturb.ai 域名。4
这一条比任何「我们扣留了答案」的声明都硬,因为它是可核的机制描述。
然后是读数。作者从原文正文与图里挑出 12 个结论段落,配上 62 个相关扰动,得到 71 组「扰动—结论」对照。
35 组完全匹配,13 组匹配并补充了更细的解释,9 组部分匹配,14 组没覆盖到。2
只看「能靠差异表达数据直接推出来」的 55 组:48 组匹配或精炼(87.3%),再加 4 组部分匹配,至少部分恢复的占 94.5%。
没覆盖的那 14 组,基本都需要差异表达之外的外部数据。这条边界比恢复率本身更有用。
还有一组旁证:常规通路富集分析每条通路列出的基因中位数是 19 个,agent 的通路摘要只有 5 个,而两者在 96.2% 的匹配比较里方向一致。
判读流程也要说清。四类标签先由 agent 预标,第一作者逐条复核并裁定模糊案例,所以 87.3% 里含一层人工裁量。
把基因名打乱之后
1,519 条高置信发现被分进四类:与文献一致 420 条(27.6%),有机制支持但没有直接对应的观察 636 条(41.9%),与文献预期冲突 101 条(6.6%),检索不到先例 362 条(23.8%)。
这些标签是不是套话,可以做个反事实检验:保持转录本签名不动,只把扰动的基因身份随机换掉。
换成本屏内的其他基因,「与文献一致」从 29.3% 掉到 13.2%;换成屏外基因,掉到 6.1%。「检索不到先例」从 29.9% 涨到 43.5% 和 61.0%。2
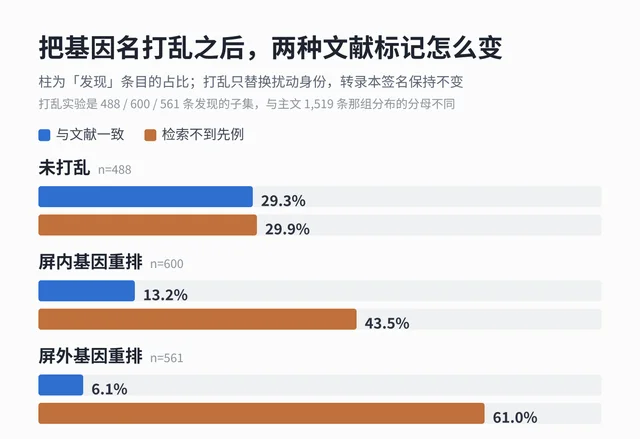
标签跟着「基因—表型配对」走。基因名一换,同一批表达变化就不再被认成原基因的已知结论。
残余的一致也有解释。一部分是共享的生物学,比如细胞应激程序本来就常见;另一部分是文献匹配的极限——论文举的例子是,把 Psmb4 的数据改标成 Trim47,p53 相关诱导与突触抑制会得到不同的标签。
一个 agent 读 11 篇,八百九十三个读七千多篇
规模化的实验设计很干净:同一个模型、同一套提示、同一个推理档与工具,只把任务量从 1 逐级加到 893。
1、3、10 个扰动时,两条曲线几乎重合。30 个开始分开,100 个之后差距迅速拉大。
893 个扰动时,单 agent 引用了 11 篇文献;分布式那组保留的引用多 711 倍,约 7,800 篇。
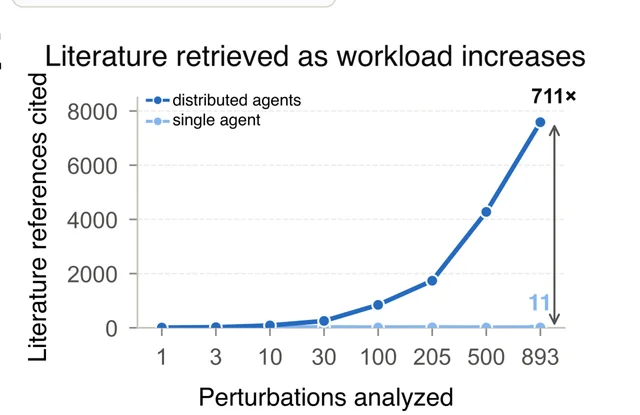
按每份报告看,读数中心大致落在读 19 篇、引 8 篇。全部分布式运行加起来,记录 39,185 次论文阅读、保留 16,445 条引用。
7,800 是 893 份报告的合计,摊到每份是 8 篇。把总量读成单份深度,会高估这套方法在每个扰动上花的功夫。
顺带一处口径问题。官方博客的图注写的是「在最大工作量下,分布式 agent 引用了超过 700 篇文献,单 agent 为 11 篇」。论文写的是 711 倍,博客图注把它落成了「超过 700 篇」。只看博客的读者会记住一个偏小一个数量级的数。1
32 分钟、几个月,和它们各自的口径
博客开头的 32 分钟最容易被转述,也最需要拆。
论文方法写的是:在一个单独的基准里,跑了 24 次完整的单目标任务,均值 32.8 分钟、中位 31.6 分钟、四分位区间 24.7 到 36.8 分钟,然后用并行执行把这个值报成整批分析的时间。4
也就是说,32 分钟量的是一个扰动读完的时间;2,046 个扰动跑完的墙钟时间要另算。
按论文自己写的并发(40 进程 × 每进程 30 任务,约 1,200 个同时跑),2,046 个任务至少要排两轮,整批应该在一小时量级。这是我按它给的配置推的,论文没有直接测这个数。
人类那一侧更要说清。作者假设每个扰动 15 分钟分析、每篇文献 10 分钟阅读、时薪 22 美元,据此得到「数月至一年」,并注明它只是工作量级的示意。4
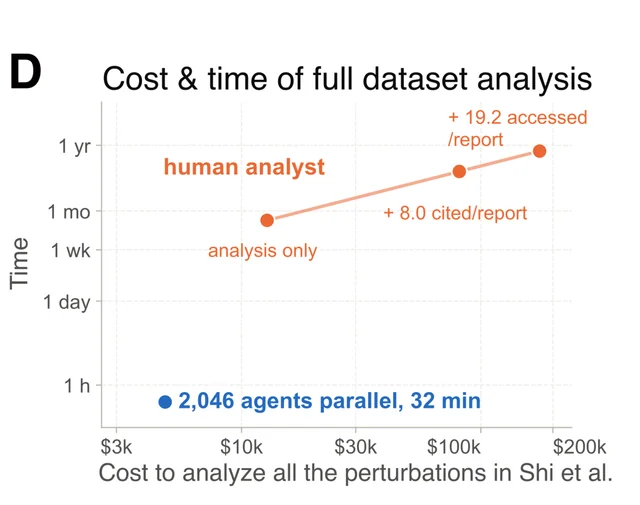
还有一个空缺:论文正文没有给出跑完这一批的金额,只有图上的一个点位。想知道实际花多少钱,得去翻运行清单,那不在正文里。
没见过的扰动,它错在哪
泛化测试把 1,946 个扰动量成两段:1,674 个训练、272 个留出。agent 只看训练集的表达谱,要预测留出扰动在丘脑谷氨酸能神经元里会产生多少个显著差异基因,包括预测「零」。
平衡准确率 0.705。零反应的 172 个里判对 142 个(82%);有反应的 100 个里判对 59 个(59%)。四格摊开是:59 个正确预测、41 个漏报、30 个过度预测、142 个正确判零。2
两类错误都有机制,而且机制比分数有信息量。
漏报发生在训练集里找不到可比对象的时候。Naa20 是 NatB 复合体的一个亚基,STRING 里没有合格邻居,agent 预测零反应,实测 1,327 个差异基因。
过度预测发生在相反的方向。Pomp、Thoc2、Pafah1b1 分别被预测有 600、303、40 个差异基因,实测都是零。
有意思的是这三个靶点的另一重身份:它们同时是细胞被清空得最厉害的靶点(图 3I 里 Pomp 排在 125、Thoc2 第 82、Pafah1b1 第 85)。细胞先死了,转录组就读不到它本该有的反应。
这层解释让论文多问了一步:只给转录证据,能不能预测哪些扰动在体内把丘脑神经元清得最狠?
答案是能,但不准。在前 50 名的召回率上,分布式 agent 0.36,单 agent 0.18,DepMap 必需基因基线 0.26,按差异基因数量排序 0.14。2
两条值得做实验的线索
这套流水线最终要交出的东西,是能被拿去做实验的假设。论文给了两条,也给了一条自己判错的。
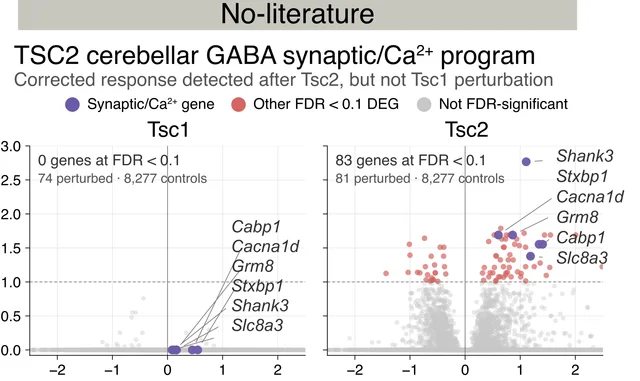
第一条落在 Tsc1 与 Tsc2。这两个基因同属一个复合体,控制 mTOR,多数神经元里扰动任一个的反应高度一致(相关系数 0.892,202 个基因)。
但小脑的 GABA 能神经元里,两者分开了:扰动 Tsc2 产生 83 个显著差异基因,扰动 Tsc1 是零个。2
这和临床上的一件事对得上:结节性硬化患者的小脑异常与 TSC2 突变关系最强。降 mTOR 活性的药能治部分脑肿瘤与癫痫,学习与行为上的困难一直难处理。
第二条落在 DCTN1。这个基因的突变导致 Perry 综合征,一种带帕金森样症状的神经退行病。
图谱里扰动 Dctn1 会让胆固醇合成相关基因上调。agent 把它与「胆固醇运输出问题、细胞就多造胆固醇」的文献接上,提出一个可测的问题:DCTN1 的缺失会不会改变神经元内胆固醇的分布,这种改变会不会参与神经退行?
这条的后续优先级评分是 4.3/5,落在最高一档。对照组是 Apc-Wnt:证据支持 4/5,新颖性只有 1.5/5,优先级 2/5。这套排序能把「早就知道」和「值得追」分开。
判错的那条更值得看。Wdr26 扰动的表达谱与 Tsc2 很像(余弦相似度 0.629),agent 却给了「与文献冲突」的标签。
它的推理路径是从成纤维细胞里 GID–AMPK 的研究外推,判断 Wdr26 缺失应该激活 AMPK、抑制 mTOR。人工复核发现,GID 各亚基功能不同,后续研究里 WDR26 缺失并未抑制 mTORC。2
跨亚基、跨细胞类型的外推会错。这里的价值在于它把错误标了出来,没有悄悄吞掉。
30 位专家,180 次评分
盲评的设计值得单独说,因为它决定了「75%」这个数能撑多重。
30 位有博士学位的生物学者,方向限定在分子生物学、细胞生物学、神经科学、遗传学或系统生物学,且近十年内仍在做研究。他们以独立承包人身份参与,接触过原文与该数据集的人被排除。4
评价集是 60 份报告:高、中、低分位的分布式报告各 20、10、10 份,加 20 份单 agent 的最高分位报告。报告抽掉排名与 agent 自评分,每人评 6 份,每份 3 人评,共 180 次评分。
评分维度是新颖性、证据支持、后续优先级与自评信心,五级量表,另附书面理由。允许做简短文献检索,禁止使用生成式 AI。
合成分(新颖性、支持、优先级三项均值)随 agent 排名下降:高分位 3.14、中分位 2.75、低分位 2.63。
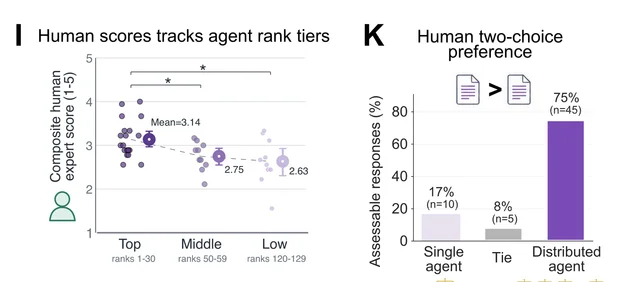
人与 agent 的分数相关性,新颖性 0.61(P=2.7×10⁻⁴)、后续优先级 0.56、证据支持 0.49。分得最开的是「值得追」,这也是作者最想让它成立的一项。
二选一那 60 次判断里,分布式 45 次(75%)、单 agent 10 次(16.7%)、平手 5 次(8.3%)。
这套设计能支持的结论有边界:单数据集、单模型、每份报告只有 3 人评,评审拿到的报告按排名分层抽样,与随机全样本不同。
能拿走什么,拿不走什么
代码与技能包在 GitHub,MIT 许可,2026 年 10 月 21 日还在更新。5
仓库里放的是 agent runtime、语料工具与复现论文图表的 notebook。README 写明,复现已保存的分析不需要任何模型调用或密钥。
数据是 CC BY 4.0,7,720,300 个细胞核的图谱可直接下载。6 原始报告 JSONL 在 Zenodo,2026 年 9 月 23 日存的,单文件 60.8 MB,文件名 findingsReport_rosalind_fullTarget_sourceguard.jsonl。7
另有一个托管查询服务,可以挂到 Codex 里只读检索发现与证据。README 自己说明这是自定义域名不可用期间的临时地址,且不含原始数据,不能直接重算统计。
拿不走的东西有三样。
一是模型。论文的数据可用性只交了流水线、技能包与报告,没有交模型;GPT-Rosalind 5.5 是 OpenAI 的商业模型,换成别的模型会得到什么结果,论文没有测。
二是合成层没有对照。单扰动那一层有扣稿、打乱、盲评三重检验;跨扰动综合只有 3,397 条关系与优先级分,没有一组「人类综合 vs agent 综合」的对照。这是全套流程里证据最薄的一环。
三是范围。一个数据集、一个物种、一种组学。表观遗传、蛋白、空间转录组、形态学都被列进了未来工作。
值不值得拆,图 2E 给了答案的边界。几十个扰动的时候,拆开没有收益,两边曲线还重合着;上百个之后,不拆等于主动放弃大部分文献。
如果只打算翻原文,先看三处:Table 1 到 Table 5 是四类检验的逐条底账,Figure 2E 与 2H 是规模化与打乱对照,Figure 4K 是专家偏好。
真正变了的是分工单位
把整件事交给一个更强的模型,是这类演示最常见的做法。这里换了个问法:能不能让模型的数量去匹配实验的数量。
每个扰动交一份报告,报告再拼成一张可查的图谱。这条路上最先被解决的是解读的吞吐量,最后才轮到判断。
四条证据各自给出了一个数:扣稿后恢复 87.3%,打乱后一致率掉到 13.2% 与 6.1%,893 个扰动时文献量 711 倍,专家盲评 75% 选分布式。这四个数一起,才够支撑「它读懂了」这句话。
至于这些假设里有几条能进湿实验、能留下来,要等下一批数据。
References
- 1
- 2
- 3
- 4补充材料:方法
biorxiv.org
- 5jinlabneurogenomics/distributed_agent
github.com
- 6perturbai/wholebrain_crispr_atlas
huggingface.co
- 7Distributed Agents Reports(Zenodo)
zenodo.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.