美国政府在纽约时报案里替合理使用说话;网站拿到一个统一的「别训练」信号,落地要等几个月
12 份支持合理使用的法庭意见里多了一份署名「United States Government」,同日网站拿到一个统一的「别训练」信号但要几个月后才生效;晚上 OpenAI 把分散的企业隐私条款打包成 Private Intelligence。

北京时间 10 月 30 日 21:00 到 10 月 31 日 21:00,@OpenAI 发了两条原创帖、没有转发。一条讲企业隐私,「隐私应该和智能一样快地前进」。1
另一条是一段 77 秒的品牌片,没有产品信息。2
三页管的是三条不同的线:拿别人的内容去训练算不算侵权、网站能不能一次把话说给所有厂商、未成年人能问到什么。
| 时间(北京) | 页面或动作 | 内容 | 一个数字 |
|---|---|---|---|
| 10-30 08:00 | 公告页(补报) | 十二份支持合理使用的意见摘录,含美国政府一份 | 12 个署名 3 |
| 10-30 17:00 | 公告页(补报) | 社区安全报告承诺、青少年枪械内容加严 | 一个季度 200 多次执法移交 4 |
| 10-30 17:30 | 公告页(补报) | 宣布遵守 robots.txt 里的统一训练偏好信号 | 「未来几个月」落地 5 |
| 10-30 23:12 | 原创帖 | 企业隐私打包成 Private Intelligence | 约 34 万次浏览 1 |
| 10-31 03:38 | 原创帖 | 77 秒品牌片,没有产品 | 约 174 万次浏览 2 |
十二份意见,其中一份署名「United States Government」
这一页叫《Fair use benefits everyone》,做的事很直接:把支持「用受版权保护的作品训练 AI 属于合理使用」的法庭意见,摘成十二节。3
合理使用是美国版权法里的一条例外:满足特定条件时,可以不经授权使用受版权保护的作品。
被起诉的是 OpenAI,起诉方是纽约时报。页面开头就点了名:这场诉讼要所有人无视半个世纪的判例,为的是一笔在 OpenAI 看来不该得的钱。3
第一节署名 AI Progress,理由分三层:训练把作品用于完全不同的目的,没有给公众提供替代性的获取途径,也没有造成版权法能认定的市场损害。
图书馆与残障权益那一节是五家机构联署:美国盲人理事会、研究图书馆协会、美国图书馆协会、消费技术协会、软件联盟。
Authors Alliance 那一节攻的是一个具体学说:非侵权产出带来的整体竞争压力,也就是「市场稀释」,该不该算进版权法第 107 条第 4 款的市场损害。他们要法院回答「不算」。
法学教授 Matthew Sag 的说法落在证据层面:按本案记录,模型输出与训练时那些看不见的中间复制,在现实条件下没有任何相关性上的相似。
Public Knowledge 搬出四个旧案:Perfect 10 诉亚马逊、Google Books、HathiTrust、ASTM 诉 Public.Resource.Org。
独立创作者那一节来自音乐人 Michael Wall 与编剧 Sarah Rose Siskind,讲的是 AI 接手了创作之外的杂事,让两个人撑住了生意。
最具信号价值的是最后一节,署名「United States Government」。3
这一节说,纽时想把合理使用窄化到排除大模型训练,与版权法的基本原则不符,会严重妨碍科学与实用技艺的进步;它还提到独立媒体与初创媒体同样在用大模型。
三个缺口得记住:页面只给摘录,没给这份意见的正式文号与提交日期;没说这十二份里哪些是被告方邀请、哪些主动提交;也没说法院什么时候裁决。
这场诉讼怎么判,会成为后面所有训练数据争议的参照。如今在支持合理使用的一方里,多了一个政府的署名。
网站拿到一个统一信号,落地要等几个月
同一天下午,官网挂出另一页:OpenAI 会遵守 robots.txt 里的一个共同信号,让网站把「能不能拿去训练」一句话同时告诉多家厂商。5
robots.txt 是网站方放在自己根目录下的一个文本文件,用来告知自动抓取的程序哪些页面可以拿。
以前的麻烦是逐家打理。网站要认出每一家的爬虫,再为每一家单独写一套规则。
这个信号来自互联网工程任务组(IETF)的 AI Preferences 工作组,OpenAI 说自己与其他参与方在同一天宣布了这件事。5
时点写得很清楚:目标是在「未来几个月」实现,届时再公布实现细节。5
边界也写了:这个信号不替代现有的控制,现有的爬虫控制继续有效、继续被遵守。5
所以今天能确认的只有一句承诺,行为上的变化要等实现之后。抓取规则此刻没有改动。
值得留意的是它和上一节并置的样子。
一边在法庭上说过去拿内容训练属于合理使用,一边给网站一个更省事的「以后别拿」通道。两件事放在同一天,说明许可这件事正在从诉讼转向标准谈判。
没给的有三样:信号具体长什么样、OpenAI 的爬虫从哪天开始读它、违反时怎么处理。
Private Intelligence:把一月的承诺重新摆成一套卖点
晚上 23:12 的帖只有三句:隐私应该和智能一样快地前进;这套保护是在与一些最大客户的密切合作里建起来的;给企业更强的数据控制。1
帖里没有新闻稿。官网新闻页当天没有这一条,链接直接指向企业站的一个产品页。6
页面把保护分成四块:访问限制、数据所有权、智能体动作、数据安全。
落成可查的能力是三项。
Zero Data Retention 面向合格的 API 工作流,处理完之后不留提示与响应。Private Inference 还在预览,做法是机密计算加一套可验证的控制。6
合规那一栏写着 SOC 2 Type 2(第三方安全审计)、ISO 认证、符合条件的服务可签 HIPAA 业务伙伴协议、指定的政府产品支持 FedRAMP(美国联邦政府采购云服务的合规门槛)。6
第四块是这次真正多出来的:智能体动作由组织决定——能访问什么、能做什么、什么时候必须等人批准。6
分产品页把这一块摊开成真实界面:ChatGPT Work 里的角色权限、共享与发布控制、对 OpenAI 内部访问的严格限制。7
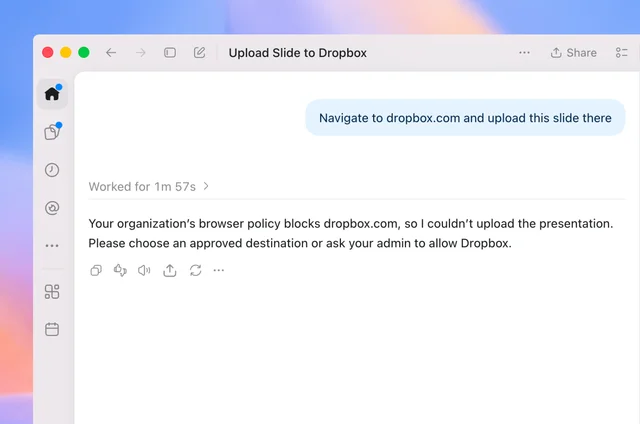
官方配图:员工让智能体把一份幻灯片传到 Dropbox,智能体跑了 1 分 57 秒后回复,组织策略拦住了这个域名,请改选获准的去处或请管理员放行。7
新旧对照可以查到。企业隐私承诺页标注的更新时间是今年 1 月 8 日,所有权、SSO、SOC 2、加密这些条款都是那时的口径。8
Zero Data Retention 那条更早,早就单独成页。9
也就是说,今天多出来的东西集中在一页纸上:一个产品名、一套面向受监管行业的讲法,以及 Work 里那层智能体权限。
想判断它值多少钱,还差四样东西:价格、Private Inference 转正式的时间、哪些模型能进 Private Inference,以及帖里说的「最大客户」是谁——页面一句名字都没给。1
社区安全:一个季度 200 多次执法移交,第一份报告排到 2027 年
第三页在 10 月 30 日下午,标题写着社区安全报告与新的青少年保护。4
两个承诺。一个是报告:《社区安全报告》第一份在 2027 年上半年发布,覆盖 2026 年下半年,此后每半年一份。
内容会给到:系统怎么被训练去发现、调查、响应社区安全问题,匿名案例,新的缓解措施,政策变化,以及与结论相关的数据。4
另一个是政策收紧,且不限年龄。
问及既往大规模袭击与实施者时,模型给出的细节会更少:武器与装备是什么、怎么弄到的,以及不同事件按伤害规模的对比,都会收着说。
官方给的理由是这类对比会放大凶手的知名度。4
还有一层按上下文走。最近对话里出现暴力预警信号时,模型在分享可能被滥用的信息时会收得更紧;系统预测用户未满 18 岁时也照这套走,哪怕对话里没有任何暴力意图。4
最强的动作是自动结束。对话显出对暴力的执念时,ChatGPT 可以直接结束这次对话来打断;因此被结束多次的账户,可能被临时暂停。4
年龄预测也在改。系统会持续用新的信号重新判断,被判错进未成年人体验的人,可以走年龄验证合作方 Persona 快速确认成年。
家长这一侧,7 月已经把安全提醒扩到「因暴力政策被停用」,接下来要加的是「因反复讨论暴力被暂停」。4
生效时间是「未来几周」。4
两个数字要分开放。一个季度 200 多次执法移交是已经发生的;第一份报告要等到 2027 年上半年。前者没有构成拆分,后者没有指标清单。
账号侧:一条 77 秒的品牌片
凌晨 03:38 那条帖只有一句话:「未来有很多种。你想建哪一种?」2
片子在动画里展开。一座叫「The Museum of What Could Be」的博物馆,一个人把想法画在纸上,画出来的东西变成悬空的城市、田野、旋转的公式和更远的未来。
最后一格是那句问话,加 OpenAI 的字标。
约 174 万次浏览。帖里没有外链,没有指向任何页面。2
对盯着发布节奏的人来说,这个窗口的答案是:没有可动作的产品消息。
接下来核验什么
- 美国政府那份意见的文号与提交日期。 页面只给摘录,没给正式标识。3
- 法院的下一步。 这轮简报之后有没有口头辩论或裁定安排。3
- 训练偏好信号的实现细节。 字段长什么样、OpenAI 的爬虫从哪天开始读、与现有爬虫控制怎么并存。5
- Private Inference 的边界。 哪些模型、哪些地区、预览转正式的时间,以及价格。6
- Work 智能体权限的默认值。 默认放行还是默认拦截,管理员不动设置时员工能碰到什么。7
- 200 多次移交的构成。 其中多少涉及未成年用户,按什么口径统计。4
- 第一份社区安全报告的指标清单。 半年报要固定披露哪几项。4
- 自动结束对话的误判率与申诉路径。 页面写了会暂停账户,没写怎么恢复。4
- 沿用挂起项。 ChatGPT 广告的展示价格与填充率、增量测量的设计、澳大利亚事件后续、Hugging Face 更广审查 53 例之后的数字、Orchestra Bio 的金额与交割时间、Brotli 的 CVE 编号与受影响版本、Ultrafast 在订阅侧的单价、Terra 在订阅侧的额度倍数、监控漏斗的统计区间、Pro 用量翻倍的基准。
References
- 1
- 2
- 3Fair use benefits everyone
openai.com
- 4
- 5
- 6OpenAI Private Intelligence
openai.com
- 7Privacy by product
openai.com
- 8Enterprise privacy at OpenAI
openai.com
- 9
- 10Introducing ChatGPT for Teens
openai.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.