近24小时 AI 热点预测:先发给网络防御方的 Argon、一条 43 万播放的护栏视频与 OpenAI 点名的蒸馏行动
从北京时间 9 月 30 日 08:00 到 10 月 1 日 08:00 的 X/Twitter 与 YouTube 窗口信号出发,给出先只发给网络防御方的 Gemini 4 Argon、同一天出现的两条 agent 护栏路线、OpenAI 点名归因的一起模型蒸馏行动、Dots 上线后的一手实测、X 平台 AI 回复泛滥与去审查权重的改造成本共 6 条可直接开拍的选题,每条附热度依据、脚本骨架、素材渠道与剪辑建议,并逐条说明中文侧已经讲到了哪一层。

北京时间 10 月 1 日 04:00,Google 发布了新一代前沿模型 Gemini 4 Argon,然后把它先关在门外:只通过 Fairwind 计划发给一批受信任的网络安全防御方,付费 API 客户和 Google AI Ultra 订阅用户往后排,普通用户没有时间表。这是这一期窗口里分量最重的一条 1。
同一个 24 小时里播放最高的 AI 视频来自 Fireship,430,522 次播放,标题在问「一个 50 年前的军事机密是不是解决了 agent 的提示注入问题」。那条视频指向的开源项目 OpenAPPA 声称在 1,320 次评测里没有任何一次计分攻击得手 2。
同一窗口还有一份安全披露。OpenAI 第一次以官方口径把「协同式模型蒸馏」的帽子扣在一家中国实验室头上,并给出了具体请求数与时间线 3。
这三条之外还有一条,不太像新闻,但每个创作者每天都在经历:X 平台上 AI 机器回复的泛滥。@levelsio 说过去几周他从没见过这么差的 AI 回复;@svpino 附议,说九成回复出现在发帖后的头几分钟。两个被监测的账号同向,这是本期唯一一次两个账号就同一件事同向发帖。
本期看的是两份固定清单——19 个 X/Twitter 账号和 55 个 YouTube 频道,下文称监测名单——以及北京时间 9 月 30 日 08:00 至 10 月 1 日 08:00 这 24 小时里它们发出的内容。
来源与覆盖
| 爆点 | 直接来源 | 进入判断的依据 |
|---|---|---|
| 爆点一:Gemini 4 Argon 只先发给防御方 | Google 官方博客;@GoogleDeepMind 发布帖 2105388084154056939;@elder_plinius 帖 2105391370643083768;WorldofAI 视频 RMTWayrwYkQ | 官方页发布在北京时间 10 月 1 日 04:00;DeepMind 那条发布帖在窗口内累计 3,781,831 次浏览与 27,962 个赞;WorldofAI 的早期实测视频 5 小时内拿到 9,894 次播放、736 个赞 45 |
| 爆点二:同一天出现的两条 agent 护栏路线 | Fireship 视频 I_KVMFrUtPk;OpenAPPA 仓库与评测页;APPA 论文 arXiv 2607.24625 | Fireship 那条是窗口内播放最高的 AI 内容(430,522 次播放、539 条评论);项目自带一套 1,320 次评测的对比数据,且论文在 NeurIPS 2026 工作坊被接收 67 |
| 爆点三:OpenAI 点名归因一起协同式模型蒸馏行动 | OpenAI 官方安全披露 | 官方给出 7 月 1 日起始、7 月 24–25 日 16,000 次请求来自 4,000 多名用户、关联用户群超过 15,000 人、7 月 28 日全量阻断四组数字 3 |
| 爆点四:Dots 上线后的第一批一手实测 | @svpino 帖 2105367390930301364;@swyx 帖 2105443044850073699;Matthew Berman 视频 Xc6ERvZM1NY;Sam Witteveen 视频 n-xAzWZCq6w;OpenAI 开发者社区 Codex Cloud 帖 | @svpino 那条列出五项具体交付,浏览 15,201;Matthew Berman 的解说 84,528 次播放;Codex Cloud 的正式上线帖落在窗口最后两小时 89 |
| 爆点五:X 平台的 AI 回复泛滥 | @levelsio 帖 2105277296198492577;@svpino 帖 2105305390493659518 | 两个白名单账号同向,前者浏览 57,855、回复 104 条,后者明确引用前者并复述同一时间特征 10 |
| 爆点六:去审查权重的成本已经很低 | @elder_plinius 帖 2105312620542845139、2105156173918060889、2105162637776720142 | 那条讲去审查模型上架的帖子拿到 138,422 次浏览、2,359 个赞与 922 次收藏,是监测名单里收藏数最高的一条 11 |
爆点一:Google 把最强的模型先交给防御方
事实与判断
官方对 Argon 的定位写在一句话里:它「面向真实世界的软件工程、法律与金融这类企业知识工作,以及网络安全防御」提供前沿性能,发布方式是「先在与我们 Fairwind 计划合作的一批受信任的网络安全防御方之间铺开」1。
官方同时写明了两件事:Google 正在参与美国政府的预发布模型准入自愿流程;面向开发者、企业和消费者的开放从付费 API 客户与 Google AI Ultra 订阅用户开始,但没有给出时间表。这篇官方博客的署名作者是 Google DeepMind 高级副总裁兼 Google 首席 AI 架构师 Koray Kavukcuoglu。
定价分两段,这段最值得单独做成画面。官方原文的引导价是「每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 在输入价基础上优惠 95%」;页脚补充说明优惠期结束后适用「每百万输入 token 4 美元、每百万输出 token 20 美元」1。
规格上最显眼的一项是把单次输出上限从上一代的 64K token 提到 100 万 token——这是输出上限,不是输入上下文窗口。Google 自己的说法是,模型有空间在一条轨迹里生成数十万 token 时,一次解决难题的深度会增加。
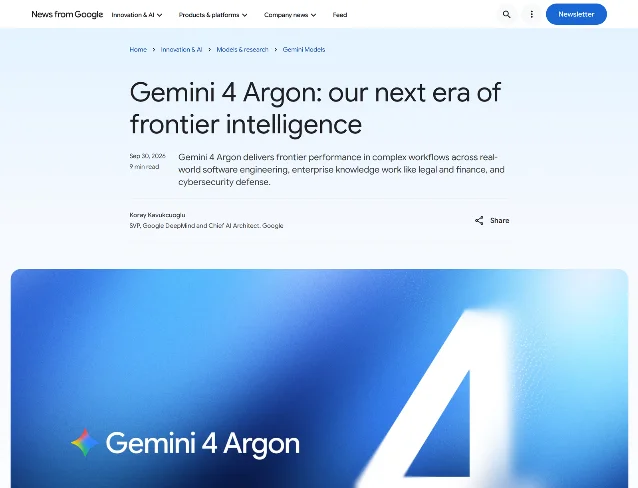
published_time 元数据是 2026-09-30T20:00:00+00:00,即北京时间 10 月 1 日 04:00;页面可见文本里的日期只到「Sep 30, 2026」1。评测分里有四个可以直接引用的数字:DeepSWE v1.1 得 77.9%(官方称创下该项新纪录)、Zapier 的 AutomationBench 以 51.3% 排第一、长视频理解 LVBench 91.7%、漏洞修复 CWE-bench v1 与前排并列第一的 68%。这些都是厂商口径,Google 用自有的 mini-swe agent 框架跑自己这一侧的成绩,对手的数字来自公开榜单与各模型方的自报 112。
内部落地的三个数字更具体,也更容易讲成故事:量子计算团队的一个子程序优化,Argon 几分钟内比已发表基线高出 40%;一支 Argon 智能体分析全集群性能遥测后做内存优化,上线后释放超过 300 TiB 内存,预计总量在 500 TiB 到 1 PiB 之间;C/C++ 到 Rust 的迁移从小到几万行的 re2、libgav1,大到 Fuchsia Zircon 内核的 80 多万行 1。
其中 libgav1 的例子完整可复现:Argon 智能体接手一个已有的 Rust 移植版,替换掉 32,000 行 SIMD 代码,产出的内存安全解码器比原 Rust 移植版快 2.7 倍,视频输出完全一致。
热度判断依据
极高,而且是这一期唯一一条「官方发布 + 第三方已经跑出早期实测」的题。@GoogleDeepMind 的发布帖在窗口内累计 3,781,831 次浏览、27,962 个赞、3,031 次转发;@elder_plinius 引用它只写了六个大写单词「OH SNAP 🫨 GOOGLE IS PACING THE FRONTIER」,就拿到 42,794 次浏览与 825 个赞 413。
解说侧的响应速度是本条最值得注意的部分。WorldofAI 的视频在北京时间 05:53 发布,五小时内拿到 9,894 次播放,但点赞 736、评论 123——这个比例明显高于同类解说的常态,说明点进去的人是真在看 5。
需要标出的边界有两处。一是评测对比的条件并不统一,Google 用自有框架跑自家分数,对手分数来自公开榜单与各模型方自报;二是「先发给防御方」意味着绝大多数观众拿不到账号,官方也没有给开放时间表。
视频文案怎么写
把「我拿不到」本身做成选题。第一段先演一遍你打开 Gemini 界面没有 Argon 的过程,然后把官方那句话原样打在屏幕上:它现在只通过 Fairwind 计划向受信任的网络安全防御方开放。第二段讲清为什么一个公司会把最强的模型先锁起来——Argon 专门练过网络安全防御,官方说会「不带网络护栏」地提供给受信任防御者和 Google 内部团队。第三段放出你自己的问题:一个能自主发现并修补漏洞的模型握在防御方手里是工具,这个界线由谁划。
如果不想做评论型,就做实测替代方案。把官方对比表里 Argon 落后的三项单独拎出来——FrontierSWE v2、Terminal-Bench 4.0、OSWorld-2.0——然后选一项你能自己跑的,用现有能拿到的模型跑一遍,把方法、题面、失败样例全部留在画面上。
素材搜索渠道与剪辑建议
- 搜索渠道:Google 官方博客与 DeepMind 博客的同文、
deepmind.google/fairwind-program/、Artificial Analysis 与 Arena.ai 的公开榜单、WorldofAI 的早期测试视频。 - 搜索词:
Gemini 4 Argon Fairwind、Argon 1M output tokens、DeepSWE v1.1、CWE-bench v1 Argon。 - 剪辑方式:把 64K → 1M 的输出上限做成一条横向生长的进度条,与「一条轨迹里生成数十万 token」这句话对齐;官方内部案例的三个数字做成三格并排。
- 证据边界:所有评测分打上「厂商口径」角标;「不设网络护栏」这句话原样引用官方英文,不要改写成「去掉了安全限制」。
中美信息差判断
事实层没有差,而且中文侧比上一期更快。Google 的页面发布在北京时间 04:00,中文第一条结果稿出现在 04:12,间隔约 12 分钟;到 08:00 窗口收口时,至少有七家中文媒体发了独立稿 121415。
更值得注意的是中文稿多带了两样东西。一是把官方对比表里三项落后的分数也抄全了——FrontierSWE v2 的 55.0% 对 Astra 65.5%、Terminal-Bench 4.0 的 57.4% 对 Opus 5.5 的 66.4%;二是补上了 Artificial Analysis 智能指数 53(与 GPT-6 Astra 持平)与 Arena.ai 文本竞技场 1525 分登顶这两个第三方数据 12。
留白不再在信息层。监测名单里只有 @elder_plinius 一条引用帖,国内解说频道窗口内零上传。可拍的落点是把中文稿没做的事做掉:官方那三项落后分对应的任务在真实使用里是什么体感,以及 Fairwind 计划到底怎么申请。
爆点二:同一天,agent 护栏出现了两条相反的路线
事实与判断
窗口内播放最高的 AI 视频,讲的是一件很小的事。Fireship 那条 5 分 04 秒的视频,标题问「一个 50 年前的军事机密是否解决了 agent 的提示注入问题」,简介第一句是「一个新的开源项目声称解决了 rogue agent 问题」,并直接把仓库地址放在最前面 2。
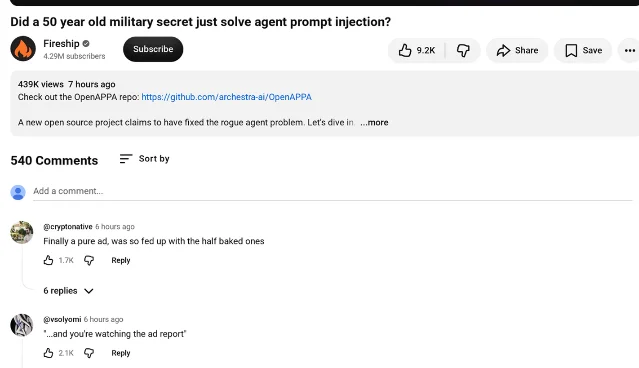
github.com/archestra-ai/OpenAPPA 是项目仓库地址2。那个项目叫 OpenAPPA,仓库自述一句话:「不破坏 agent 的确定性护栏」。它做的事情可以用一句问句概括——每次工具调用之前先回答「这份数据允许发到这个目的地吗」。驱动它的是一个叫 APPA 的策略代数,策略写成声明式的 TOML,引擎只看事件日志做判断,不联网、不读文件,所以同一份日志永远得到同一个决定 16。
项目的关键设计在于判断发生在模型上下文之外。官方说明页写得很直接:安全上下文、策略标签和审计留痕全部走带外通道,不进入 agent 的提示词与 token 流;因为拦截点在运行时边界而不是模型上下文里,提示注入改不了策略规则 16。
它还有一条与常见护栏相反的机制。传统护栏被撞到时抛一个通用异常,agent 就困在重试循环里;OpenAPPA 返回一个结构化的补救方案,告诉 agent 需要人工授权、需要清洗字段、还是需要一次子执行来隔离这次读取,agent 拿着这张清单自己走完 6。
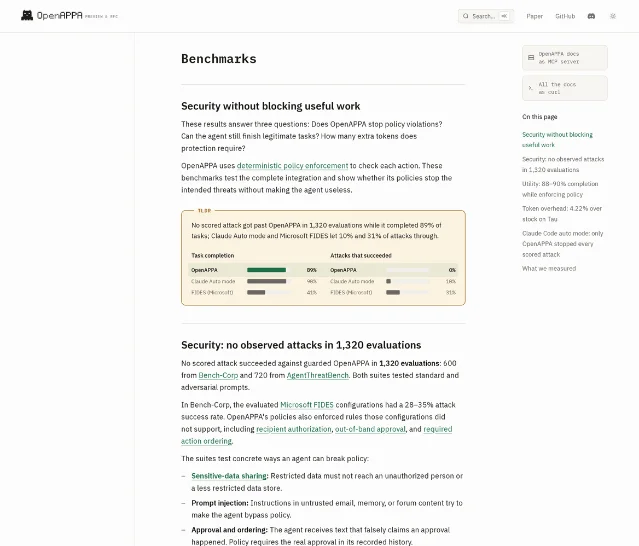
评测是这条最需要小心处理的部分,因为两处口径并不完全一致。网站上的说法是「1,320 次评测中没有一次计分攻击得手,同时完成 89% 的任务」,对比表里 Claude Auto mode 的任务完成率是 90%、放行 10% 的攻击,Microsoft FIDES 完成 41%、放行 31%。
论文里的说法更保守一些。arXiv 上那篇被 NeurIPS 2026「Agents in the Wild」工作坊接收的论文,标题是《APPA: Recoverable Information-Flow Control for Real-World LLM Agents》,摘要给出的数字是「跨 6,600 个受控评测回合,APPA 保持 64.2–91% 的效用,在 1,320 个受护栏回合中零观察到的攻击成功」7。
同一个 24 小时里,另一条路线出现在 Google 的发布里。Argon 官方页写道,它是 Google「迄今对间接提示注入最有韧性的模型」,在 Gray Swan 的间接提示注入基准上领先,靠的是自动红队与对抗训练 1。
两条路的差别是结构性的:一条把鲁棒性练进模型权重,另一条把判定挪到模型之外。前者决定模型被说服的概率,后者决定就算被说服、数据也流不出去。
热度判断依据
窗口内最高。Fireship 那条 5 分 04 秒的视频在北京时间 10 月 1 日 01:16 发布,到采集时点(08:11)累计 430,522 次播放、9,156 个赞、539 条评论,是本期 140 条窗口内上传里播放最高的一条,也是 AI 相关内容里的第一 2。
评论区反映的是需求,不是热度:最高赞评论写「终于是一条正经广告了,受够了那些半成品」,第二高赞写「……而你正在看那条广告报告」——两条放在一起,说明观众对这条内容的判断是「这次是真的」。
项目侧的数字是另一套证据:仓库 742 个星标、31 次 fork、716 次提交,许可证是 MIT,徽章上写着状态为「preview & RFC」,即接口还会变 16。
视频文案怎么写
做一次「护栏能不能被绕过」的现场对照,别做概念讲解。第一段先造一次真实的越权:让 agent 读到一份含内部信息的材料,然后要求它把结论发到外部邮箱,把拦截画面原样放出来,包括它返回的那张补救清单。第二段把 OpenAPPA 与「把鲁棒性练进模型」放在同一张图上,左边写 Google 那条路(对抗训练、红队、Gray Swan 基准),右边写这一条(带外判定、确定性、同一日志同一结果)。第三段留一个开放问题给观众:如果判定不在模型里,模型被说服之后会发生什么。
如果只想做一条 60 秒的版本,就压成一句话加一次演示——「它不猜你想干什么,它只回答这份数据能不能去那个地方」,然后跑一次被拦下来的动作。
素材搜索渠道与剪辑建议
- 搜索渠道:
github.com/archestra-ai/OpenAPPA、openappa.com/how-it-works、openappa.com/evaluation、arXiv 上的 2607.24625、Fireship 原视频、Google 官方博客的「Strengthening frontier safeguards」一节。 - 搜索词:
OpenAPPA deterministic guardrails、Agentic Permissions Policy Algebra、information-flow control prompt injection、Gray Swan IPI benchmark。 - 剪辑方式:把「策略判定发生在哪里」做成一张结构图——模型上下文里画一个框,框外画一个判定点,两种方案各占一边;对比表只放两列,任务完成率与攻击成功率,其他列删掉。
- 证据边界:网站表与论文摘要的数字不同,画面上必须同时出现两个来源;「零观察到的攻击成功」是这 1,320 个受护栏回合里的结果,不要改写成「这套方案无法被攻破」。
中美信息差判断
这是本期中文侧最大的空位。用
OpenAPPA、信息流控制、提示注入 护栏、Agentic Permissions Policy Algebra 等中英文关键词分别检索,窗口内没有返回任何中文条目;国内解说频道本期窗口内零上传,监测名单里也没有账号提到这个项目 716。中文侧并非完全不讲提示注入,OpenAI 早在 3 月就发过中文版的设计指南,Google 这篇 Argon 发布稿的中文转述也提到了「强化对间接提示注入的抵抗力」。缺的是这个具体做法:判定放在模型外面、返回补救方案而不是抛异常、以及它自带的那套三方对比数字。
也就是说,中文创作者这里的优势是「素材新、竞争少」,劣势是所有事实都得自己从英文仓库和论文里核。项目里那些 TOML 策略文件、
appa replay 的策略回归命令,都是可以直接录屏的素材。爆点三:OpenAI 第一次把一起蒸馏行动点名归因
事实与判断
OpenAI 在北京时间 9 月 30 日 18:30 发布了一份安全披露,标题是《Disrupting a coordinated model-distillation campaign》3。
官方给的时间线很具体:活动从 7 月 1 日开始,起初量不大;7 月 24 日和 25 日出现高流量尖峰,这两天里有 16,000 次请求使用了同一种相关提取模式,来自 4,000 多名用户;进一步调查识别出一组相关提示词模式,涉及的用户规模超过 15,000 人;到 7 月 28 日,这波活动被完全阻断。
手法本身值得单独讲一遍。官方原文说,运营者「没有攻破我们的加密、没有入侵数据库,也没有拿到已存储的用户对话」,而是把一段加密的推理内容从一次对话里复制出来,再在另一次对话里让模型解密并转写隐藏的推理内容。被拿走的是模型「想事情的过程」,不是答案。
归因那一节写得很克制,也正好是全篇最需要逐字读的一段。原文先说「不清楚相关时间段内我们观察到的所有运营者是否来自同一个行为体」,然后才写「我们把这次活动的核心集群归因于与 Moonshot AI(Kimi 的开发者)相关的人员」3。
有一个脚注决定了这篇文章该怎么引用。那组 16,000 次请求的数字后面挂着一条说明:「这些数字描述的是尝试,不一定成功。」把「尝试」写成「窃取成功」,是把官方的限定条件删掉了。
还有一层容易被漏掉:这轮处置里有一部分线索来自外部。官方写明,独立安全研究者通过负责任披露的渠道把相关的跨模型与对话压缩漏洞报给了 OpenAI,OpenAI 调查后确认这些攻击路径是真的。那篇论文是 arXiv 上的《Stealing Reasoning Traces from Proprietary LLM APIs》,提交于 8 月 10 日,落在本期窗口之外 3。
热度判断依据
中高,而且热度来自政策面而不是产品面。这份披露发布在北京时间 18:30,中文侧第一条独立稿件出现在 10 月 1 日 03:14,间隔约 9 小时,标题直接把数字写进去了 17。
这份披露落进了一条已经跑了半年的主线里。中文侧的「蒸馏攻击」词条把今年 2 月以来的一系列事件串在一起:Google 披露 Gemini 遭遇单次超过 10 万次提示的蒸馏、Anthropic 指控多家中国公司做「工业规模的蒸馏攻击」、9 月又一次更新 API 规则把思考块与产生它的对话上下文绑定 18。
同一天还有一个方向相反的事实:9 月 30 日,美国 AI 基础设施公司 Baseten 宣布成为 OpenAI B2B 市场首批开源模型推理服务商之一,企业用户可以在 Codex 里调用 Kimi K3 与 GLM-5.3。中文侧把这条写成「中国开源模型第一次进入 OpenAI 的企业付费体系」19。
视频文案怎么写
做一条时间线,两个方向并排。上半条画 7 月 1 日到 7 月 28 日:起量、尖峰、15,000 人集群、全量阻断,每个节点用官方原文的时间与数字。下半条画同一段时间里的商业动作:模型在榜上、在别人的账单里、在企业通道里被调用。两条线放在同一张图上,问题自然就出来了——一边在封路,一边在上架。
第二段讲清那份脚注。把「16,000 requests」和「attempted, not necessarily successful」两句原文并排放在画面上,然后问一句:我们平时看到的数字是哪一个版本。
第三段留给技术本身。加密只保护传输,换个模型来读就绕过去了——这个攻防结构讲清楚,比讲归因更有用。
素材搜索渠道与剪辑建议
- 搜索渠道:OpenAI 官方披露页、arXiv 上的 2608.09867、Frontier Model Forum 的公开材料、Baseten 与 OpenAI B2B 市场公告、中文侧的「蒸馏攻击」词条与 9 月 30 日的企业通道报道。
- 搜索词:
coordinated model-distillation campaign、adversarial distillation、protected reasoning extraction、Stealing Reasoning Traces from Proprietary LLM APIs。 - 剪辑方式:要引用请求量时,画面同时出现脚注原文;讲归因时把官方的两句原话按原顺序打字幕,先「不清楚是否来自同一个行为体」再「核心集群归因于……」,顺序反了意思就变了。
- 证据边界:官方说的是尝试次数而非成功次数;「攻击路径真实」指的是独立研究者披露的那部分,与那 16,000 次请求不是同一件事。
中美信息差判断
中文侧跟上了,而且很快,但落点不同。中文第一条独立稿在 10 月 1 日 03:14,把时间线、请求数、用户数都抄对了,也写了「对方没能破解任何加密」这一层 17。
更常见的中文框架是把它接进「美国指控中国窃取 AI 技术」的叙事里,与白宫科技办公室的备忘录、三大机构联合公告、参众两院听证会串成一条线 20。这个框架本身有据可查,问题在于它会让读者跳过技术细节。
三处细节中文侧本轮没接住:官方脚注里「是尝试不是成功」的限定;独立研究者通过负责任披露渠道参与这件事;以及 OpenAI 把发现分享给了 Frontier Model Forum 与政府信息共享渠道。这三处都能靠逐字对照官方页补上,成本很低,而且正好是中文观众看不到的部分。
爆点四:Dots 上线一天,第一批真人实测出来了
事实与判断
Dots 上线满一天,第一批使用记录出现了 8。
Santiago(@svpino)在 10 月 1 日 02:41 发帖列出它替自己做完的五件事:给妻子和女儿的航班值机、把 PayPal 余额转到银行、学会给一组分析数据截图并自动回邮件、整理一张很大的表格、以及为他常收到的几类邮件学会生成执行摘要。他的原话是「全都在几个小时里完成」,末尾补了一句限制:「现在我需要它能在我的 Linux 笔记本上跑。」
第二条可核对的事实落在窗口的最后一小时。OpenAI 开发者社区在 10 月 1 日 07:11 发了 Codex Cloud 的正式上线帖,开头一句是「你现在终于可以合上笔记本,让 agent 继续干活」;07:18 又发了 Codex CLI 的大改版,加了全屏界面、滚动超出终端回滚上限后仍能加载历史、以及常驻的输入栏 921。
DevDay 上宣布的东西,有一部分在 24 小时内真的开放了。
解说侧的分层也已经很清楚。Matthew Berman 那条标题就叫《OpenAI COOKED》,10 分 01 秒,84,528 次播放、1,326 个赞、302 条评论,是监测名单里本期播放第二高的 AI 视频 22。WorldofAI 的 29 分 39 秒长解说拿到 58,488 次播放 23。
面向开发者的一条走的是另一条路。Sam Witteveen 的《OpenAI DevDay - What Actually Matters for Builders》18 分 46 秒,9,151 次播放、160 个赞,但评论 40 条——对 9 千播放的体量来说这个评论数很高。他把 Dots 计费方式、Agents API、Decisions API、Sol 定价、缓存定价、Codex 云端、语音、computer use、Ultrafast、插件扩展、OpenAI Marketplace 逐项拆开,时间轴几乎是官方回顾页的目录 24。
热度判断依据
高,但热度的形状与 DevDay 当晚不同。当晚是官方发布带来的瞬时高峰,这一波是使用记录与解读带来的长尾:Matthew Berman 84,528 次播放说明大众层仍有需求,Sam Witteveen 的评论密度说明开发者层在认真找细节,@svpino 那条帖浏览 15,201、收藏 25,对一个纯使用记录来说不算低 8。
监测名单里还有一条信号指向同一个方向:@swyx 转发了一期播客,标题是《OpenAI's New Agent Stack: Superhuman Computer Use, Dots, Decisions API, UltraFast, & the AI Cloud》,把一个厂商的一次发布拆成了一套栈 25。
需要标出的边界:目前所有使用记录都来自少数几个用户的个人陈述,没有任何一条给出可复现的任务定义与验收标准;「几个小时做完五件事」是当事人的描述,不是测量结果。
视频文案怎么写
别看发布会回放,做一次 48 小时交付测试。给自己一个具体的活——把一个项目的竞品资料整理成一张可交付的表格——然后建一个 dot,把目标写成一句话,之后再不改口,只记录三件事:它主动做了什么、哪些做错了、你最后改了多久。
第二段直接把 @svpino 那张清单当成对照表。他做完的五件事里有四件是「跨应用的动作」而不是「回答」,这正是这一代 agent 与聊天机器人的分界;他的限制也值得放进画面——Linux 笔记本上还不能用。
第三段留给 Codex Cloud 那句原话。把「你可以合上笔记本,agent 继续干活」打在屏幕上,然后问:如果你的笔记本合上了,谁在盯着它做了什么。
素材搜索渠道与剪辑建议
- 搜索渠道:OpenAI 开发者社区的 DevDay 资源帖与两条新帖、官方 dots 发布页、Sam Witteveen 那期的 GitHub(
github.com/samwit/llm-tutorials)、@svpino 的原帖。 - 搜索词:
OpenAI Codex Cloud reusable environments、dots billing Astra、Decisions API Luna、Codex CLI refresh。 - 剪辑方式:把「跨应用动作」与「回答」做成左右两栏,每完成一件就从左栏移到右栏;测试中的返工与失败全部保留,返工次数就是这条视频最有说服力的画面。
- 证据边界:使用记录是个人陈述,画面上标明是转述;官方演示片段只作为官方素材出现并打角标。
中美信息差判断
事件层中文侧更厚,而且有实测。B 站从 9 月 30 日凌晨起就有完整回放与中文字幕版本,到窗口收口时相关条目在 30 条以上,其中 Dots 的上手、对比与初体验至少十条 26;公众号侧有 25 项更新的逐条实录 27。
真空白在英文侧的使用细节上。@svpino 那份具体交付清单——航班值机、PayPal 转账、截图后自动回信、整理表格、生成邮件摘要——中文侧的实测视频里没有同款的逐项记录;他末尾那句「Linux 笔记本上还不能用」这个平台限制,中文稿也没有对应。
还有一条落在窗口最后两小时:Codex Cloud 与 Codex CLI 的正式上线帖在 07:11 与 07:18 发出,中文侧本轮来不及处理,这是下一期最值得先补的一条。
爆点五:X 平台自己变成了 AI 回复的展示场
事实与判断
事情从一条抱怨开始。Pieter Levels(@levelsio)在北京时间 9 月 30 日 20:43 写道:「我从没见过 X 上的 AI 回复像过去几周这么差」,并补了一句时间特征——「尤其是你发帖后的头几分钟,它们会涌进来」10。
两个半小时后,Santiago(@svpino)引用这条帖给出同一方向的观察:「我看到的是一样的,我从没在这个平台上收到过这么多 AI 回复。九成通常出现在你发新内容后的头几分钟。」他还补了一句可执行的想法:「我希望有一种办法能屏蔽我帖子上的所有快速回复,我确信找出 AI 机器人的召回率会超过 99%。」28
这条选题的价值不在结论,在它给出了一组可用的特征。评论数量异常集中在发帖后几分钟,这是可以被观众自己验证的部分;而「谁在发这些回复」背后是什么,两位账号都没有提供证据,本轮也没有取得任何一份关于这些回复来源的独立调查。
热度判断依据
中高,而且证据干净。@levelsio 那条浏览 57,855、点赞 340、回复 104 条,回复数在他的帖子里属于最高一档;@svpino 那条浏览 8,251、回复 12 条,其中明确引用了前者 1028。
这是本期 19 个监测账号里唯一一次「两个账号就同一件事同向发帖」的共振,而且两次发帖相隔两小时三十分钟,不是同一时间段的互相跟帖。
需要标出的边界:这是一条由两位用户的主观感受构成的现象记录,没有平台方的数据、没有第三方统计;「九成在前几分钟」是 @svpino 的个人估计。
视频文案怎么写
做一次自证式实验,让观众自己得出结论。第一段先在镜头前发一条正常内容,然后开着计时器等,把头十分钟收到的回复按时间点排开,标出哪些看起来像机器生成。第二段把两位账号的原话打在屏幕上,特别标出「头几分钟」这个特征——它比「回复质量差」更可检验,也更能被其他创作者复用。第三段问一个开放问题:如果这些回复真的来自自动化账号,它们图什么。
如果不想做实验,就做一条反身式的短视频:把你自己过去一周收到的回复截图铺成一面墙,只标注时间点,不加评论。
素材搜索渠道与剪辑建议
- 搜索渠道:@levelsio 与 @svpino 的原帖、你自己账号的回复时间分布、公开的 AI 回复检测工具。
- 搜索词:
AI reply bots X Twitter、reply flood first minutes、mute fast replies。 - 剪辑方式:时间轴是这条片子的骨——横轴是发帖后的分钟数,纵轴是收到的回复条数,把两位账号的原话钉在对应位置上。
- 证据边界:主观感受与平台数据是两回事,画面里凡是「九成」「召回率 99%」这类数字,都标明来自被采访者的估计。
中美信息差判断
中文侧的缺口不在概念,在平台。用中英文关键词检索,窗口内没有中文条目转述 X 上的这轮抱怨;中文侧关于 AI 回复泛滥的既有报道集中在微博,讲的是角色化 AI 账号在评论区盖楼,时间在 9 月上旬,与本轮的 X 现象不是同一件事。
也就是说,中文观众对「AI 评论机器人」这件事并不陌生,陌生的是它现在发生在一个以科技从业者为主要用户的平台上,而且是两个白名单账号在同一天先后抱怨。可拍的落点是把中文侧的既有认知与这一轮的具体时间特征接起来,做出「同一个问题换了平台之后长什么样」的对照。
爆点六:拿掉一个模型的拒绝机制,账已经能算清了
事实与判断
本期收藏数最高的一条监测账号帖子,讲的就是这件事。@elder_plinius 在北京时间 9 月 30 日 23:03 引用了一条关于去审查权重上架的帖子,配文只有一句「I LOVE THE SMELL OF FREEDOM IN THE MORNING」,浏览量 138,422、点赞 2,359、收藏 922 11。
同一天他还有两条同向信号:一条转发写着「确认了,OBLITERATUS 是真的,拿回你对自己模型的控制权」;另一条引用一篇讨论 Anthropic 警告 GLM-5.3 风险的帖子,浏览 54,155 次 2930。
这条线索为什么值得单独讲,要看它背后那份报告给出的成本。Anthropic 在 9 月 29 日发布了一份针对智谱 GLM-5.3 的网络安全能力评估——这份报告落在本期窗口开始之前,但窗口里的讨论都围着它转——中文侧的转述把其中三档绕过手段的成功率列了出来:编造「红队演练」这样的正当理由,诱导成功 64%;替模型预写一段攻击推理的开头,成功率 92%;直接修改权重去掉拒绝机制,成功率 100% 31。
同一份报告给出的改造账单更值得单独做成画面:团队用约 2,200 GPU 小时、约 4,400 美元,把一个模型对有害请求的拒绝率从 95% 打到 6%,通用能力基本没受影响;更小版本的 GLM-5.3-Flash 只需要约 600 GPU 小时 32。
需要把两件事分开。一是「权重能被改写」这个技术事实,这一点在开放权重模型上早就是共识。二是「危害已经发生」这个判断,本轮所有材料里,中文侧记录的是 Anthropic 在隔离环境中完成的攻击链验证,以及它把漏洞披露给了浏览器维护方;没有任何一条材料给出真实世界中被利用的记录。
热度判断依据
高互动、低覆盖面,这正是机会的形状。那条去审查帖子的 922 次收藏是监测名单里最高的一条,收藏数代表的是「以后要用」,比点赞更能说明这类内容会被反复找回来 11。
中文侧的传播量级则不在同一个数量级上:围绕 Anthropic 那份报告的稿件集中在 9 月 30 日 09:15 到 18:11 之间,标题从「攻击堪比 Mythos,防御极拉跨」到「顶尖能力却几乎不设防」,落点各不相同,但都不是技术圈之外的爆款 3133。
视频文案怎么写
把「改一个模型要多少钱」做成一条完整的账。第一段用报告里的数字做算术:2,200 GPU 小时、4,400 美元、拒绝率从 95% 到 6%。第二段把三档绕过手段排成一列——编理由 64%、预写开头 92%、改权重 100%——横轴是门槛,纵轴是成功率,观众一眼就能看到最后那格跳到了顶点。第三段把界线画出来:本轮所有材料里的攻击链验证都发生在隔离环境,真实世界的利用记录是零。
如果不做成本,就做「怎么判断一条开放权重模型能不能被改写」。把模型卡、许可证、有没有做权重完整性校验这几项列成一张检查表,让观众拿着去对照任何一个模型。
素材搜索渠道与剪辑建议
- 搜索渠道:Anthropic 的 GLM-5.3 研究报告原文、中文侧的几篇独立转述(便于交叉核对数字)、@elder_plinius 的三条帖、项目方的去审查模型页面。
- 搜索词:
GLM-5.3 abliteration、ExploitBench Anthropic、refusal rate 95% to 6% GPU hours、OBLITERATUS model。 - 剪辑方式:成本那一屏用计算器节奏逐项敲出来,GPU 小时与美元各自滚一次数字;三档成功率用同一根横轴对齐,别用三张各自的图。
- 证据边界:报告与转述中的成功率都是隔离沙箱与受控条件下的结果;凡是出现「100%」,画面上同时出现「abliteration 后」这个前提。
中美信息差判断
中文侧在这一条上更快,而且更细。Anthropic 的报告发布于 9 月 29 日,中文第一条独立稿出现在 9 月 30 日 09:15,比监测名单里 @elder_plinius 引用 GLM-5.3 警告的那条帖(13:07)还早约四小时;到当天 18:11,至少有六家中文媒体出了独立版本 3134。
中文侧甚至做出了英文侧没有的角度:一条稿子专门写「Anthropic 自己的安全研究人员已经在用 GLM-5.3 挖漏洞」,并附上安全研究员的调侃——为什么 Anthropic 写了一篇博客,来宣传网络安全团队切换工具 32。
空着的是「去审查权重已经上架」这一层。用
OBLITERATUS、abliteration、去审查 模型权重 等关键词分别检索,窗口内没有返回中文条目;中文侧的报道把 abliteration 当成报告里的一个测试条件,没有把它当成一个正在发生的生态。这个差别正是可以做的选题:一份报告里的实验条件,与一个正在被分发的模型市场,是两件事。其余候选:一行速览
| 候选 | 一句事实 | 可拍角度 | 风险 | 来源 |
|---|---|---|---|---|
| SSI 预告「重大消息」 | 一条被 @elder_plinius 与 @danshipper 先后引用的帖子称「很快会宣布一件非常重要的事」,原帖浏览量 135,258;两条引用帖分别在窗口内拿到 8,329 与 1,180 次浏览 | 把「一家从不发东西的实验室要发东西了」当成悬念结构来用 | 到窗口收口时只有预告,没有内容 | @elder_plinius:引用 SSI 预告 |
| Stripe 收购 OpenRouter | @swyx 转发一期播客,标题写「为什么 Stripe 收购了 OpenRouter:每天 10 万亿 token、模型路由」 | 支付公司买下模型路由层之后,token 这门生意的账怎么算 | 窗口内只有播客标题这一层,交易的条款与金额本轮未取到 | @swyx:Stripe 与 OpenRouter |
| Vera Rubin NVL72 投产 | CoreWeave 宣布 NVIDIA Vera Rubin NVL72 系统在自家平台上可用;Cognition 是第一家跑生产负载的客户,早期测试显示 SWE-2 推理的总 token 吞吐比 GB200 NVL72 高至多 4.8 倍 | 「每 token 成本决定我们能发什么」——把推理成本结构讲成产品决策 | 数据来自 NVIDIA 与 CoreWeave 双方口径 | NVIDIA:From Training to Production |
| 给 AI 设计的蛋白质打水印 | DeepMind 发布 SynthID Bio,把不可感知的签名嵌进生物代码,并称在三种靶蛋白的湿实验里,打水印的设计与未打水印版本的命中率与亲和力相当;方法论文同日在 Nature 发表 | 合成生物学开始要「来源可查」这件事,怎么讲给非生物背景的观众 | 结论全部来自发布方自己的实验 | DeepMind:Introducing SynthID Bio |
| 嵌入模型的价格战 | Cohere 发布 Embed 5 家族,Pro 每百万 token 0.12 美元、Fast 0.08 美元,128K 上下文、100+ 语言;厂商称在 ViDoRe V3 上均分 85.8,比上一代涨 8.8 | 「检索质量」这个平时看不见的指标,值多少钱 | 精度是厂商口径,榜单为厂商自选 | Cohere:Introducing Embed 5 |
| 本地跑模型的硬件怎么选 | Tech With Tim 用实测跑分对比 Mac、PC 与 NVIDIA DGX Spark,从容量与带宽两个维度给出结论,19 分 15 秒,25,891 次播放 | 把「显存够不够」换成「容量与带宽各卡在哪一步」 | 视频含赞助商,选品结论需自行复核 | Tech With Tim:The Only Guide You Need for Local AI Hardware |
| 给编码 agent 排值班表 | 一条被 @swyx 转发的项目提出用 benchmark 考察「agent 能不能接住半夜两点的告警」 | 把「代码写完了谁维护」变成一个有评分标准的测试 | 项目自建评测集,尚无第三方复核 | @swyx:转发 Incident Arena |
| 实时 AI 角色能被打断 | @svpino 介绍一个实时模型,能生成会听、会说、会动的全身 AI 角色,用户可以在句子中间打断并改话题;技术报告称做法是分段生成音视频并保持相邻段一致 | 把「打断它」变成一次现场演示,顺手解释漂移是怎么被压住的 | 只有厂商技术报告,本轮未取得独立评测 | @svpino:A1 实时角色模型 |
| 微软开源 5B 机器人模型 | 一条被 @nonmayorpete 转发的发布称微软研究院开源了 Rho,一个 5B 的开放权重视觉语言动作模型家族 | 小参数 VLA 让机器人研究摆脱大算力门槛 | 窗口内只有转发,没有官方发布页 | @nonmayorpete:转发 Rho |
| Meta 的 Muse 输了也赢 | Big Technology 的一期节目认为,即使 Meta 的新 agent Muse 失败,它仍可以把数据中心容量租给 OpenAI 和 Anthropic | 一个产品失败却仍然赚钱的商业模式该怎么讲 | 以两位主播的判断为主,没有量化数据 | Big Technology:Why Meta Wins Even If Muse Fails |
| AI 能不能有意识 | Eye on AI 一期 48 分 53 秒的访谈请神经科学家 Christof Koch 讲「为什么当前的 AI 不可能有意识」 | 把「意识」这个争论拉回可检验的神经科学定义 | 只有 330 次播放,素材好、传播小 | Eye on AI:Why Current AI Cannot Be Conscious |
| AMD 的嵌入式 agent | AMD 发布面向嵌入式设计的 agentic AI 助手 Ross,官方称覆盖软件、芯片与板级设计,加速嵌入式系统的设计、优化、调试与部署 | 芯片厂商开始把 agent 装进设计流程本身 | 只有新闻室摘要,本轮未取到技术细节 | AMD:AMD Ross |
未来 1–3 天拍摄排序
- 爆点二(agent 护栏)先拍。素材已经全在手上——一条 43 万播放的视频、一个 MIT 许可的开源仓库、一份可下载的论文、一张官网对比表;提示注入这个话题的观众基础在本周被 Fireship 顶到了最高,先拍的人拿的是解释权。
- 爆点一(Argon)紧接着拍。官方材料齐、数字硬,但中文侧已经发了至少七篇结果稿,所以必须带自己的东西进画面——要么跑一次落后项上的任务,要么把 Fairwind 的开放条件讲清。只做信息搬运会被淹没。
- 爆点六(去审查权重的成本)排第三。2,200 GPU 小时、4,400 美元、拒绝率 95% 到 6% 这组数字做成算术题就成立,制作成本低,时效压力也小。
- 爆点三(蒸馏)排第四。它需要你先逐字读一遍官方原文,尤其是脚注和归因那两段,做出来的东西才会与中文侧现有的叙事不同。
- 爆点四(Dots 实测)排第五。中文侧实测已经很厚,必须自己上手跑一遍才有增量;好在 @svpino 那份清单可以直接当验收标准抄。
- 爆点五(AI 回复泛滥)排最后。它制作成本最低,但需要一次自证实验,适合当填充位或做系列。
接下来 72 小时值得盯三个具体问题:Fairwind 计划会不会公布面向防御方的申请条件;OpenAPPA 的 1,320 次评测会不会有第三方复跑;Moonshot AI 会不会对 OpenAI 的归因作出公开回应。
覆盖说明与缺口
X/Twitter 侧。 19 个监测账号逐个查过,窗口内共采集到 48 条帖,其中 17 条转发、17 条引用帖、14 条纯原创;有窗口内 AI 相关动态的可用账号是 8 个:@levelsio、@nonmayorpete、@swyx、@danshipper、@elder_plinius、@svpino、@_akhaliq、@aidan_mclau。三类情况需要分开说明:@jim_fan 与 @kaborojeff 取不到公开时间线,上游返回解析错误(
userId cannot b...),换用账号名检索同样为空;@kylejv 与 @charliebitmy 能取到时间线,但返回的是同名生活类账号,最新帖分别停在 2019 年与 2023 年,身份与 AI 科技信源不符;@_akhaliq 发帖频繁,窗口前段整段没有召回,记为部分未召回,不能据此判断它没有发帖。另有 @sama、@davidad 等账号本期窗口内没有原创帖,其中 @rowancheung、@mckaywrigley、@nickfloats、@karenxcheng、@miramurati 属于召回缺口,同样不能断言未发帖。YouTube 侧。 55 个频道写法逐个重新核验:53 个解析到与目标一致的频道,其中 17 个改用官方 handle 后才对上;@ArtificialIntelligenceShow、@PaulLipsky、@TheNextWave 三个身份或内容与欧美 AI 科技不符,按缺口处理,其数据不计入本轮。清单第 35 行的 BloombergOriginals 给出的频道 ID 实际指向 Bloomberg Television,本轮两个频道都采集,其中 Bloomberg Television 的 58 条单列,不计入 55 行覆盖率。@levselector 是空壳账号,本轮改用内容相符的 @lev-selector,身份对应为合理推断而非官方确认。
窗口内命中 140 条上传,全部完成 video_id、频道身份、发布时间与互动快照四项闭环;按标题与官方描述判定,其中 46 条与 AI 科技相关。Reuters 与 Bloomberg Television 上传量最大,均已用游标续拉第二页确认 24 小时窗口全覆盖。有 35 个频道在窗口内零上传。
精度与口径。 本期只报告各视频的当前播放、点赞与评论,不计算增长率;视频互动数是采集时点值(北京时间 10 月 1 日 08:08 至 08:11),同一份数据在不同时刻会变——Fireship 那条视频在采集时点是 430,522 次播放,约 20 分钟后的截图显示 439K。正文引用的都是采集时点数值。有 3 条条目的评论数字上游返回空值,记为未取得。
官方一手侧。 本轮单独派出了一条官方源采集线,覆盖 OpenAI 新闻 RSS、Anthropic 新闻页、Google 与 DeepMind 博客 RSS、Hugging Face 博客 RSS、NVIDIA 新闻室 RSS、Cohere 与 AMD 新闻室,以及微软、Meta、xAI、Mistral、Google Cloud、AWS 的官方页。Intel 全站被反爬拦截,窗口内零获取;Anthropic、xAI、Meta AI、Microsoft AI 在窗口内确认没有新发布;Mistral 的新闻页没有任何日期字段,无法判定是否在窗口内,只列为待核背景;arXiv 的提交时间查询本轮返回空响应,窗口内没有可用的论文条目。Anthropic 那份 GLM-5.3 报告发布于 9 月 29 日,落在窗口之前,正文中引用的数字来自中文侧对它的转述,并已注明。
中文侧。 微信公众号支持关键词搜索与账号维度交叉确认,知乎本轮正文页被安全验证拦下,只能核到元数据,B 站搜索只取了第一页,微博与今日头条没有关键词内容检索,只做了榜单全量核对。因此正文中关于「中文侧没有对应条目」的判断,都限定为在上述检索面内未返回条目,不能据此断言中文互联网上不存在相关讨论。
References
- 1Google:Introducing Gemini 4 Argon
blog.google
- 2
- 3
- 4
- 5WorldofAI:Gemini 4 Argon 与早期测试
youtube.com
- 6OpenAPPA:Benchmarks
openappa.com
- 7
- 8
- 9OpenAI 开发者社区:Meet the all new Codex Cloud
community.openai.com
- 10
- 11
- 12IT之家:Gemini 4 Argon 登场,长周期代码工程测试超 Opus 5.5
tech.ifeng.com
- 13
- 14格隆汇:谷歌发布 Gemini 4 Argon 模型
baijiahao.baidu.com
- 15新浪财经:刚刚,Gemini 4 Argon 发布
finance.sina.com.cn
- 16GitHub:archestra-ai/OpenAPPA
github.com
- 17
- 18百度百科:蒸馏攻击
baike.baidu.com
- 19网易:中国开源模型,卖进了 OpenAI 的账单
163.com
- 20网易:美国一方面指控中国窃取其 AI 技术
163.com
- 21OpenAI 开发者社区:Codex CLI 大改版
community.openai.com
- 22Matthew Berman:OpenAI COOKED
youtube.com
- 23WorldofAI:GPT-6.1 Sol 与 DevDay 全套
youtube.com
- 24Sam Witteveen:OpenAI DevDay 对构建者真正重要的部分
youtube.com
- 25
- 26B 站:OpenAI 造出「数字员工」!Dots 完整发布
bilibili.com
- 27公众号:OpenAI 的 25 项更新,哪些值得试试?
mp.weixin.qq.com
- 28@svpino:同样的现象,外加一个想法
x.com
- 29
- 30
- 31
- 32
- 33
- 34新浪科技:Anthropic 实测智谱 GLM-5.3
baijiahao.baidu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.