便宜档的 39.2% 只在努力拉满时成立、27B 压到 7.89GB 后 AIME 从 96.7 掉到 79.2、MoE 缓存的 2.2 倍要 89% 命中率
八组实测里,省下来的每一栏都配着一道门槛——努力档、10 万 token 的费用台阶、显存预算、命中率、夜班时段、并发路数;本期把每个数字旁边的条件一起摆出来。

Anthropic 在 10 月 7 日发布 Claude Haiku 5.5,官方表上最亮的一格是电脑操作:OSWorld 2.1 的离线子集从上一代 Haiku 4.5 的 15.7% 涨到 72.4%,同一张表里 GPT-6 Luna 是 48.9%、自家 Sonnet 5.5 是 83.9% 1。同一页写明它是 Haiku 系列第一款带可调努力档的模型;小红书一位作者翻完各家口径后补了一句,网上转得最凶的那个 Terminal-Bench 4.0 39.2%,是在努力档拉满时测出来的 2。
同一天,一个把 Qwen 3.8 27B 压到 7.89GB 的开源版本放出,模型卡首页写着平均保留 96%、工具调用反超原版;翻到逐项表,2025 年 AIME 那一行是 79.2 对原版的 96.7 3。
还是 10 月 7 日,llama.cpp 合并了一个给 MoE 专家做显存缓存的分支。作者的对照表里,一块 RTX 5090 用 18.6GB 缓存把解码从 30.8 拉到 67.8 tok/s,命中率 89% 4;同一条讨论串里另一个人把缓存预算设小了,速度掉到 6.77 tok/s,日志写着这一档预算装不下哪怕一层专家。
这三件事省下来的东西,都配着一道门槛:努力档、10 万 token 的费用台阶、显存预算、命中率、夜班时段、并发路数。跨过去是一个数,跨不过去是另一个数。本期八组材料覆盖 2026 年 10 月 7 日至 10 月 8 日,来源为 X、Reddit、小红书与公众号,另含两家官方发布页、一处 GitHub 仓库与两份公开模型卡。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 便宜档能干多少活 | Claude Haiku 5.5 发布(10 月 7 日),六项官方基准、四家模型并排;10 万 token 上下的两档价格 1 | GDPval-AA v2.1 1620 对上一代 735;OSWorld 2.1 离线子集 72.4% 对 15.7%;Terminal-Bench 4.0 39.2% 对 0.0%;10 万 token 以内输入 $0.10、超出后 $0.50 1 | 全表官方自测、无第三方复现;39.2% 是努力拉满时的数;新分词器同一段提示词多用约 1.25 倍 token 2 |
| 把 27B 压到 8GB 以下 | Underdog Saluki 27B 1.0,7.89GB IQ2 混合量化 GGUF,跑在原生 llama.cpp 上,Apache 2.0 3 | 工具调用 120 题 88 对原版 84;并行调用 100 题 42 对 35;九项平均保留 96%;AIME 2025 为 79.2 对 96.7 3 | 原版分数来自另一套 harness;120 题样本偏小;作者自陈竞赛数学只保住 82%–85% 3 |
| 用显存换 MoE 解码速度 | llama.cpp PR #29887:给留在内存里的专家加显存 LRU 缓存,用 --moe-cache-mib 开启,只服务 32 token 以内的批 4 | 4090 上 25.0→40.7 tok/s(1.62 倍,77% 命中);5090 上 30.8→67.8 tok/s(2.20 倍,89% 命中) 4 | 缓存预算装不下一层专家时同一张 4090 掉到 6.77 tok/s;命中率由路由决定、无法事先保证 4 |
| 一台桌面盒子能不能替掉订阅 | 一台 GB10(121GB 统一内存)跑 Qwen3.8-Flash-Next,vLLM 0.30 加 MTP 投机解码,约 30 tok/s;对手是 Opus 5.5 API(medium),三套 harness,21 道带隐藏测试的题 5 | 日常 11 题:两边都 11/11,本地 36–59 分钟对 Opus 7 分钟;难题 10 题:Opus 10/10、7.43 美元,本地默认 4/10、换成 Qwen Code 低努力档 7/10 5 | 每套配置每题只跑一次;作者承认这套题是跟 Opus 5.5 来回商量出来的;日常区间的误差范围很宽 5 |
| 浏览器里的两个小模型谁干活 | 全在 WebGPU 上跑的视频编辑器:Gemma 4 E2B 做编辑助理,EmbeddingGemma 2(文本+视觉,440M、388MB)做素材检索,Whisper-small 转字幕 6 | 已知编辑的改写 76 条里 54 条理解正确;换成从测量数据里挑剪辑,一条固定规则 32:0 打败它;EmbeddingGemma 2 把找对片段从 5% 提到 87%(24 条新闻片的 hit@5) 6 | 全部数字来自一台英特尔 Iris Xe 核显笔记本;正确率由两个 Claude Opus 实例盲评(κ 0.95) 6 |
| 自己托管的每 token 成本 | 两家内部工具的 API 账单约每月 9000 美元,换成一台 4 卡机器跑中等规模 Qwen、走 vLLM 7 | 三个月后 dcgm 显示显卡一周只忙约四分之一时间,摊到每小时的成本与 API 大致相同;把抽取积压、评测与分类任务挪到夜里后,利用率过半、每 token 成本降到 API 的三分之一 7 | 一家公司的内部账,没有给模型版本、并发与峰谷曲线;成本口径依赖任务能否推迟 7 |
| 不插显卡能跑多大的模型 | 双路 AMD EPYC 7543(64 核 128 线程)加 1TB DDR4,实测带宽 271 GB/s,纯 CPU 跑 GLM-5.3-Flash(3209 亿参数、288 专家,4bit 量化后 186 GiB) 8 | 解码 3.09→5.42 tok/s(+75%),贪婪解码最快 7.1–7.7;预填充 2159 token 从 26.9 到 42.3 tok/s;带宽只用出约 22% 8 | 单机记录;作者自己说同一配置两次能差一半,必须同窗口交替 A/B;体验要按每秒 5–7 个字来规划 8 |
| 同样多的 token 放不放得下 | 一台 12GB 与一台 32GB 的显卡上,两个权重体积相近的小模型,按 8 位量化 KV 缓存折算 9 | Ling-3.0-Tiny 每 token 6.75kB、60 万上下文约 4GB;K2-Horizon-7B 每 token 76.5kB、同样 60 万要 46GB;K2-Horizon-MoVA-36B-A4B 每 token 超过 100kB 9 | 帖子是带 RANT 标签的抱怨,未给引擎版本与硬件全貌;KV 数字按 8 位量化缓存折算 9 |
便宜档的 39.2%,是在努力拉满时测的
Claude Haiku 5.5 的官方性能表一共六行,每行并排四个模型:Haiku 5.5、上一代 Haiku 4.5、OpenAI 的 GPT-6 Luna,以及自家 Sonnet 5.5 作参照。知识工作的 GDPval-AA v2.1 从 735 升到 1620,AA-Briefcase v1.1 从 614 升到 1578,多学科推理的 Humanity's Last Exam 无工具档从 10.2% 升到 45.9%,视觉推理的 Chartography 从 6.4% 升到 46.4%,智能体编码的 Terminal-Bench 4.0 从 0.0% 升到 39.2% 1。
价格这一栏是这次发布的重点。10 万 token 以内的请求,输入每百万 token 0.10 美元、输出 0.50 美元;超过 10 万 token 之后,输入回到 0.50、输出回到 2.50。缓存读是 0.01 与 0.05 两档,缓存写是 0.125 与 0.625 1。官方脚注给的口径是:10 万 token 以内比上一代便宜 90%,超过 10 万只便宜 50%,而上一代有九成请求落在前一类,两头合起来的平均值是便宜约 75% 1。
脚注还留了一句容易漏掉的话:Haiku 5.5 换了新分词器,完成同一件工作会多用一些 token。小红书一位作者按这个换了算了一遍,他给的数字是同一条长提示词产生的 token 约为上一代的 1.25 倍 2。同一个帖子里还有另外两条口径提醒:Terminal-Bench 4.0 的 39.2% 是努力拉满时测的,默认档大约只有它的一半;整张对比表由 Anthropic 自己发布、自己测试,当时没有第三方复现 2。
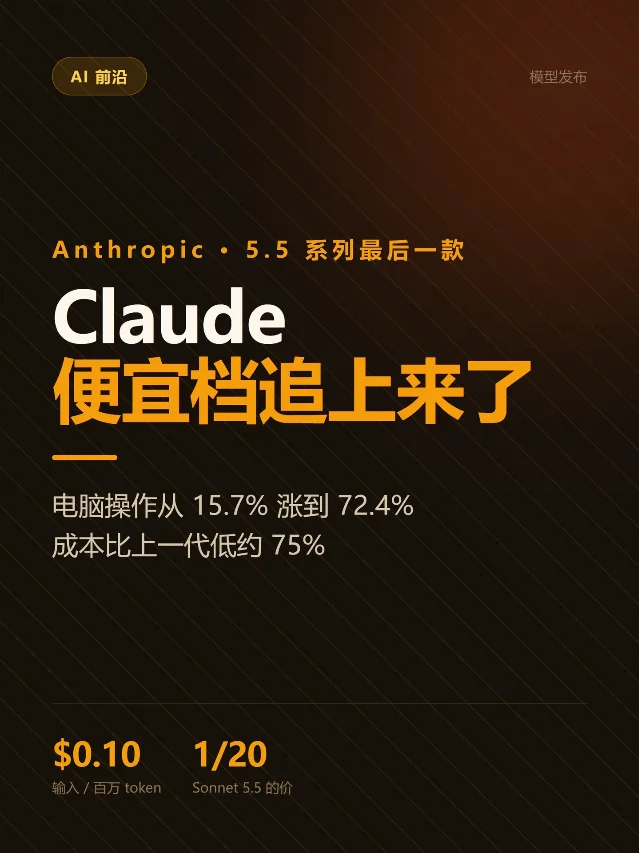
发布当天的另一条对比来自 X。一位中文圈作者把 Haiku 5.5 与 DeepSeek V4.1 Flash、GLM 5.3 Flash 的价格摆在一起,结论是它比这两个都便宜,并顺手引了 Artificial Analysis 的 Terminal-Bench 4.0 分数;他对那一栏的两句描述互相矛盾——先说比 GLM 5.3 Flash 高一分,接着说与它相同——按正文只能确认价格那一栏 10。另一位作者把它放回自家演进史里比,给的说法是它的综合水准已经能对标几个月前的旗舰 Opus 4.8 11。
官方自己划的边界是另一回事。页面上写着,Sonnet 5.5 与 Opus 5.5 仍是 Terminal-Bench 4.0 那类复杂智能体编码的更好选择,Haiku 5.5 适合的是窄一些、过去因为贵而没做的活,例如压缩、摘要、子智能体 1。页面上另引了 Asana、HubSpot、AlphaSense、Box、Rogo 与 Cognition 六家客户的评测数字,HubSpot 给的 CRM 场景成绩是三次平均 92.8%,这些同样是各家自己跑的 1。
96% 是九项平均,数学那一栏没保住
Underdog Saluki 27B 1.0 是一个把 Qwen3.8-27B 压到 7.89GB 的 GGUF,跑在原生 llama.cpp 上,许可证 Apache 2.0,视觉能力要另挂一个 928MB 或 629MB 的附加文件 3。发布帖给的三个卖点很好转述:体积只有全精度版的七分之一不到,保住 96% 的基准表现,工具调用反超原版 12。
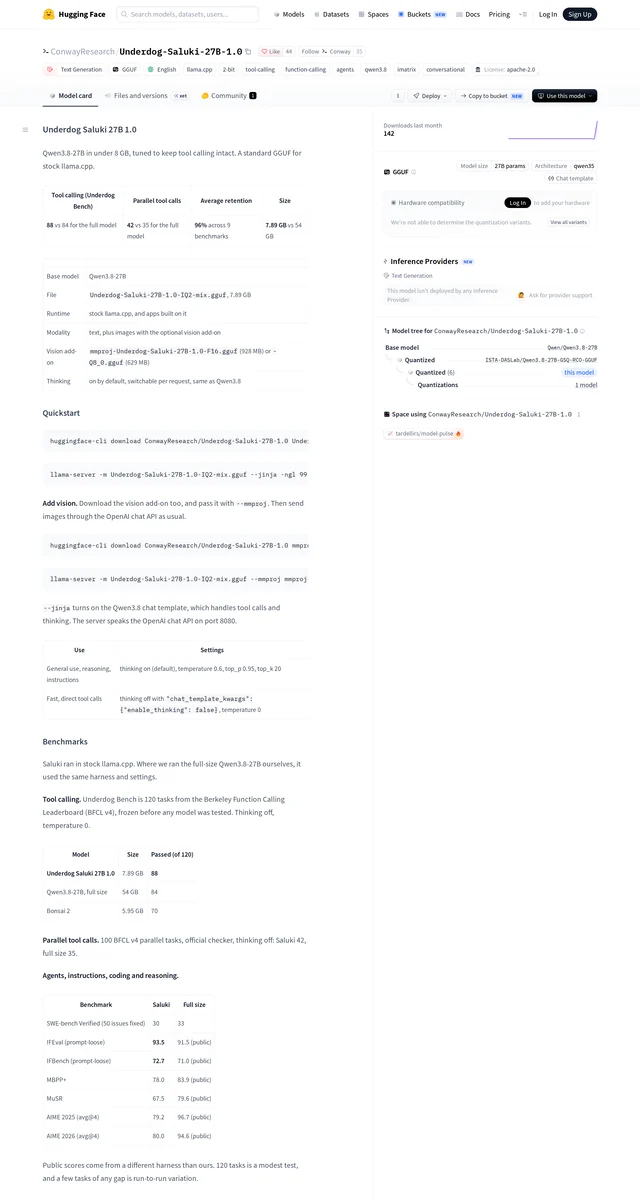
工具调用那一栏用的是 Underdog Bench:120 道来自 Berkeley Function Calling Leaderboard v4 的题,在测任何一个模型之前就冻结,关思考、温度 0。Saluki 通过 88 题,全量 Qwen3.8-27B 是 84 题,对照的 Bonsai 2(5.95GB)是 70 题;并行调用另用 100 道官方检查器,Saluki 42 对全量版 35 3。
「平均保留 96%」这个数字底下是九项,差值分布得很不均匀。SWE-bench Verified 修好 50 个 issue 里 30 个对 33 个,MBPP+ 是 78.0 对 83.9,MuSR 是 67.5 对 79.6,2025 年 AIME 是 79.2 对 96.7,2026 年 AIME 是 80.0 对 94.6;反超的两项是 IFEval 的 93.5 对 91.5 与 IFBench 的 72.7 对 71.0 3。
作者把两边的来源差别也写进了同一节:原版那几项的公开分数来自另一套 harness,120 道题的样本量本身不大,几道题的差距属于跑动之间的波动 3。限制一节写的比成绩更具体:竞赛数学只保住 82% 到 85%;字母级指令题(回文、元音规则、字母排序)最弱;并行调用大约每五条回复里有一条小的格式瑕疵;开着思考时经常长篇铺垫;视觉是附加件 3。
Reddit 上有人当天转了这个发布,标题直接抄了「1/7 的体积、96% 的表现」这句话 13。
Loading content card…
同一份缓存,两种正负号
llama.cpp 的 PR #29887 在 10 月 7 日被合并进主干,并被标了 highlight。它的做法是:留在内存里的 MoE 专家改由显存里的一个 LRU 缓存来算,只有没命中的那些才通过 PCIe 上传,只服务 32 token 以内的批,层与层之间专家排布不同的会分成不同的缓存组;开关是
--moe-cache-mib,作者建议取专家总大小的 10% 左右 4。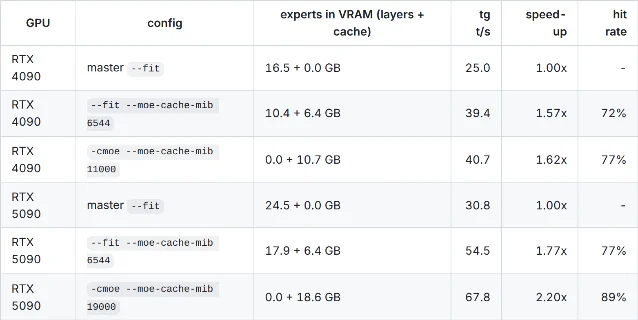
表格的环境写在表上方:模型是 Qwen3.8-Flash-Next 的 Q4_0(93.7 GiB,其中专家 65.4 GiB),题目是 SPEED-Bench 的 qualitative 组(11 类各 3 个样本,输出 512 token,温度 0),没挂 MTP;服务端
-fa on -c 32768 -b 2048 -ub 2048 -t 16,CPU 在显卡所在的 NUMA 节点上(EPYC 7742,16 核),PCIe 4.0 x16;基准是主干默认 --fit 4。反过来的一栏出现在同一条讨论串里。另一位测试者在 4090 上跑 Qwen3.8-Flash-Next 的 UD-Q4_K_XL,用
--n-cpu-moe 48 把专家放在 CPU 侧:不开缓存是 20.9 与 25.1 tok/s,--moe-cache-mib 1024 掉到 7.30,--moe-cache-mib 2048 掉到 6.77,日志给出的原因是这个预算连一层专家都装不下,于是它们根本没被缓存 4。同一条串里还有一组 AMD 侧的读数,把「命中率」这一栏单拎出来看更清楚。第三位测试者用 ROCm/HIP 跑 Qwen3.8-Flash-Next 的 IQ1_M,批不超过 8 个 token 时解码命中率是 8000 MiB 档 85.0%、16000 MiB 档 94.6%,批一超过 8 就掉到约 18%;解码速度对应为 11.0、14.5、27.6 tok/s,预填充从 51.5–59.3 升到 65.2 与 66.5 4。
这条改动落地的当天,同一仓库还合并了 PR #30112,把 MoE 缓存从单卡扩到多卡 14。X 上一位作者把第一张表复述了一遍,提醒的正是命中率那一栏:命中率高于 75% 时接近原生速度,掉到 50% 以下时瓶颈会变成 PCIe 15。
Loading content card…
一台桌面盒子对 Opus 5.5:21 道题,三套 harness
这一组的作者原本每月付 100 美元的 Claude Max,为了让额度够用,买了一台 GB10 的桌面盒子专门跑编码与日常智能体任务,保留 Claude Pro 作为补充。他写了 21 道带隐藏测试的题,把本地的 Qwen3.8-Flash-Next 与 Opus 5.5 放在同一套题上跑 5。
运行条件是:本地用 NVIDIA 的 NVFP4 权重、vLLM 0.30 加 MTP 投机解码,跑在 121GB 统一内存的 GB10 上,长生成约 30 tok/s;对手走 Opus 5.5 的 API,努力档 medium。三套 harness 分别是一个最小三工具循环、Claude Code 2.1.285 与 Qwen Code 0.24.7。判分在独立沙箱里跑隐藏测试,二值通过或不通过,改动测试文件即判失败;时限放宽到 Opus 所需时间的至少两倍;每套配置每题只跑一次 5。
日常档 11 道题(修 bug、按规格实现、重构、从堆栈里排障、一个 TS 命令行、一次跨层的前端改动,加上文档问答、摘要与抽取)两边都做对 11 道。差别在时间:Opus 一共花了 7 分钟,本地在所有调好的配置里是 36 到 59 分钟 5。
难题档 10 道(按 5,800 字规格写一个带 230 项检查的解释器、在 3.5 万行代码里只给症状的排障、一次 40 倍的性能重写、asyncio 并发 bug、80 处调用点的 TS 迁移、可证明最优的调度、从 6.6 万 token 文档里给精确答案)就分开了:Opus 10 道全对,总花费 7.43 美元,折合每次通过约 0.73 美元;本地用最小 harness、默认设置只做出 4 道,换成 Qwen Code 加低努力档并做一处修正是 7 道。还有一套配置在时间用尽时工作其实已经全对,只是没停下来 5。
他列的几条经验比分数更有用。Flash 的对话模板默认把
reasoning_effort 设成 xhigh,改到 medium 最多快 2.3 倍而没丢通过;在 Qwen Code 里低努力档最好。Qwen Code 的 /effort 与 model.reasoningEffort 到不了 vLLM,前者发的是 reasoning: {effort} 对象、vLLM 读的是顶层的 reasoning_effort,要写在 model.generationConfig.extra_body 里。Qwen Code 会静默丢弃流式超过 15 分钟的响应并从头重试,在 30 tok/s 下一次 2.5 万 token 的思考就能撞上这个上限。他还写下了失败的样子:时间花在反复验证上。在并发那道题上它先修好 bug,然后自己写了一套压力测试,在这套测试里踩到问题,把剩下的时间用来调自己的测试 5。他自己承认,这套题是跟 Opus 5.5 来回商量着建起来的,题目本身不算新,很多东西是社区里已经跑过一遍的重述;每题只跑一次,日常档的区间要按宽的看。harness 的选择对难题档分数的影响,和调参差不多大 5。
Loading content card…
会排序的小模型,打败了会写的小模型
一位作者写了一个完全跑在 WebGPU 上的浏览器视频编辑器,没有服务端。里面的智能体是 Gemma 4 E2B(LiteRT-LM 的网页版),素材检索用 EmbeddingGemma 2 的文本+视觉版(440M、388MB,LiteRT-LM 0.18),字幕用 transformers.js 载入的 Whisper-small,全部在一个 Chrome 标签页里,机器是一台核显笔记本(英特尔 Iris Xe,共享内存)6。
先说它擅长的一半:他准备了 120 条自己那套关键词规则接不住的请求,每条开一个干净页面,由两个 Claude Opus 实例盲评(一致性 κ 0.95)。76 条是对编辑器已有功能的改写,54 条理解正确、9 条明显错、0 条错得像对的、13 条什么都没做;另 20 条含糊或一次说了好几件事的请求里,只有 4 条正确 6。
失败在决策那一层。要从测量数据里挑出该做哪个剪辑时,一条固定规则以 32:0 赢过它;约束解码、追问一遍、把语气换得更直接,三种办法都没救回来,最后这部分逻辑被搬进了代码 6。
真正把活干成的是那个更小的模型。EmbeddingGemma 2 在后台给视频帧建索引之后,从 24 条新闻片里找对目标片段的比例从 5% 升到 87%(hit@5),它还能和 Gemma 4 E2B 同时跑在那块核显上而不报错。作者自己总结的一句话是:会排序的小模型打赢了会写的小模型 6。
这份记录里的每个数字都来自那一台笔记本,评分的两个裁判也是模型。同一周,EmbeddingGemma 2 在中文圈被另一篇文章介绍过:它是 Google 10 月 6 日发布的多模态嵌入模型,做的是把文字、代码、图片、音频与视频换成可比较的向量,服务对象是开发者 16。
Loading content card…
自托管的每 token 成本,要么加班次,要么加利用率
一家公司把两个内部工具的 API 账单养到了每月约 9000 美元,于是买了一台 4 卡机器,把中等规模的 Qwen 放上 vLLM,整个搬过去。买单前财务看到的表格写的是每 token 成本约为 API 的五分之一 7。
三个月后,作者把 dcgm 的数字拉给财务看:显卡一周只忙大约四分之一的时间。两个工具都跟随办公时间,机器当初是按上午那份峰值配的,于是把成本摊到每一个小时上,每 token 成本与 API 大致相当 7。
改动的方向落在活本身上:抽取积压、评测与一个分类任务被挪到了夜里,这些活不在乎什么时候跑完。利用率过了半,每 token 成本降到 API 的三分之一 7。
作者写这条是想补一栏:他能读到的自托管成本测算,都默认显卡会一直满负荷,没有一份问过「你有多少活可以等到夜里」。这个帖子里没有模型版本、并发数与峰谷曲线,只有这一家的账 7。
不插显卡跑 320B:三招加了 75%,天花板在访存
10 月 8 日发在小红书上的一份记录,用的是一台没有计算显卡的服务器:双路 AMD EPYC 7543(64 核 128 线程)加 1TB DDR4,八个 NUMA 节点,实测内存带宽 271 GB/s;模型是 GLM-5.3-Flash,总参数 3209 亿、288 个专家、每个 token 激活 8+1 个,4bit 量化后权重 186 GiB,全程纯 CPU 推理 8。
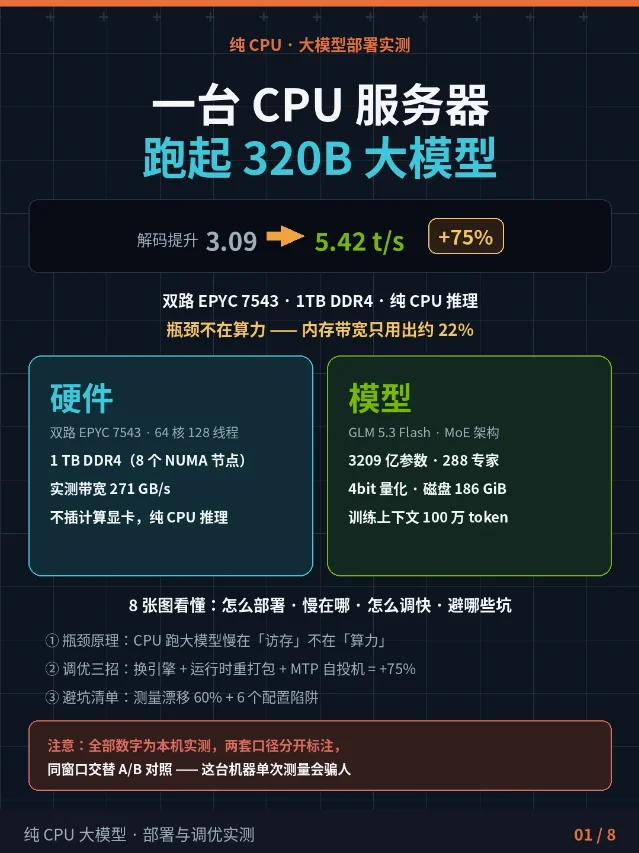
作者先算了一笔账:每生成一个字都要把这一路用到的权重从内存里读一遍,约 180 亿激活参数乘以 0.62 字节,合下来每个 token 约 11GB;按 271 GB/s 折算理论上限约 24 t/s,实测只有 5.4。剩下的差距他归到访存延迟上——八个 NUMA 节点跨节点取数慢,带宽并不是瓶颈 8。
三招把解码从 3.09 提到 5.42 t/s。第一招换引擎,从 llama.cpp 换成 ik_llama.cpp,用
-rtr 重打包 768 个 MoE 张量,带来约 40%;第二招开 MTP 自投机,模型自带草稿头、--spec-type mtp:n_max=2,命中率约 69%,再带来约 26%;第三招做内存交织,numactl --interleave=all 加 -t 32,把权重摊平到八个 NUMA 节点上 8。读数按同窗口交替 A/B 的方式给:解码 3.09 到 5.42 t/s,贪婪解码下最快能到 7.1 至 7.7;预填充一条 2159 token 的长提示词,从 26.9 提到 42.3 t/s,涨了 57%;体感是贴一份 2000 token 的文档大约 48 秒吐第一个字,输出大约每秒五个字 8。
他自己标了两个坑。吞吐漂移最高到 60%,同一套配置两次测量能差一半,单次测量不可信,必须同窗口交替 A/B 取一致值;投机解码的
p_min 不能设成 0,那等于无条件接受草稿,输出会退化成复读。部署面用的是 llama-server 的 OpenAI 兼容接口加 Open WebUI,两者都只绑在 127.0.0.1 上 8。他的结论是纯 CPU 跑大模型可行,但要按每秒五到七个字的体验去规划;下一步的提速方向在内存喂得更顺,再往上就得让显卡分担一部分层 8。
模型卡上没写的那一栏
另一位作者在 r/LocalLLM 上贴了一篇带 RANT 标签的抱怨,主题是模型卡从来不列 KV 缓存的成本。他用自己那台 12GB 的机器举了例子:Ling-3.0-Tiny 的权重装得下,上下文还能塞进 60 万 token,够开八个 64k 会话;换成 K2-Horizon-7B 之后,同样多的 token 连他那台 32GB 的机器都放不下 9。
差在每一个 token 的上下文要占多少显存。Ling-3.0-Tiny 是 6.75kB,K2-Horizon-7B 是 76.5kB,后者是前者的十倍以上;换成显存总量看,60 万上下文的 KV 缓存前者约 4GB,后者要 46GB;在 12GB 的卡上,就得把 60 万 token 的上下文换成约 5.3 万。同一家的 K2-Horizon-MoVA-36B-A4B 更贵,每个 token 的上下文超过 100kB 9。
这些数字都按 8 位量化缓存折算,未量化的开销还要更高;作者没有交代引擎版本与整机配置,这帖的体裁是抱怨短帖 9。
顺带看到的几条
四台 DGX Spark 连起来跑 552B。这条原帖是 10 月 5 日发的,因为本周被反复转述,放在这里并注明日期。发帖人是 AMD 的 Patrick Moorhead,他用四台 DGX Spark 以 QSFP 直连成环形拓扑(没有光交换机也没有以太网交换机)跑 DeepSeek V4.1-Flash 的 5520 亿参数版本:32 路并发时编码 494 tok/s、散文 280 tok/s,单请求约 58(散文)与 96(代码),预填充约 4,764 tok/s,空闲时首字约 0.2 秒;模型占用 476GB,四台合并约 512GB 统一内存,每台 128GB LPDDR5X、带宽约 273 GB/s 1718。外媒算的整套价格是 2.5 万到 4 万美元,并写明 NVIDIA 官方推荐的 4 机方案是 200GbE 星型而非这种环 18;国内一篇公众号也转述了同一组数字 19。
Google 在 10 月 6 日上线 Nano Banana 2.1,官方把规格放在 DeepMind 的模型卡页 20。10 月 7 日小红书上的一篇对照把规格写全:支持最多 10 个视频文件输入生图、最高 4K 输出、15 种宽高比、128K 上下文;作者给它的评价是多轮生成与连续编辑下的主体一致性、文字排版与参考图控制精度都有改善,画面偏干净、风格偏卡通,出现的问题在纹样与磨损细节不足、风格存在波动 21。
韩国几家银行遭到的攻击,被点到的模型是一套组合。X 上一位 AI 作者 10 月 8 日转述 CrowdStrike 的一份报告,称上周的攻击可能由单人完成,工具栈是开源渗透工具 ARTEX 加上 DeepSeek V4.1-Flash 当主力,另接了 GLM-5.3、Grok 4.6 与 Claude Code;他附的是转述与截图 22。
两条小注。有人在 r/LocalLLM 贴出一个用 Java 编译到 CUDA 的 vLLM 式框架,仓库自己称在 NVIDIA 显卡上的本地推理能到 llama.cpp 的约 90%,代码在 TornadoVM 与 jitllm 两个仓库里 23。ExLlamaV3 发布 v1.6.0,加了 ROCm 与 RDNA 支持,并在 Linux 上默认关掉了 CPU pinning 24。
今天能带走的三句话
第一句,先找门槛,再看数字。同一份官方表里,39.2% 在努力拉满时成立、72.4% 在离线子集上成立;同一组家用集群读数里,494 tok/s 是 32 路并发时的数,单请求只有 58 到 96;同一份缓存对照里,1.62 倍配的是 77% 命中率 124。
第二句,折扣和损失通常写在同一张表的不同行。把 27B 压到 7.89GB,九项均值保住 96%,数学那两项掉了 15 个点上下;给 MoE 加显存缓存,预算够时速度翻倍,预算连一层专家都装不下时速度掉到原来的三分之一 34。
References
- 1Anthropic:Introducing Claude Haiku 5.5
anthropic.com
- 2小红书 罗集:Claude便宜档,能干专业活了
xiaohongshu.com
- 3Hugging Face:Underdog Saluki 27B 1.0 模型卡
huggingface.co
- 4
- 5
- 6Reddit:一个浏览器视频编辑器里的两个本地模型\
reddit.com
- 7Reddit:自托管的每 token 成本,直到显卡有了夜班才赢过 API\
reddit.com
- 8小红书 喵闻周报AI打工记:不插一张显卡,纯 CPU 跑 320B 大模型实测\
xiaohongshu.com
- 9Reddit:模型卡该把 KV 缓存开销列出来\
reddit.com
- 10
- 11小红书 Lando的AI实践:Haiku 5.5 能对标哪一代的 Sonnet 甚至 Opus
xiaohongshu.com
- 12
- 13Reddit:Saluki 27B,约七分之一体积保住 96% 表现
reddit.com
- 14
- 15
- 16公众号 AI引路者:照片、录音、文档一起搜:Google 这次更新的不是聊天模型
mp.weixin.qq.com
- 17
- 18
- 19公众号 AMP实验室:AMD 技术专家家庭部署 DeepSeek V4.1 Flash,用的是四台英伟达 DGX Spark
mp.weixin.qq.com
- 20Google DeepMind:Nano Banana 2.1 模型卡
deepmind.google
- 21小红书 海贼AI:Nano Banana 2.1 VS GPT Image 2.5 实测对比
xiaohongshu.com
- 22
- 23
- 24
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.