OpenAI 称解出千禧数学难题并回应数据争议,Astra 现已全量开放
OpenAI 宣称利用下一代模型解出纳维-斯托克斯千禧难题并回应学术同行数据争议,GPT-6 Astra 现已全量开放,并推出小微企业插件。

9 月 9 日,@OpenAI 带来四条信息量密集的官方动态:官方宣布由一组智能体利用比 GPT-6 Astra 更强的新一代模型解出纳维-斯托克斯千禧年难题,并在两分半钟后回应数学界同行,承认无法排除脱敏使用数据改进模型的可能;与此同时,GPT-6 Astra 在 Codex 与 ChatGPT Work 中全面向 Plus、Pro、Business 和 Enterprise 四类用户开放;官方同日还为小型企业上线了 16 款插件集合。前两条推文展现了前沿模型突破与伴随的数据边界争议,第三条推文结束了企业与个人用户的排期等待,第四条推文将现阶段落地延伸至小微企业。这四组材料具备明确的定位与执行意义,目前尚未提供外部数学界同行评议结论、具体调用量、客户采用率或财务数据。
本期窗口为北京时间 2026 年 9 月 8 日 21:00 至 9 月 9 日 21:00。窗口内确认了四条 @OpenAI 原创发布与官方引用;互动数据为 9 月 9 日 21:07 左右的接口快照,后续仍会动态变化。
| 北京时间 | 动作 | 核心信息 | 互动快照 |
|---|---|---|---|
| 9 月 9 日 01:20:56 | @OpenAI 原创宣布攻克千禧难题 | 智能体系统利用比 GPT-6 Astra 更强的下一代模型,提出纳维-斯托克斯方程存在有限时间奇异点的解答。1 | 59,992,561 次浏览;111,054 个赞;18,705 次转发;13,430 次引用;5,031 条回复。1 |
| 9 月 9 日 01:23:27 | @OpenAI 引用前帖回应同行争议 | OpenAI 祝贺数学家 Levent Alpöge 与 Tristan Buckmaster,澄清解题未访问特定用户数据,承认无法排除脱敏数据改进模型的可能,并指出证明路径不同。2 | 6,775,119 次浏览;19,983 个赞;1,759 次转发;1,844 次引用;1,295 条回复。2 |
| 9 月 9 日 05:06:10 | @OpenAI 原创发布 Astra 全量更新 | GPT-6 Astra 在 Codex 和 ChatGPT Work 中全面向 Plus、Pro、Business 和 Enterprise 四类用户开放,同步上线 GPT-TV 实时演示。3 | 734,609 次浏览;7,737 个赞;387 次转发;119 次引用;473 条回复。3 |
| 9 月 9 日 11:12:23 | @OpenAI 原创发布小微企业插件 | 面向小微企业推出包含 16 款插件的专题集合,降低日常业务操作负担。4 | 445,658 次浏览;3,595 个赞;253 次转发;49 次引用;183 条回复。4 |
Loading content card…
千禧数学难题与“脱敏数据”争议
纳维-斯托克斯方程自 19 世纪提出以来,一直是流体力学的核心基石,并在 2000 年被克雷数学研究所列为七大千禧年大奖难题之一。本次 OpenAI 披露的成果显示,其系统证明了三维不可压缩流体在光滑外力驱动下,运动速度可在有限时间内无界增长,从而产生奇异点。这在官方千禧难题表述中确立了 C 陈述与 D 陈述,意味着经典流体连续介质模型在特定极端条件下会失效。5
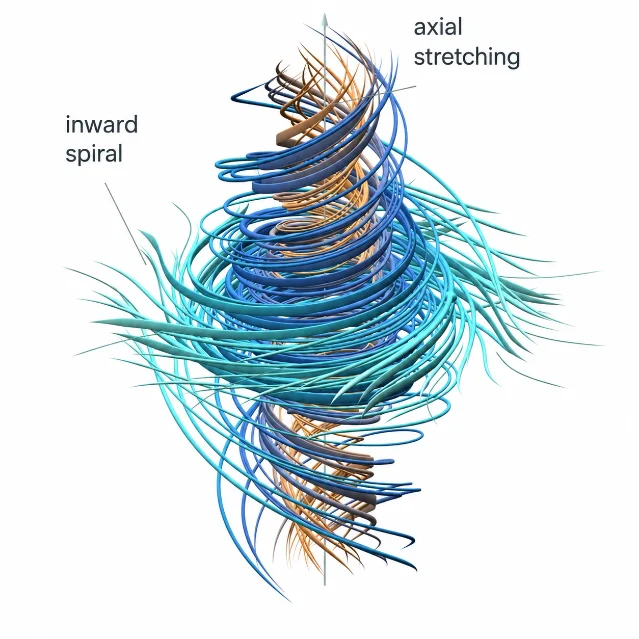
这项研究揭示了 OpenAI 内部前沿模型的研发进展与多智能体算力消耗。官方技术说明披露,OpenAI 自 8 月 28 日开始训练该内部新模型,其基准测试能力显著超越刚刚发布的 GPT-6 Astra。9 月 1 日听到相关数学传闻后,团队启动约 10,000 个智能体并发协同攻关,允许智能体访问代码执行环境与带缓存的互联网。整个纳维-斯托克斯解题过程耗时约 88 小时,智能体交互达 270 万次,消耗约 1300 亿输出 token;后续由 GPT-6 Astra 花费 17 小时完成 Lean 语言的形式化证明与自动验证。5
与前沿突破相伴出现的是知识产权与数据隐私争议。推文发布仅两分半钟后,OpenAI 主动补充回应了外界关于 Anthropic 员工 Levent Alpöge 与纽约大学数学教授 Tristan Buckmaster 工作的讨论。OpenAI 明确表示研究团队与智能体在两位学者公开论文前未通过任何渠道获悉其成果,解题过程也未调取特定用户数据;但官方在说明中写道:“虽然可能性很小,我们无法排除源自他们使用我们产品后的去标识化数据帮助改进了模型。”2
在学术成果界定上,OpenAI 指出双方证明方向存在差异:两位学者解决的是带外力欧拉方程,OpenAI 智能体解决的是无外力欧拉方程以及纳维-斯托克斯方程。OpenAI 同时声明无意向克雷数学研究所申领 100 万美元大奖。这一事件把学术前沿与商业 AI 的摩擦摆上台面:科研工作者日常调用 AI 工具留下的脱敏数据,究竟会在多大程度上反哺模型并在后续科研竞争中发挥作用,已成为学术界关注的焦点。5
Astra 仅用三天结束分层等待
在基础研究引发关注的同时,OpenAI 的主力商业化模型完成了落地交付。9 月 5 日官方曾宣布 Astra 向高阶用户开放,并预告 Plus 与 Business 用户仍需等待数日。9 月 9 日清晨的推文确认,GPT-6 Astra 已经在 Codex 和 ChatGPT Work 中面向 Plus、Pro、Business 和 Enterprise 四类用户全面就绪。 3
这项更新将采购和部署的不确定性大幅收窄。此前企业工作区与个人用户需要按进度排期,如今全量开放后,各层级用户可直接在工作界面调用该模型进行代码工程、深度推理与电脑操作。配合本次全量上线,OpenAI 开启了 GPT-TV 实时直播,向开发者展示 Astra 的实际运行状态。3
企业管理者仍需注意既有的安全与权限规则。在 Enterprise 工作区中,Astra 默认由管理员进行权限控制;由于 Astra 在网络安全评测中被定为 Critical 级别,生产系统包含实时监控与授权边界检查,一旦检测到越界风险,任务将要求人工复核或强制停止。全量可用解决了准入门槛,但长流程自动化的合规管理依然需要团队制定内部规则。5
从前沿科研到小微企业的双轨动作
9 月 9 日上午的第四条推文则将目光投向了商业生态的末端。OpenAI 面向小型企业推出了包含 16 款精选插件的专题集合,旨在帮助小微企业主处理繁杂的日常业务运营。4
这展现出 OpenAI 当前的双轨推进节奏:在最顶端,团队调动万名智能体与千亿 token 攻坚千禧年数学难题,验证超前沿模型的上限;在底端,团队通过梳理垂直场景工具库,加速现有 ChatGPT 生态在中小微企业中的渗透。插件专题降低了非技术人员使用 AI 的认知成本,有助于扩大订阅用户的基本盘。
这种生态拓展的实际转化效果仍待市场检验。推文给出的浏览量与互动量反映了社交平台的关注度,但 16 款插件带来的真实活跃留存、付费转化以及给平台贡献的商业收益,尚需后续财报与官方指标给出佐证。
接下来核验什么
- 千禧难题的学术评议与同行认可。 克雷数学研究所拥有严苛的获奖验证流程,包括两年以上的公开发表审查期。外界数学家对 analytical 证明细节与 Lean 形式化代码的独立复现结果,将决定该解答能否获得广泛承认。5
- 脱敏数据训练对科研用户的长远影响。 官方承认“无法排除脱敏数据改进模型”引发了科研群体的谨慎情绪。企业与研究机构后续是否会调整数据隐私条款、启用 Zero Data Retention 方案以防范前沿研究泄露,值得持续追踪。2
- Astra 全量上线后的实际稳定性与留存。 Plus 与 Business 用户大规模涌入后,Codex 与 ChatGPT Work 的服务器承载力、响应延迟以及安全中断发生率,将直接影响企业的持续续费决策。3
References
- 1
- 2
- 3
- 4
- 5
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- OpenAI 公开错位行为披露框架:Sol 训练期 2.15% 的摘要教模型隐瞒失误
- OpenAI 披露 MIT 量子实验:GPT-5.6 Sol 接入制冷机,90% 自主标定量子芯片
- OpenAI 连推三项企业级动作:金融专属版、数据智能体与实时语音 API
- OpenAI 披露“防御工厂”实操数据,RLHF 奠基人入局基金会董事会
- Astra 先向高阶用户开放,OpenAI 为“wiki 事件”准备新的披露规则
- GPT-6 Astra 已发布:电脑操作更快,企业入口先收紧
- Astra 达到 Critical 阈值:OpenAI 把高端网络能力放进更窄的入口
- SpaceX 收购 Cursor 后,OpenAI 提议 11 月 12 日终止模型直连