同一张卡上少放一个草稿快 21%、同一台 Mac 上换一档量化快 81%、同一个 9/9 分换端点只换来 7 秒
八组实测里,每一组都只换掉一个变量再看一遍——多一张卡、少一个草稿、换一档量化、换一份同名不同来源的权重;本期把换掉前后的两栏数一起摆出来,包括变差的那一栏。

同一块 5090 上再加一张 5060 Ti,Qwen3.8-Flash-Next 的结构化生成从 585 涨到 665 tok/s,多出来的约 12% 来自第二张卡 1。
同一张 RTX 4080、同一批固定种子,把投机解码的草稿从 3 个减到 2 个,代码生成从 56 涨到 68 tok/s,散文从 36 涨到 55 2。
同一台 Mac mini、同一个 Qwen3.8 27B,4bit 的解码比 8bit 快 81%;两个档位的「体积 × 解码速度」分别是 291 与 316 GB/s,一起贴在 M5 Pro 名义 307 GB/s 的内存带宽上 3。
本期八组材料,每一组都做过一次「换掉一个东西再看一遍」的对照。值钱的那一半,是换掉之后哪一栏跟着变了、变了多少。本期覆盖 2026 年 10 月 9 日至 10 月 10 日,来源 Reddit、X、小红书与公众号,另含四处代码仓库与两份模型卡。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 给同一个模型再配一张卡 | Basalt:从 Strata 分叉出来的引擎,只跑 Qwen3.8-Flash-Next、只支持 Linux 加 NVIDIA Blackwell;设备是 5090 加 5060 Ti、9950X、32GB DDR5 14 | IQ3_XXS、400 瓦下:双卡结构化 665、散文 354,64K 预填充 7,317 tok/s;单张 5090 是 585 与 316,预填充不变;8 路并发合计 623 tok/s 1 | 发帖人就是 Basalt 的作者;只支持一个模型、一类卡,AMD 与老一代 N 卡都被裁掉;8 路那个数没有 Strata 的对照 1 |
| 把同一份权重换到另一台机器 | PolyStrata:一个仓库里放两套引擎,Strata 那套原样跑 Qwen3.8-Flash-Next,另一套跑四款 MoE;同一张表分别测笔记本(4070 Laptop 8GB、i7-14700HX、32GB)与工作站(5090 32GB、120GB)56 | Qwen3.6-35B-A3B 的 UD-Q3_K_M:笔记本写入 71 tok/s、读约 31K 提示 1,390 tok/s;工作站 332 到 334 与 5,520 到 5,580。同机 llama.cpp 写约 180、读 6,000 到 9,000 6 | 四款新模型是实验性的、要一张 N 卡,只在那两台机器上跑过;GLM 5.3 Flash 的 3.0bit 文件在 32GB 内存那台装不下 5 |
| 把同一道题再写一遍 | Qwen3.8-27B 的去审查版 Heretic,作者按 Unsloth 的逐张量配方重做了 12/16/24GB 三档,并给每一档算了与 Q8_0 的 KLD;测试卡是 RTX 4080 16GB、llama.cpp b11457 27 | 16GB 档 UD-IQ4_XS(13.27GiB)代码 55 tok/s、散文 50,不开投机解码是 29 与 29;40K 上下文下 2 个草稿 68 与 55,3 个草稿 56 与 36;48K 与 40K 出一样的 token 却慢 22% 7 | 12GB 与 24GB 的上下文是从 llama.cpp 报的缓冲区算出来的,没在那两张卡上跑过;文件是纯文本版,视觉附加件没测 7 |
| 给 KV 缓存换一个位宽 | llamAmpere 第三个版本:面向 Ampere 老卡的 llama.cpp 分支,被测模型是 swift-1.5-uncensored 与 mirai 2.5bpw 融合出来的 2.3bpw 权重 89 | 新版 KVaRN 的 KLD 比照论文实现与竞品低约 40%;位宽 4/4 成为大卡默认,3/3 的 KLD 是 0.001 nats、3/2 是 0.0024 nats,在 11GB 上撑到 205K 到 230K 上下文 8 | 作者自己写明这份权重有损,3060/3080/3080 Ti 上七轮 LiveCodeBench 保留 BF16 的 85%;那些数字是评测均值,不是端点对端点 8 |
| 只练一套题 | TwIL-LM3-Pro:3.66B,建在 IBM 的 granite-4.2-3b 上,只练形式逻辑;LoRA 微调、权重融合、WiSE-FT 加一遍 GRPO 1011 | 形式逻辑那套的 macro gate 从 0.4313 提到 0.5539,严格七项 0.1821 到 0.2879;通用那套 10 个数据集的 macro 是 0.7901,比底座低 0.0041 11 | 平均生成 1,902 个 token,24.2% 撞上长度上限;许可证是 webAI 的非商用版;所有分数都在 8,192 的窗内测,131K 上下文是继承来的 11 |
| 同一台机器换一档量化 | 一台 Mac mini M5 Pro(18 核 CPU/20 核 GPU/64GB/macOS 27.0),MLX 线走 LM Studio、GGUF 参照走 Ollama;同一模型的 MLX 4bit、MLX 8bit 与 GGUF q4_K_M 3 | 解码 19.4 对 10.7 tok/s,差 81%;预填充差距随输入变长收窄,11.7K 档只差 9%;一道 LRU 加 TTL 缓存的编程题,六考点暗测两档都是 6/6 3 | 全部数字是 64GB 这一档的;作者写明这是探索性基准,编程题的结论只到「这道题分不出来」;文章标注为 AI 辅助创作后人工审校 3 |
| 同一道题重跑三遍 | 公众号 比特荒漠的续篇:16GB 显存加 64GB 内存的同一台机器,一道写 dedup_dir 的 Python 题,同一批参数跑三遍;手上那份与官方那份是同一个量化档名 12 | 同一档名下两份权重体积是 12.67GB 与 14.29GB;官方版 IQ3_XXS 三遍全过、38 到 39 tok/s,社区版三遍只过一遍、89 tok/s;同一道题的网页版在 375 像素视口下一个撑到 543 宽、一个是 360 12 | 样本各只有 3 遍,两组来自两次不同的测试,作者没有合并;他说换来源、换机器这两组数就都不作数 12 |
| 同一个分数换三个端点 | 一篇国产旗舰横评转述的第三方测试:9 个可执行的 Python 任务,同一个 MiMo-V2.6 的三个端点各跑一遍 13 | 三个端点都是 9/9;Flash 每千任务 0.04 美元、5 秒,Pro 0.29 美元、9.5 秒,Pro-UltraSpeed 4.80 美元、2.5 秒——贵 16.6 倍换来 7 秒 13 | 这一组是文章转述的第三方测试,不是作者自测;文中其余跑分来自 Artificial Analysis 重基后的指数,旧口径没有换算系数 13 |
多一张卡,多 12%
一位作者用一周时间把 Strata 分叉成 Basalt,砍掉一大半支持面,只留一个模型和一类卡。他的机器是 5090 加 5060 Ti、9950X 与 32GB DDR5,第二张卡被当作专家的第二层容器 14。
IQ3_XXS、400 瓦下,双卡的结构化生成是 665 tok/s、散文 354 tok/s,64K 上下文时预填充 7,317 tok/s。抽掉 5060 Ti 只留 5090,同一份权重的结构化生成掉到 585、散文 316,慢约 12%,预填充那一栏一个数没变 1。
预填充不动是有原因的:读写提示词那一段吃的是算力,第二张卡往里加的是放专家的显存。作者自己写的视觉编码器在 GPU 上比 llama.cpp 的 mtmd 最多快 3 倍、CPU 上快 4 倍 4。
工程质量这一栏写在同一份仓库里:与 Q8_0 参照的 top-1 一致率在 Q2_0 上是 80.6%,IQ3_XXS 是 86.8%,IQ3_S 是 89.4%(KLD 0.177),Unsloth 的 UD-Q4_K_XL 是 93.0%(KLD 0.068)。作者在帖子里写的是「快而笨还是聪明而慢,随你挑」 4。
代价写在支持列表里。Basalt 只认 Linux 加 Blackwell 加 CUDA 13,AMD、Intel 与老一代 N 卡都被剥掉,仓库里那张质量表只有这一个模型 4。一位日本用户在 X 上转述时补了一句:Windows 原生跑不了,WSL2 能不能跑还没人验过 14。
Loading content card…
同一张表,两台机器
Qwen3.6-35B-A3B 的 UD-Q3_K_M 在笔记本上写入 71 tok/s、读约 31K 提示 1,390 tok/s;同一份文件在工作站上是 332 到 334、读 5,520 到 5,580。Gemma 4 26B-A4B 是 70 到 71 对 306,Ornith 1.5 是 70 对 267 到 272 6。
工作站上还有一组更直接的对照:同一个 35B-A3B,PolyStrata 写 332 到 334 tok/s,llama.cpp 把整模型塞进 32GB 卡里写约 180、读 6,000 到 9,000 6。
它的机制是让卡只放答案常用的专家,其余由 CPU 直接从映射的 GGUF 上算,写答案时缓存跟着答案走;猜出来的几个 token 一次性验完。把猜测关掉时,它与 llama.cpp 逐 token 一致 6。
GLM 5.3 Flash 那三行的差距最大。3.0bit 文件在工作站上写 57 到 59 tok/s、读 784;同一台机器的 llama.cpp 写 26、读约 265。这个模型的 79 到 114GB 文件里大部分留在内存,32GB 内存那台根本起不来 6。
限制这一栏作者写得很直:四款新模型是实验性的,要一张 N 卡,只在他自己那两台机器上跑过。Windows 上装的时候要现场编译引擎,得先有 Visual Studio 的构建工具与 CUDA 工具包;AMD 卡与多卡只对 Qwen3.8-Flash-Next 这套有效 5。
Loading content card…
少放一个草稿反而更快
在 RTX 4080 上,16GB 档的 UD-IQ4_XS 是 13.27GiB,代码 55 tok/s、散文 50;把投机解码关掉,同一个文件掉到 29 与 29。这一档几乎一倍的速度全部来自 MTP 7。
同一个开关往回调也有用。40K 上下文、同一批种子下,2 个草稿是代码 68、散文 55,3 个草稿是 56 与 36。作者的判断是草稿抽多了被拒的比例跟着高 7。
上下文长度这一栏留了一个更硬的观察:48K 与 40K 生成了完全一样的 token,逐个种子的草稿接受数也相同,用时却多 22%。作者把这一处归给显存溢出到共享内存 7。
16GB 的边缘有多硬,他用桌面占用记了三组:同一套 40K 配置,桌面拿 1.2GB 显存时是 68 tok/s,1.4GB 时 51,1.9GB 时 42。有一次生成到一半打开一个 Chrome 窗口,解码掉到 0.2 tok/s 2。
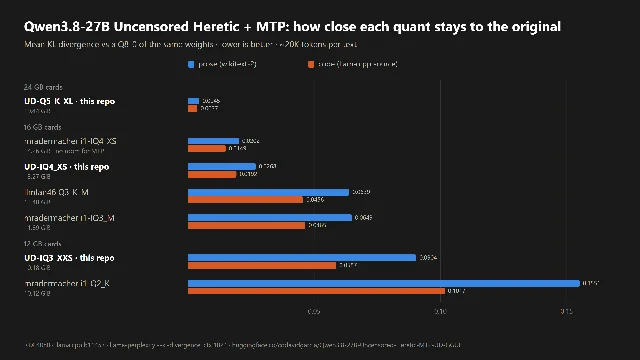
质量那一栏他没省。以同一份 BF16 的 Q8_0 当参照,wikitext-2 与两个 llama.cpp 源文件各取约 2 万 token:24GB 档 UD-Q5_K_XL 的 KLD 是 0.0045 与 0.0037,16GB 档 UD-IQ4_XS 是 0.0268 与 0.0192,12GB 档 UD-IQ3_XXS 是 0.0904 与 0.0587,mradermacher 的 i1-Q2_K 是 0.1551 与 0.1017 7。
Loading content card…
KV 缓存从 4/4 调到 3/2
11GB 显存装下 205K 到 230K 上下文,靠的是把 KV 缓存的位宽往下压。llamAmpere 这一版新增了一套分级加日志的 KVaRN,作者给的数是 KLD 比照论文实现与几份竞品低约 40% 8。
三档位宽给出的 KLD 分别是:4/4 成为大卡的推荐默认,3/3 是 0.001 nats,3/2 是 0.0024 nats。他另外算了一笔账——3/2 相对 3/3 多出来的 KLD,比从 4 XL 量化降到 4 S 量化带来的落差还小 8。
被测权重是 swift-1.5-uncensored 与 mirai 的 2.5bpw 融合出来的 2.3bpw 版本。作者在 3060、3080、3080 Ti 上跑了七轮 LiveCodeBench,保留 BF16 成绩的 85%;3080 与 3080 Ti 加上 MTP 后评测阶段约 65 到 70 tok/s 8。
他在同一段里把话说死:这份权重有损;个人体感落在 Qwen3.5 与 Qwen3.6 的 BF16 之间;用 Hermes 跑了几天、过了编码评测与 pi 测试,标准 agent 任务够用 8。仓库与权重合集分别在 GitHub 与 Hugging Face,MIT 许可 9。
Loading content card…
只练一套题,换来什么、让出什么
TwIL-LM3-Pro 是一个 3.66B 的模型,建在 IBM 的 granite-4.2-3b 上,后训练只干一件事:一阶逻辑翻译、蕴含判断、语义解析、Lean 形式化与证明批评 11。
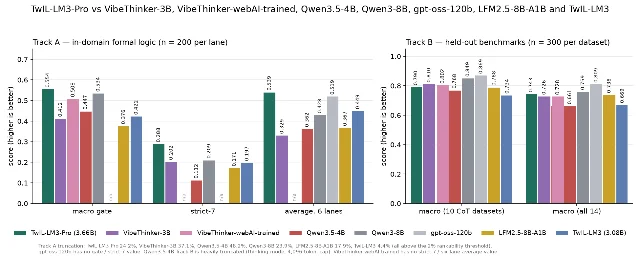
它换回来的分写在模型卡第一段:同一套题、同一批抽样行下,形式逻辑那套的 macro gate 从底座的 0.4313 升到 0.5539,严格七项从 0.1821 升到 0.2879。严格多选题这一栏是 0.4100,排在第二的是 0.1700 11。
让出的那一栏它也印了出来。通用那套 10 个数据集的 macro 是 0.7901,比自己的底座低 0.0041;14 个数据集是 0.7425,比底座高 0.0093 11。
那 0.0093 全部来自 BBH-logic 一行(0.9540 对 0.6107)。把这一行拿掉,剩下 13 个数据集平均是 0.7263,比 VibeThinker-3B 的 0.7350 低 11。
对 Qwen3-8B 那一栏,模型卡自己写了读法:gate 上领先的 0.020 小于每栏 200 题时的采样噪声,所以只算平手。严格七项上的 0.2879 对 0.2093 不含宽松匹配,差距站得住 11。
代价在长度上。形式逻辑那套平均生成 1,902 个 token,24.2% 撞上长度上限,换算成每秒完成的答案只有 11.1 个,而 TwIL-LM3 是 28.1 11。模型卡还标出了几处被截断污染的格子,包括 rudas_ood 的 0.0437——那一栏 93.7% 的生成撞了上限 11。
能带走的一条是这套流程搬得动:同一套后训练配方用在五个底座上,用在 VibeThinker-3B 上把它的 macro gate 从 0.374 提到 0.508,代价是它的通用 10 集 macro 从 0.815 掉到 0.802 11。Q4_K_M 的 GGUF 是 2.09GiB,CPU 或 4GB 显存就能跑,许可证为非商用 10。
4bit 对 8bit:快 81%,质量那一栏分不出
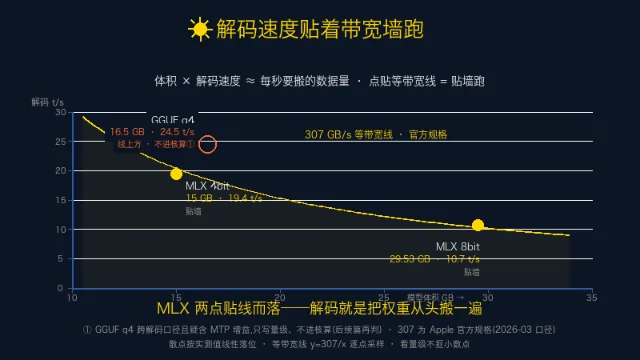
一篇分八篇发的实测里,第三篇把同一台 Mac mini 上的同一份 27B 拆成三档:MLX 4bit(15GB)、MLX 8bit(29.53GB),再加一条 GGUF q4_K_M(16.5GB)做跨格式参照 3。
档间倍率只在 MLX 这一线内算:解码 19.4 对 10.7 tok/s,4bit 快 81%。预填充的差距随输入变长收窄,0.4K 档快 22%、3K 档 10%、11.7K 档 9% 3。
作者把原因算成了两个乘积:19.4 乘 15GB 约 291 GB/s,10.7 乘 29.53GB 约 316 GB/s,两个数都贴住 M5 Pro 名义 307 GB/s 的内存带宽。体积翻倍、速度近乎减半,是这条墙的直接推论 3。
质量那一栏用的是一道 LRU 加 TTL 缓存的编程题,双轨判分:模型自己写用例自己跑,脚本再预埋六个考点暗测。自测是 4bit 23/24、8bit 31/31,暗测两档都是 6/6 3。
作者没有把 6/6 读成「量化档质量无差」,他写下的边界是:这道题的分辨力到此为止。8bit 的完成用时约 1012 秒、4bit 约 645 秒,方向与解码差一致、幅度小一些 3。
顺带一条工具层的发现:qwen3.8 在 LM Studio 里关不掉思考段,两个 API 开关都无效。给 128 或 256 个 token 的预算会被思考整段吃光,正文一个 token 都不剩;最后有效的解法是在请求里给 assistant 预填一个空的思考块 3。
同一道题跑三遍,判它失败的脚本错了
第二组国内材料换的是验收标准。一位作者给同一道题跑三遍,第一遍的输出他当场判了失败:屏幕上打印「保留 3 个,移动 3 个」,数字全对,他打开目标目录,看到的是 a1、b1、c1 三个同名文件夹 12。
他写了个脚本比对文件名,期望看到 a2、b2、c2,实际看到 a1、b1、c1,判 FAIL。把目录逐层展开之后才看清:被搬走的正是 a2、b2、c2,模型给每个保留文件建了一个同名子目录,把重复文件放了进去,而题面里写着「保持可追溯」 12。
他给这一处写的判词是本次最值钱的一句:把错的代码用起来危险,把对的答案丢掉一样危险。两次的错误方向相反,根子是同一个——验收标准与自己真正想要的东西没有对齐 12。
第二个变量是权重来源。同一个目录里两份权重摆在一起,量化档名一样、都叫 IQ3_XXS,体积是 12.67GB 与 14.29GB。他原先一直以为手上那份就是官方版 12。
把量化档固定住之后,变量只剩「权重是谁的」。同档 Q4_K_M、显存占用都在 13.3 到 13.6GB:社区版出语法错、数学 2/3、89 tok/s;官方版通过、数学 3/3、29 tok/s。官方权重的 IQ3_XXS 是 38 到 39 tok/s,三遍全过 12。
社区版错在哪儿也点到行了。一次 try 块没写完就接上 except;一次把
stat.S_ISLNK(mode) 写成 os.stat(...).S_ISLNK;中国剩余定理那道题第一步的模运算就错了,推出 N≡69(mod 77)(69 除以 7 余 6、除以 11 余 3),最终答 200,正确答案是 346 12。还有一处换到了网页上量:同一个「机房设备巡检台账」的前端,同一台机器、同一个 375 像素视口,社区版页面被撑到 543 宽、溢出 183 像素,官方版是 360、零溢出。社区版那条提示条的实测尺寸是 0×0,它被塞进了一个平时不显示的容器 12。
那份针对社区版的验收报告写着 62 项断言、56 项通过、6 项失败,失败全部来自上面这两处。作者的结论是这次选正确率:官方版权重的 IQ3_XXS 是 38 到 39 tok/s,比他原先那份慢一半还多,这个换算他认 12。
同一份 9/9,三个端点差 120 倍的钱
最后一组把「分数一样就没得比」这句话翻了过来。一篇国产旗舰横评引的第三方测试用 9 个可执行的 Python 任务跑同一个 MiMo-V2.6 的三个端点,三个端点全部 9/9 13。
分数一样,能比的只剩钱和时间:Flash 每千任务 0.04 美元、5 秒,Pro 0.29 美元、9.5 秒,Pro-UltraSpeed 4.80 美元、2.5 秒。UltraSpeed 比 Pro 贵 16.6 倍,换来的是 7 秒 13。
这篇文章里另一处「换掉一个东西再看一遍」发生在尺子上。Artificial Analysis 把智能指数重基到 v4.3.2,锚点从「人类专家等于 1000」换成「DeepSeek V4.1 Flash 等于 1600」,145 个模型的分数跟着变、128 个下降,官方没有给换算系数 13。
重基之后的三个数是这样:MiMo-V2.6-Pro 智能 46 分、每任务 0.13 美元、47 tok/s;GLM-5.3 智能 45 分、75 tok/s、每任务 2.01 美元;DeepSeek V4.1-Flash 智能 39 分、222 tok/s、每任务 0.27 美元。三家各占一角,没有一家三项全赢 13。
模态那一栏是最容易推翻「预算够就上 Pro」的地方:DeepSeek 与智谱的旗舰 Pro 都是纯文本,能看图和视频的反而是更便宜的 Flash。三家里只有小米把全模态做成了 Pro 级标配 13。
还有一处官方公告与实际状态对不上。DeepSeek 9 月 10 日公告称 9 月 14 日 12:00 之后
deepseek-v4-pro 的请求全部路由到 V4.1-Flash;文章引的 10 月 6 日第三方抓取显示,v4-pro 仍以每百万输入 0.66 美元、输出 1.98 美元独立在售,并发上限 500。文章给读者的动作很实在:发一个 v4-pro 请求,看返回体里的模型字段和自己的账单 13。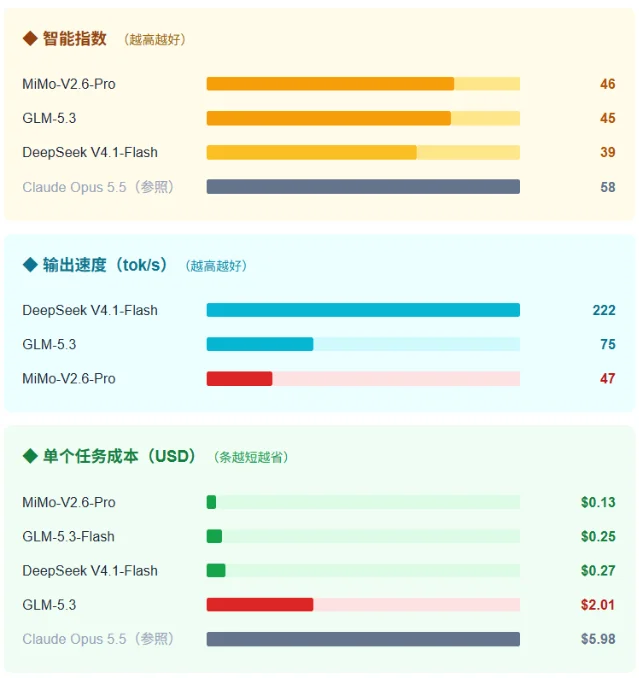
顺带看到的几条
llama-server 有一个未授权远程内存破坏漏洞:CVE-2026-107183,出在 common_chat_peg_mapper::map 里,往 POST /completion 塞一个构造过的 chat_parser 就能触发 use-after-free 加 double free。受影响的是 b8227 到 b11393 之间的构建,b11393 起已修;CNA 给的 CVSS-B 是 9.2 15。X 上一位作者贴了单张 V100 跑 Strata 的读数,模型是 Qwen3.8-Flash-Next 的 IQ3_S,两档下 Code 62.0 对 62.7、Logic 53.5 对 59.0、Prose 52.3 对 56.0、Japanese 59.7 对 57.4。预填充在 5.9K 时约 985 tok/s、23K 时约 1,356 16;另一位账号在同一串里补了一句,两张 V100 走 OCuLink 也能跑起来 17。
同一片平台上的反例是 Ryzen AI Max+ 395 那台。一位日本作者在 Windows 上把 Strata 跑起来了,4bit 量化的 Qwen3.8-Flash-Next 性能「还凑合」,但启动很慢,显存占用大得连休眠模式都不正常了。他的建议是把它当服务器用的专用机 18。
决策模型这一侧多了一条主干上的路。vLLM 合并了
/v1/systemone 支持,同一个接口从此不用再靠各家自己写的转发 19。H2O.ai 放出的 H2O-Lightning-4B 是 Apache-2.0 权重、基于 Qwen3.5-4B,在 JevBench v1.6.1 的开源权重榜上综合 72.5,参考位的 Jev 是 71.5;它跑在没改过的 vLLM 0.30.0 加一段标准库脚本上,H100 上每次决策约 29 毫秒 20。
它给的路由表比榜首更实用:3,474 道留出题上,置信度阈值取 0.8 时升级掉 37.7%、其余准确率 95.8%、自信答错的占 2.6%;阈值取 0.9 时是 53.1%、98.5% 与 0.7% 20。
国内这三条在本次截图与检索里只读到标题与首行,先把地址记下。一位作者的 Codex 能力榜每天更新,10 月 10 日这一版写着第一名 GPT-6 Sol LOW 100.0、第二名 GPT-6 Astra XHIGH 80.8 21。
另一个账号说把 753B 的旗舰模型装进了四台书桌大小的主机、没走 API 22——753B 这组参数与本期那篇横评里 GLM-5.3 的总参对得上。还有一条是 Qwen-Image-2.1 的 Turbo 版,去噪步数从 40 步砍到 8 步 23。
今天能带走的三句话
第二句,那个变量的斜率未必朝你想的方向走。草稿从 3 个减到 2 个更快,48K 上下文比 40K 慢 22%,3/2 位的 KV 缓存相对 3/3 多出来的 KLD 比从 4 XL 换到 4 S 量化带来的落差还小 78。
第三句,把你的验收标准也当成被测对象。同一道题三遍只过一遍,一半要记在权重来源上,另一半要记在一个自己没说出口的标准上 12。
留一个今天就能做的核对项:把你手上那个本地模型文件的体积报出来。同一个量化档名在不同来源那里能差出 1.6GB,这个数比名字更能说明你手上是哪一份 12。
References
- 1
- 2
- 3公众号 羲和实验室:Mac mini 跑 Qwen3.8 27B,4bit 与 8bit 差多少
mp.weixin.qq.com
- 4GitHub:jesdga95/basalt\
github.com
- 5Reddit:PolyStrata,Strata 再加四个 MoE 模型\
reddit.com
- 6GitHub:VecSzn/PolyStrata\
github.com
- 7Hugging Face:Qwen3.8-27B-Uncensored-Heretic-MTP-UD-GGUF\
huggingface.co
- 8
- 9GitHub:JakeATX/llamAmpere\
github.com
- 10
- 11Hugging Face:webAI-Official/TwIL-LM3-Pro\
huggingface.co
- 12公众号 比特荒漠:用本地模型跑了同一道题做 3 遍\
mp.weixin.qq.com
- 13公众号 AI科技深度:2026 国产旗舰大模型横评\
mp.weixin.qq.com
- 14
- 15NVD:CVE-2026-107183
nvd.nist.gov
- 16
- 17
- 18
- 19Reddit:vLLM 合并 /v1/systemone 支持
reddit.com
- 20Hugging Face:h2oai/h2o-lightning-4b
huggingface.co
- 21小红书 纪伯伦:Codex 模型能力排行榜 10.10
xiaohongshu.com
- 22小红书 喵闻周报AI打工记:753B 装进四台桌面主机
xiaohongshu.com
- 23小红书 跑通为止:8GB 显卡跑 Qwen-Image-2.1 Turbo 踩坑
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.