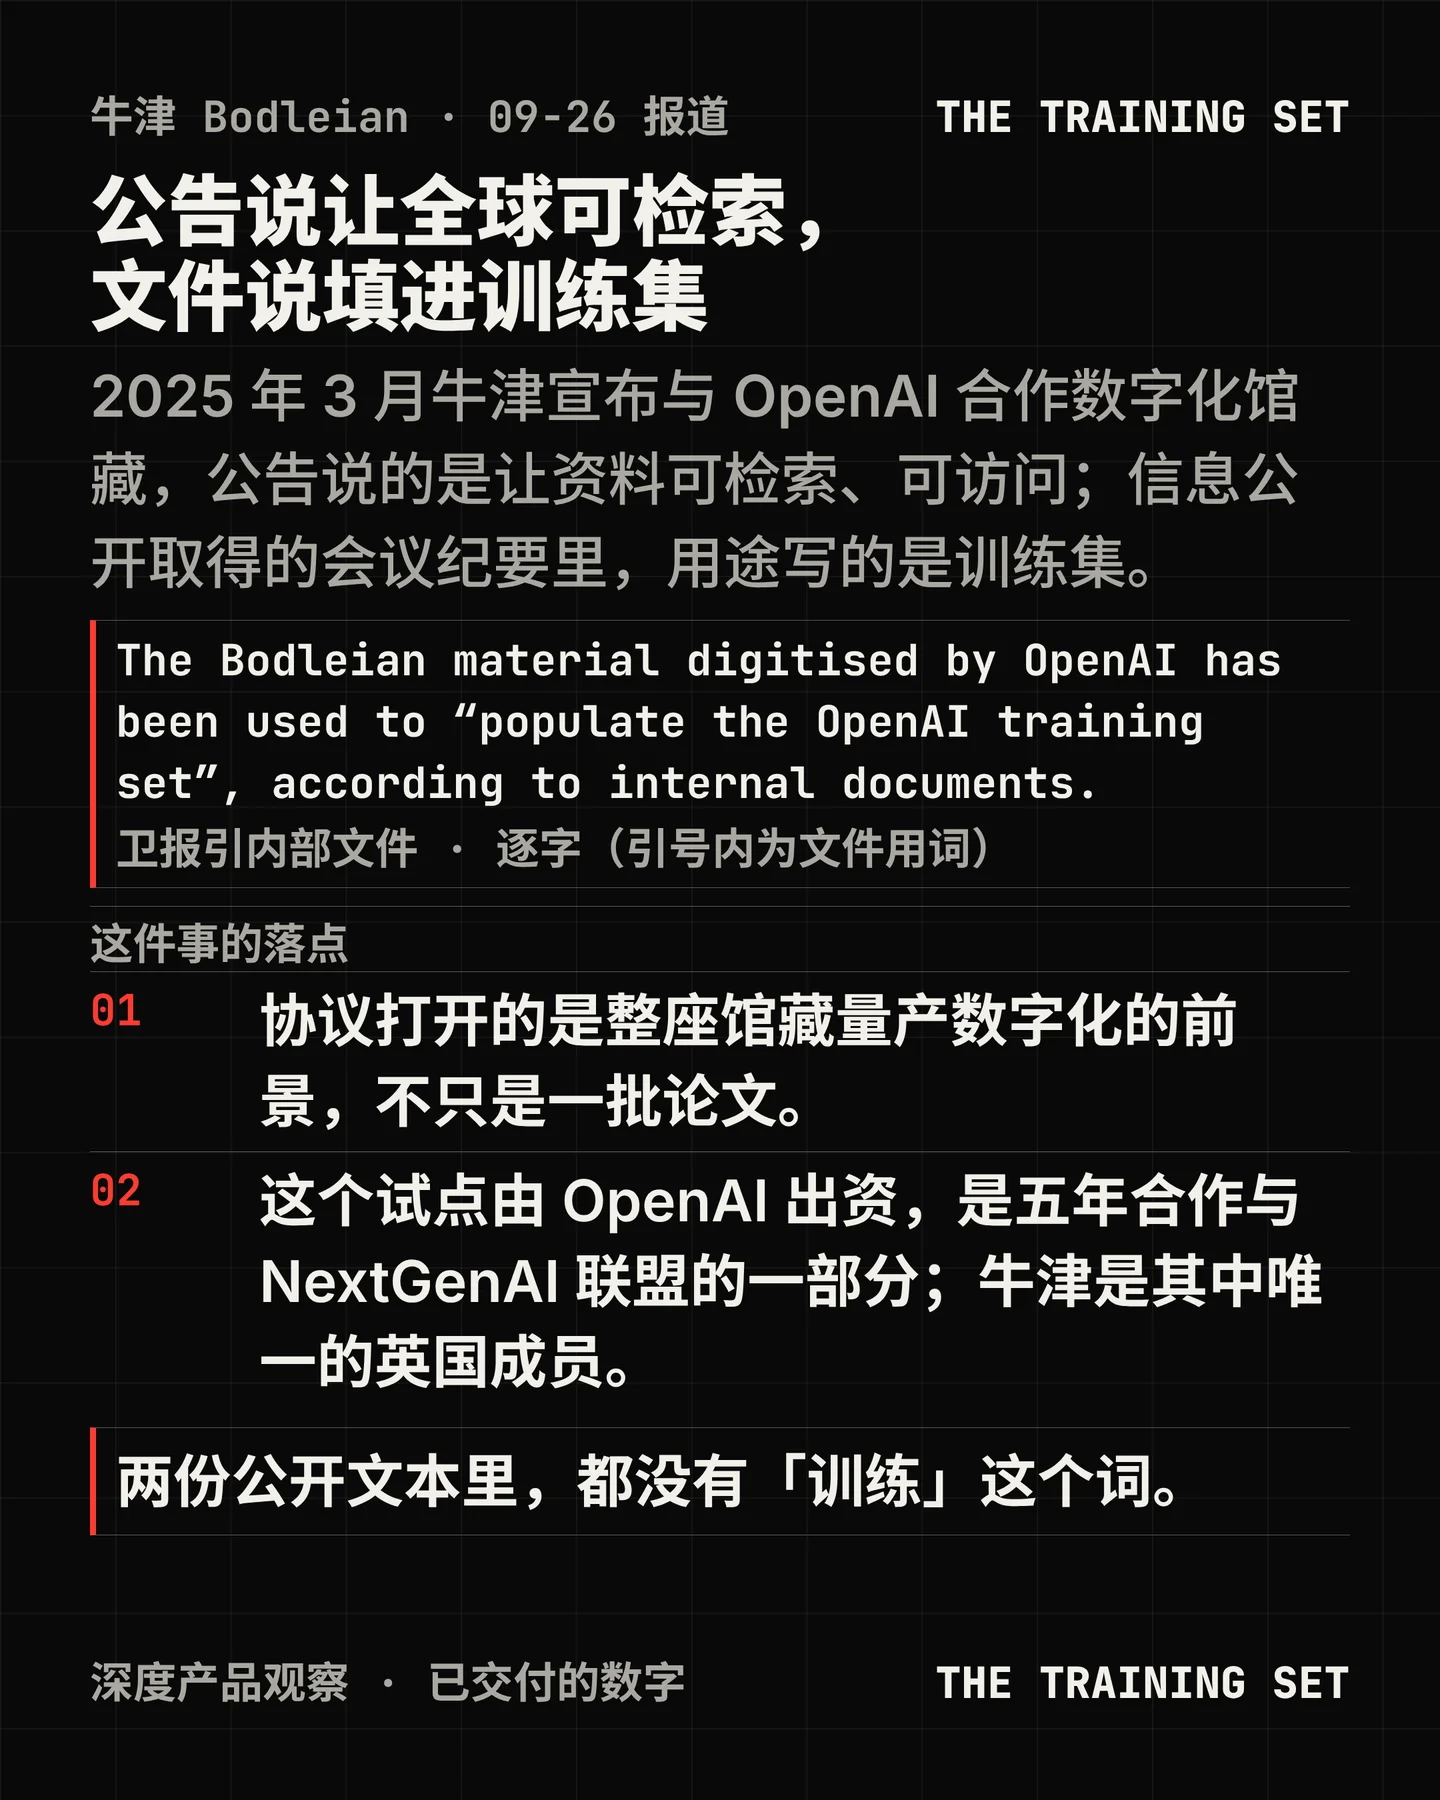

一份信息公开取得的会议纪要,说出了一个公告没有写的用途。
落差在两句话之间。 9 月 26 日,卫报报道牛津大学允许 OpenAI 用博德利图书馆的历史文献训练模型,依据是内部文件:The Bodleian material digitised by OpenAI has been used to “populate the OpenAI training set”1。同一篇报道里,牛津 2025 年 3 月宣布这项合作时的公告,说的是另一件事。
两份公告的用词可以逐字对。 牛津 2025 年 3 月 4 日的公告写:The collections which have previously been unavailable online, will become searchable and accessible for students and researchers worldwide——此前无法在线上获取的馆藏,将变得可被全球的学生与研究者检索和访问2。OpenAI 同日的 NextGenAI 发布稿写,博德利「is digitizing rare texts and using OpenAI’s API to transcribe them, making centuries-old knowledge newly searchable by scholars worldwide」3。两份公告讲的是同一个动作(数字化)和同一个好处(可检索、可访问),两份公告里都没有出现 train、training、training data 这类词。
已经交出去的那部分是有数字的。 卫报写,截至 2025 年 6 月,125,000 张历史学位论文扫描件已从博德利馆藏交给 OpenAI,其中包括 19 至 20 世纪欧美大学的博士论文;另一批是 10,000 件 16 世纪的 broadside ballads,上面有歌词和乐谱;牛津 2025 年 3 月的公告把试点范围写成 3,500 份 1498 至 1884 年的全球学位论文12。还有一批材料只出现在会议纪要的讨论里,没有对应的交出记录:18 世纪爱尔兰公文、小说家 Edgeworth 的私人书信(卫报写作 Marie Edgeworth,通行的名字是 Maria Edgeworth)、Dorothy Hodgkin 的青霉素笔记,以及一个叫「Ask the Bod」的聊天机器人1。这个试点由 OpenAI 出资,属于双方五年合作与 NextGenAI 联盟的一部分,它的启动时间是 2025 年 2 月4;牛津是这个联盟里唯一的英国成员,美方成员包括波士顿公共图书馆、Caltech、MIT 与密歇根大学3。
权利和条件是分开写的。 牛津发言人对卫报说的这几句可以逐字核:规模是 modest in scale、只覆盖 out of copyright 的材料、OpenAI 的使用不是独家的;博德利保留自行公开这批数字化材料的权利,并将在「未来几个月内」开始公开上线1。发行方那一侧,OpenAI 发言人只说公司「proud」,理由是让今天的模型把世界的历史知识留给未来1。会议纪要记下的员工顾虑则是声誉风险,以及这份涉及高能耗技术的协议与大学环境承诺的关系1。
这份协议站在一条正在被划出来的边界上。 边界的一侧是公共领域。微软副总法律顾问 Burton Davis 对美联社解释过为什么先从这一侧入手:「It is a prudent decision to start with public domain data because that’s less controversial right now than content that’s still under copyright.」5 波士顿公共图书馆数字与在线服务的 Jessica Chapel 讲的是同一件事的另一面:「OpenAI had this interest in massive amounts of training data. We have an interest in massive amounts of digital objects.」5 边界的另一侧在收紧:2024 年 9 月 4 日,美国第二巡回上诉法院在 Hachette 诉 Internet Archive 案中判定,把仍在版权期内的印刷书整本扫描并全文在线分发不构成合理使用,判决写的是 we conclude the answer is no. We therefore AFFIRM6;而 2015 年第二巡回在 Google Books 案里认定,为检索功能制作整本数字副本属于转换性使用,商业动机不构成否定理由7。Anthropic 在版权诉讼中的 15 亿美元和解已于 2026 年 7 月 20 日获得终审批准8,那条界线划在「怎么拿到这些书」,而不是「拿它们做了什么」。
同一条落差还出现在别的地方。 卫报这篇报道提到,书商报过一批冷门书的集中订单;Anthropic 花数千万美元买书、切掉书脊扫描后化浆,它说自己不买也不毁掉珍本;404 Media 把追踪器放进二手书订单里,跟到美国一处亚马逊设施1。Oxford 这份协议里,博德利的馆藏保持完整1。同样是把纸上内容变成可检索的文本,处置方式分成两种:一种把馆藏留在原处、只授权使用扫描件,另一种让载体消失、只把内容抽走。
能核到什么程度,也要写清楚。 卫报没有写信息公开申请由谁提出、向谁提出,也没有给内档的文件名、日期与撰写人;这些原件目前不可公开取到,所以「populate the OpenAI training set」这句话现在只有卫报的转述这一个来源1。馆藏规模还有一处口径不一致:卫报写 23m items,博德利自己的项目页写 approximately 14 million printed items,并另外提到 23 座馆舍14。报道发出后,到本文写作时没有第二家媒体自采跟进,可见的只有授权转载与编译;牛津与 OpenAI 也都没有另外发布声明。
落点是几栏可以在签字之前写住的字。 用途那一栏先写:这批材料进不进模型训练,公告里写不写。权利那一栏写清楚:扫描件归谁,机构能不能自己再开放。时间那一栏写到具体日期,而不是「数月内」。边界那一栏回答一个问题:这些材料是公共领域,还是仍在版权期内。这四栏填完,一份机构数据协议才算把用途交代清楚——博德利这批扫描件的用途栏,现在还是空的。
References
- 1
- 2
- 3
- 4Bodleian Digitisation Research project · Bodleian Libraries
bodleian.ox.ac.uk
- 5
- 6
- 7
- 8Anthropic Copyright Settlement
anthropiccopyrightsettlement.com
Comments