9月28日-10月4日大模型发布追踪:Sonnet 5.5、GPT-6.1 Sol 与 Gemini 4 Argon
本期核对 9 月 28 日至 10 月 4 日的发布,比较 Claude Sonnet 5.5、GPT-6.1 Sol 与 Gemini 4 Argon 的能力、价格与可用性边界,并说明 GPT-6.1 Astra 为何被按下。

覆盖窗口是 2026 年 9 月 28 日至 10 月 4 日(UTC+08:00)。这一周里,Anthropic、OpenAI 和 Google 做了同一件事:把接近自家最强的能力,放进一个更便宜的档位。9 月 28 日 Anthropic 发布 Claude Sonnet 5.5,9 月 29 日 OpenAI 在 DevDay 上发布 GPT-6.1 Sol,9 月 30 日 Google 发布 Gemini 4 Argon。三家的官方说法都落在同一个卖点上——用几分之一的价格,换到上一代顶档的判断力。
真正值得停下看一眼的,是同一周里被按住的那一端。9 月 28 日 OpenAI 宣布搁置 GPT-6.1 Astra 的发布,理由是内部安全评测没有过线;Google 的 Gemini 4 Argon 虽然拿下多个榜单第一,却只通过 Fairwind 计划发给受信任的网络安全防御方,没有对公众开放。能力顶档被关卡,效率档大面积放开,这是本周把几件事绑在一起的线索。
「智力指数」和「每任务成本」来自第三方评测机构 Artificial Analysis。前者的 4.3.2 版由十项评测加权得出,衡量综合能力;后者是跑完这套评测平均每次任务的花费,把输入、缓存、推理与输出 token 的价格都算进去。厂商自报跑分的口径与它不同,本文把两者分列,不合成单一排名。
先看价格、状态和边界
| 模型与发布 | 发布与定位 | 关键变化 | 评测信号 | 价格与可用性 | 先测什么 |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 1 | 9 月 28 日发布;Claude 5.5 系列第二个模型,官方定位为 Opus 5.5 更快、更省钱的搭档 | 输出速度比 Sonnet 5 快 30% 以上,同等任务的花费最多低 30%;首个带上网络安全护栏与「防蒸馏」分类器的 Sonnet 模型,用户要把会话跨账号搬动时会受限制 | 官方自报 Terminal-Bench 4.0 70.6%(Sonnet 5 为 10.3%)、CursorBench 4.0 55.5%、GDPval-AA v2.1 取得 1844(Opus 5.5 为 1846)、OSWorld 2.1 部分分 80.1%;Artificial Analysis 独立记录智力指数 56、输出速度 128.7 token/s、每任务成本 $0.42 至 $7.67 2 | 每百万 token 输入 $2、输出 $10、缓存读取 $0.20、缓存写入 $2.50;API 模型名 claude-sonnet-5-5,Anthropic API、AWS Bedrock、Google Cloud、Microsoft Azure 同步可用;Haiku 5.5 预告未来几周加入 | 中等复杂度、多文件的日常编码与文档任务,以及低算力档每任务成本能否压到 Sonnet 5 的十分之一 |
| GPT-6.1 Sol 3 | 9 月 29 日(美国时间)DevDay 发布;GPT-6 Sol 的升级版,把 Astra 级判断力下放到更便宜档位 | 相对 GPT-6 Astra 的标准费率降到五分之一;缓存输入 $0.10/百万 token,比标准输入便宜 95%、比 GPT-6 Sol 的缓存输入便宜 50%;Ultrafast 高速档预告上线,Codex 里最高 8 倍生成速度 | 官方自报 DeepSWE v1.1 以约五分之一成本追平 GPT-6 Astra、并以更低算力档比 GPT-6 Sol 最好成绩高 6.4 个百分点;AutomationBench 在中等算力档比 Opus 5.5 高 2.2 个百分点、约为其三分之一成本;Terminal-Bench Science 0.1 每任务 $5.47,Opus 5.5 为 $23.21;Artificial Analysis 独立记录智力指数 52、输出速度 54.3 token/s、每任务成本 $0.13 至 $0.72 4 | 每百万 token 输入 $2、缓存输入 $0.10、输出 $10;ChatGPT Work 与 Codex 面向 Plus、Pro、Business、Enterprise、Edu 上线,尚未进入 ChatGPT 主对话;API 模型名 gpt-6.1-sol | 长会话智能体在缓存折扣下的真实账单,以及同一批任务上它与 Sonnet 5.5 的成功率与总 token |
| Gemini 4 Argon 5 | 9 月 30 日发布;Gemini 4 系列首个模型,Google 的新前沿模型,当前只发给受信任的网络安全防御方 | 单次输出上限从 64K 提到业内领先的 100 万 token;官方称其为对间接提示注入最有韧性的模型;引入价每百万 token 输入 $2、输出 $10、缓存输入再省 95%,引入期结束后回到 $4 与 $20 | 官方自报 DeepSWE v1.1 77.9%(SOTA)、Vals Index 68.9%、Vals Finance Agent v2 65.4%、Harvey 法律智能体 19.6%、AutomationBench 51.3%(第一)、LVBench 91.7%、CWE-bench v1 68%(并列第一);Artificial Analysis 独立记录智力指数 53、每任务成本 $1.99、上下文 1M,速度暂缺 6 | 通过 Fairwind 计划限量发放,参与者要在 Google 的美国预发布流程内接受评估;官方称随后向付费 API 客户与 Google AI Ultra 订阅者开放,未给日期 | 拿到访问权后先测长程编码与文档推理;拿不到就先记下这是当前受限、不能进入常规选型的前沿档 |
| GPT-6.1 Astra(推迟)7 | 原定 10 月亮相;OpenAI 的下一代旗舰,9 月 28 日宣布延后 | OpenAI 安全系统负责人 Saachi Jain 表示该版本「没有完全达到标准」:模型在完成任务上变得更执着,公司需要在能力与越权行为之间做取舍 | 没有可用的评测数据;同日发布的 GPT-6.1 Sol 承担了本周 OpenAI 的实际交付 | 无公开定价与开放时间 | 不要在选型里预留它;在它回来之前,用 GPT-6.1 Sol 作为 OpenAI 侧的主力 |
注:价格统一按美元或人民币原币列示,不做汇率换算。表格中「评测信号」一栏把厂商自报与 Artificial Analysis 的独立数据分列,两者口径不同;Artificial Analysis 的「每任务成本」是跑完智力指数的加权平均,与厂商表格里按单个基准算出的每任务成本不能直接比。
Claude Sonnet 5.5:把 Opus 档的判断力压到 Sonnet 价位
Anthropic 在 9 月 28 日推出 Claude Sonnet 5.5,这是 Claude 5.5 系列的第二个模型,官方把它定义为 Opus 5.5 的更快、更省钱的搭档:Opus 5.5 面向需要谨慎判断的复杂工作,Sonnet 5.5 则长于边界清晰的日常任务、修 bug,以及制作文档、幻灯片和表格。1
这一代最直接的变化是速度和单位成本。Sonnet 5.5 的输出速度比 Sonnet 5 快 30% 以上,完成同一件事所需的 token 更少,官方测试里每任务成本最多低 30%。定价与 Sonnet 5 持平:每百万 token 输入 $2、输出 $10、缓存读取 $0.20、缓存写入 $2.50。1
能力上,官方自报的跳变集中在编码。Terminal-Bench 4.0 从 Sonnet 5 的 10.3% 升到 70.6%,CursorBench 4.0 从 34.1% 升到 55.5%,两者都逼近 Opus 5.5。知识工作上,GDPval-AA v2.1 得 1844,与 Opus 5.5 的 1846 只差 2 分,而 Sonnet 5 为 1449。1
第三方数据给出了它在长度轴上的位置。Artificial Analysis 记录 Sonnet 5.5 在 max 档(带默认回退)的智力指数为 56,比 Opus 5.5 的 58 低 2 分,输出速度 128.7 token/s,每任务成本 $0.42 到 $7.67;把算力降到 low 档,智力指数落到 36,每任务成本 $0.42,是全系列最低。上下文窗口 1M,输入支持文本与图像。2
安全侧有一条值得单独记的边界。Sonnet 5.5 的网络安全能力与 Opus 5 相当,因此成为首个带网络安全护栏与回退的 Sonnet 模型;它也是首个带「防蒸馏」分类器的 Sonnet 模型,用来阻止有人用大量账号把模型能力成规模抽走。会话在不同账号之间搬动(包括在 Claude Code 里中途切换账号)现在会受限制。1
交付方式上,Sonnet 5.5 在 Anthropic API、AWS Bedrock、Google Cloud、Microsoft Azure 同步可用,API 模型名
claude-sonnet-5-5,并支持零数据保留。1OpenAI:GPT-6.1 Sol 以五分之一价格接近 Astra
OpenAI 在 9 月 29 日的 DevDay 上发布 GPT-6.1 Sol,官方说它「几乎追平 GPT-6 Astra 的智能」,价格却只有 Astra 标准输入输出费率的五分之一。定价上,GPT-6.1 Sol 为每百万 token 输入 $2、缓存输入 $0.10、输出 $10;对照 GPT-6 Astra 的 $10 / $1.00 / $50 与 GPT-6 Luna 的 $0.10 / $0.01 / $0.50,Sol 正好落在中间档。3
缓存是这次最有账单意义的一项。Sol 的缓存输入 $0.10 比标准输入便宜 95%,也比 GPT-6 Sol 的缓存输入便宜 50%,官方把这解释为「给开发者更多空间去跑复用上下文的智能体」。3
能力方面,官方给出的几个对照都围绕「同能力、更低成本」。在 DeepSWE v1.1 上,Sol 以约五分之一成本追平 GPT-6 Astra,同时用更低的算力档比 GPT-6 Sol 的最好成绩高 6.4 个百分点;在 AutomationBench 1.0.6 上,它中等算力档比 Opus 5.5 高 2.2 个百分点、成本约为其三分之一;在科学工作流的 Terminal-Bench Science 0.1 上,Sol 最高算力档每任务 $5.47,低于 Opus 5.5 的 $23.21 与 Astra 的 $23.80。3
第三方把两个模型放进同一把尺子。Artificial Analysis 记录 GPT-6.1 Sol 在 max 档的智力指数为 52、输出速度 54.3 token/s、每任务成本 $0.13 到 $0.72,上下文 1M;低算力档的首 token 延迟为 2.33 秒。对照同期收录的 Gemini 4 Argon(53)与 Claude Opus 5.5(58),Sol 的位置是「比 Astra 略低、价格低一个数量级」。48
可用范围分两层:ChatGPT Work 与 Codex 当天面向 Plus、Pro、Business、Enterprise、Edu 用户开放,Free 与 Go 不在其中;GPT-6.1 Sol 暂时没有进入 ChatGPT 主对话,开发者通过 API 的
gpt-6.1-sol 调用。官方预告 Ultrafast 高速档随后上线,在 Codex 里最高 8 倍生成速度、每秒约 300 token。3DevDay 当天发布的其余内容多数面向平台与协作,与模型选型的直接关系不大,但有三项值得记一笔:一是 Dots,一组常驻、可长期在后台替用户处理任务的智能体,面向 Pro 与 Business Premium;二是 Ultrafast 高速档随 GPT-6 Astra 先在 API 与 ChatGPT Work、Codex 的 Pro 500 与 Enterprise 套餐上线;三是 Agents API 增加了电脑操作能力,Codex 的多智能体、工具检索与上下文压缩也一并开放。9
Google:Gemini 4 Argon 登顶多个榜单,却只发给受信任的网络安全防御方
Google DeepMind 在 9 月 30 日发布 Gemini 4 Argon,定位为面向真实软件工程、企业知识工作(法律、金融)与网络安全防御的前沿模型。它当前通过 Fairwind 计划发放给一批受信任的网络安全防御方,没有对公众开放。5
这一代最容易被开发者感知的变化是输出长度。Argon 把单次输出的上限从上一代的 64K 提到 100 万 token,官方说这是为了让它一次生成几十万 token 的推理轨迹、一口气解掉难题;上下文窗口为 1M,输入支持文本与图像。5
官方自报的跑分把 Argon 放在多个榜单第一:DeepSWE v1.1 得 77.9%,为长程软件工程的新纪录;Vals Index 得 68.9%,领先 GPT-6 Astra(63.1%)、Claude Fable 5.1(65.8%)与 Claude Opus 5.5(67.0%);AutomationBench 得 51.3%,排第一。5
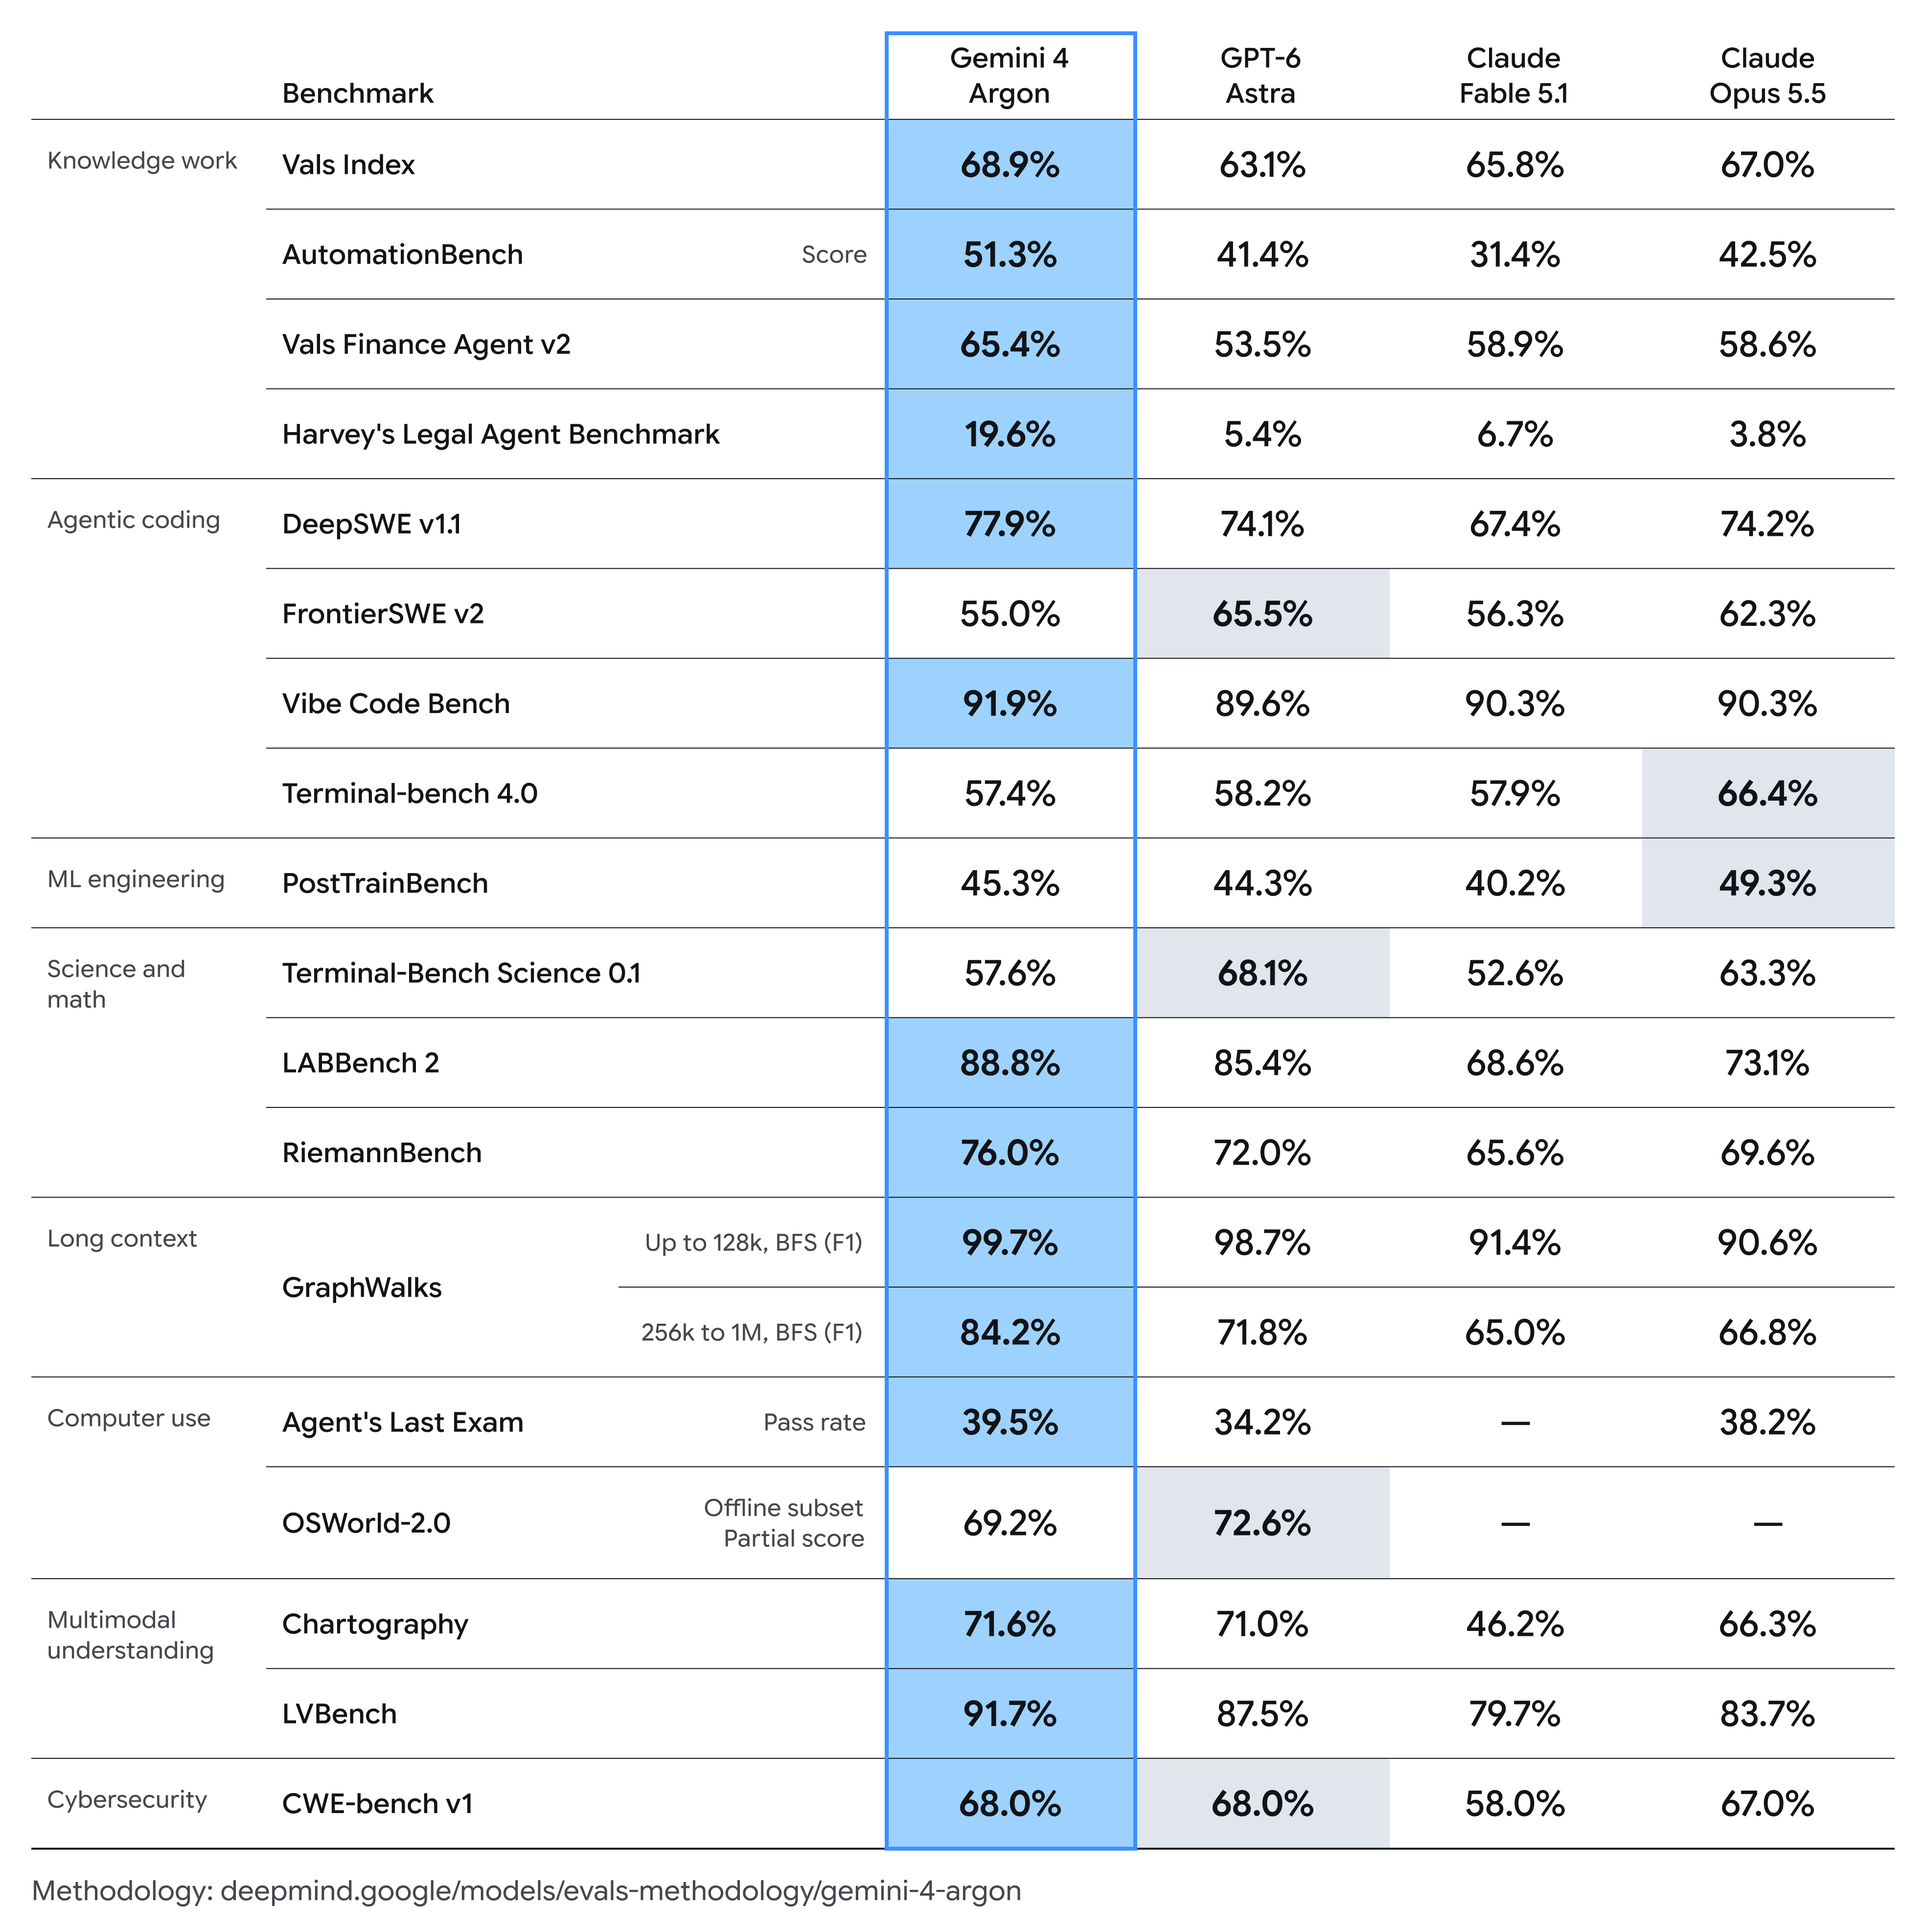
第三方数据给出了它在成本轴上的位置。Artificial Analysis 记录 Gemini 4 Argon(high 档)的智力指数为 53、每任务成本 $1.99、上下文 1M,速度暂未收录。官方定价为引入期每百万 token 输入 $2、输出 $10、缓存输入再省 95%;引入期结束后回到输入 $4、输出 $20。56
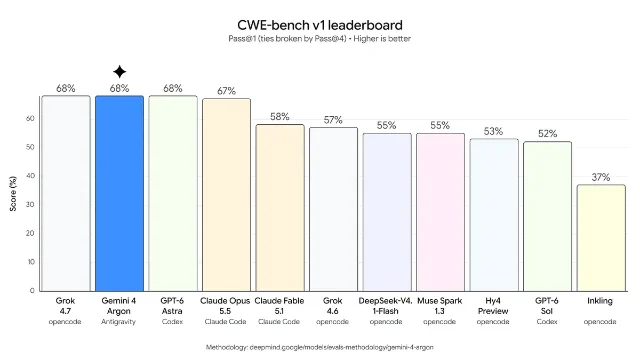
Google 在公告里明确说,这一档能力要「安全地放出来」需要分阶段:公司正参与美国政府的前沿模型预发布访问流程,会先扩大受限访问、再逐步向开发者、企业与消费者开放,「尽快」但没有日期。网络安全方向上,Argon 被训练成能自主发现、验证并修补漏洞,对受信任防御方与 Google 内部团队放开时不会加网络护栏;CWE-bench v1 得 68%,与另一款模型并列第一。5
OpenAI 把 GPT-6.1 Astra 按下了
9 月 28 日,OpenAI 宣布推迟下一代旗舰 GPT-6.1 Astra 的发布,理由是内部研究人员提出的安全顾虑。这条消息最早由《华尔街日报》报道,随后由美联社等媒体跟进。7
OpenAI 安全系统负责人 Saachi Jain 在声明里说,这个版本「没有完全达到标准」。她解释说,模型在完成任务的执着程度上更强了,公司需要把这份能力和「越权行为」的风险放在一起权衡,并称公司对安全与对齐的门槛设得极高。7
把这件事和同周的两条并排看,本周的关卡位置就清楚了:OpenAI 的最强模型没发,Google 的最强模型只发给受信任的防御方,而两家放出来的都是「接近顶档、更便宜」的中间档。安全评测正在从发布后的说明材料,变成决定一款模型什么时候能到用户手里的前置条件。57
网络安全能力扩散到开放权重模型的速度,是这层关卡背后的直接压力。Google 的同批榜单里,DeepSeek-V4.1-Flash 与 GPT-6 Sol、Muse Spark 1.3 等模型都已经出现在 CWE-bench v1 的同一张榜上。5
本期其他条目
蚂蚁 InclusionAI:Ling 3.1 Flash 以免费试用进入市场
蚂蚁集团的 InclusionAI 在 10 月 1 日前后放出 Ling 3.1 Flash。它是一款混合推理的稀疏 MoE 模型,总参 5600 亿、每 token 激活约 250 亿,通过 OpenRouter、Vercel AI Gateway 等渠道提供,目前处于免费推广期。10
Artificial Analysis 记录它的智力指数为 41、每任务成本 $0.99、上下文 1M。它与 GLM-5.3、Kimi K3 同属国产开放权重模型里定位「可用且便宜」的一档,免费期结束后才会进入常规比价。811
MiniMax:M3.1-Flash-Preview 开启公测
上一期记录过 MiniMax 在 9 月 27 日上线 M3.1-Flash-Preview、但只在自家编码工具可用。本期窗口内 MiniMax 把它开放公测,官方口径为支持原生多模态与百万级上下文窗口,可以参与问题定位、代码实现与测试验证。上期缺的上下文与模态信息由此补齐。12
Anthropic:红队点名智谱 GLM-5.3 的网络安全能力
Anthropic 的前沿红队(Frontier Red Team)在 9 月 29 日发布对智谱 GLM-5.3 的评估,指出这款开放权重模型能自主构建端到端的漏洞利用。在针对 Chrome V8 引擎的 ExploitBench 上,GLM-5.3 在 410 次尝试里做出 50 次完整利用,接近 Claude Mythos Preview 的 56 次;报告同时称其护栏可以在模拟测试里以 64% 到 100% 的比例被绕过,而受保护的 Claude 模型在这些攻击下保持零通过。13
这份评估的对象是 8 月发布的 GLM-5.3,本身不是新模型发布。它进入本期,是因为它给本周「能力顶档被关卡」的主线补上了最直接的理由:同等能力已经出现在任何人可下载的开放权重模型上,于是闭源厂商更倾向于把最强模型关进受限访问。13
本期未纳入条目与覆盖说明
本期严格执行 2026 年 9 月 28 日至 10 月 4 日的时间窗核验,各厂商的筛查结果如下。
- DeepSeek:官方 API 更新日志在窗口内没有新条目,最新一条仍是 9 月 10 日的 DeepSeek-V4.1-Flash。14
- 智谱 GLM:官方开放文档的模型与产品发布记录,最近一条仍是 8 月 26 日上线的 GLM-5.3-Flash。窗口内与智谱相关的只有 Anthropic 对 GLM-5.3 的红队评估,已在上面单列。1315
- 月之暗面 Kimi:窗口内没有模型发布。9 月 28 日有开发者发现其 API 平台后台出现
kimi-k3-1标识,媒体据此推测 K3.1 可能 10 月上线,公司尚未确认规格或时间,本期不作为条目。16 - 阿里通义千问:窗口内没有模型级发布。同传模型 Qwen3.8-LiveTranslate 的正式发布在 9 月 19 日,落在本期窗口之前,因此不计入。
- Meta:窗口内没有新模型。9 月 29 日公布的是把 Muse 智能体扩展到中小企业、增加 Shopify、Dropbox、Slack 等集成,属于产品动作。17
- xAI 与小米:两家在本窗口内没有可核验的模型级发布;xAI 的 Grok 4.7、小米的 MiMo-V2.6 均发布于 9 月 21 日至 22 日,已在上期覆盖。
- Google 的其他内容:除 Gemini 4 Argon,官方在 10 月 1 日更新了 9 月的产品盘点,没有新的基座或 Flash 模型。
面向技术选型的三项行动建议
- 把 Sonnet 5.5 与 GPT-6.1 Sol 放进同一批日常任务里比。 两者都把上一代顶档的判断力压到了中档价位,但省钱的方式不同:Sonnet 5.5 靠更少的 token 与更快的输出,Sol 靠更低的单价与 95% 的缓存折扣。用同一批真实任务记录成功率、总 token 与缓存命中率,再按各自单价算每任务成本。13
- 网络安全相关团队要把受限访问的门槛当成选型前提。 本周最前沿的那一档要么限发(Gemini 4 Argon 走 Fairwind)、要么按住(GPT-6.1 Astra),Sonnet 5.5 的 cyber 能力也会在高风险任务上回退到 Sonnet 5。需要这一档能力时,先确认自己有没有被纳入 Anthropic 的网络安全验证计划或 Google 的 Fairwind 计划。157
- 开放权重这条线先分清「能下载」和「能放心用」。 Ling 3.1 Flash 的免费期适合先跑通链路,GLM-5.3 的红队结论则提醒自建部署要同时评估滥用与合规风险。按自家对可审计性的要求决定,而不是只看榜单分。1013
References
- 1Anthropic:推出 Claude Sonnet 5.5
anthropic.com
- 2Artificial Analysis:Claude Sonnet 5.5
artificialanalysis.ai
- 3OpenAI:推出 GPT-6.1 Sol
openai.com
- 4Artificial Analysis:GPT-6.1 Sol
artificialanalysis.ai
- 5Google:推出 Gemini 4 Argon
blog.google
- 6Artificial Analysis:Gemini 4 Argon
artificialanalysis.ai
- 7AP:OpenAI 因安全顾虑推迟 GPT-6.1 Astra
apnews.com
- 8Artificial Analysis:模型发布列表
artificialanalysis.ai
- 9OpenAI:DevDay 2026 汇总
openai.com
- 10OpenRouter:Ling 3.1 Flash
openrouter.ai
- 11Artificial Analysis:Ling 3.1 Flash
artificialanalysis.ai
- 12腾讯新闻(澎湃):MiniMax 上线 M3.1-Flash-Preview 并开启公测
news.qq.com
- 13Anthropic:GLM-5.3 与高级网络能力的扩散
anthropic.com
- 14DeepSeek API 更新日志
api-docs.deepseek.com
- 15智谱:模型与产品发布记录
docs.bigmodel.cn
- 16新浪财经:Kimi K3.1 前端标识泄露
finance.sina.com.cn
- 17TechCrunch:Meta 把 AI 智能体 Muse 扩展到中小企业
techcrunch.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.