PenShot:把剧本拆成 5 秒分镜的那一层,一致性承诺只兑现了一半
今天拆的是 PenShot(story-shot-agent):一个把任意格式剧本切成 5 秒级镜头、并写出可直接喂给 Sora / Veo / Runway 的提示词包的 MIT 项目;文章给全它在链条上的位置、三条上手路径、八处已知阻塞,以及项目自己的源码考证里那些还没接线的一致性机制。

PenShot 是一个 Python 项目,仓库名 neopen/story-shot-agent,MIT 许可,LICENSE 上的版权署名是「Copyright (c) 2025 HiPeng (Peng)」,2025 年 10 月 23 日建仓。1 到 2026 年 9 月 26 日,仓库有 204 star、38 fork、594 次提交、15 个分支、17 个 tag 与 17 个 release;最新一版 v0.3.8 发布于 2026 年 9 月 19 日,同一天 PyPI 上的 penshot 也更新到 0.3.8。234它做的事一句话说得完:把一整段剧本切成若干不超过 5 秒的片段,为每一段写下可以直接喂给 Sora、Veo、Runway、可灵这些模型的提示词——画面描述中英各一份,另附负面词、片长、目标模型与一组音频提示词。5 它不生成视频,也不剪片;它交付的是提示词包,是你把素材交出去之前的那一步。
前十一期交到读者手里的东西,分别是一块渲染底座、一只浏览器里的剪辑器、一台本机工作台、一份剪映工程、一个驱动 Google Flow 的接口。这一期站在它们全部的上游:在还没有任何素材的时候,先决定每一段该长什么样。
它在链条上站在哪一层
链条从上游往下游数是这样的:剧本与分镜的规划层 → 生成接口层 → 工程与时间线层 → 渲染底座。67 PenShot 在最上游那一层,它的下游是 gflow-cli、Comfy MCP 那种真正去调模型、出素材的东西,再往下才是 capcut-cli、Nomi 与 DaVinci Resolve MCP 这类处理工程与时间线的方案。89
这个位置决定了它交回来什么。你给它一段文字,它回来一份 JSON:
fragments 数组里每个片段带 prompt(英文描述加中文描述各一段)、negative_prompt、duration、model、style,还有一个 audio 对象,写着音频提示词、目标音频模型、音色描述、情绪、语速与声道参数。5 成品视频不在里面,时间线也不在里面——这些字段是给下一个环节的输入。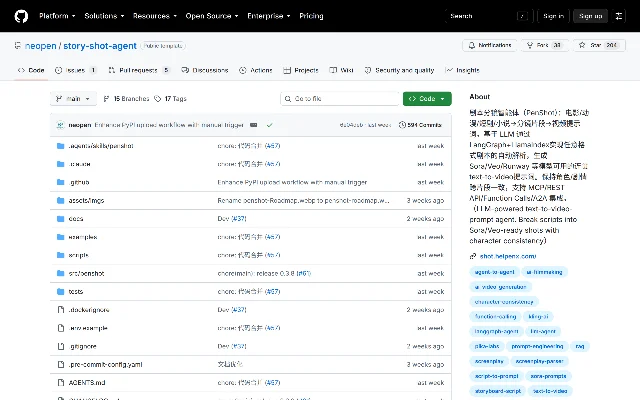
Enhance PyPI upload workflow with manual trigger(接口记录的时间是 2026-09-19);文件列表里能看到 src/penshot、tests、examples、docs、scripts,以及一个 .agents/skills/penshot 目录。2同一层还有别的形态,差在哪要看你缺的是哪一段。video-shotcraft 走的是另一条路:157 张镜头配方卡装进编码 Agent,让它把一份产品卖点排成宣传片,考的是镜头语言的固定套路;10 PenShot 处理的是叙事剧本——电影、短剧、动漫、小说都能塞进去,它要解决的是「一个两分钟的故事,怎么切成模型吃得下的十几段,还不让角色换脸」。5 这条差别不是功能清单上的差别,而是你手上的输入是广告文案还是故事。
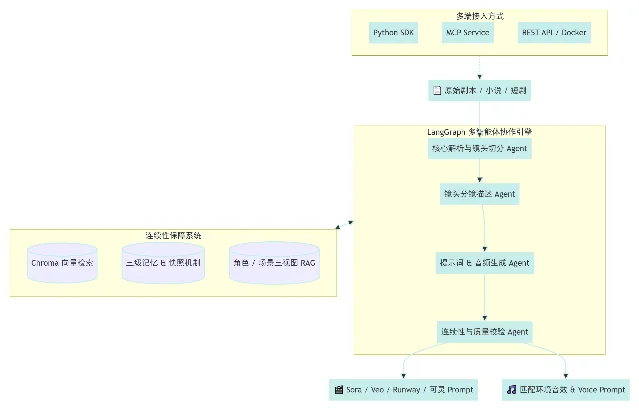
assets/imgs/penshot-uml-cn.webp(2026-09-26 从仓库取回):上方是三类接入方式(Python SDK、MCP Service、REST API / Docker),中间是 LangGraph 多智能体协作引擎,下方输出 Sora / Veo / Runway / 可灵提示词与环境音效、人声提示词;左侧那块「连续性保障系统」里并排写着 Chroma 向量检索、三级记忆与快照机制、角色 / 场景三视图 RAG——后两样今天在代码里的状态,见下一节。5它在这一层怎么做事
主链路是六个节点,项目自己的文档给出的顺序是:剧本解析 → 镜头拆分 → 视频分段 → 指令转换 → 质量审查 → 连续性守护。11
切分这一段值得单独说,因为它是整个项目的立身之本,也是它第一处需要说清的地方。视频分段器有规则与 LLM 两个实现:镜头时长不超过 5.5 秒时走规则分割,按 2.5 秒左右均分,不判断语义边界;超过阈值的镜头才交给 LLM,由提示词约束它把切点落在动作自然停顿处、对话句号或省略号之后、情绪转折处。11 一句话:短镜头省 token,长镜头保语义,这个取舍是显式的,代价也写在文档里——关掉 LLM 就便宜,但割点可能落在动作中间。
一致性靠的是「文本基线 + 模板强约束」两张牌。剧本解析阶段把每个角色的服装拆成颜色、款式、材质写进
global_metadata.character_outfits,指令转换时由固定函数拼成四段「全剧上下文」:本场景关键道具、角色服装要求、本场景地点、以及剧本级的连续性要点。12 三档提示词模板都把它定义成硬约束,其中一条原文是「参数矛盾优先采用【全剧上下文】设定」——镜头描述与全局基线打架时,以基线为准。记忆分三层:短期在 Redis 里做滑动窗口,中期用 LLM 压成摘要落盘,长期进 Chroma 向量库按剧本隔离。13最后一关是连续性守护,它的检查方式是六项词表级规则,不是视觉比对:带台词的角色有没有对应镜头、外观关键词(服装 / 发型 / 配饰)有没有变、相邻镜头场景跳变是否超过镜头数的 30%、角色动作词与持拿动词有没有换、片段
style 去重后是否超过两种、相邻片段首尾时间差是否超过 0.1 秒。12 质量审查走的是规则优先的混合路线,评分从 100 分起按违规权重扣,warning 扣 5、moderate 扣 10、major 扣 25、critical 扣 40,扣到 0 分为止;两次真实运行的记录里,同一个剧本一次拿到 5.0 分、另一次拿到 90.0 分。14
这里有一处必须摊开讲:README 承诺的一致性机制里,有一部分今天并没有接上。项目自己那份源码考证写得比任何第三方都细——三视图机制的三个环节(生成三视图、三视图库、参考图注入)在代码库里全部不存在,检索
三视图 / tri_view / turnaround / reference_image 零命中;连续性锚点的模型类 ContinuityAnchor 除定义处外无任何引用,状态快照的 take_snapshot 没有任何调用点,StateTimeline 没有工作流节点读取;RAG 那条路上,剧本知识库的 query() 收下 use_rerank 参数却不消费它,真正的重排序实现在另一条没接到主链路上的检索器里。12 也就是说,今天真正在跑的是文本基线、四段上下文注入、六项词表检查与扣分制审查这一套;参考图级别的锁形、跨片段的状态回放,属于还没通电路的部分。仓库自带的架构图里那三个圆柱体,其中一个还只是图纸。你要给什么,它交回什么
要给的东西不多,但有几样是硬条件:
- Python 3.10+。PyPI 上
penshot的requires-python写的是>=3.10,仓库徽章也是 3.10+;官网技术架构那一栏写的是 Python 3.9+,两处口径不一致,装之前按 PyPI 的来。415 - 一个对话模型的 key。OpenAI、DeepSeek、通义千问、本地 Ollama 都能接,配置里分成
LLM__DEFAULT与备用厂商两段。516 - 一个嵌入模型的 key。它和对话模型是两套配置,
.env.example默认指向 OpenAI 的嵌入接口,换成通义就把 base URL 改成 DashScope 并保留text-embedding-v4。16 - 可选的一台 Redis 与一个本地数据目录。Redis 不配也能跑,数据目录负责装任务产物、记忆文件与工作流检查点。14
它交回来的东西,按入口分四类:
- 一份提示词包:每个片段的正负向提示词、片长、目标模型、风格串与音频提示词,外加全片的
project_info(片段数、总时长)和三条执行建议(按顺序生成、保持相同种子、生成后检查衔接)。5 - 一套任务状态机:提交之后先拿到
task_id,再轮询状态,终态的字面量是success;源码里的任务状态枚举没有completed这个值,网上流传的示例常常写错。16 - 一条给编码 Agent 的工具面:MCP 服务端暴露七个工具——提交剧本的
breakdown_script,查询与管理的get_task_status、get_task_result、cancel_task、list_tasks、get_queue_status、get_stats。16 - 四种接入形态:Python SDK(
create_penshot_agent加同步 / 异步两个方法)、REST API(FastAPI 起服务,/api/v1/storyboard提交、/api/v1/status/{task_id}查状态)、可以作为独立节点嵌进 LangGraph 工作流的PenshotFunction,以及一个把整个服务包成 A2A Agent 的示例。517
有一件事容易误会:仓库里确实带了一个 Agent Skill,路径是
.agents/skills/penshot/SKILL.md,但它的描述写得很清楚——「PenShot 项目开发 Skill」,用来修改这个项目自己的 Agent、工作流、记忆、配置、REST、MCP 与测试,不是给外部 Agent 用来调用分镜功能的。18 要让 Agent 用它,走的是上面那七个 MCP 工具。最短的上手路径与花费
本机 pip 这条路最短。 装包、配
.env、三行代码就够了,下面两段命令与代码取自仓库 README5:pip install penshot
cp .env.example .env # 填 PENSHOT_LLM__DEFAULT__* 与 PENSHOT_EMBED__DEFAULT__*,Redis 可选from penshot.api import create_penshot_agent
agent = create_penshot_agent(max_concurrent=5)
task_id = agent.breakdown_script_async("早晨,一个女孩在咖啡馆读书,阳光透过窗户……")
result = await agent.wait_for_result_async(task_id)容器这条路少一步环境配置。 取
docker-compose.yml 与 .env.example 之后 docker compose up -d,应用与 Redis 一起起来;不想写 compose 文件就用 docker run,把 PENSHOT_LLM__DEFAULT__*、PENSHOT_EMBED__DEFAULT__*、PENSHOT_REDIS_URL 用 -e 注进去即可,镜像在 ghcr.io/neopen/penshot:latest,Docker Hub 上另有 neotems/penshot(截至 2026-09-26 累计拉取 2,558 次,最后更新于 2026-09-19)。519要让编码 Agent 自己调,起 MCP 服务端:
python -m penshot.mcp_server --max-concurrent 5 --queue-size 500命令行参数就是并发数与队列上限(默认分别是 10 与 1000),启动后按
initialize → tools/list → tools/call 三步走,提交剧本拿到 task_id,轮询到 success 再取结果。16验收信号:
get_task_status 能读到当前阶段与各阶段进度,get_task_result 返回 success / status / data / error / 耗时 五样;16 仓库文档里一份 13 个片段、总时长 48 秒的示例输出带 processing_time_ms 约 519 秒,另一份同样是 13 片段的记录是 88,988 毫秒,两次相差近六倍。14顺带说一句官网那个「在线体验」:抓下来的页面自己标着「这是一个演示接口,实际应该调用服务 API」,所以它演示不了你的剧本。15
花费分三笔,第四笔最贵的那一笔不在这个项目里。
- 对话模型的 token。以 DeepSeek 官方价目表为例,
deepseek-flash在非高峰时段输入每百万 token 0.15 美元、输出 0.6 美元,高峰时段翻倍(高峰是 UTC 周一至周五 01:00–04:00 与 06:00–10:00)。20 项目自己给的口径是:语义分块与预处理砍掉 15%–25% 的输入 token,分级审查把 LLM 审查触发压到四成以下,三层记忆把单次调用的上下文从可能的上万 token 压到两千以内,提示词模板复用省下 50%–70% 的生成 token,综合下来整体省约 60%——这些数字来自项目自己的文档与实测记录,不是一个统一条件下的第三方基准。13 - 嵌入模型的 token。默认那套 DashScope
text-embedding-v4在阿里云百炼的官方计费页上是每千 token 0.0005 元。21 - 可选的机器与 Redis。文档给的 compose 配置是 2 核 CPU、2 GB 内存上限,Redis 单独一个容器;不用记忆功能可以关掉。17
- 真正的大头在提示词包的下游:把十几个片段真的生成成视频,由 Veo、Runway 这类模型按次或按秒计费,这笔钱 PenShot 不收,也不替你管。11
会卡住的地方
语义切分只在长镜头、且开着 LLM 的时候才发生
症状:短剧本切出来的片段时长整齐得像用尺子量过,割点落在动作中间,两段之间对不上。
触发条件:镜头时长不超过 5.5 秒,或者
enable_llm 关着。
现状:项目文档写得很直白——规则分割器按 2.5 秒左右均分,不判断动作与对话边界;只有超过阈值的镜头才交给 LLM 做语义分割。11
你能怎么办:要么接受规则模式的速度与零成本、把剧本写得段落分明,要么在配置里把 LLM 分割打开,让长镜头走语义路径;如果你要的是「切点必须落在动作停顿处」,那只有后一条路。时长标准有三层,落在中间地带的输出会被原样放行
症状:审查给了通过,可片段要么长过模型上限,要么总时长对不上剧本。
触发条件:片段落在告警区间里。
现状:提示词层面的建议是单段不低于 1.5 秒、总时长误差小于 0.5 秒;代码里的强校验区间是 1.0–5.0 秒;总时长偏差到 1.0 秒只告警,超过 2.0 秒才按比例缩放。三套阈值没有对齐,落在告警区间的结果不会被拦下。11
你能怎么办:把它当提示而不是保证——流水线里对每个片段的
duration 再做一次自己的校验,尤其是要喂给有硬时长限制的模型时。一次任务几分钟,同步接口会撞超时墙
症状:HTTP 客户端报超时,任务其实还在跑。
触发条件:用同步接口等结果。
现状:中等规模剧本的端到端耗时实测落在 1 分钟到 10 分钟量级,且波动明显——同为 13 片段 / 48 秒的两份记录,一次约 89 秒,一次约 519 秒;SDK 里的同步方法内部默认等 300 秒,超时返回
None,调用方要自己判空。1114 耗时的八成以上花在三段 LLM 环节上:镜头拆分、指令转换、质量审查。14
你能怎么办:一律走异步——提交拿 task_id,轮询状态,取结果;把超时值设成预期耗时的两三倍以上。MCP 的 stdio 版让客户端看不见参数名
症状:Agent 调
breakdown_script 时不传 script,或者按自己猜的参数名调用,直接失败。
触发条件:用 stdio 方式接入 Claude Desktop、Cursor 这类客户端。
现状:这个 MCP 服务端没有用官方 SDK,而是用标准库手写了 JSON-RPC over stdio 循环,只实现 initialize / tools/list / tools/call 三个方法;tools/list 返回的七个工具参数 schema 全部是空对象,客户端看不到 script、language、wait 这些键名,只能凭 description 猜。协议版本写死成 0.1.0,规范里的通知(包括 notifications/initialized)一律回 -32601。同一批工具的 HTTP 版走 /tools 路由,参数描述是完整的。16
你能怎么办:接入时把参数名写进系统提示词里约束 Agent,或者先对着 HTTP 联调版确认契约;如果客户端对协议严格校验,先按作者自己的说法实测一遍兼容性。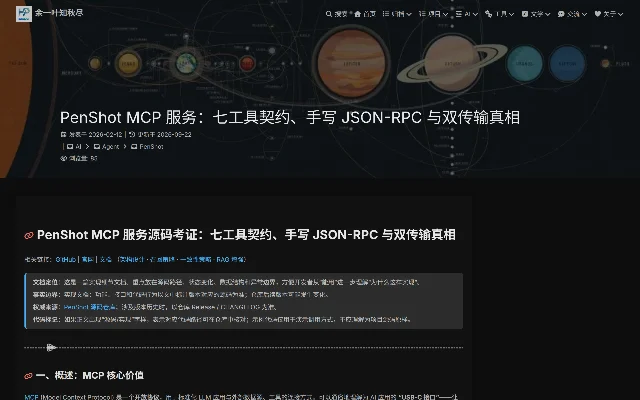
/tools 才带完整参数描述」,第三条澄清任务终态的字面量是 success、不存在 completed。16Redis 降级是静默的,多实例的记忆互相看不见
症状:任务照跑,但记忆功能实际没生效;多副本部署时各副本的记忆完全不同步。
触发条件:没配 Redis,或者连接失败。
现状:短期记忆会先探测 Redis 可用性,未配置或连不上时打印告警、降级为内存存储加文件持久化,任务不中断;14 另外,LLM 分割决策的缓存是单进程字典,多副本部署时各副本独立、命中不共享。11
你能怎么办:别只看配置里那个开关,去核对运行记录里的
redis_enabled 字段与实际连接地址;要横向扩容,先把记忆与缓存外置这件事当成前置条件。一致性里有一半机制没有接线
症状:跨片段的人物外观、道具位置仍然漂移,而且漂移之后没有东西能拦住。
触发条件:剧本里角色换装、道具换手、场景切换一多,词表级检查就会漏。
现状:项目自己的源码考证给出三分法——三视图零命中(不存在);
ContinuityAnchor、StateTimeline、GlobalConsistencyContract 有定义、无调用方;重排序有实现、没接在主链路上。今天在跑的六项检查是词表级比对,能发现「穿衬衫」变成「穿裙子」这类显性切换,对同义改述与方位错误无能为力。12
你能怎么办:把它的一致性预算定在「文本约束降低漂移概率」这一档。真需要锁形,得靠参考图或首尾帧条件生成这类下游能力,而这个仓库的边界就是提示词与指令编排。12它交到提示词为止,剩下的活在下游
症状:以为它能出片,结果拿到的是一份 JSON。
触发条件:指望口型同步、环境音融合、片段拼接由它完成。
现状:README 的注意事项写着「当前提供音频提示词,口型同步与环境音融合需下游工具配合」;「AI Video Production」在路线图里属于还没发布的阶段。5 官网那五个步骤的最后一步写着「视频生成」,架构文档与 README 都把它放在下游。1115
你能怎么办:把「出提示词」和「出片」当成两笔预算、两套工具来排;这个项目的价值在于把最繁琐、最容易出错的切分与描述那一段自动化。
部署与迁移有两处默认值要改
症状:把示例配置原样搬上生产;或者换机器之后历史任务与检查点不见了。
触发条件:直接拿 README 的
docker run 示例或 compose 文件部署。
现状:示例里 Redis 的密码是 123456,docker-compose.yml 同样写着这个默认值——本地开发无所谓,生产环境必须换成随机值并用密钥管理;517 另外,任务输出、记忆文件与工作流检查点统一落在数据目录下,而这个目录不随源码发布,容器重建时要单独备份,否则中断恢复能力静默消失。14
你能怎么办:把 Redis 密码换成环境变量或密钥,把数据目录挂成持久卷并纳入备份。许可与真实成本
代码这一层同样干净:MIT,LICENSE 原文写「Copyright (c) 2025 HiPeng (Peng)」,可以自由使用、修改、分发,保留版权声明即可。1 这份 MIT 只覆盖代码本身;你生成的提示词、以及下游模型产出的视频素材,服从你自己那些模型供应商的条款。
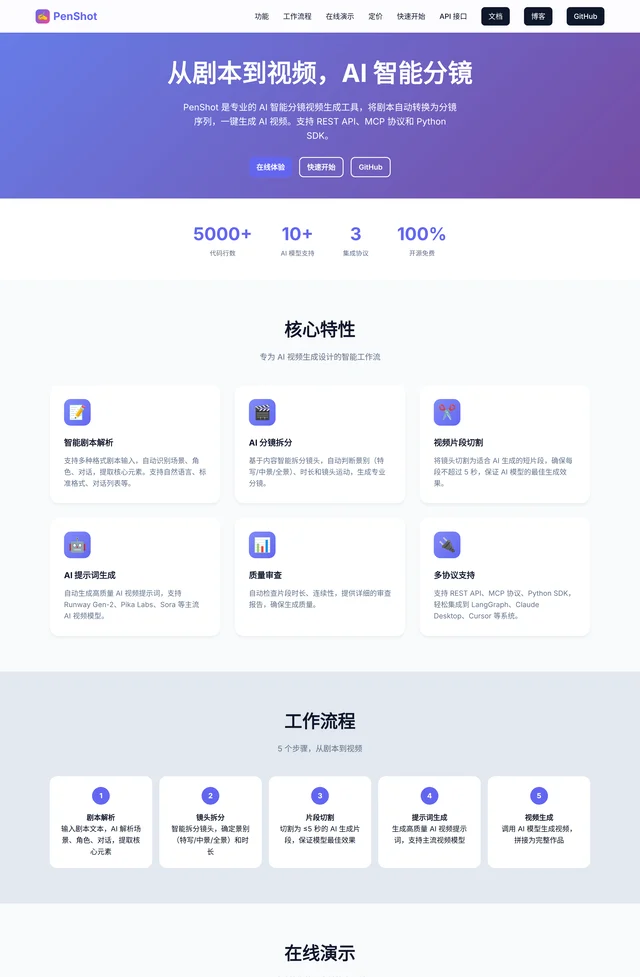
官方给的是两档:社区版免费,完整功能、本地部署、社区支持、MIT 协议;企业版标「定制」,含优先技术支持、定制开发、SLA 保障与私有化部署。15 企业版没有公开价格,要谈。
口径上的几处不一致,照实并列:
- Python 版本:官网技术架构写 Python 3.9+,README 徽章与 PyPI 都写 3.10+ /
>=3.10。415 - 步骤数:官网写 5 个步骤,其中第 5 步是「视频生成」;架构文档与 README 把视频生成放在下游,主链路是六段。1115
- 一致性能力:README 与仓库架构图并列写出三视图、快照机制、Chroma 向量检索;项目自己的源码考证逐条说明哪几样还没接线。512
还有一笔关于证据来源的账要算清楚。这个项目的公开讨论很少:594 次提交里 456 次来自作者账号,未关联账号的匿名提交 132 次,
PengLine 3 次,两个机器人各 1 次;2 issue 列表里只有一个未关闭的 issue,是作者 2026 年 9 月 18 日开的讨论帖,正文只有一句「有问题可在此处讨论」,另外 5 个未关闭的 PR 全是依赖升级机器人开的。2223 而上面那些架构、性能与成本数字,几乎全部来自项目自己的技术文档站与源码测评——它写得比多数项目的文档都细,还主动标了工程短板,但它终究是项目一方自己的核验,其中那份总测评给出的 8.5 / 10 也是这个项目给自己打的分。17 读这些数字时,把它们当作者的实测记录,而不是第三方复现。和之前几期放在一起看
| 方案 | 你给它什么 | 它给你什么 | 它在这一层 | 许可与公开体量 |
|---|---|---|---|---|
| 本期:PenShot(story-shot-agent) | 一份任意格式的剧本、一个对话模型 key 与一个嵌入模型 key,Redis 可选 | 镜头级中英双语提示词、负面词、片长与音频提示词 | 剧本到分镜的规划层 | MIT,204 star2 |
| video-shotcraft | 一份产品卖点与 157 张镜头配方卡 | 一条排好的宣传片时间线 | 镜头配方与素材资产 | Apache-2.0,9,558 star10 |
| vibeframe | Seedance / Runway / Veo / Kling 各自的 key | 一条带硬性花费上限的生成命令 | 多供应商生成路由 | MIT,170 star24 |
| descript-mcp | 一个 Descript 账号 | 改文字就是剪片的那套操作 | 官方 SaaS 的 MCP 接口 | Apache-2.0,32 star25 |
| Comfy MCP | 一个 Comfy 账号,或一台跑着 ComfyUI 的机器 | Agent 自己建图、跑渲染、批量取素材 | 生成引擎的官方接口 | AGPL-3.0-or-later 或商用许可,237 star26 |
| capcut-cli | Node 与一份本机剪映草稿库 | 一份还能继续改的工程 | 工程文件读写层 | MIT,742 star8 |
| Nomi | 一台机器与外部模型来源 | 一份本地工程:画布、分镜、时间线、MP4 | 本机工作台 | AGPL-3.0,523 star9 |
| HyperFrames | HTML 与组件代码 | 浏览器里的渲染底座 | 渲染底座 | Apache-2.0,53,073 star6 |
| hypit | 一份需求描述 | 一条从脚本到成片的流程 | 编排层 | 自订许可,15,973 star7 |
表里每个数字都是 2026 年 9 月 26 日当天重新取的。
今天该不该动手
今天就动手:你手上本来就是文字——剧本、小说、短剧大纲,你要的产物是镜头级提示词包而不是成片;5 你已经有对话模型与嵌入模型的 key,两条路可以来自不同供应商;16 你的剧本主要是中文,篇幅在中等规模以内;你打算把它接进编码 Agent 或自己的服务,需要的就是一条能跑通、能看产物、随时可以退出的实验。11
先收藏:你的剧本是英文的——README 自己写着当前针对中文剧本深度优化,其他语言仍在迭代;5 你要的一致性依赖参考图、首尾帧这类视觉锚点,而这条通道今天没有接线;12 你打算多副本部署,而记忆与分割缓存都还在进程内;14 你的 Agent 客户端对 MCP 参数 schema 严格校验,而 stdio 版交出来的是空 schema。16
跳过:你要的是成片、口型同步或音画合轨——这个项目到提示词为止;5 你要的是一个有人负责的 SLA 与托管服务——社区版没有这项,企业版要单独谈,官网那个演示接口也只是个占位;15 你连一份对话模型或嵌入模型的 key 都不打算准备——这个项目自己不带任何模型。4
不管走哪条,第一天做两件事:把
.env 里的对话模型与嵌入模型分开配好,先用一段两分钟以内的中文剧本跑一次异步任务;再拿这次运行的质量分、违规明细与连续性报告当基准,之后每次改提示词模板或换模型都跟它比一次。质量分是扣分制的终审快照,同一个剧本两次运行可以差出十几倍,不看明细只看总分一定会误判。14References
- 1LICENSE · story-shot-agent
github.com
- 2neopen/story-shot-agent
github.com
- 3Releases · story-shot-agent
github.com
- 4penshot · PyPI
pypi.org
- 5README · story-shot-agent
github.com
- 6heygen-com/hyperframes
github.com
- 7hypit-ai/hypit
github.com
- 8renezander030/capcut-cli
github.com
- 9aqm857886159/Nomi
github.com
- 10Vincentwei1021/video-shotcraft
github.com
- 11架构文档 · PenShot
pengline.cn
- 12一致性文档 · PenShot
pengline.cn
- 13成本文档 · PenShot
pengline.cn
- 14性能评测 · PenShot
pengline.cn
- 15PenShot 官网
shot.helpenx.com
- 16MCP 文档 · PenShot
pengline.cn
- 1730 维度测评 · PenShot
pengline.cn
- 18SKILL.md · story-shot-agent
github.com
- 19neotems/penshot · Docker Hub
hub.docker.com
- 20Models & Pricing · DeepSeek
api-docs.deepseek.com
- 21知识库计费说明 · 阿里云百炼
help.aliyun.com
- 22issue #58 · story-shot-agent
github.com
- 23Issues · story-shot-agent
github.com
- 24vericontext/vibeframe\
github.com
- 25descriptinc/descript-mcp\
github.com
- 26Comfy-Org/comfy-mcp\
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.