7B、2K、原生透明图层:Qwen-Image-2.1 把生成和编辑合进一个模型,许可证只放开研究和评估
解读 Qwen 2026 年 9 月 20 日开源的 Qwen-Image-2.1:7B 的视觉生成模块把文生图、图像编辑与原生透明输出合进一个模型,官方榜总分 60.28,而许可证只允许研究和评估。

2026 年 9 月 20 日,阿里 Qwen 团队把 Qwen-Image-2.1 的权重开放了出来。官方给它的定位是把文生图和图像编辑收进同一个模型:视觉生成那部分 7B 参数、32 层单流 DiT,可以直接输出带透明通道的 RGBA 图,一次编辑最多接入 10 张参考图,默认出图 2048×204812。
权重仓比发布日早几天建好。HuggingFace 上这个仓库的创建时间是 2026 年 9 月 14 日,9 月 20 日又更新过一次;两个配套的提示词重写模型建仓于北京时间 9 月 20 日 16 点 45 分和 16 点 46 分345。发布当天,diffusers、ComfyUI、vLLM-Omni、SGLang 和 LightX2V 都挂上了当天可用的支持2。
挂在标题上的两个数字是 7B 和 60.28 分。这批材料里,架构和规格是最实的一层,效率与总分是最虚的一层,而最容易被标题带过去的那一条写在许可协议第一页。
7B 说的是三块里的一块
官方把这次的改进列成四条,第一条叫「紧凑高效」,写的是视觉生成部分由 32 层单流 DiT 组成、7B 参数1。权重仓里的配置文件和这句话对得上:
num_layers 是 32,注意力头 32 个、每个头 128 维,输入输出通道都是 646。这 7B 覆盖的是三块里的一块。整套推理还要加载一个 Qwen3-VL 8B 的文本编码器(36 层、hidden size 4096,配一个 27 层的视觉塔)和一个 64 通道的 RGBA VAE,VAE 在空间上把图像压缩 16 倍27。要本地跑,磁盘和显存得按这两份权重一起算。调度器用的是 Flow Matching 的 Euler 离散版本,带动态 shifting8。
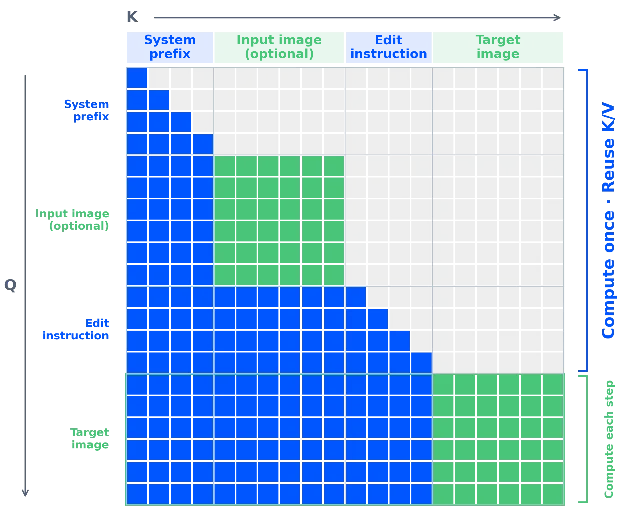
效率这一项,官方给的机制是混合粒度注意力:系统前缀、输入图和编辑指令走 token 级因果掩码,目标图像走块内双向、块间因果的掩码12。前缀只在第一步算一次,之后每个去噪步直接复用,官方示意图把这条分界标成 Compute once · Reuse KV 与 Compute each step1。参考图越多、指令越长,能省掉的重复计算越多。
省了多少,材料里没有数字。博客和仓库都没有给出推理时延、显存占用或单张图的成本,「效率」目前只有这套机制说明12。规格上可核的是默认 40 步去噪、默认 2048×2048、官方推荐七种宽高比,最大到 2752×1536 和反向的 1536×27522。
透明成了输出格式,抠图少走一遍
2025 年 12 月,Qwen 发过一个专门做分层与透明的模型 Qwen-Image-Layered9。2.1 把这个能力并了进来,输出普通图还是带 alpha 通道的图,由提示词决定1。官方给出的写法是一句模板:
This is an RGBA image with transparency. <主体描述>. The image has alpha channel and the background is transparent.2三段能力是连着的。第一段是从文字直接生成透明素材,官方示例里有一排贴纸风格的图;第二段是对透明图层继续编辑,比如换掉主体的表情,或者把图层里的文字从 BLOOM 改成 Qwen-Image;第三段是把一张普通 RGB 照片里的主体抠出来,输出成带透明的 RGBA 图层1。第三段落进设计流程,省掉的是「先生成一张图、再找工具抠、再清一遍边缘」这三步。
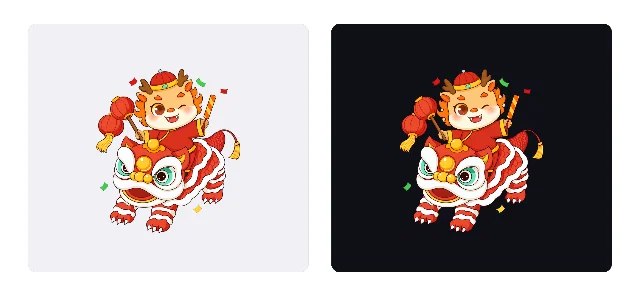
边界也在示例里:官方挑出来的都是干净的单个主体和分层素材,毛发、半透明材质、复杂阴影这些容易出问题的情形没有示例1。
一次编辑接十张参考图,三种方式指定改哪里
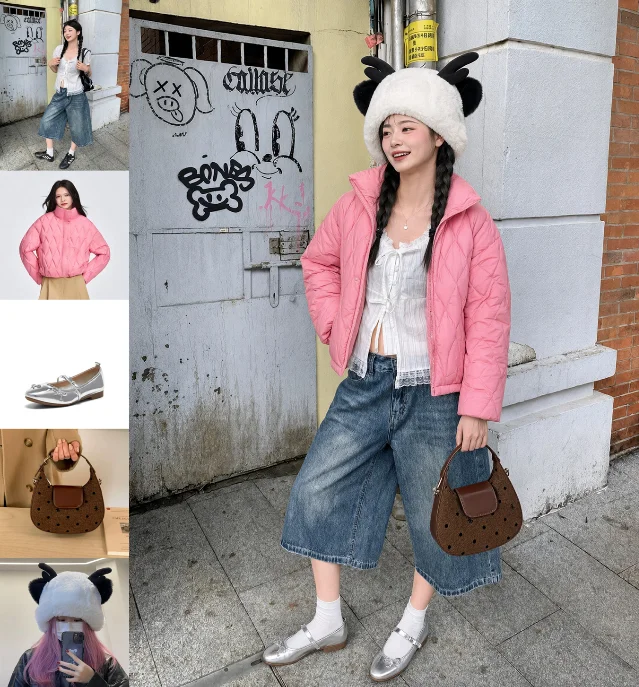
参考图的上限是 10 张。官方配了三组示例:六张单人照合成一张合影,五件单品(模特、衣服、鞋、包、帽子)合成一套穿搭,十张家具图排出房间布置1。
指定改动位置的入口有三种。用不同颜色的圈在图上标出多个区域,一句话里把三件事说全(官方例子是同时去掉蓝圈里的金属手表、把红圈里的头发改成黑色、把绿圈里的衣服换成灰色亚麻短袖);用涂画的方式标出区域;把原图和一张单独的 mask 作为两个输入,这样原图不会被标注挡住1。
官方另外强调了两处保真:人像的身份在多次编辑之间保持一致,商品的文字、纹理和形状尽量不动1。往外的延伸任务包括从自拍生成全景、把模特照扩展成信息图、把角色三视图变成完整分镜,连续改动同一场景还能拼成一段简单动画1。
这些示例都由官方挑选,命中率和失败情形没有公布1。
60.28 分在一张只有两行的榜上
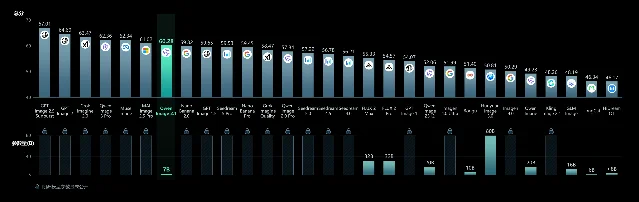
官方给的对照叫 Qwen-Image-Bench,整张图只有两行:上面一行是总分,下面一行是参数量1。总分一列,2.1 拿到 60.28,在 29 个模型里排第 7。排在它前面的是 GPT Image 2.5 Sunburst(67.01)、GPT Image 2(64.69)、Grok Imagine 2.0(63.47)、Qwen Image 3 Pro(62.36)、Muse Image 2.5 Pro(62.34)和 MAI Image 2.5 Pro(61.02)1。
参数量那一行只有 2.1 标出 7B,开放权重的模型分布在 6B 到 80B 之间:LongCat 6B,HiDream O1 约 8B,Boogu 10B,GLM Image 16B,Qwen Image 与 Qwen Image 2512 各 20B,FLUX 2 Max 与 FLUX 2 Pro 各 32B,Hunyuan Image 3.0 80B;闭源的位置只画了一个锁形图标1。
这张图能支持的判断只有一条:同门的上一代 Qwen Image 2512 是 20B、52.06 分,7B 的 2.1 比它高 8.22 分1。参数量降下来、分数升上去,这条线读到这一层。
读不出来的部分更多。整张榜只有一列总分,文字排版、人像、编辑一致性各占多少没有拆分,评测集规模、评委是人还是模型、误差区间也都没有1。这是 Qwen 自家的榜,示例也是官方自己挑的。和上一代对照还有一处缺口:2025 年 8 月的 Qwen-Image 配了技术报告,这一版还没有10。
权重开放,授权只给研究和评估
许可协议的第一页写着 Release Date: September 20, 2026,授权范围是 FOR NON-COMMERCIAL PURPOSES ONLY,协议对 Non-Commercial 的定义是 for research or evaluation purposes only11。要把这套权重放进商业用途,路径是照协议给的邮箱单独申请商用授权11。
另外两条和产品直接相关。一条是标注:用这套材料或它的输出去训练、微调、改进另一个会分发或开放的模型,要在相关产品文档里显著标出 "Built with Qwen" 或 "Improved using Qwen"11。另一条是命名:衍生产品不得把 "Qwen" 作为主名称或标识,描述性用法(例如 fine-tuned from Qwen Image)可以11。协议适用中国法律,争议由杭州的法院管辖11。
同一个系列的上几代用的是另一种许可:
| 模型 | 发布 | 参数量 | 权重许可 |
|---|---|---|---|
| Qwen-Image | 2025 年 8 月12 | 20B | Apache-2.013 |
| Qwen-Image-Edit-2511 | 2025 年 12 月12 | 20B | Apache-2.014 |
| Qwen-Image-Layered | 2025 年 12 月12 | 20B | Apache-2.015 |
| Qwen-Image-2512 | 2025 年 12 月12 | 20B | Apache-2.016 |
| Qwen-Image-2.1 | 2026 年 9 月1 | 7B 视觉生成 + 8B 文本编码器3 | 研究与评估,商用需单独授权11 |
今天能跑起来的部分
发布当天就位的工具链是这次发布里第二实的一层:
| 入口 | 形态 | 说明 |
|---|---|---|
| 权重 | 权重下载 | HuggingFace 与 ModelScope 两个站;BF16 的 7B 视觉生成模块、8B 文本编码器与 64 通道 VAE317 |
| diffusers | Python 推理管线 | QwenImage21Pipeline,发布当天合并18 |
| ComfyUI | 节点式工作流 | 原生支持,兼容权重 Comfy-Org/Qwen-Image-2.1,附文生图与图像编辑两个工作流模板219 |
| vLLM-Omni | 服务化推理 | 前缀 KV 缓存、CUDA Graph 解码、FP8 量化、张量与 Ulysses 并行220 |
| SGLang-Diffusion | 服务化推理 | 前缀缓存、Cache-DiT、CUDA graph、多种并行与组件 offload21 |
| LightX2V | 加速推理 | 面向数据中心与消费级显卡的加速框架2 |
| 提示词重写模型 | 单独的权重 | Qwen-Image-2.1-PE-T2I 与 PE-I2I,都是 Qwen3.5-VL 9B 的微调版本,代码在仓库的 prompt_rewrite/ 目录45 |
| 芯片适配 | 推理后端 | AMD Radeon 走 ROCm;FlagOS 把 Diffusers 适配到 8 个芯片平台,含 T-Head 真武与 Arm 版本,官方称各平台精度与官方实现对齐2 |
| 免费试用 | 网页 | 国内的 wuli.art 在 Chatbox 与 Canvas 里开放全部 2.1 功能,官方称包含透明背景;官方 demo 在 HuggingFace Space;ModelScope 支持在线生成与 LoRA 训练172223 |
显存不够的做法官方也写了:加载时调用
pipe.enable_model_cpu_offload() 把部分权重放到内存2。提示词重写这一环,2.1 的仓库把它列进推荐流程,做法是把短提示扩写成详细描述,并让模型顺带给出建议的宽高比2。上一代 Qwen-Image 的仓库把话说得更直白:编辑任务不做提示词重写,结果可能不稳定12。该动手的,和该等的
References
- 1
- 2QwenLM/Qwen-Image-2.1
github.com
- 3Qwen/Qwen-Image-2.1 · Hugging Face
huggingface.co
- 4Qwen/Qwen-Image-2.1-PE-T2I
huggingface.co
- 5Qwen/Qwen-Image-2.1-PE-I2I
huggingface.co
- 6transformer/config.json
huggingface.co
- 7text_encoder/config.json
huggingface.co
- 8scheduler/scheduler_config.json
huggingface.co
- 9
- 10Qwen-Image Technical Report
arxiv.org
- 11Qwen Research License Agreement
raw.githubusercontent.com
- 12QwenLM/Qwen-Image 发布记录
github.com
- 13Qwen/Qwen-Image
huggingface.co
- 14Qwen/Qwen-Image-Edit-2511
huggingface.co
- 15Qwen/Qwen-Image-Layered
huggingface.co
- 16Qwen/Qwen-Image-2512
huggingface.co
- 17Qwen/Qwen-Image-2.1 · ModelScope
modelscope.cn
- 18diffusers PR #14804
github.com
- 19ComfyUI 工作流模板(文生图)
github.com
- 20Qwen-Image-2.1 vLLM-Omni recipe
recipes.vllm.ai
- 21SGLang PR #39983
github.com
- 22wuli.art
wuli.art
- 23Qwen/Qwen-Image-2.1 · Demo
huggingface.co
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.