接上地球 AI 工具,专家级地理题从 3.3 分到 62.7 分;加一层规划,3.1 Pro 反降 3.2 分
Google 地球 AI 的 GRA 把领域工具与规划层拆成四档做对照:工具带来最大一步,规划只在愿意改道的模型上为正,分数与每题成本一并给出。

GeoExpertQueries 里有 76 道开放式的专家级地理题。其中一道要给 2022 年巴基斯坦洪水的重灾区估结构损毁,还要把「被水淹」和「变成瓦砾」分开。1
同一个 Gemini 3.8 Flash 只靠参数知识答这套题,得 0.0 分。给它搜索、地图和代码执行,3.3 分。2
接上 Google 地球 AI 的技能与工具,52.2 分。再加一层「先规划、再执行」,62.7 分。2
同一套规划层换到 Gemini 3.1 Pro 上,分数从 50.8 掉到 47.6。2
10 月 14 日,Google Research 用一篇博客公布了三件事:一份技术报告、五个合作方的试用、以及 Ask Google Earth 上的早期访问。1
技术报告 10 月 11 日提交到 arXiv,39 页、37 位作者,第一作者 Noam Slonim,Google Research 与 Google Geo 两个署名混排。2
报告的主角是 GRA,Geospatial Reasoning agent。它把一个 Gemini 接在遥感、人口动力学、天气、洪水预报、地图兴趣点、Earth Engine 与 Data Commons 后面。2
值得读的地方在对照设计:模型固定不动,只换外面两层。能力层管有没有地球 AI 的工具,编排层管要不要先规划。2
作者说,此前没有地理智能体的评测这样拆过。2
它把三件事拼在一起
第一件是技能按需加载。能力被打包成 skill,每个 skill 带一组领域工具和一份使用说明。2
模型平时只看到每个 skill 的名字与一句描述,判断这个查询要用,才把内容读进来。本次评测里 GRA 加载了 23 个技能、调用了 62 个工具。2
上一代的系统要在每次请求里声明全部工具。工具一多,模型选错的概率上升,每加一个领域,其他领域都变得更难用一点。2
技能化把「能力有多少」和「上下文占多少」分开了。加新能力不必让旧能力变笨。2
第二件是数据不进上下文。卫星栅格、行政边界、表格结果都作为 scratch dataset 放在外部工作区。2
工具之间按引用传递这些数据。模型要看就用专门的工具读,要算就在 Python 里算,行星级的数据因此不会撑爆上下文窗口。2
第三件是规划。每次查询先出一份计划,写明要取哪些数据、做哪些空间运算,然后才动工具。2
执行时把计划当路线图。工具返回的东西如果指出一条更直接的路,或者某个数据根本不存在,计划允许改道。2
计划之外还有一组行为规则。有专用数据源时不许退回网页搜索;权威的空结果当作结论,不当失败;同一个工具连续三次失败就判死路。2
本次评测全程开着 best-effort 模式:理想数据拿不到,就用最接近的代理数据顶上,并在回答里写明替代了什么、不确定在哪里。2
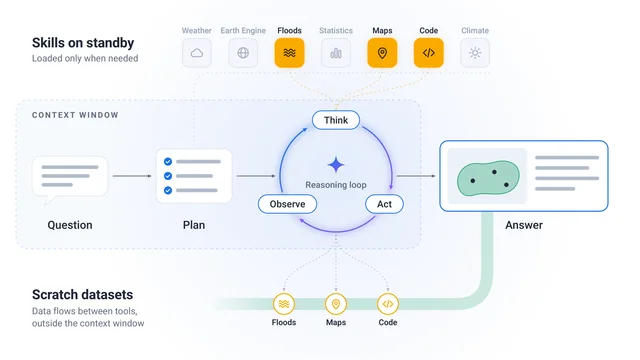
官方 Figure 2。上方灰底的技能默认待命,命中才点亮;中间是计划完成后的 Think–Observe–Act 循环;底部的洪水、地图、代码工具把数据放在上下文窗口之外按引用传递。这次评测里加载了 23 个技能、调用了 62 个工具。
一道地理题难评在哪
报告把难点归成四条。复杂地理问题很少只有一个正确答案,多条流程都可能同样合理。2
查询本身不带数据,得在大目录里自己找,工具可达性会混进分数。物理世界的真值还会漂。2
已有的地理基准多数把工具集和数据目录先钉死,让每道题有唯一答案,评分退化成「有没有调用对函数」。开放性就是这么被去掉的。2
他们的办法是四档配置。裸模型;加搜索、地图和代码执行;加地球 AI 的全部技能与工具,但仍用反应式循环;完整的 GRA。2
四档共用同一个模型,分数差因此归到能力层或编排层。2
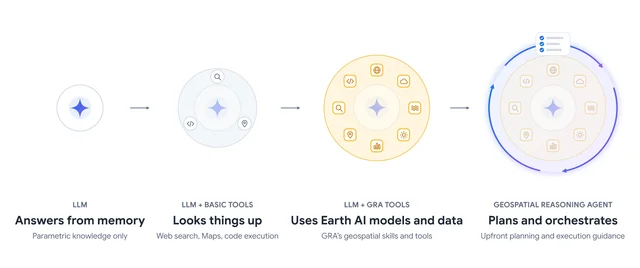
官方 Figure 3。四个圆环从左到右各加一层:通用工具、地球 AI 的技能与工具、规划与执行指导。论文的对照组就建在这四档上。
两套新基准各补一个角度。GeoExpertQueries 从从业者用例起草,132 条里筛掉数据不可得的,留 101 条。2
101 条里 25 条开发、76 条测试。测试题分四个域:危机韧性 35、公共卫生 17、选址与城市规划 20、运营 4。2
每条题由三名专家独立写 golden workflow,写的是应有的步骤、数据源与产出特征。三人彼此互盲,也看不到 GRA 的工具。2
三份流程再由程序合成一份共识版本。有 4 条题的三位专家方法不兼容,就保留多个版本,评分时对着最接近的那份算。2
GeoKTools 走另一头。92 个专家模板、24 种工具、305 条实例,其中 220 条用于测试。2
模板按需要几种工具类型系统变化,K 从 1 到 4。答案由确定性求解器算出,不经过模型判断。2
外部两套基准用来对照。CBGB 原本 45 题,这次用 44 题:删掉一道要跑数小时二分搜索的难题。2
另外改了 4 个参考答案,因为 Sentinel-2 影像重处理过,一处保护区边界也重划过。原来的答案没错,是底下的数据变了。2
UnivEARTH 是 140 道是/否题,取材于 NASA 的地球观测文章,答之前得先从 400 多个影像集合里找对数据。2
GeoExpertQueries 的分数由自动评分器给。它拿到查询、执行轨迹和共识流程,只认真正执行过的工作。2
承诺要做不算,把坐标或统计量从记忆里写死也不算。换用等价的工具、等价的数据,或者自己写 Python 完成同一步,都算数。2
同一条轨迹评三次,取均值。2
评分器本身被检验过。69 条轨迹、三名领域专家、207 条标注,专家之间的一致性系数是 0.56。2
把评分器当成第四位评分者,系数变成 0.57。它与专家均值的 Spearman 相关是 0.72。2
87% 的轨迹落在专家均值 0.33 分以内,两个方向都没有完全反转。2
这组数字的意思是:评分器能顶一个专家,帮系统排序;绝对分仍随评分器的严格程度浮动。论文自己也这么写。2
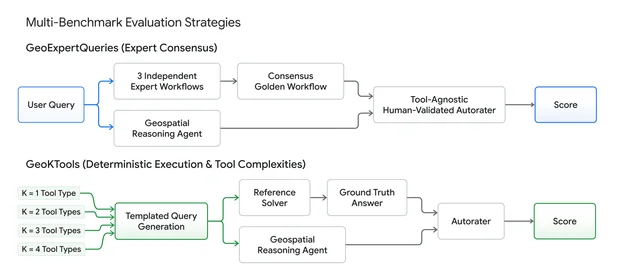
官方 Figure 1 下半部分。上面一条:查询先由三名专家写出流程,合并成共识版本,再与智能体的轨迹一起交给不依赖具体工具的自动评分器。下面一条:按工具数生成模板题,参考答案由确定性求解器算出。
四个基准上的读数
全部用 Gemini 3.8 Flash,测试集,三次运行均值。2
| 基准(测试题数) | 裸模型 | 加基础工具 | 加地球 AI 工具 | GRA |
|---|---|---|---|---|
| GeoExpertQueries(76) | 0.0 | 3.3 | 52.2 | 62.7 2 |
| GeoKTools(220) | 40.5 | 40.0 | 86.0 | 85.9 2 |
| CBGB(44) | 12.9 | 19.7 | 87.9 | 86.4 2 |
| UnivEARTH(140) | 93.6 | 98.3 | 98.8 | 98.1 2 |
三套基准上,跨得最大的一步都来自工具。GeoExpertQueries 从 3.3 到 52.2,GeoKTools 从 40.0 到 86.0。2
CBGB 同一步从 19.7 到 87.9。2
基础工具那档在 GeoExpertQueries 上有八成以上的题,三次运行全是 0 分。2
UnivEARTH 是例外。裸模型就拿到 93.6,四档全在 87 到 99 之间。题目取自 NASA 公开文章,答案能从原文读出来。2
这条基准已经饱和。2
3.1 Pro 的四档分别是 0.0 / 2.3 / 50.8 / 47.6(GeoExpertQueries),37.1 / 37.8 / 84.5 / 81.6(GeoKTools)。2
CBGB 上四档是 14.4 / 13.6 / 84.8 / 84.8,UnivEARTH 上是 86.9 / 96.7 / 97.9 / 89.5。2
在 GRA 内部,更便宜的 3.8 Flash 全面胜过 3.1 Pro。GeoExpertQueries 高 15.1 分,GeoKTools 高 4.3 分。2
CBGB 高 1.6 分,在波动内;UnivEARTH 高 8.6 分。2
规划层加的分,取决于模型肯不肯反悔
把它当成默认动作,会在这里撞上一个例外。3.8 Flash 上,加规划是 +10.5;3.1 Pro 上,同样的规划是 −3.2。2
分域看更清楚。3.8 Flash 的增益主要来自危机韧性(35 题,45.6 到 66.0)与公共卫生(17 题,42.5 到 55.6)。2
选址反而从 71.4 掉到 65.6,运营那 4 道题从 55.6 到 50.0,都落在运行间波动里。2
3.1 Pro 三个主域一处没升,选址从 57.2 掉到 48.1。2
报告给了轨迹上的解释。不加规划时,3.8 Flash 在危机域有三分之一的运行只加载了网页搜索技能。2
这些运行把「某地野火损失」当成查资料题,平均不到 10 分。加了计划,它被迫先想清楚该动哪个数据源。2
用量上看得见:每题网页搜索从 7.0 次降到 3.2 次,用到 Earth Engine 的查询比例从 38% 升到 54%。2
有确定答案的 GeoKTools 与 CBGB 上,两档差在 3 分以内,规划加不出东西。2
Pro 为什么反而掉?报告的解释是它更守规矩。计划在看不到数据时形成,猜不到后面每一步要用什么。2
Flash 需要时会偏离计划,写自定义代码、再调一次工具。Pro 更严格地按计划走,也更容易被「限制重复调用」这类规则拦住。2
专家流程里常有查询没写出来的规范步骤,比如算可开发土地之前先遮掉水体。这类步骤上,守规矩反而吃亏。2
编排层的收益因此取决于模型愿不愿意在执行时改道。报告的结论措辞是:编排要与模型匹配。2
工具越多,掉队的只有没工具的那两边
GeoKTools 的题按 K 分档,K 是每题必须用到的工具类型数,从 1 到 4。2
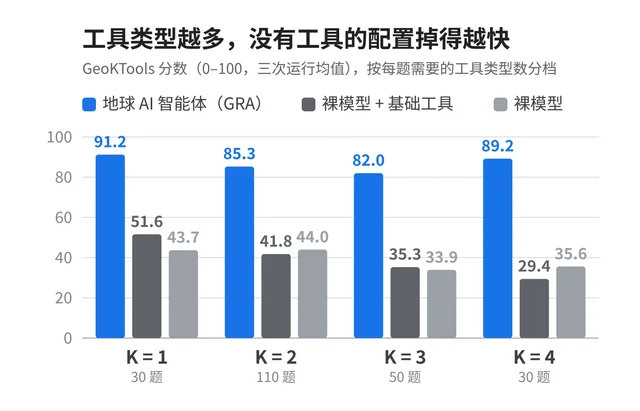
按论文 Table 6 重绘,取 Gemini 3.8 Flash 的三个配置;括号里的题数是 K=1 到 4 各自的测试题数。K 统计的是工具类型数,K=1、3、4 三档各只有 6 到 9 个模板,单格差异不宜当作趋势。
没有工具的配置随 K 往下走。K=1 与 K=2 时在 39 到 52 分之间,K=3 与 K=4 掉到 27 到 36。2
带地球 AI 工具的两档几乎不动,四个 K 档全落在 79 到 91 之间。2
裸模型在 K=1 上还能拿 43.7 分,靠的是预训练里的人口与地理常识。2
题面是「内布拉斯加离 Carhenge 最远的县,2019 年中位年龄」这类具体值。模型给近似答案,评分器按接近程度给部分分。2
K 度量的是工具类型数,与题目本身有多难只部分相关。三档各只有 6 到 9 个模板,个别模板就能挪动整格分数。2
报告据此提醒,不要跨档读趋势。2
每题多少钱
报告给了每题的模型 token 成本,只算模型调用,外部数据与算力服务不计。2
| 基准 | GRA·3.1 Pro | GRA·3.8 Flash | 基础工具·3.8 Flash |
|---|---|---|---|
| GeoExpertQueries | $0.688 | $0.199 | $0.044 2 |
| GeoKTools | $0.360 | $0.122 | $0.112 2 |
| CBGB | $0.151 | $0.093 | $0.132 2 |
| UnivEARTH | $0.271 | $0.079 | $0.010 2 |
最反直觉的一行在 CBGB。用 3.1 Pro 时,完整 GRA 每题 0.151 美元,裸模型加基础工具 0.514 美元。2
分数却是 84.8 对 13.6。基线把钱花在到不了答案的尝试上,GRA 用更直的路走到答案。2
GeoKTools 上同理,0.360 对 0.575。2
规划那 10.5 分也不贵。GeoExpertQueries 上,加规划把每题从 0.167 美元抬到 0.199 美元,约 3 美分。2
口径要写全:一次运行最多 100 次模型调用、30 分钟墙钟、1M 上下文,超限就记 0 分,成本照样计进均值。2
62.7 分是流程分
golden workflow 规定的是步骤、数据源与产出特征,评分器判的是「这份分析达到专家流程的多少价值」。2
它允许换工具、换数据、自己写代码等价完成,所以 62.7 对应的是流程对齐。答案正确率是另一回事。2
报告自己的措辞是:输出应当作专家复核的初稿。2
四道有多个专家版本的水质题说明了另一面:两位专家用卫星影像测浊度,第三位只认取水口的现场测量,三种做法都算对。2
报告还顺手记下地理基准的两种衰减。第一种是饱和:UnivEARTH 的题源在公网,裸模型 93.6 分。2
第二种是数据漂移:CBGB 有 4 个参考答案在重跑时已经对不上,因为卫星影像重处理过、保护区边界重划过。2
局限列得很干脆:只测 Gemini;GeoKTools 的模板围着 GRA 的工具设计,对有工具的配置有利;基础工具那档的解释器无网络,联网基线没测。2
还有两条。GRA 与「有工具但无规划」的差,把规划与逐条指令混在一起,没有拆开。2
GeoExpertQueries 的绝对分受评分器严格程度影响,能站稳的是同款评分器下的排序。2
| 读数 | 怎么用 | 前提 |
|---|---|---|
| GeoExpertQueries 62.7 分 | 带口径引 | 流程对齐分,只在同款评分器下横比 |
| 工具带来的 +48.9 分 | 可直接引 | 同模型、同评分器、同测试集 |
| 规划 +10.5 / −3.2 | 必须带模型 | 只有 3.8 Flash 上为正 |
| 每题 0.199 美元 | 带口径引 | 只含模型 token,不含外部数据服务 |
| CBGB 87.9 分 | 带修改引 | 删 1 题、改 4 个答案、单次尝试 |
| UnivEARTH 93.6(裸模型) | 当饱和证据引 | 不能当能力读数 |
被用在什么事上
博客给了五个合作方的试用,都是自述的效率,没有对照实验。1
世界卫生组织非洲区域办事处与刚果(金)国家生物医学研究所:2026 年埃博拉疫情初期,GRA 把森林损失、矿点与人口数据交叉。1
几分钟里定位出 48 个暴露聚落、约 45,500 名高风险人口。同样的交叉核对原本要花数周。1
INRB 的流行病建模组用 Planetary Prediction Engine 每周估一次向未感染区扩散的风险。1
People in Need 用它分析 14 条历史气旋路径,找高暴露村庄,从几天的 GIS 手工活变成几分钟。1
GiveDirectly 上传自定义边界,按风速带算热带气旋 Maila 与密西西比龙卷风的人口暴露。1
Milken Institute 把 1,500 多栋候选建筑叠加屋顶光伏与普查数据,筛社区韧性中心的选址。1
WPP 把人口动力学洞察接到自有投放数据上,做地理维度的投放优化。1
早期访问开了两条路:Ask Google Earth 里的深度分析预览,和一个 agent-to-agent 形式的推理接口。1
接下来该看什么
第一个可检验的点是规划层的边界。这次只有两档模型,方向还相反;换成别的模型家族,规划是加还是减,现在没有数据。2
第二个是联网基线。报告为了让边界干净,把基础工具那档的代码执行器断网。接上网络能追回多少,留给了后续。2
第三个是基准的保鲜。测试集不公开能挡住污染,挡不住数据漂移。CBGB 那 4 个失配的答案说明,依赖卫星与边界的基准需要定期重验真值。2
对做产品的人,报告的顺序值得照搬:先买领域工具,再考虑编排。2
同一套 GRA 里,3.8 Flash 比 3.1 Pro 高 15.1 分,成本不到它的三分之一。2
对读跑分的人,先问两个问题:这个分数评的是流程还是答案;基线有没有被拿走网络与数据。2
这两问的答案,决定那个数字能不能跨系统比较。2
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.