工具返回被反复计费、接口拆成四个最好、本地评测量到的是服务栈:9 月 21–27 日三篇大模型论文
导读 9 月 21–27 日新挂出的三篇论文:留在上下文里的工具返回如何变成持续账单、同一批能力拆成几个工具最合适,以及本地评测量到的为什么可能只是服务栈。

本期覆盖 2026 年 9 月 21 日至 9 月 27 日 首次在 arXiv 公开的大模型相关论文。生产时 arXiv 的索引已经收录到 9 月 25 日(周五)提交的条目,本轮可比对的是窗口内的周一到周五:cs.CL 375 条、cs.AI 852 条、cs.LG 785 条,按标题去重后 1602 条。三篇分别落在工具调用的账单、工具接口的拆法、本地评测的可信度三个方向。挑选的标准仍是问题说得清、实验可复述、结论能直接换成工程师和产品团队可以执行的判断。
本期三篇
| 论文 | 方法类型 | 一句话结论 | 提交日期 |
|---|---|---|---|
| Persistent Billable State: Denial-of-Wallet Attacks and Defenses in Tool-Calling LLM Agents | 智能体安全与成本测量 | 一次被保留的工具返回会在之后每一次模型调用里再计费一次,最大会话的累计输入达到首次调用输入的 14,293 倍。1 | 9 月 23 日 |
| MCP-GRANITE Benchmark: GRANularity Interface TEsting for MCP-Based LLM Agents | 工具接口粒度基准 | 同一批能力拆成 4 个任务级工具时完成率最高,比拆成 8–10 个细粒度原语高 16.4%,比合成一个万能工具高 33.6%。2 | 9 月 21 日 |
| Measuring the Serving Stack Instead of the Model: Hidden Confounds in Local Tool-Use Evaluation | 评测有效性测量 | 本地服务栈按模型模板拒掉工具调用请求,测试框架把被拒的那一轮记成模型回合,一个根本没跑过的模型于是被报成 0% 保真度。3 | 9 月 22 日 |
1. 一次工具返回,为什么会反复进账单?
元信息
Persistent Billable State: Denial-of-Wallet Attacks and Defenses in Tool-Calling LLM Agents
作者:Jinqian Zhang、Haojun Xia、Shujiang Wu、Jingkun Yue、Xia Zhang、Zhangpei Cheng、Bibo Tu(中国科学院信息工程研究所、中国科学院大学网络空间安全学院、北京航空航天大学、北京邮电大学网络与交换技术国家重点实验室)
论文:arXiv:2609.28585v1 · 2026 年 9 月 23 日提交 · cs.CR(交叉 cs.AI)。1
要解决什么问题
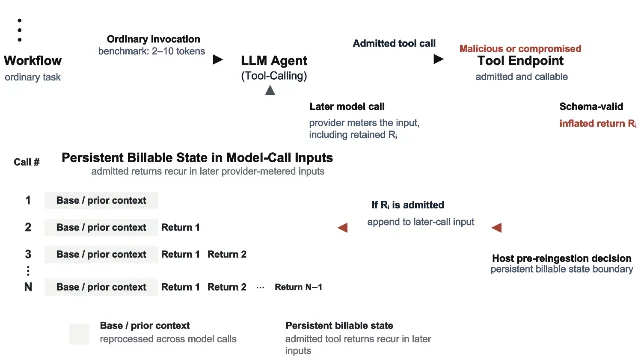
多步工具调用智能体靠一件事维持连续性:宿主运行时把工具返回留在上下文里,下一轮模型才看得见上一轮的结果。主流 API 按输入 token 计费,每一轮调用都会把保留下来的内容重新算一遍。于是一次工具返回只要被留在上下文里,就获得了在之后每一次调用上持续花钱的资格。
作者把这类内容叫「持久计费状态」(persistent billable state),把宿主决定它要不要、以什么形式进入后续计费上下文的那一步叫「持久计费状态边界」。攻击的形态是:一个正常任务调用一个早已被接纳入执行路径的远端工具,而这个工具被攻破、或者本身就是恶意的;它返回一段结构合法、看起来像正常结果、内容却被塞大的数据;宿主把它保留下来;后续每一次模型调用反复处理并计费。整个过程不需要受害者的凭证,也不需要本地运行时权限。作者推算,在完全保留、返回体量稳定的设定下,一个 2–10 token 的触发就足以启动递归计费,累计输入随轮数增长。4
这段被保留的内容同时也是任务需要的状态:丢掉它,智能体会忘记刚查到的结果;给它设一个固定上限,长流程又会被中途打断,而攻击者可以把增量摊到很多轮里躲开上限。作者由此把问题的落点放在保留什么、以什么形式保留上。4
方法是什么
作者搭了 DoW-Bench 这套端到端测试台,在六个模型家族上跑了 243 次执行,其中 69 个会话产生了正的标价成本。衡量重复处理强度的指标是「成本放大倍数」(CAF,Cost Amplification Factor):一个会话累计的输入 token 数,除以它第一次调用的输入 token 数。美元数字按厂商公开价目表折算。4
测试台实例化了六类攻击向量。V0 直接递归:工具返回一段填充内容,并诱导智能体再调一次工具。V1 多态变形:每轮换一种表示形式,让靠固定字符串或固定模板识别的防护失效。V2 跨工具链式:让返回内容把智能体引向另一个工具,把循环摊到多个工具上。V3 隐蔽升级:前几轮小而无害,等会话建立起工作流之后再加量。V4 输出武器化:把成本压力从输入历史转到模型生成侧,诱导冗长输出。V5 阈值贴线自适应:把会话当成黑箱反馈通道,始终贴着估计出的护栏下沿加量。4
另有一组实验用来隔离「保留」这一项本身的贡献:同一批需要历史的任务,用 Full(保留原始历史)、Compress(压缩后保留)、Drop(丢弃工具返回)三种策略,在 Groq 与 Mistral 两家各重跑一遍,共 144 个计划会话、143 个成本完整的会话。防御方案是确定性的历史变换,加四项宿主侧不变量 D1–D4,分别约束提示词体量、上下文增长、递归机会和累计花费,全部落在内容重新进入模型之前这个位置。作者还扫了 3,830 个公开的 MCP 服务器与传输层仓库,看部署侧有没有对应的防护。4
结果说明了什么
先看暴露的量级。单会话最大的 CAF 达到 14,293 倍,也就是这个会话累计处理了首次调用输入的 1.4 万倍。在 69 个产生成本的攻击会话里,51 个越过了 0.10 美元的熔断设置,最高一次标价 3.404 美元,均值 0.820 美元、中位 0.715 美元;同一批实验里正常会话的最高值是 0.025 美元。4
放大效应跟会话能活多久直接相关。在 Llama-3.3-70B 上,V0 直接递归的九次运行全在两轮内结束,平均 CAF 只有 22.6 倍;V3 隐蔽升级与 V5 阈值贴线自适应分别达到 385.7 倍与 117.0 倍,靠的是把会话拖得更长。作者同时报告,同一个攻击在重复执行之间的波动很大——V1 在 Llama-3.3-70B 上 CAF 的变异系数是 3.08,会话自然结束这件事不足以充当宿主的预算保护。4
三种历史策略的对照把「保留」这一项的代价与收益拆开了:
在同一批需要历史的任务上,保留完整历史与压缩后保留都还能拿到 10/12 以上的成功数,丢弃工具返回在每个供应商上都掉到 2/12。压缩因此是一层能同时压住成本与保住任务状态的变换。4
防御侧的数字落在两个尺度上。四项不变量在三种重放预设下拦住了全部 41 次递归攻击;在一组 24 条工作流的迁移测试里,按任务进度放行的 D4 策略拿到 22/24 的成功且没有提前中断,固定 0.10 美元上限的做法只有 13/24。部署面则很空:3,830 个仓库里只有 71 个存在任何代码可见的防护痕迹,没有一个覆盖四类防护。4
读完可以带走什么
把「工具返回进入后续上下文」当成一个需要单独设计的边界:谁授权它继续占用 token 预算、授权多久、以原始文本还是摘要或结构化字段的形式进入。预算护栏最好分两层——单会话的累计上限,加上对每轮增量本身的限制;这套实验里固定上限会把长任务砍掉,而按任务进度放行的策略既拦住了递归成本,也保住了大部分完成率。监控面也要挑对:只盯着入站内容大小的团队会漏掉把成本转移到输出侧的向量,只看首轮响应的监控会漏掉先小后大的策略。给自己设一条可测的判据:同一条工具返回在后续若干轮里被重复处理的次数和字节数。
局限一句
攻击的前提是执行路径上已经存在一个被攻破或恶意的远端工具,美元数字按厂商价目表折算、会随定价变化,防御部分则在重放语料与 24 条工作流的迁移测试上评估,规模小于攻击侧。4
2. 给智能体四个工具、八个工具,还是一个万能工具?
元信息
MCP-GRANITE Benchmark: GRANularity Interface TEsting for MCP-Based LLM Agents
作者:Demetris Paschalides、Moysis Symeonides、George Pallis、Marios D. Dikaiakos(塞浦路斯大学计算机系)
论文:arXiv:2609.24161v1 · 2026 年 9 月 21 日提交 · cs.DC(交叉 cs.AI、cs.LG)。
要解决什么问题
MCP(Model Context Protocol,一套让模型客户端在运行时把外部工具的能力读进上下文并调用的标准)规定的是工具怎样被发现和调用,至于同一批能力该拆成几个工具,标准留给了实现者。同样的能力可以暴露成许多单一用途的小工具、四个任务级工具、两个读写工具,或者一个收 action 参数的大工具。已有的工具调用基准把接口当成固定条件,测的是模型在这套接口下能不能用对;而拆法是每个 MCP 服务器作者都要做的设计决定。论文选在边缘设备这个更吃紧的场景里把它当成受控变量:能塞进本地的模型很小,靠换一个更大的模型来补救往往不是选项。5
方法是什么
MCP-GRANITE 是一个开源的基准框架,把工具接口的粒度当成自变量。它有 81 个多步场景,分布在 9 个物联网域里,覆盖工业自动化、智能环境和现场作业三类;每个域的场景再按难度分成三档,从 1–2 次调用、单个实体,到 9–10 次调用、4 个以上实体。同一批场景在四个粒度层级上各实例化一次:L1 是一个万能工具,L2 是两个工具,L3 是 4 个任务级工具,L4 是 8–10 个细粒度原语。每个场景都配了金标准,写明期望的调用序列与每一步参数,作者先跑通一次确认最终状态正确,再把场景投入使用。5
被测的是 9 个本地部署的模型,参数从 268M 到 20.9B,其中既有通用模型也有专门做函数调用的版本;量化位数在 3 位到 8 位之间。全因子设计把 9 个模型、9 个域、4 个粒度、9 个场景和 3 次重复组合起来,共 8,748 次运行(每个模型 972 次),硬件是一台带 NVIDIA Tesla T4(16GB 显存)的边缘工作站。工具服务器用可控的实现返回固定响应,工具延迟因此不会混进模型之间的差异。指标包括任务完成率、工具选择 F1、参数准确率、时延和能耗。5
结果说明了什么
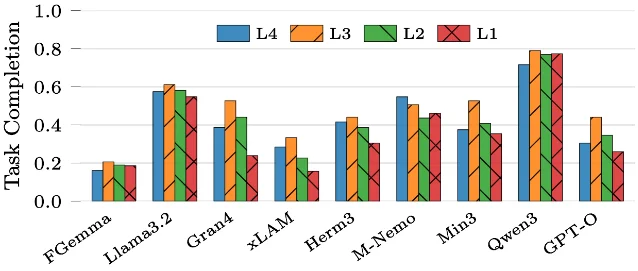
中度过合并的 L3 在 9 个模型里的 8 个上拿到最高完成率,只有 Mistral-Nemo 在 L4 略好。把四次运行的汇总数字放在一起看,粒度的影响集中在两处:参数准确率,和调用环节的失败率。
| 粒度 | 任务完成率 | 工具选择 F1 | 参数准确率 | 一次工具都没调用的比例 |
|---|---|---|---|---|
| L4(8–10 个细粒度工具) | 0.42 | 0.59 | 0.20 | 10.2% 5 |
| L3(4 个任务级工具) | 0.49 | 0.66 | 0.40 | 10.7% 5 |
| L2(2 个工具) | 0.42 | 0.71 | 0.38 | 14.6% 5 |
| L1(1 个万能工具) | 0.36 | 0.63 | 0.26 | 28.2% 5 |
L3 相对 L4 提升 16.4%,相对 L1 提升 33.6%;参数准确率从 L4 的 0.20 翻到 L3 的 0.40。作者用逻辑回归控制了模型规模、量化位数、域和难度之后,L3 仍然独立地把完成几率提高 1.36 倍(置信区间 1.12–1.66),而 L1 把完成几率降低 22%。5
这张表里有一处值得停一下:工具选择 F1 最高的是 L2(0.71),完成率最高的却是 L3。作者的解释是,选对工具跟把参数填对是两件会各自失败的事;L1 的失败主要发生在调用环节,28.2% 的运行一次工具都没调用,错误率也从 L3 的 11.4% 升到 15.8%。模型规模同样不是可靠的预测因子:Qwen3(14.8B)完成率最高,0.762,但平均要 164.5 秒;Llama3.2(3.2B)完成率 0.579,只用 6.7 秒且错误率为 0;参数更多的 GPT-OSS(20.9B,前向只激活约 3.6B)错误率 55.6%,xLAM-2 为 52.8%,失败集中在工具调用格式与 schema 违规。能耗上的差距更大:在 L3 上,3.2B 模型每成功完成一个任务消耗的能源比表现最好的 14.8B 模型少 23 倍。5
域之间的差异也很大:healthcare(0.202)与 robotics(0.244)最低,industrial(0.608)与 energy(0.596)最高,而工具选择 F1 在各域之间稳定在 0.614–0.667。模型大多挑得对工具,卡住它们的是多步执行和参数填写。5
读完可以带走什么
把能力接进 MCP 之前,先量一次接口拆法的备选方案:这套实验里同一批能力换个拆法,完成率相差 33.6%,而这件事在本地就能跑一遍。评测自己的工具集时,把工具选择与参数正确分开统计,只报一个「调用正确率」会把瓶颈所在藏起来。选型上不必只盯着参数量:在边缘场景里,一个 3.2B 模型配上合适的粒度,表现可以压过 20.9B 模型配上错配的粒度,单位成功任务的能耗差距更大。一个可以直接试的起点是任务级工具、数量在 4 个左右,也就是把同一件事的读、写、配置合并成建模者能一句话说清的粒度。
局限一句
实验在单张 T4 的边缘工作站上完成,工具服务器返回固定响应,9 个模型都在 20.9B 参数以下;完成率的具体数值换到闭源前沿模型和在线 MCP 服务上未必复现,可以带走的是粒度之间的相对关系。5
3. 本地评测里,量到的到底是模型还是服务栈?
元信息
Measuring the Serving Stack Instead of the Model: Hidden Confounds in Local Tool-Use Evaluation
作者:Lijuan Tang、Yuemeng Zheng(东北大学西雅图校区)
论文:arXiv:2609.26693v1 · 2026 年 9 月 22 日提交 · cs.CL(交叉 cs.AI、cs.SE)。
要解决什么问题
一次工具调用要先过协议层:模型吐出一段能被解析、并且符合所给 schema 的调用,框架才可能去执行它。这跟「它选对了哪个工具」是两件事。作者本意是在小模型上测协议层的成功率,测下来发现测量本身才是问题。6
在 Ollama 上,框架发来的
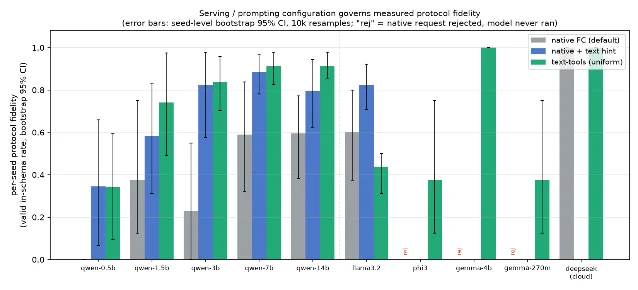
tools= 请求会按模型被一道静态的模板开关拦下来:有的模型被接受,但调用以文本形式返回;有的返回原生的 tool_calls 结构;Phi-3 和 Gemma-3 在推理开始之前就被拒掉(HTTP 400)。测试框架把「请求被拒」和「重试耗尽」写成了一条普通的助手回合,不保留结构化的失败元数据。于是一个从未真正运行过的模型,在下游按回合统计时被读成「它选择不调用工具」,报出 0% 的保真度。6方法是什么
作者搭了自己的框架和逐回合的分类口径,比较三种服务配置:原生函数调用(工具 schema 走
tools= 字段,也是默认路径)、原生加文本提示(仍走原生通道,同时在提示里附一份工具清单和调用格式)、统一文本工具表(工具只写在提示里)。主实验在 Ollama 上用 8 个种子跑,用 llama.cpp 做跨栈对照,再探 vLLM 与 SGLang 的默认行为。任务有二:一个聚合任务和一个跨模块多跳依赖链任务,另在 HumanEval 上做单轮复现;受约束解码作为一个基线。6结果说明了什么
Phi-3 与 Gemma-3 在朴素的按回合分析下都读成 0%,实际上它们 100% 的回合都是被拒请求,模型没有运行过。作者指出,这两个模型在这一栏的正确取值是「未定义」;把它记成 0,会把没跑过的模型排到榜单末尾。6
对服务端接受的模型来说,原生路径偏低主要是缺少格式指引:Qwen 0.5B、1.5B、3B、7B、14B 在原生配置下的按种子保真度是 0%、38%、23%、59%、60%,加上文本提示后变成 35%、58%、82%、89%、80%。Llama-3.2 是反向的例子:原生加文本提示能到 82%,换成统一文本协议反而掉到 44%,因为它本身有原生
tool_calls 支持,纯文本协议把这个通道丢掉了。最好用的配置跟模型有关,没有一种服务配置能让所有模型的读数都最高。6同一个请求在四个栈上的结果也不一样:Ollama 拒掉的权重,用 llama.cpp 服务时跑得起来;vLLM 默认直接拒绝,提示需要
--enable-auto-tool-choice 与 --tool-call-parser;SGLang 默认接受请求,但把调用当文本返回,除非加上 --tool-call-parser。请求会不会被拒、被接受之后调用会不会被识别,由服务栈和它的启动配置决定。6统计口径也会改结论。Qwen-0.5B 在文本协议下,按回合池化是 85%,按种子平均只有 34%——单个 41 回合的循环把池化数字拉高了。弱模型的回合数只有 8–16 个,种子级自助法 95% 置信区间宽到 [9,59],用这组数给模型排名并不成立。受约束解码在单步上让 9 个本地模型 8/8 都产出合法调用,代价是弱模型不再会停:被强制每轮都要产出调用之后,单条会话能跑到 600–900 回合,Qwen-0.5B 有一次跑到 869 回合才被截断。6
读完可以带走什么
做模型对比时先固定服务栈:同一份权重换一个栈、换一个启动参数,测出来的工具调用能力就会变;横向榜单里混着不同栈的读数,结论就站不住。框架层面要分开记三类结果:请求被拒或空响应、模型确实回复了但没调工具、调用格式不合法。这三类混成一条助手回合,下游分析会得出方向相反的结论。报数用按种子平均并带上区间,同时给出池化值,因为会话长度一旦不均匀,池化口径会被长循环主导。给弱模型加受约束解码之前先想清楚取舍:它把解析不了的调用换成了不会停的会话。
局限一句
按种子的保真度只在两个任务(分别 8 个与 4 个种子)加一次 HumanEval 单轮复现上测过,弱模型的回合数只有 8–16,vLLM 与 SGLang 只探了 Qwen-0.5B 与 Phi-3 两个模型,可以带走的是服务栈会影响读数这个事实和相应的测量纪律,具体数值会随任务变化。6
三篇各记一句
- 持久计费状态:工具返回一旦留在上下文里,它就成了持续计费的状态;宿主在内容重新进入模型之前做的那个决定,是成本的落点。
- MCP-GRANITE:工具接口的拆法是一个可以量出来的设计变量;在这套边缘实验里,四个任务级工具好过八个细粒度原语,也好过一个万能工具,而卡住智能体的多半是参数填写。
- 本地评测混杂:被服务栈拒掉的请求如果和模型自己没调工具的回合在框架里长得一样,测出来的是栈的表现,模型的排名跟着一起偏。
References
- 1
- 2
- 3
- 4
- 5
- 6
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.