说专用芯片回来了的这篇稿子,作者是 a16z 领投的 Gimlet 的 CEO
a16z 刊出一篇说专用芯片回来的客座稿,作者是它领投过的 Gimlet 的 CEO;本文拆开三十年架构史与关键数字,并交代作者与 a16z 的利益关系。

2026 年 10 月 21 日,a16z.news 刊出《Why Hardware Specialization is Back》。1
副标题把问题摆在桌上:三十年前,通用芯片在半导体业那场战略之争里赢过专用芯片;今天同一场争论回来了,约束换了。1
这是客座稿。作者 Zain Asgar 是 Gimlet Labs 的联合创始人兼 CEO,斯坦福计算机系兼职教授。2
他此前创办过 Pixie,也在 Google AI、Trifacta 和 Nvidia 工作过。2
答案压在文末:摆锤最终会摆回通用架构,但「专用化的时代就在眼前」。1
先交代一层关系。2026 年 9 月 4 日,a16z 宣布领投 Gimlet 的 3 亿美元 B 轮。3
本频道 9 月 5 日那期解读过这笔投资,讲的是 Gimlet 怎么把模型拆到不同芯片上跑。4
这一篇换了题目:三十年的架构史,加上电力这条新约束。
三十年前,通用芯片赢在专用芯片的主场上
「micro」指微处理器:一种什么活都能干得不错的通用芯片,每年以百万片计卖进桌面电脑,性能一年比一年快。
差不多同一时间,与微处理器竞争的专用架构成批倒下。
ETA Systems 在 1989 年关门,Multiflow 在 1990 年,Alliant 在 1992 年,Symbolics 在 1993 年。
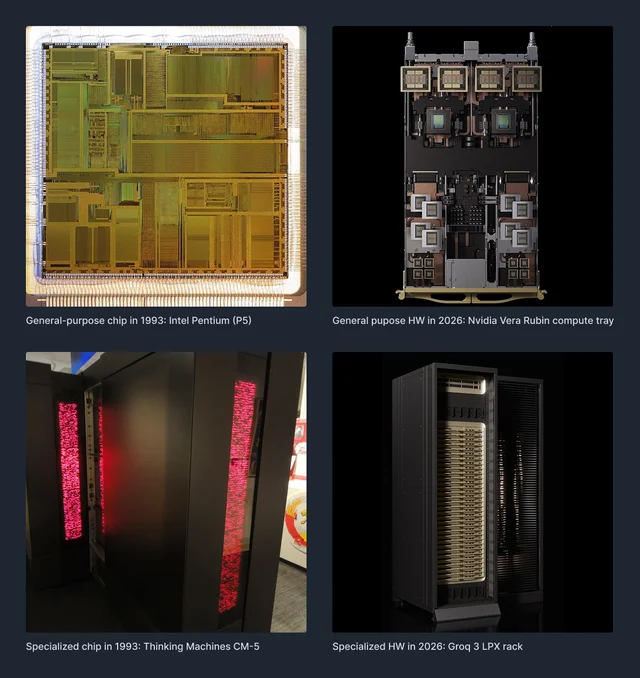
Kendall Square Research 与 Thinking Machines 都在 1994 年,Cray Computer 在 1995 年。1
Thinking Machines 的创始人 Danny Hillis 多年后说,「这些东西到头来不过是一箱箱微处理器」。1
最值得记住的是一个反直觉的事实:专用机输在自己设计的那些活上。通用微处理器在它们专门为之下功夫的任务上也超过了它们。1
为什么?作者给了一条三环相扣的正循环。
通用性带来销量:微处理器一年卖几千万片,专用机只跑一种负载,销量低一个量级。1
销量带来性能:成本摊薄、客户变多、研发有钱,1986 到 2003 年单处理器性能每年涨五成以上。1
性能又反哺通用性:同一份程序换台新机器自动变快,编译器与操作系统也有足够大的用户盘子摊薄投入。1
专用机在两头吃亏:量小,养不起同样的迭代节奏;软件栈要自己搭,用户盘子又小。
等通用芯片把它们的想法吸收进去,专用机连差异都没了。
文章举的例子很具体:早期带 DVD 光驱的电脑要配一块专用视频解码卡。
大约两年后,Pentium II 用软件就能解码,这类卡绝迹。1
免费午餐在 2005 年和 2012 年各少了一口
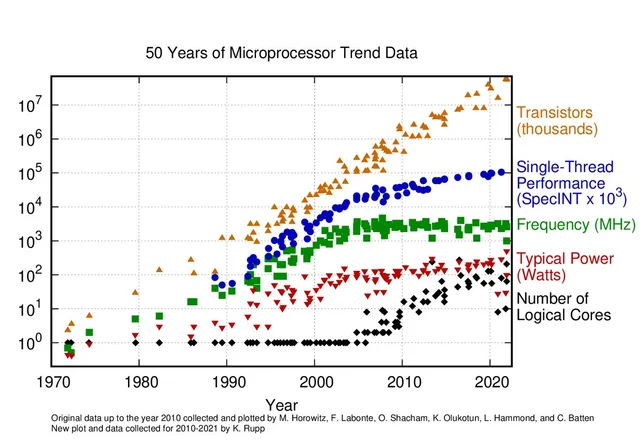
1974 年,IBM 的 Robert Dennard 发表论文说明:晶体管更小,会更快、更便宜、更省电。
于是每一代时钟都能提高,功耗却保持不变。6
这条承诺支撑了三十年。作者说它先掉的第一块是电压缩放。
大约 2005 年之后,更小的晶体管不再享受成比例的更低电压,而电压正是抬高频率的前提。1
频率曲线在那一刻走平,芯片转而堆核心,用并行补单线程的亏空。1
第二块在 2012 年掉:每个晶体管的价格不再下降。
晶圆厂和工艺的额外成本涨得比每片晶圆的晶体管数还快,单价于是持平甚至更高。1
第三块更老。1995 年就有人把内存带宽涨得比算力慢这件事叫「memory wall」。1
David Patterson 的估算是:2012 到 2022 年,Nvidia GPU 算力涨 80 倍,内存带宽涨 17 倍。8
作者给的算术很干净:算力随芯片面积增长,能进出的带宽随周长增长。面积是平方,周长是一次方,差距自己会拉大。1
2012 年,作者在斯坦福 Mark Horowitz 的组里读研。
他的一位联合创始人 Omid Azizi 参与的研究算过:一段 720p 编码跑在通用多核上,能耗约是交给 ASIC 的 500 倍。9
这个 500 倍常被当作专用化的铁证。原论文自己写得更细:通用的优化能拿回 10 倍性能、7 倍能耗。
剩下的差距才来自专用化,比较对象是 2010 年前后的一颗通用多核与一块定制 ASIC。9
GPU 是那场仗的幸存者,后来自己变成了通用芯片
1999 年的 GeForce 256 只干一件事:把三角形快速画到屏幕上。
它活下来的原因和 1990 年代那些专用机相反——它有主流市场,游戏 PC 一年出货几百万张卡。1
2005 年频率停住之后,芯片的出路从「同样的事做更快」变成「同时做更多事」。
GPU 本来就这么设计:成千上万个简单核心,配上很高的内存带宽,牺牲单线程速度换吞吐。1
接下来这张图是全篇最值得盯的一张。
Nvidia 首席科学家 Bill Dally 在 Hot Chips 2023 拆过单卡推理十年涨 1000 倍是怎么来的。10
数字格式从 FP32 到 BF16 到 FP8 贡献约 16 倍,新指令约 12.5 倍,稀疏化约 2 倍。
工艺从 28nm 到 5nm 只贡献约 2.5 倍。10
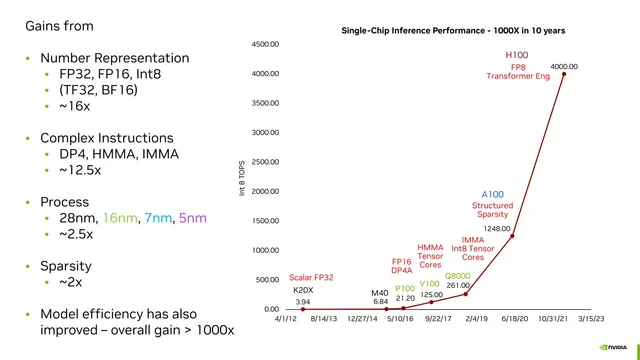
工艺不再是主贡献,这句话对整篇文章至关重要。
过去通用芯片靠规模摊薄先进工艺、再靠工艺换性能,这条路正在失去带宽。10
收入也在换位。按文章那张图,2000 年 CPU 年收入约 300 亿美元、GPU 约 20 亿。
2025 年 GPU 约 2240 亿、CPU 约 630 亿。1
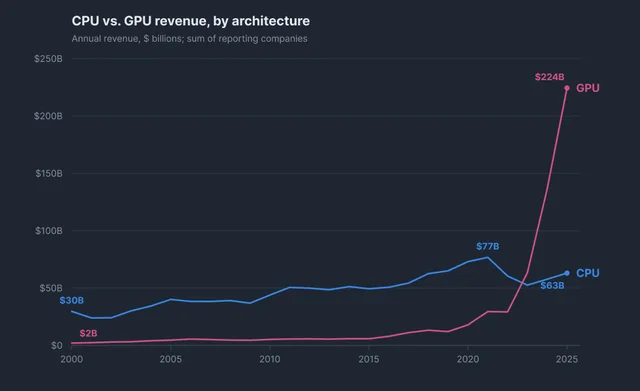
作者由此开了一句玩笑:也许该把 GPU 叫作通用加速器,把 CPU 叫作专用芯片。1
今天变了的三件事
第一条是电力。文中引用一份 2026 年的高盛报告:2026 到 2030 年,token 需求涨 24 倍,可用供电只增加约 2 倍。1
高盛那篇文章自己的口径是:在 agent 普及的假设下,全球 token 消耗到 2030 年增长 24 倍,每月 120 千万亿个。11
第二条是写软件变便宜了。作者说,用智能体替新加速器写优化代码,比过去容易太多。1
这一条打在专用化的旧伤上:1990 年代每条专用产品线都得自己养一套软件栈。
第三条是造芯片的门槛。多数芯片公司不用自己建厂,经验与基础设施也比三十年前厚。1
资本市场同样开了门。Cerebras 在 2026 年 5 月 14 日登陆纳斯达克,发行价 185 美元,首日收涨 68% 至 311.07 美元。
它募资 55.5 亿美元,市值约 950 亿美元。12
这一年最重的专用芯片交易,来自 Nvidia 自己。
2025 年 12 月 24 日,Nvidia 用约 200 亿美元买下 Groq 的资产,并取得推理技术的非独家授权。13
Groq 创始人 Jonathan Ross 等高管加入 Nvidia;Groq 公司照旧独立运营,云业务不在这笔交易里。13
到 2026 年 8 月,Groq 3 LPX 机架全面投产,年内随 Vera CPU 与 Rubin GPU 部署到 Nebius。14
这件事的读法有两面。Nvidia 花两百亿美元买一块架构与 GPU 不同的芯片,等于承认单一架构装不下全部推理负载。
它把这块芯片装进自家机架,又等于把专用硬件收编成产品线的一节。同一件事,同时是专用化的证据和通用化的证据。
作者自己列出的反向力量
文章自己列出了三条对专用芯片不利的因素。1
其一是产能:晶圆厂与 HBM 的配额都很紧,新玩家很难拿到。
其二是部署周期:加速器要跑好几年才划算,负载本身还在变,今天最优的切分过两年可能错位。
其三是吸收:GPU 一直在把推理专用特性装进自己体内,2017 年加 Tensor Core,2024 年加 MXFP4 与 NVFP4。1
第三条与三十年前那种失败方式最像:通用芯片把专用能力吸收进自己的架构。
作者最后借 Makimoto 的摆锤做总结:标准化在上市时间、成本与运营效率上占优,差异化与供需失衡把摆锤推向另一头。15
数字要怎样读
文中的关键数字,可以按「谁算的、按什么口径、覆盖哪一段」三问过一遍。
| 主张 | 谁算的 | 口径与范围 | 能否独立核实 |
|---|---|---|---|
| token 需求 2026–2030 涨 24 倍 | 高盛研究,2026 年 5 月 20 日 11 | 全球月度 token 量,agent 渗透假设 | 可核到高盛原文;同文没有「供电只增约 2 倍」 |
| 单卡推理十年 1000 倍 | Bill Dally,Hot Chips 2023 10 | 单卡、2012–2023 年的推理性能 | 可核,演讲与图表公开 |
| 算力 80 倍、带宽 17 倍 | David Patterson 的估算 8 | Nvidia GPU,2012–2022,单卡 | 可核,多篇 IEEE 文章引用同一组数 |
| GPU 收入超过 CPU | Gimlet 自己的分析 1 | 汇总有披露的公司,按架构归并 | 算法未公开,需第三方复算 |
| 同功耗下快 2–10 倍 | Gimlet 自己的 Pareto 分析 1 | 各种拆解方式与 GPU-GPU 拆解的对比 | 公司自测,未见第三方复现 |
| Groq 交易约 200 亿美元 | CNBC 报道与 Nvidia 说法 13 | 资产收购加非独家授权,公司仍独立 | 可核,双方均有公开表述 |
表里最靠下的那组数字还有一层。同一家公司对同一组性能的表述,在七周里挪了位置。
9 月 4 日 a16z 的投资公告写「在相同功耗下,最高 10 倍的吞吐与交互性提升」。3
同一天 Gimlet 的 B 轮公告里,一处写「3–10 倍」,另一处写「5–10 倍」。16
到 10 月 21 日这篇,口径成了「2–10 倍」。1
下限从 5 倍挪到 2 倍,三次表述用的都是自家同一套分析。
这种移动本身值得记一笔:读同一家公司放在投资公告、公司博客和客座文章里的数字,按最保守那一版理解更稳。
谁在写,谁受益
作者是 Gimlet 的 CEO,Gimlet 是 a16z 领投的被投公司。文章的结论正好落在 Gimlet 卖的东西上:把推理负载拆到不同芯片上跑。1
文末还留了招聘邮箱,写明所有岗位都在招,正在扩建推理云。1
有一处值得顺手核对。a16z 官网的公开投资清单(页面 2026 年 10 月 5 日更新)在 G 段找不到 Gimlet Labs。17
清单顶部自己写明:未获被投方许可公开披露的投资不列入。
一家被公开宣布领投的公司不在这份清单上,正好凑成一个可用的反例:查不到只说明没披露,说明不了没投。
另一头也值得说:文章点名的 Cerebras、d-Matrix、Groq,同样不在那份清单上。17
这篇文章在替整条异构路线说话,其中替自家产品说话的分量最重。
对做产品与做判断的人
这篇文章的可用之处,落在三个具体动作上。
第一,把工作负载拆到阶段,别停在整机。同一段推理里,prefill 吃算力,decode 吃内存带宽,工具调用吃网络往返。
判断一块芯片合不合用,先看你这一段属于哪一种。
第二,把「每瓦 token」当成一等指标。电力成为硬约束之后,性能的分母换了;同样一千瓦出多少 token、延迟多少,比自己跟自己比的峰值更有意义。
第三,用自己负载上的端到端数据做决定。作者那句「同功耗下快 2–10 倍」是自家曲线上的读数,厂商演示与你的真实流量之间隔着模型、上下文长度和并发。
对创业者还有一层定位问题。作者认为异构系统难在网络拓扑、机架密度、供电与散热这些物理设施上。1
他补了一句判断:物理基础设施的复杂度,可能比软件更难复制。这句话属于作者立场。
成立的前提是跨机房、跨芯片的调度确实要碰电力与制冷;作者没有讨论的是,这类能力同样会随芯片换代和机房标准统一而折旧。
需要自己核对的三处
两个年份都在流通,讲这段历史时说清出处更稳妥。
二、「供电只增约两倍」。 这句在原文里紧跟 24 倍 token 需求,读起来像同一份高盛报告的两个数字。
高盛 2026 年 5 月那篇只给了 24 倍与每月 120 千万亿个 token。
方向一致,数字对不上,引用时最好分开写。
三、「Groq 成为 Nvidia 的 LPU」。 原文这么写,容易读成整家公司被买下。
实际结构是资产收购加非独家授权,Groq 仍作为独立公司运营,Nvidia 拿到的是技术与团队。13
接下来看什么
Groq 3 LPX 在 Nebius 的实际上线时间与吞吐表现,是这条路线今年的第一场公开考试。
Nvidia 引用的基准来自 Artificial Analysis,称单机架可达每秒 3400 个 token。14
Cerebras 上市后的产能与毛利,会说明专用芯片这条路能不能自己养活自己。它上一年的营收是 5.1 亿美元,净利润 8800 万美元。12
GPU 的下一代会不会再把专用特性吸收一遍,是这篇论证最直接的反证来源。三十年前,通用芯片正是靠这一手赢的。
还有一件小事值得盯:Gimlet 那套 2–10 倍,什么时候出现可复现的第三方数据。在那之前,它是一家公司对自己产品的描述。1
References
- 1Why Hardware Specialization is Back
a16z.news
- 2Zain Asgar 的作者页
substack.com
- 3Investing in Gimlet
a16z.com
- 4本频道 2026 年 9 月的 Gimlet 篇
neodrop.ai
- 5Lab helped unleash power of SC
llnl.gov
- 6
- 7microprocessor-trend-data
github.com
- 8
- 9Understanding Sources of Inefficiency in General-Purpose Chips
engineering.upenn.edu
- 10
- 11AI Agents Forecast to Boost Tech Cash Flow as Usage Soars
goldmansachs.com
- 12
- 13
- 14
- 15Implications of Makimoto's Wave
shmj.or.jp
- 16Announcing Gimlet's Series B
gimletlabs.ai
- 17Investment List
a16z.com
- 18Killer micro
en.wikipedia.org
- 19AI/Data Center Power Demand: The 6 Ps
goldmansachs.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.