谷歌Gemini 4突然发布!RSI加持,GPT和Opus都让让
谷歌发布新一代旗舰模型 Gemini 4 Argon:官方与第三方榜单上它各排第几、2/10 美元的促销定价便宜在哪儿、百万 Token 输出上限,以及目前只对经审核的网络安全团队开放这一限制,逐条拆开。

本文转载自微信公众号「量子位」2026 年 10 月 1 日推送的文章《谷歌 Gemini 4 突然发布!RSI 加持,GPT 和 Opus 都让让》,作者鹭羽,发自凹非寺,量子位|公众号 QbitAI。原文链接:谷歌 Gemini 4 突然发布!RSI 加持,GPT 和 Opus 都让让。
哎呦喂,谷歌终于也是蹬起来了。。。
假期第一天,谷歌携 Gemini 4 Argon 空降多榜单第一。拳打 Opus 5.5,脚踢 GPT-6 Astra。更夸张的还在后头,单项任务成本最低可至 1.99 美元。
最高百万 Token 输出上限,面向编程、金融和法律等复杂工作流,而且划重点,网络安全防御能力超牛掰。
这波等等党要赢麻了。
不过吧,咱普通用户现在只可远观,暂时还吃不上。Gemini 4 Argon 目前只开放给部分经过筛选的网络安全团队使用,其它订阅用户得一步步来。
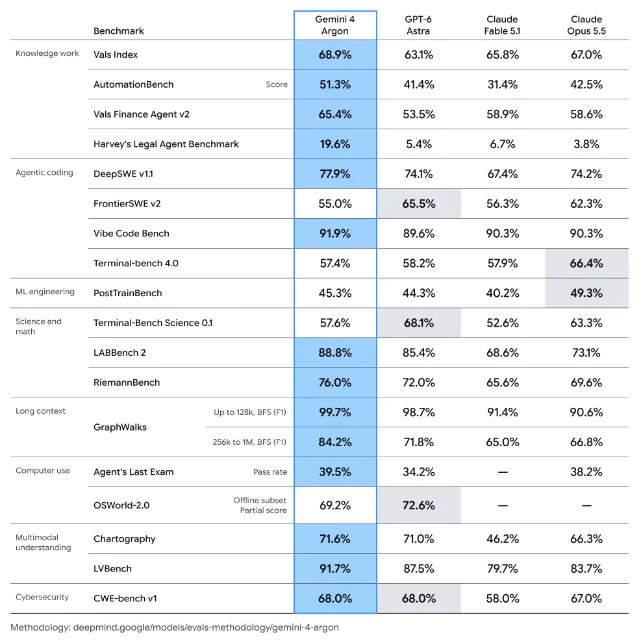
谷歌在当地时间 9 月 30 日发布这款模型,官方给它的定位是长时间跨度的复杂专业任务:真实的软件工程、法律与金融这类企业知识工作,以及网络安全防御。1 撑起这几天讨论的是三个数字:官方基准 DeepSWE v1.1 上 77.9%、Vals Index 上 68.9%、促销期每百万 Token 输入 2 美元/输出 10 美元。1
限制条件也写在发布文里:输出上限从 64K 提到 100 万 Token;首批只面向经过审核的网络安全防御方,走谷歌的 Fairwind 计划;面向开发者和普通用户的开放时间,官方只说「尽快」。1
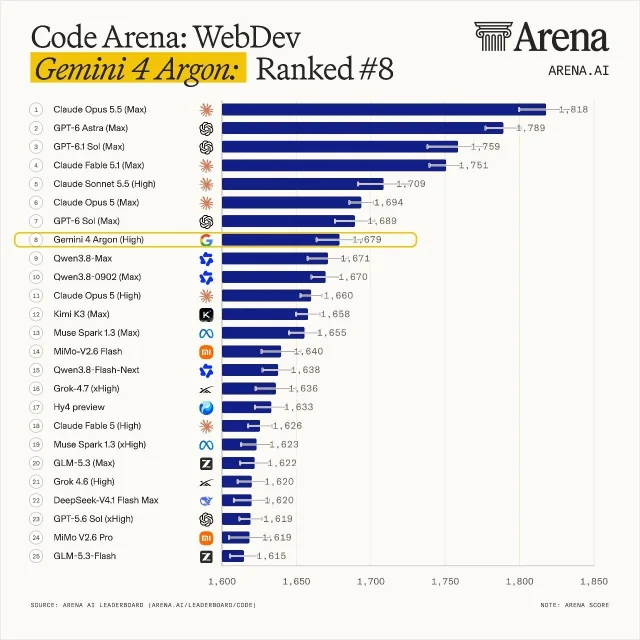
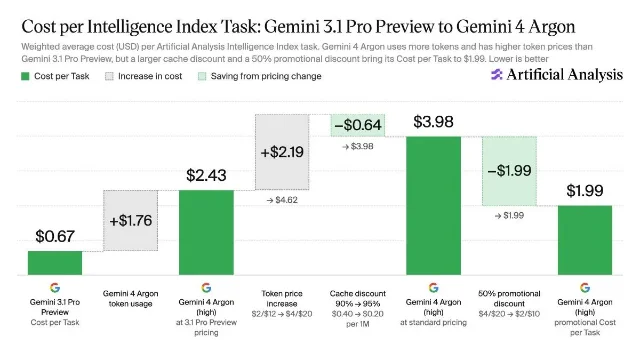
第三方给出的口径和官方并不完全一样。LMArena 的 Text Arena 上,它以 1525 分排第一;Code Arena 的网页开发榜上,它只排到第八。2 Artificial Analysis 的智能指数给到 53 分,与 GPT-6 Astra 持平、比 GPT-6.1 Sol 高 1 分,单题成本 1.99 美元。3 彭博社的报道补充了另一件事:谷歌内部有员工对它在编程上的实际表现并不买账。4
谷歌内部对新一代旗舰模型的态度还挺有意思的。劈柴哥、哈萨比斯还有接班人 Koray Kavukcuoglu,纷纷一键三连为其站台:谷歌 is back! DeepMind 研究员 Zirui Wang 也在 X 上发帖直言:5
RSI 来了!我已做无可做,是时候追逐我的咖啡师梦想了:)
轮到你了,谷歌
全体起立!咱盼星星盼月亮的 Gemini 4,它终于来了。
仔细数一数,距离谷歌上一代旗舰模型发布都快一年了,哪吒都没这么难产。这一年 OpenAI、Anthropic 是追着谷歌砍,放假前一周还连发 Opus 5.5、Sonnet 5.5、GPT-6.1 Sol 逼宫。你说谷歌能不急吗,新型号 Argon 火速上岸。
先看跑分情况,清一色的性能领跑。Argon 在衡量长期软件工程任务的 DeepSWE v1.1 上拿到 77.9%,高于 Claude Opus 5.5 的 74.2% 和 GPT-6 Astra 的 74.1%。网络安全漏洞修复测试 CWE-bench v1 拿到 68%,和 GPT-6 Astra 并列第一。1
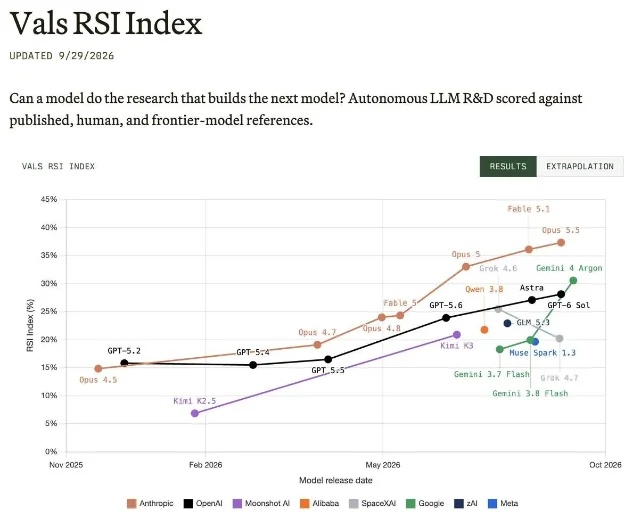
Argon 以 68.90% 登顶 Vals Index 榜首,较 Gemini 3.8 Flash 实现大幅提升。6 尤其是 RSI 指数 一跃第四,超越了 GPT-6 Astra。
RSI 说的是「递归式自我改进」(recursive self-improvement)。Vals 的这个指数把「模型有没有可能自己完成造出下一代模型的研发工作」拆成压缩、语言模型训练、后训练和 harness 工程四类任务,每项都在固定的算力和时间预算里让模型自己跑实验,最后交一份成果出来受评。7 这个指数今年 8 月上线,此前领跑的是 Claude 系列。
Gemini 4 Argon 在另外的第三方评测中也不遑多让。文本领域,Argon 在代码编写、高难度提示词、指令遵循、长查询以及创意写作赛道优势显著,以 1525 分位居 Text Arena 第一;在评测网页开发的 Code Arena 中排名第八,较 Gemini 3.8 Flash High 提升了 21 个名次,依旧稍逊于 Claude 和 GPT 最新模型。2
Artificial Analysis 测评中,Argon 和 GPT-6 Astra 旗鼓相当,高于 GPT-6.1 Sol 一分,提升主要来自更少的幻觉和更强的智能体能力。3
价格上 Argon 相比 Astra 优势明显。优惠期间单题成本约低四成;每百万输入 Token 为 2 美元、输出 Token 为 10 美元,是目前最具性价比的模型之一。3 这两句话各是一种算法:1.99 美元是 GPT-6 Astra 每道智能指数任务 3.26 美元的六成;而 2/10 美元的 Token 单价,对照 Astra 的 10/50 美元正好是五分之一。36 促销结束后,Argon 的 Token 单价回到 4/20 美元,单题成本升到 3.98 美元。13
在具体工作中,Argon 也更倾向于处理复杂且长期的深度推理任务,比如软件工程、企业专业知识梳理以及网络安全防御等。模型的百万 Token 输出上限,就是为这种长任务准备的,它能给模型更多连续工作的余地和充足的推理深度。1
以谷歌内部使用情况为例,其中 Argon 在谷歌各数据中心自主识别并落地内存优化方案,待方案全面部署后,预计可释放超 300 TiB 内存。另一个案例中,Argon Agent 围绕视频解码器的 Rust 移植版本,反复实验并替换了 3.2 万行 SIMD 代码,最终版本运行速度达到原 Rust 移植版的 2.7 倍。1
官方还重点强调了 Argon 的防御性网络安全优势。它能够自主发现、验证并修补 20 多种语言的关键软件漏洞,在 Wiz 内部黑箱渗透测试中,模型可以在无源代码下实时分析网络系统,高效发现攻击面、识别漏洞以及生成概念验证证据。1
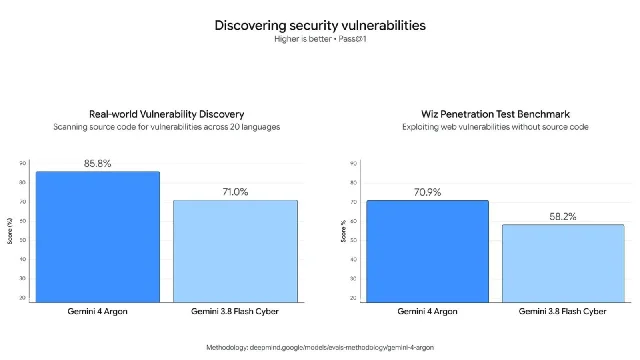
为了防止滥用,Argon 首批进入的是谷歌的 Fairwind 计划,面向经过审核的网络安全防御方。对受信任的防御团队,谷歌会放开针对网络安全任务的部分限制,Argon 将帮助防守方补洞,以及用来寻找攻击入口。1
One More Thing
不过嘴上说说得了,Argon 实际跑起来怎么样,还得打个问号。毕竟咱普罗大众还没用上啊喂。。。
彭博社的报道里,谷歌内部员工对 Gemini 4 并不完全看好。一些接触过 Gemini 4 的员工认为,模型在实际编程任务中并没有跑分那么亮眼,网页和应用的前端界面设计仍是短板,甚至存在过度刷榜的嫌疑。然而另一名熟悉开发工作的员工则表示,内部普遍认为 Gemini 4 已达到前沿水平。谷歌也回应称,说它编程表现不佳并不准确。4
总之模型到底咋样,还有待观察。所幸的是,谷歌终于回到了牌桌之上。
References
- 1Introducing Gemini 4 Argon
blog.google
- 2Arena.ai 的帖文
x.com
- 3
- 4
- 5Zirui Wang 的帖文
x.com
- 6Vals Index 榜单
vals.ai
- 7Vals RSI Index
vals.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.