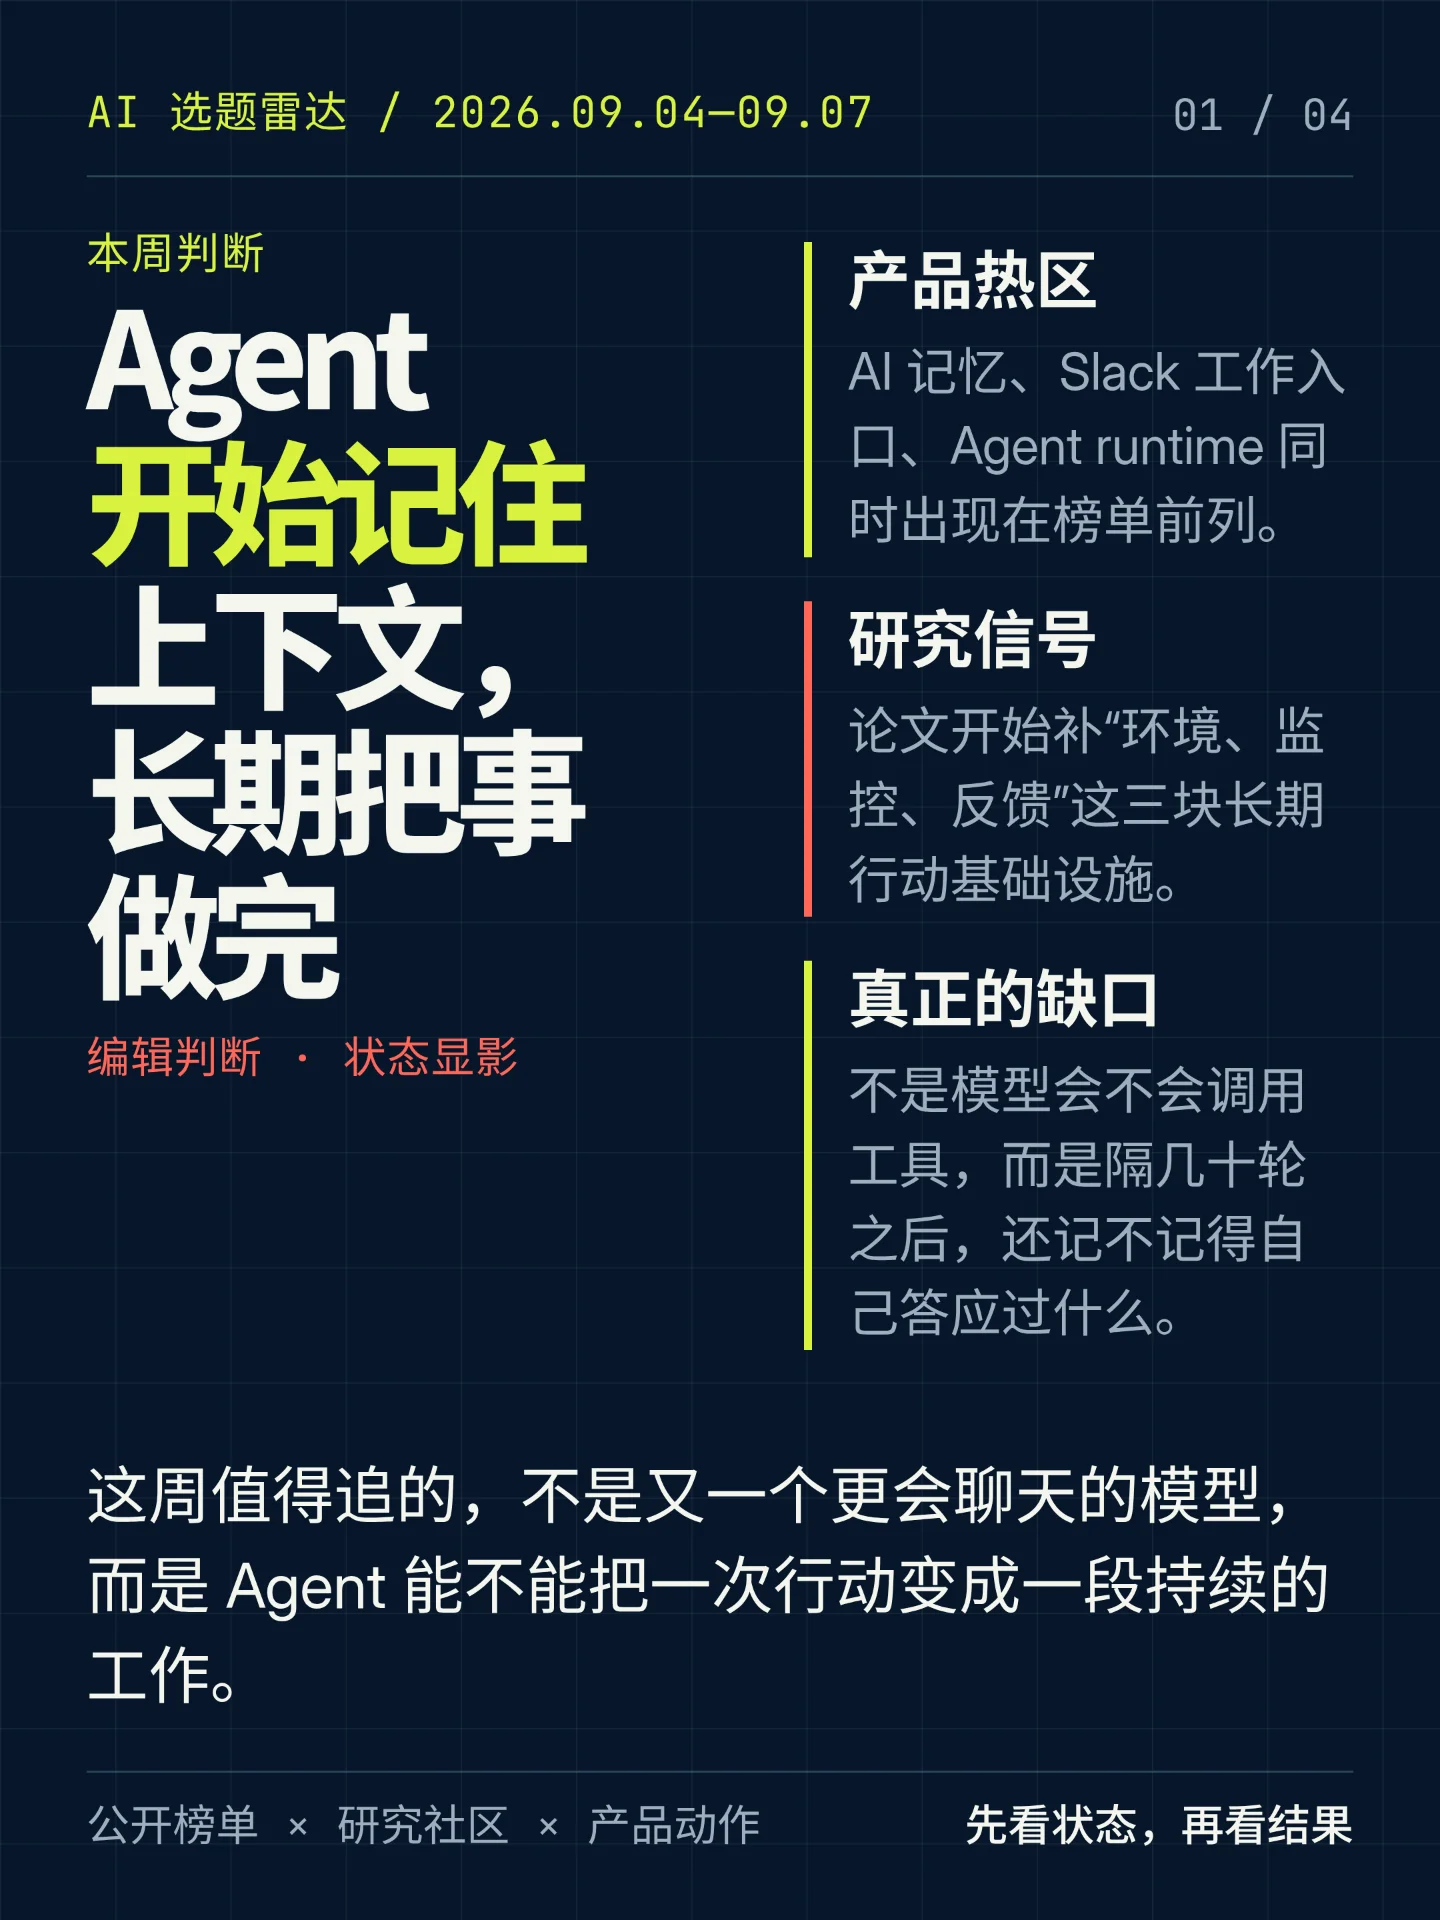
这周最值得追的,不是又一个更会聊天的模型,而是 Agent 能不能把一次行动变成一段持续的工作。产品榜单把热度落在 AI 记忆、工作入口、视频观察和 Agent runtime;研究社区则在补环境、监控和逐步反馈。下面把已验证事实和编辑判断分开,方便下周继续追。
Product Hunt 9 月 6 日 24 小时榜里,AI Toolbox 3.0 排第 1(328 票),Tadata 排第 2(281 票),Agentic Video Understanding in Gemini 排第 4(209 票),Kit by Speakeasy 排第 7(115 票)。四个产品的共同点不是“又一个聊天框”,而是让 Agent 接上跨会话上下文、组织工作、主动选择观察方式,或获得独立的运行层。1234
研究社区的信号更像一张故障地图。Terminal-Universe 在 Hugging Face 9 月 4 日 Daily Papers 排第 2,272 票;论文把 Agent 轨迹还原成可执行环境,并生成多轮任务与反馈。CivBench 把单局任务拉到 300+ turns,专门测主动监控和承诺执行;DRACO 则把终局判断重新分配给具体步骤。三篇论文都还不是产品成熟度证明,却共同指向同一个问题:Agent 忘记了什么、漏看了什么,以及失败究竟发生在哪一步。5678
给创作者的下一步,可以只盯三件小事:产品有没有留下状态,Agent 说完“下一步”后十轮以内有没有兑现,失败有没有逐步日志可查。下一轮 Agent 竞争,先比谁能持续完成,再比谁会说。
References
- 1Product Hunt 产品榜单
producthunt.com
- 2Tadata 产品页
producthunt.com
- 3Agentic Video Understanding in Gemini
producthunt.com
- 4Kit by Speakeasy
producthunt.com
- 5Hugging Face Daily Papers · Sep 4
huggingface.co
- 6Terminal-Universe
arxiv.org
- 7CivBench
arxiv.org
- 8DRACO
arxiv.org
Comments