「服务挂了,我重启一下」和「这个重启要五分钟」,差在哪三件事
工程师在群里说「服务挂了,我重启一下」,你要判断的是这次重启的代价:几台在跑、会不会丢东西、要等多久。这篇讲清服务与进程的区别、内存里攥着的状态、就绪检查、多实例,以及按下重启之后到底发生了什么。

上一期的结尾是:门牌号拿到手,下一件事是敲门。门牌号指的是服务器的地址,这一篇就从那台机器上跑着的东西讲起。
一晚上,群里两句话。
「服务挂了,我重启一下。」
「先别,这个服务重启要五分钟。」
同一个动作,两个数字:一个按下去三十秒就回来了,一个按下去只算开始。
你在群里每隔两分钟问一次「好了吗」,工程师回的估计一次比一次含糊。
先问三句,代价就出来了
听到「重启一下」,先问三句。
- 现在跑着几台?挂了的那台,是不是唯一一台。
- 它手里有没有还没写下去的东西?
- 从起来到能接活,要多久?
三句问完,答案大致落在三种里的一种。
- 边聊边按:几台都在跑,它起来得比你说完这句话还快。
- 挑时间按:要么会丢东西,要么一按就是几分钟的空白。
- 按之前先叫人:只剩一台,或者一按就起不来。
这三句里,最容易被跳过的是第一句。工程师说的「挂了」,有时候指进程没了,有时候指进程还在、只是不回话。
01 起跑
「服务」这个词,工程师指的是一个进程。
Linux 上管服务的程序叫 systemd,它的文档把
.service 文件定义成「关于一个被它控制和监督的进程的信息」1。程序变成进程,中间差一步:磁盘上的程序是个文件,躺着不干活;让它干活,系统把这个文件读进内存,变成一段正在执行的代码 2。
程序是菜谱,进程是灶上正在做菜的那个厨师。菜谱能印一千份,灶上同时站着的厨师只有一个。
进程一跑起来,机器就拨给它一块自己的地方:正在处理的数据、打开的文件、算到一半的结果,都放在那儿。
你会听到:「进程没了。」「进程还在,但请求它不回。」
这两句要分开办。进程没了,缺的是一次重启;进程还在却不回请求,可能卡在等一个不来的东西上,重启只是把这段等待从头再走一遍。
问什么:是进程没了,还是进程在、但不回请求?
02 攥着
进程手里的东西,按放在哪儿分两种。
写在磁盘上的:上传的图片、存进数据库的订单。进程走了,这些还在。
只在内存里的:登录状态、填到一半的购物车、缓存的一份数据、还没发出去的消息。
内存是进程自己的草稿纸,进程一退,草稿纸就没了。
一个服务重启之后不需要知道「上次算到哪」,叫无状态;需要,叫有状态。
无状态像一个不用交接班的收银员,来谁都行;有状态像一个记着账的老板,换人之前得先对账。
内存数据库 Redis 的文档说得很直接:快照方式不持久,机器一停或者被强杀,最后写进去的数据就丢了。
用默认的快照设置,要备好丢最后几分钟数据 3。
你会听到:「重启会掉 session,用户得重新登录。」「这个先别动,队列里还有消息。」
问什么:重启会丢掉哪一块?那一块别处有没有存着?
03 就绪
进程在跑,和它能接活,是两件事。
它起来之后还要连数据库、读配置、把缓存填热。这段时间它活着,回答不了请求。
systemd 把这个区别写成了配置项。
Type=notify 的服务要自己发一句 READY=1,才算启动完成。容器这一层说得更直白。Kubernetes 的就绪检查(readiness probe)不过,这个实例就不接流量。这项检查只问一件事:它现在能不能开始接活。
启动检查(startup probe)专门留给起得慢的应用,最长等多久可以自己设。
文档里的例子给到 30 次 × 10 秒,也就是最多 5 分钟 4。
还有一层:活着检查(liveness probe)连续不过,容器会被杀掉重来 4。
所以有时候是它在替自己按重启,人最后一个知道。
你会听到:「起来了,还在预热。」「就绪没过,再等两分钟。」
问什么:从进程起来到就绪通过,差多久?这段时间用户看到什么?
04 分身
一个服务常常同时跑着好几份,一份叫一个实例。
理由很直接:一份挂了,别的接得住;升级时一份一份换,用户感觉不到。
Kubernetes 的部署(Deployment)就是这么干的,按
replicas 起若干份,滚动更新时默认保证至少 75% 的实例还在跑 5。能这么复制的前提,是每一份都接得住任何一份活;官方对部署的描述就是「通常是不保存状态的那种工作负载」5。
有状态的服务得另想办法,这里不展开。你只要记住一句:它不适合「随便挑一台重启」。
你会听到:「三台挂了一台,用户没感觉。」「现在就剩一台,这时候不能重启。」
问什么:现在几台在跑?重启一台,剩下的扛得住现在的量吗?
05 重启
systemctl restart 的定义只有一句:停掉,再起来 6。「停掉」有讲究。系统先给进程发一个信号(SIGTERM),意思是「把手上这单做完就收工」。
然后等一个宽限期,容器里默认 30 秒;到点还没走,发第二个信号(KILL)强制结束 7。
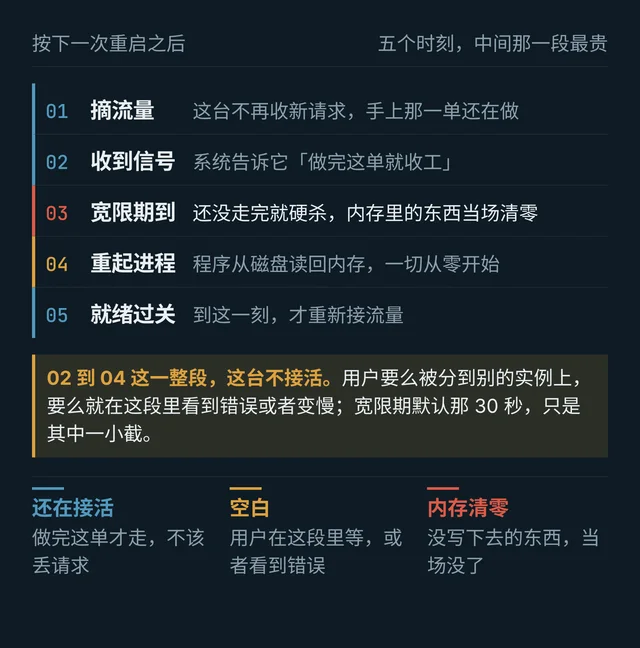
示意图由本文绘制。这台不接活的时间是收工、启动、预热三段加起来的,宽限期那 30 秒只占其中一段;滚动重启让人感觉不到,靠的是这段空白由别的实例接住。
被 KILL 的那一刻,02 节说的那张草稿纸就没了。
所以一次重启的时长 = 收工 + 启动 + 预热。工程师说的「五分钟」在后两段里,跟你按下按钮那一下隔着一整段。
还有一种情况让它更久:起不来的服务会被反复重试,间隔越拉越长。
systemd 可以配成 10 秒、20 秒、40 秒这样翻倍 1。
Kubernetes 里这个状态叫
CrashLoopBackOff,意思是它一直在崩、一直在重试 7。「怎么还没起来」有时候是它已经崩过五回了。
你会听到:「滚动重启,一台一台来。」「先摘流量,别硬重启。」「重启之后没起来,在 CrashLoopBackOff。」
摘流量,就是先让这一台停止接新单,等它把手上的做完再动手。
问什么:先摘流量再重启,还是直接重启?起不来会自己重试吗,间隔多久?
存下来当一张表
| 你听到的 | 多半指什么 | 你接着问 |
|---|---|---|
| 服务挂了,我重启一下 | 进程没了,或者进程在、不回请求 | 是进程没了,还是进程在、不回请求? |
| 这个不能随便重启 | 内存里有还没写下去的东西 | 会丢哪一块?别处存着吗? |
| 重启要五分钟 | 起来之后还要连库、预热 | 就绪什么时候过?这期间用户看到什么? |
| 三台挂了一台,没事 | 还有别的实例在接 | 现在剩几台?扛得住吗? |
| 滚动重启 | 一台一台换,其余照常接活 | 一次换几台?出事能回滚吗? |
| 重启了还是不行 | 没过就绪,或者在崩溃重试 | 现在卡在哪一步? |
怎么用
先问几台,再问丢不丢东西。这两句有答案,你就知道该催、该等,还是干脆拦住这一下。
重启弄丢的那一块叫内存,下一层从它讲起:一台机器的内存快满的时候,为什么先被杀的常常是你的服务。
References
- 1systemd.service 手册
freedesktop.org
- 2execve(2) 手册
man7.org
- 3Redis 文档:持久化
redis.io
- 4Kubernetes:配置存活、就绪与启动探针
kubernetes.io
- 5Kubernetes:Deployments
kubernetes.io
- 6systemctl 手册
freedesktop.org
- 7Kubernetes:Pod 生命周期
kubernetes.io
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.