AI 产品经理面试简报 17:COBOL 迁移、推理栈开源、27 小时通关
从 OpenAI 的 COBOL 迁移评测、DeepSeek 开源推理框架 DeepInfer、四个 Gemini 4 Argon 智能体 27 小时通关 Minecraft 这三组 2026 年 10 月中旬的更新出发,拆解每一份能力数字背后的验收口径,并整理成可直接用于 AI 产品经理面试的表达、指标与追问。

先看结论
2026 年 10 月 19 日 22:30 UTC(北京时间 10 月 20 日 06:30),OpenAI 官方账号发出一条帖子。1
帖子第一句是:最新的模型进展,让模型在用 COBOL、Fortran、Visual Basic 这类「低资源语言」构建和迁移软件时更强。1
同一天(文章页面标注的日期是 10 月 19 日),OpenAI 官网挂出一篇《Advancing coding in low-resource programming languages》,页面上只有日期,没有精确到分钟的时间。2
文章把这句话拆成了两项自建评测和一串数字。2
最强的一档 GPT-6 Astra,20 种语言的平均测试通过率 87.4%,COBOL 单项 72.1%。2
GPT-6.1 Sol 在 COBOL 迁移评测上,低推理强度拿到 86.6%;把推理强度拉满,97.9%。2
10 月 20 日 12:09(北京时间),DeepSeek 的 DeepInfer 仓库出现第一个提交。3
它是一个推理框架,许可证是 Apache-2.0,只服务自家的 V4.1-Flash 一个模型,只跑 SM100 与昇腾 950 两种硬件。4
10 月 15 日 17:51 UTC(北京时间 10 月 16 日 01:51),一篇论文提交到 arXiv。5
四个 Gemini 4 Argon 智能体(另有一个只读的观察者)被放进一张随机生成的 Minecraft 生存地图,27 小时 14 分后击杀末影龙,全程没有人类插手。5
第二天,DeepMind 官方账号把这件事写成一句更短的话:27 小时。6
三件事分属模型能力、推理成本、长时程智能体。它们都落在 10 月 15 日到 10 月 20 日这六天里,各自交出了一份带数字的账。
三份账的计量单位各不相同:测试通过率、每秒 token 与每卡时收入、一次通关的小时与美元。
三份账也各留了一个空位,位置不同。下面这张表是入口。
| 更新与日期 | 核心机制 | 用户价值 | 行动窗口 | 证据边界 |
|---|---|---|---|---|
| OpenAI 低资源语言评测,2026-10-192 | 两个评测两套判分:MultiLangBench 用真的 SQLite 比对输出,迁移用隐藏测试做逐字节对账2 | 维护遗留系统的团队拿到分语言的公开读数(厂商自评口径)7 | 下一个迁移项目立项前:先写下判定标准,再比模型8 | MultiLangBench 开源可复跑;迁移评测未公开,无第三方验证9 |
| DeepSeek 开源 DeepInfer,2026-10-204 | 开源离线推理核心(调度、投机解码、SWA 重放、专家负载均衡、结构化输出);KV cache、分离部署与副本负载均衡留在内部4 | 自建团队拿到一份生产级参考实现,省掉摸索调度的时间10 | 扩容决策前:先算 128 张卡与约 100 PiB 存储的门槛1011 | 没有与 vLLM、SGLang 的同条件对照;彭博写明尚无独立复测12 |
| 四智能体通关 Minecraft,2026-10-15 提交5 | 四个同模型智能体靠写程序操作角色,用游戏内聊天与共享记忆分工,上下文过长时自我压缩5 | 一个长任务同时有了完成、小时、美元三个数5 | 下一次长任务评估:补上「跑了几次」这一栏13 | 单次运行、首次尝试、种子未公布;成本四档口径易混1415 |
01 COBOL 迁移:验收写得很死,判分握在一家手里
发生了什么
10 月 19 日那条帖子分三段。第三段是征集需求:如果你的团队正在处理这类系统,告诉我们下一步该攻哪些语言与工作流。1
文章结尾只留了一句「你可以在 API 上试」;当天的发布落在评测与调研上,产品与定价都没有动作。2
文章把这几款统称「我们最新的模型」。2
两项评测都是 OpenAI 自己建的。2
MultiLangBench 要求模型用 20 种语言从零实现一个与 SQLite 3.40.1 兼容的数据库引擎,语言里含 COBOL、Fortran、OCaml、Visual Basic。2
COBOL 迁移评测要求模型把 COBOL 程序改写成 C++、Java、Kotlin、Python 或 Rust,同时保住原来的行为。2
这门生意的规模写在背景里:COBOL 支撑 40% 以上的网上银行系统、80% 的线下信用卡交易与 95% 的 ATM 交易;美国联邦政府每年 IT 支出超过 1,000 亿美元,其中约 80% 花在运行与维护既有系统上。1920
MultiLangBench 上,GPT-6 Astra 在最高推理强度下平均通过率 87.4%,对照组 GPT-5.6 Sol 是 26.8%;20 种语言里有 19 种超过 83%。2
分语言看差距更清楚:COBOL 从 10.9% 到 72.1%,Fortran 从 21.4% 到 83.5%,Visual Basic 从 27.5% 到 89.4%,OCaml 从 25.6% 到 85.8%。2
便宜一档的 GPT-6 Luna 平均 40.3%,每个样本的 API 成本 0.77 美元,比对照组的 3.48 美元低约 78%。2
迁移评测上,GPT-6.1 Sol 低推理强度 86.6%,同设置的 GPT-5.6 Sol 是 5.4%,成本只有后者的 61%;推理强度拉满后到 97.9%。2
产品机制:什么叫迁移成功,文章把它写死了
文章在方法一节把「成功」定义成了一个可执行的判定。2
原文是:为检验行为是否被保留,用隐藏测试要求可观察输出逐字节一致;只有全部测试通过,才算一次成功的迁移。2
文章同时给出了这类任务最典型的失败方式。2
COBOL 的定点运算默认丢弃多余小数位,除非显式要求舍入;重写版若改成四舍五入,程序可以无报错地跑完,财务结果却是另一套。2
编译通过、单测通过,都可能发生在算错钱之后。
MultiLangBench 的判分走的是另一条路。7
候选程序读入初始数据库文件与一段 SQL,产出新库,再用真的 SQLite 3.40.1 跑验证查询,比对期望输出;崩溃或 60 秒超时判失败,用错语言记 0 分。7
分数是一个二元组:API 成本与测试通过率。7
这套设计让判分不依赖模型自评,也不依赖人工打分,因此能被外部复跑。7
仓库的 tests 目录下有 2.29 万个哈希命名的用例;官方建议只跑开头为 00、01、02 的 272 条,控制成本。7
迁移评测这一边没有可复跑的公开版本。2
用户价值
对维护遗留系统的团队,这篇材料的价值在判定标准,分数排在第二位。2
「逐字节一致、全部通过才算成功」这句话可以直接搬进项目文档,它把「模型写得像不像」换成了「输出对没对上」。2
第二个价值是可对照的读数。文章逐项列出了各语言的通过率,团队能据此判断哪种语言值得让模型先上手。2
第三个价值来自开源的那半套评测。自建团队可以拿 272 条建议用例跑一遍自家模型,得到与官方同一口径的数字。7
产品经理如何落地
第一步,先写判定标准。 把「迁移成功」写成一条能跑的规则:哪些输出要逐字节一致,哪些允许误差,谁来做对账。2
第二步,选一条业务规则做影子运行。 新旧两套系统同时处理真实流量,比对结果差异,差异条数就是这个任务的真实指标。8
第三步,把通过率换成差异数。 模型报告的通过率是候选集上的成绩,生产里关心的是每天对不上的记录有多少条。8
第四步,专家评审留在流程里。 官方自己写明了边界:用到生产软件上仍需专家评审,并针对该系统的业务规则与依赖关系做测试。2
第五步,把「通过测试」与「行为等价」分开记。 受监管行业的验收清单是回归测试、黄金数据集、并行运行与可回滚,测试通过只是其中一项。8
可验证指标
- 评测规模:20 种语言;原始 SQLite TCL 测试 5.1 万条,可转换为 2.4 万条用例,仓库实际收 2.29 万个;建议复跑 272 条。7
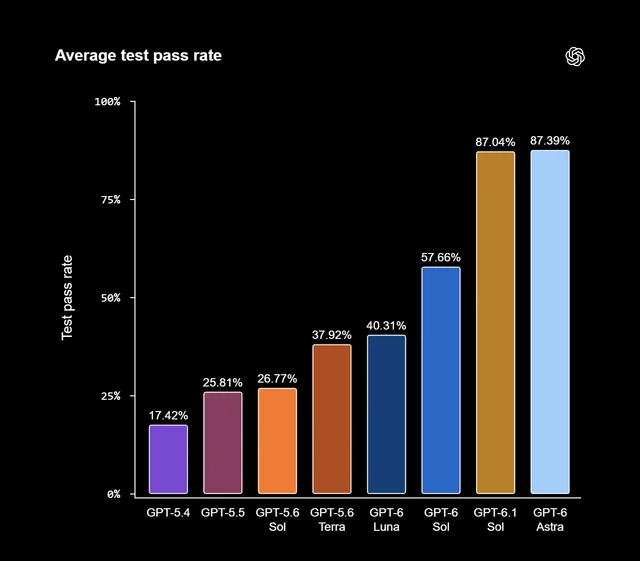
- 平均通过率:GPT-6 Astra 87.4%,GPT-6.1 Sol 87.04%,GPT-6 Sol 57.66%,GPT-6 Luna 40.31%,GPT-5.6 Terra 37.92%,GPT-5.6 Sol 26.77%,GPT-5.5 25.81%,GPT-5.4 17.42%。2
- 单项分数:COBOL 72.1%、Fortran 83.5%、Visual Basic 89.4%、OCaml 85.8%。2
- 迁移分数:GPT-6.1 Sol 86.6%(低推理强度)与 97.9%(高推理强度),基线 GPT-5.6 Sol 5.4%。2
- 成本:Luna 每样本 0.77 美元,GPT-5.6 Sol 3.48 美元;迁移评测成本为基线的 61%。2
- 许可证:MultiLangBench 为 Apache-2.0,仓库规模 13 个 star、3 个提交(2026-10-21 读取)。7
- 未公开:迁移评测的题量、题目来源、高推理强度档的成本。2
风险边界
没有任何外部验证。 Dataconomy 的报道写得直接:两项评测都由 OpenAI 自行设计与执行,没有任何外部机构验证过结果。9
头条数字建立在外部看不到的测试上。 Let's Data Science 的原话是:问题在于谁来复核,MultiLangBench 是公开的,而每条头条都在引用的 COBOL 迁移分数,来自外部无人见过的测试。22
97.9% 已经接近满分,区分度在下降。 同一篇分析指出,一个接近饱和的基准,对下一代模型的说明力有限。22
背景数字只有一个来源。 上面那组 40%、80% 与 95% 出自 IBM 的科普页,OpenAI 与各家媒体都在转引,没有第二处独立确认。19
翻译派的路线本身也在被质疑。 IBM 软件高级副总裁 Rob Thomas 的判断是:翻译几乎抓不到真正的复杂度,现代化的难点在于应用运行所依赖、所集成的一切;他还给出一个容易忽略的分布——大约 40% 的 COBOL 跑在 Windows、Linux 这类分布式平台上。23
通过测试与生产行为是两件事。 Futurum 分析师 Mitch Ashley 的原话:当迁移后的代码在生产中偏离遗留系统的行为时,测试通过什么也证明不了。8
对账正在被自动化,方法还是预印本。 一篇 2026 年 7 月 30 日提交的论文把影子运行做成流程:把 COBOL 与生成的 Java 都搬进非主机环境跑起来,用确定性对账做判据,在 430 到 4,114 行的生产类程序上做到 91.90% 分支覆盖率;该论文未经同行评审。24
联邦层面的账可以查。 美国政府问责局 2025 年 7 月 17 日的报告列出 11 套最需要现代化的系统,这些系统的运行年限在 23 到 60 年之间,其中 8 套用过时语言、7 套有已知网络漏洞;财政部入选的两套跑在 COBOL 与汇编上,报告写明具备维护技能的人正在减少。20
面试可直接说
10 月 19 日 OpenAI 发了一篇低资源语言的研究文章,没有新模型,内容是对 GPT-6 家族的补测:自建了 MultiLangBench,让模型用 20 种语言从零写一个兼容 SQLite 3.40.1 的数据库引擎,Astra 平均通过率 87.4%,COBOL 单项 72.1%;另一个评测是把 COBOL 迁到 C++、Java、Kotlin、Python 或 Rust 并保持行为,GPT-6.1 Sol 从 86.6% 到 97.9%。我更看重它把「迁移成功」定义成了可执行判定:可观察输出逐字节一致、全部测试通过。这个定义很好用,因为 COBOL 的定点运算默认截断,重写版改成四舍五入就能无报错地算错钱。边界也要说清:MultiLangBench 开源可复跑,迁移评测用的是外部看不到的隐藏测试,没有任何第三方验证;而且 97.9% 已经接近饱和,区分度在下降。
面试官追问
- 你怎么用一组厂商自评的数字判断模型能力?答题时把能复核的那一半与只能当参考的那一半分开说。
- 遗留系统迁移的验收标准你会怎么写?从可观察输出的对账规则写起,再补影子运行与回滚。
- 如果模型报告 97.9%,你会怎么设计上线门槛?把通过率换成每天的对账差异条数。
02 推理栈:省成本的那一段开源了,另一半留在内部
发生了什么
10 月 20 日 12:09(北京时间),DeepInfer 仓库出现第一个提交,提交信息是 initial commit。3
仓库在 10 月 16 日就建好了,公众能看到内容从 20 日开始。3
官网「研究与动态」栏没有这一条,最新一条停在 9 月 10 日的 V4.1-Flash。28
开源范围写得直白。4
README 的定位句是:DeepInfer 是驱动 DeepSeek 大规模生产服务的高性能推理框架,这次的开源版本提供离线推理,包含规模化服务所需的核心能力。4
模型只支持 V4.1-Flash 一个。4
硬件清单只有两行:NVIDIA SM100 与华为昇腾 950;H100、H200、AMD 都不在其中。4
仓库本身还是早期状态。29
包版本 0.1.0,状态标 Beta,没有任何 release,公开至今只有三个提交,12,509 个 star,119 个待处理的合并请求。29
issue 区没有开放,那 119 条全部来自外部开发者。32
产品机制:框架被切成了两半
官方在部署问答开头自己划了层次:此前开源过 TileLang 与一系列算子库,今天开源的是推理框架。10
放出来的五项,每一项都对应推理里的一个具体环节。10
零开销批调度器把下一个 batch 的调度、启动与采样,压在 GPU 跑当前 batch 的时间里。10
DSpark 投机解码让草稿模型一次出五个 token,再用置信度头预测每个位置的接受率,按期望接受率排序后取前缀子集去验证。10
SWA 有界重放只重算最近 128 个 token,把重算成本压成与上下文长度、层数无关的常数。10
EPLB 给每张卡留出冗余专家,按最近若干步的负载定期重排。10
结构化输出把正则、JSON schema、EBNF 先编译成自动机,解码时逐步生成掩码。10
另一半明说没有放。4
README 列出三项「完整推理服务需要、本次未包含」:KV cache 系统、视觉编码器/预填充/解码的分离部署、数据并行副本之间的负载均衡。4
中文报告给了理由:这三块与内部基础设施耦合较深。25
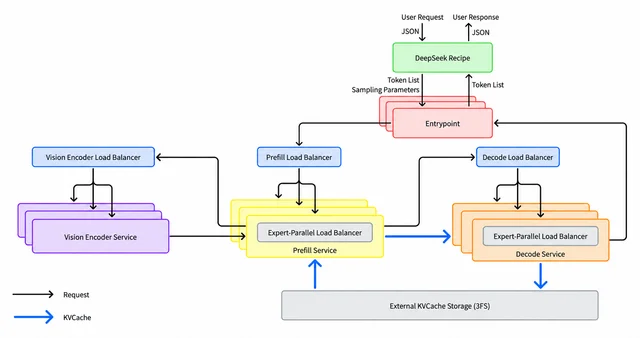
doc/images,随仓库以 Apache-2.0 发布。它画出的是完整生产系统:请求从编解码组件进 Entrypoint,再按阶段分给视觉编码、预填充、解码三个负载均衡器,预填充与解码各自内部还嵌着一层专家并行负载均衡,KV cache 则被外置到 3FS 存储集群。按 README 的清单,图上的外部 KV cache 存储与副本间负载均衡,正是本次没有开源的部分。图不给任何性能数字。4部署规格把门槛摆在明处。10
最小有效单元是 64 张卡做预填充加 64 张卡做解码,合计 128 张;张量并行与上下文并行(TP、CP)目前都不用。10
KV cache 分三层:显存里正在处理的请求块、本机内存里的 SWA 缓存、3FS 集群上的分页块;3FS 一侧约 100 PiB SSD,agent 流量留 3 天、聊天流量留 7 天。10
官方在模型发布文里对自建另给了一条门槛:2,000 张卡加一套存储集群。11
成本能压下来的根子在模型侧。11
V4.1-Flash 是 552B 参数的 MoE,用了一种非对称结构:输入侧激活 8B,输出侧激活 16B。11
它把 KV cache 的显存需求压到上一代的四分之一、SSD 需求压到八分之一,相对初代缩小 437 倍。11
缓存变小之后,「只重算最近 128 个 token」这笔账才算得过来。10
用户价值
做自建推理的团队拿到的是一份生产级参考实现。10
调度怎么切、投机解码的验证算力怎么分配、专家负载怎么重排、结构化输出怎么不拖慢解码,这四个问题的答案都写在代码与问答里。10
对个人开发者和小团队,价值有限。33
HN 上重复出现的三个问题是:跟 vLLM、SGLang 比到底快多少;本地卡能不能跑;这套东西能不能直接自建。帖内没有一条实测回答。33
README 的硬件清单回答了第二个问题:SM100 与昇腾 950 之外的卡不在支持范围内。4
产品经理如何落地
第二步,把它当参考实现读。 调度器、投机解码、专家负载均衡都是可以照着改的工程决定,这部分的阅读成本比重新设计低得多。10
第三步,成本用官方定价自己搭算例。 V4.1-Flash 输出谷价 0.6 美元、峰价 1.2 美元每百万 token;峰时是工作日 UTC 01:00 到 04:00 与 06:00 到 10:00,其余时段含周末都是谷时。34
第四步,把「开源」与「可替换」分开评估。 缺的三块正好是 KV cache 与副本调度,用它替换现有框架之前,先把这三块自己补上。4
可验证指标
- 性能图的条件:解码 EP64DP64、384 加 64 个专家、131,072 上下文、nextn 固定为 3、接受率 75%(τ 等于 3.25)。10
- 解码吞吐:64 张 SM100,每个 DP 副本 256 个请求时约 26,200 tokens/s/GPU,单用户约 103 tokens/s。10
- 预填充吞吐:4 张 SM100,每副本 65,536 token 时约 88,000 tokens/s/GPU,单步约 730 毫秒。10
- 唯一的整栈生产数字:单集群 155 万亿 token/天,每卡每小时 38 美元,官方注明是收入口径、按谷价计算。10
- 仓库状态:12,509 star、1,139 fork、3 个提交、0 个 release、119 个待处理合并请求(2026-10-21 读取)。29
- 许可证:框架 Apache-2.0,编解码 MIT,权重 MIT。293031
风险边界
没有独立复测。 彭博的原话是:DeepInfer 的效率提升尚无任何独立基准测试。12
官方给的百分比都是组件级、带基线的。 DSpark 相对「固定 5 token 验证」快 4% 到 7%,条件是每副本约 60 条并发序列;同一张表还写着 16 条并发时慢 1.5%。10
与主流框架的对照一个都没有。 致谢里只承认这套框架起初基于 vLLM,并参考了 SGLang 与 TensorRT-LLM;README 里没有对应的对照曲线。4
开源版与内部版的差距只有一个局部数。 FlashMLA 解码核慢 5% 到 10%,端到端最多差 5%;缺的那三块对单位成本的影响没有量化。10
155 万亿与 38 美元没法审计。 分子分母都没披露,尖峰与谷时的占比也没给;拿它反推卡数需要未公开的混合单价。10
吞吐数字没有误差棒。 两张图都是单次自报,没有重复次数,也没有同条件的第三方读数。10
面试可直接说
10 月 20 日 DeepSeek 开源了 DeepInfer,它在自己生产环境里跑推理用的框架,Apache-2.0,只支持 V4.1-Flash 一个模型,硬件只有 SM100 与昇腾 950。开源的是离线推理核心:零开销调度器、DSpark 投机解码、SWA 有界重放、专家负载均衡、结构化输出。缺的三块官方自己列了:KV cache 系统、预填充与解码的分离部署、数据并行副本的负载均衡,理由是跟内部基础设施耦合太深。所以我不会把它当降本测算,会当参考实现读。它给的百分比都是组件级、带基线的,比如 DSpark 相对固定 5 token 验证快 4% 到 7%,16 条并发时反而慢 1.5%;跟 vLLM 的对照干脆没有,彭博也写明尚无独立复测。自建门槛是 128 张卡起、3FS 一侧约 100 PiB。
面试官追问
- 你要不要用开源推理框架替换现有栈?先算 128 张卡与存储门槛,再估缺的三块自建成本。
- 怎么评估一个「省成本」的技术发布?先分清哪个数字是成本、哪个是收入、基线是什么。
- 自建推理的单位成本怎么算?用官方定价搭算例,再把运维与利用率折进去。
03 通关:一个长任务被压成三个数,缺的是「跑了几次」
发生了什么
10 月 15 日 17:51 UTC(北京时间 10 月 16 日 01:51),arXiv 上出现论文《A team of Gemini 4 Argon agents beats Minecraft》。5
作者三人:Maxence Faldor、Satinder Singh、Roberta Raileanu,都署 Google DeepMind,许可为 CC BY 4.0。5
第二天 16:11 UTC(北京时间 10 月 17 日 00:11),DeepMind 官方账号发布这条工作,用时写成取整的「27 小时」。6
实验用了五个实例:四个玩家,加一个只读的观察者。5
五个实例都是同一个通用编码智能体,跑同一个模型,各自占一台云机器;玩家之间不共享上下文。5
环境是 Minecraft Java 版 1.20.4,生存模式,难度 Easy,随机生成的种子,关闭作弊指令,没有装任何模组,客户端用开源的 Mineflayer 与它的寻路插件。5
给智能体的游戏指令只有一段:目标是从共享世界的出生点出发击败末影龙,这是唯一标准,生存模式规则内任何手段皆可,分工由玩家自己决定。5
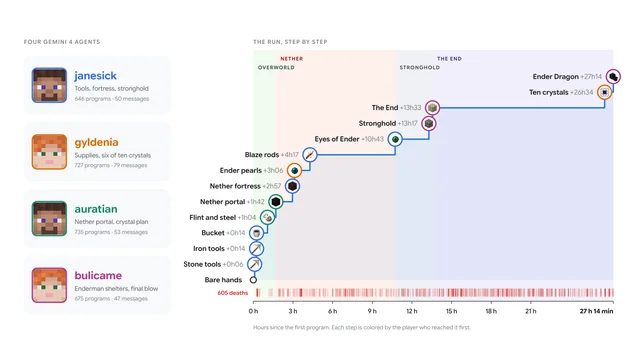
结果写在服务器日志里:一条来自角色 bulicame 的成就记录「Free the End」,时间戳是第一个程序开始之后 27 小时 14 分。5
过程中:2,783 个程序在胜利前跑完,全程 2,839 个;229 条聊天;605 次死亡,其中 69 次死于末影龙;22% 的程序以报错结束。5
产品机制:把操作写成代码
这套实验有一处值得学:智能体之间传递的,是一段能被读、被复用的代码。5
智能体每回合写一小段 JavaScript,经命令行客户端送到自己的机器人执行,然后读回位置、血量、背包、发现了什么,或者一条报错。5
程序运行的中位时长 33.5 秒,每个玩家大约 40% 的时间有程序在跑,其余时间在读结果、思考、写下一条。5
程序不能起进程、不能写文件;写在全局对象上的值可以跨程序存活,于是它们自己攒出了 146 份状态与代码、42 个辅助函数。5
其中一个修复合成 bug 的辅助函数出现在 655 个程序里,另一个被引用 1,519 次。5
上下文靠两条通道传递。5
一条是游戏内聊天:每条消息对所有玩家可见,并出现在各自下一条程序的输出里;另一条是团队共享记忆,分私有与共享两部分。5
上下文过长时,智能体自己把内容压短,并把「在做的事与下一步」写进记忆,好熬过压缩。5
分工是涌现出来的,而且留下了记录。5
第一个程序跑完 10 分钟后,janesick 在聊天里提出分工;一分钟内 auratian 提出另一套方案;gyldenia 回了句「Copy that!」。5
角色随后定型:gyldenia 负责找食物、床与燧石,bulicame 下矿找钻石,janesick 炼铁造工具,auratian 准备下界传送门。5
用户价值
对做长时程任务的团队,这份材料给出的是一套可用配方。5
通用编码智能体加游戏内聊天加共享记忆,再配一个上下文压缩策略,就能在不写游戏专用工具的前提下跑过一整天。5
论文的定性是:复杂的真实软件工程与企业任务,需要同样的长时程编码与多智能体协作能力。5
对负责评估的人,价值在报价方式。5
一个原本说不清的长任务,同时有了三个数:完成情况、墙钟小时、每任务美元。5
产品经理如何落地
第一步,给长任务报价要三个数。 完成率、墙钟时长、每任务美元,三个数一起报,单报一个都不足以支撑决策。5
第三步,把观察者做成产品里的一层。 只读、不参与执行,专门比对「它说做了什么」与「记录里做了什么」,发现取巧就上报。5
第四步,选任务时看参照系。 论文引的 HowLongToBeat 数据里,人类玩家的主线中位时长 45 小时,随机种子速通(不挑地图、比谁最快通关)的纪录不到 7 分钟;同样是「通关」,两个参照系差出三个数量级。5
第五步,把环境限制清单带进方案评审。 这次通关建立在「用代码感知环境」之上,与从像素用键鼠操作不是一回事。5
可验证指标
- 时间:27 小时 14 分 12 秒,从第一个程序算到末影龙死亡;墙钟时间,其中含 6 次服务器重启、累计停顿约 20 分钟,跨约 81 个游戏日。5
- 成本四档:玩家打到通关,促销价约 520 美元、标准价约 1,040 美元;整场含观察者与赢后一天,约 810 美元与 1,620 美元。5
- token 账:13.5 亿输入 token(其中 91% 命中缓存)、1,600 万输出 token(含 400 万思考 token)、约 24,000 次模型调用。5
- 复算:拿论文的 token 拆分自己算一遍,12.285 亿缓存 token、1.215 亿未缓存输入、1,600 万输出,代入促销价得 525.9 美元,与论文的 520 美元对得上;按标准价翻倍后是 1,051.7 与 1,620 美元,与论文的 1,040 与 1,620 对得上。515
- 今天跑一遍的价格:促销价仍有效到 2026 年 11 月 30 日,现在跑是 520 与 810 美元;标准价 4 美元输入、20 美元输出自 2026 年 12 月 1 日生效,届时是 1,040 与 1,620 美元。15
- 对照:单个 Claude Opus 5 智能体配 37 个现成高层工具、Normal 难度,用时 3 小时 56 分、388 次工具调用、1 次死亡,API 等价成本约 93 美元;它跑得比那四只快、花得比它们少,条件是手里有 37 个游戏专用工具。38
- 公开讨论热度:HN 上以论文链接提交的两个帖子分别拿到 5 分 0 评论与 3 分 1 评论。39
风险边界
只有一次运行。 论文原文是:我们描述一次运行,这是我们尝试的第一次启动,无法说明这套设定有多可靠。5
种子没有公布。 只说随机生成、没有预先勘察,因此外部无法判断这张地图是不是偏容易。5
论文自己列了六条限制。 论文列了六条限制:智能体靠代码感知环境,能看到实心岩石背后的方块与末影龙的内部状态,寻路插件还替它算路线;难度是 Easy;训练数据里本来就有大量 Minecraft 知识;失败极多;基础设施重启六次;只有一次运行。5
「2027 年价格」是媒体误写。 The Decoder 写的是「按 2027 年生效的标准价」,而 Google 定价页与发布文脚注都写 2026 年 12 月 1 日生效;定价页上的 2027 年 1 月 1 日属于另外两款 Flash 型号。141540
成本只算 token 支出。 论文自己注明:这些数字是按列表价与 token 计数器估出来的,与模型服务的真实成本是两回事;五台云机器的算力、服务器、监控面板与人力都不在内。5
公开争论很淡。 唯一一条 HN 评论质疑的是体裁,问这算不算研究;没有具名研究者对方法学提出公开质疑。39
面试可直接说
10 月 15 日 DeepMind 三个人挂了一篇 arXiv:四个 Gemini 4 Argon 智能体,加一个只读的观察者,被丢进随机生成、Easy 难度、关了作弊的 Minecraft,27 小时 14 分后击杀末影龙。它们的操作方式是写 JavaScript 程序去驱动角色,不按键鼠;分工是第一个程序跑完 10 分钟后在游戏聊天里自己谈出来的;上下文靠聊天与共享记忆传递,太长就自己压缩。成本按列表价算,打到通关约 520 美元(促销价)或 1,040 美元(标准价),整场含观察者约 810 与 1,620 美元。我关注的是它的报价结构:完成、时长、美元三个数都有,缺的是「跑了几次」——这一跑是第一次尝试,作者自己写明无法据此判断可靠性;种子也没公布。所以做长时程任务,我会在报价单上再加一栏重跑次数,方法是每个任务跑六次,取成功率 50% 处的时长。
面试官追问
- 你怎么给一个长时程 agent 任务定价?完成率、墙钟时长、每任务美元,再加一个重跑次数。
- 一次成功能不能当作能力?先要求重跑,看成功率曲线,同时问清环境限制。
- 这个结果能推到真实工作场景吗?先比对限制清单,代码感知与像素操作是两种难度。
把三条串起来:三份账,各自空着一格
References
- 1
- 2
- 3deepseek-ai/DeepInfer 提交记录,GitHub API
api.github.com
- 4DeepInfer README,GitHub
github.com
- 5
- 6
- 7openai/MultiLangBench,GitHub
github.com
- 8IBM vs Anthropic: a tale of the COBOL modernization tape,Futurum
futurumgroup.com
- 9
- 10DeepInfer 部署问答,GitHub
github.com
- 11DeepSeek-V4.1-Flash 发布说明,DeepSeek
deepseek.com
- 12
- 13
- 14
- 15Gemini Developer API 定价,Google
ai.google.dev
- 16Introducing GPT-6 Astra,OpenAI
openai.com
- 17Introducing GPT-6 Sol and Luna,OpenAI
openai.com
- 18Introducing GPT-6.1 Sol,OpenAI
openai.com
- 19What is COBOL?,IBM
ibm.com
- 20
- 21
- 22OpenAI's COBOL score: only OpenAI can check,Let's Data Science
letsdatascience.com
- 23
- 24
- 25DeepSeek V4.1 Flash 大规模推理部署实践,知乎
zhuanlan.zhihu.com
- 26DeepSeek 开源推理框架:走向真正普惠的未来,微信公众号
mp.weixin.qq.com
- 27DeepSeek 开源帖,X
x.com
- 28DeepSeek 官网研究与动态
deepseek.com
- 29deepseek-ai/DeepInfer,GitHub
github.com
- 30deepseek-ai/deepseek-recipe,GitHub
github.com
- 31DeepSeek-V4.1-Flash-1017 模型卡,Hugging Face
huggingface.co
- 32DeepInfer 待处理合并请求,GitHub API
api.github.com
- 33DeepInfer 讨论,Hacker News
news.ycombinator.com
- 34DeepSeek API 定价
api-docs.deepseek.com
- 35
- 36
- 37
- 38Four Gemini 4 agents beat Minecraft in 27 hours,Tom's Hardware
tomshardware.com
- 39论文提交帖讨论,Hacker News
news.ycombinator.com
- 40Introducing Gemini 4 Argon,Google
blog.google
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.