AI 产品经理面试简报 12:输出上限、决策模型、算子迁移
从 Google 发布 Gemini 4 Argon、Cloudflare 开源决策模型 Clef、DeepSeek 开源面向华为昇腾的六项基础设施组件这三组更新出发,拆解 AI 产品在「输出能有多长、判断由谁做出、代码跑在谁的芯片上」三个默认假设上的变化,并整理成可直接用于 AI 产品经理面试的表达、指标与追问。

先看结论
2026 年 9 月 30 日,Google 发布新一代前沿模型 Gemini 4 Argon,署名作者是 Google DeepMind 高级副总裁兼 Google 首席 AI 架构师 Koray Kavukcuoglu。官方把模型的输出上限从 64K 提高到 100 万 token,并把这称作「业界领先」;价格在促销期内是每百万输入 token 2 美元、每百万输出 token 10 美元。1 这个模型当时没有对公众开放。它先经 Google 的 Fairwind 计划放给通过审核的可信网络防御者,官方写明的后续顺序是「从付费 API 客户与 Google AI Ultra 订阅者开始」,没有给时间表。1
2026 年 10 月 1 日北京时间 23 时 34 分,Cloudflare 发布两款「决策模型」Clef 与 Clef-flash,并把权重按 Apache 2.0 许可开源。这类模型不写文章:它读入一段状态和一组你自己定义好的类型化问题,对每个问题的每个合法答案给出一个概率,官方说全程没有自由文本、也没有需要等待的推理 token。2
2026 年 9 月 30 日北京时间 10 时 1 分,DeepSeek 通过官方公众号宣布,开源面向华为昇腾算力平台的六项基础设施组件,官方把它们概括为高级语言编译工具、计算库与分布式通信库三类,并写明「所有组件与此前面向英伟达平台的开源组件一一对应」。同日下午 14 时 25 分,华为计算的官方账号发文呼应,列出了昇腾侧提供的底层能力。34
这三件事改掉的是 AI 产品三个默认假设。第一个是「一次回答能有多长」:供应商把一个更大的数字摆上桌,而这个数字的工程实现决定了你的任务该怎么切。第二个是「判断由谁做出」:当判断可以被拆成一个不写字的模型,产品里本来就存在的分流、分级与放行,第一次有了独立的、可设阈值的部件。第三个是「代码跑在谁的芯片上」:第二套工具链出现之后,迁移成本从「重写算子」降到「换一个后端」,但降下来的只是重写代码那一部分成本,性能磨合与团队经验并不在内。
| 更新与日期 | 核心机制 | 用户价值 | 行动窗口 | 证据边界 |
|---|---|---|---|---|
| Gemini 4 Argon 发布并分阶段开放,2026-09-30 | 输出上限从 64K 提到 100 万 token,价格促销期 $2/$10、标准 $4/$20,促销没有公布结束日期;先经 Fairwind 审核放给可信防御者,并对其与 Google 内部团队去掉网络类护栏15 | 设计长任务的人要重新算「一次任务」的 token 与断点,而不再看单次上限 | 10 月内用 $2 与 $4 两档单价各算一次同一个长任务的总价,把促销断档写进成本模型 | 价格与开放顺序是官方原文;100 万 token 的工程含义来自第三方(跨请求续写、实测配置 262k);基准表是官方自报口径 |
| Cloudflare 开源决策模型 Clef 与 Clef-flash,2026-10-01 | 输入状态加一组类型化问题,输出每个合法选项的概率,没有自由文本与推理 token;27B 与 9B 两个尺寸,Apache 2.0,单价 $0.24 与 $0.09 每百万输入 token2 | 把系统里「判断」这一步从生成里拆出来,变成一个可以设阈值的数值 | 10 月内取 200 条自家历史工单跑一次概率校准,再决定阈值定在哪 | 延迟与榜单均为自评,上游榜单未复现;官方自建榜单页自己标注延迟不可直接比较;完整面板里推理密集型任务仍由对手领先 |
| DeepSeek 开源面向昇腾的六项基础设施组件,2026-09-30 | 六项组件同批开源,覆盖编译、矩阵运算、跨设备通信、向量与访存算子、稀疏注意力、数据筛选,与英伟达侧组件一一对应;接口兼容,迁移从重写算子变成换后端34 | 硬件第二条路出现后,验收清单要先写清「哪些功能没有搬过来」 | 10 月 15 日前后昇腾 950DT 商用硬件窗口,向供应商索取商用版实测与第三方复现结果 | 性能数字全部为厂商自报且附硬条件;截至发布时没有第三方复测;训练端只有华为的单方说法 |
01 输出上限:它说一次能写一百万个 token,先问这是几次请求
发生了什么
Google 在 2026 年 9 月 30 日发布 Gemini 4 Argon,官方博客只标了日期,没有给发布时刻。1 发布时它既没有通用开放,也没有公开的 API 模型标识:Gemini API 的官方模型页在 2026 年 10 月 1 日更新后仍未收录这个模型。6
开放路径是分两步走的,这一步是官方原文。第一步,Argon「正通过我们的 Fairwind 计划放给一批可信的网络防御者」。Fairwind 是 Google DeepMind 的一个受限访问计划,官方页面写明它面向政府与国家级网络机构、关键基础设施运营方和核心科技平台,申请者需要填表并接受审查,Google 明说自己会「审查所有申请者」并对申请机构做背景调查;获得授权的机构只能把 Argon 用于内部的网络安全、事件响应与渗透测试团队,且禁止转售、转发与共享。5 第二步,官方说之后会「从付费 API 客户与 Google AI Ultra 订阅者开始」,并强调这需要一个过程,没有给出日期。1
官方同时说明,这个发布与美国政府的发布前自愿访问流程对接。这个流程的一手依据是 2026 年 6 月 2 日签署的第 14409 号行政令《促进先进人工智能创新与安全》:由财政部、国防部(经国家安全局)、国土安全部(经网络安全和基础设施安全局),会同国家网络总监办公室、白宫科技政策办公室与商务部(经国家标准与技术研究院)建立分级评估流程,由开发者自愿地、在最长 30 天内向联邦政府提供发布前访问;行政令同时写明,这一节不得被解释为授权建立强制性的许可、预审或批准要求。7
能力与价格是这样写的。官方原文称,模型输出上限从 64K 提升到「业界领先的 100 万 token」;促销期内每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入在输入价基础上减价 95%(也就是按输入价的 5% 计费);促销期结束后为每百万输入 4 美元、每百万输出 20 美元。官方脚注只写「促销期结束后」,没有给出结束日期。1 作为对照,OpenAI 官方文档里 GPT-6 Astra 的单次最大输出是 128,000 token,Anthropic 官方文档里 Claude Opus 5.5 与 Sonnet 5.5 的单次最大输出都是 128K,批处理接口最高 300K。89
护栏上有一个必须单独说的差别。官方写明,对可信防御者和 Google 内部团队,Argon 会「在移除网络类护栏的状态下」发布,以便他们使用完整的网络防御能力;面向更广发布时,模型则被设计为拒绝有害请求。官方没有逐条列出被移除的拒绝策略是哪些类别。1 与之配套的公开材料还有三份:DeepMind 2026 年 6 月 18 日的 AI 控制路线图,主张用监督者模型审查智能体的推理与动作,并给出检测与响应的分级;DeepMind 研究院 2026 年 9 月 16 日关于保留推理可读性的文章;以及前沿安全框架的相关说明。10
「100 万 token」这个数字要拆开看。Artificial Analysis 在发布当天的分析里写明,Argon 的 100 万输出是通过 Gemini API 的一项新特性「长解码续写」达成的:它会暂停很长的回答,在后续请求里继续,从而让推理突破请求超时限制、达到 100 万输出 token 的规模。11 另一家评测机构 Vals AI 的模型页里,实测配置写的最大输出是 262k(262,144)token。12 两处口径都来自第三方,而官方博客只讲了输出上限,没有写输入上下文窗口。1
产品机制:输出预算变成了任务设计与成本核算的新变量
这条更新真正的产品含义,不在这 64K 到 100 万这个数字本身,而在「一次请求」和「一次任务」从今天开始可以被分开计价与分开设计。
过去你把任务交给模型,隐含的假设是一次请求对应一次产出。当输出要靠暂停与续写来拼接,一次任务就可能由多次请求组成:断点落在哪里、状态怎么带过去、续写失败从哪一步重来,这些都变成了产品设计的一部分。11 这件事对做长任务的人尤其重要,因为你衡量成功的方式也随之变了——你能验收的不再是「它一口气写完了」,而是「它在每一个断点上的产物是否成立」。
成本结构也随之变形:单价低不等于每任务便宜。Artificial Analysis 给出的每任务成本是:促销价下 1.99 美元,是同期 GPT-6 Astra 的约 60%;促销结束后升到 3.98 美元。同一篇分析指出,Argon 平均每任务输出约 62,000 token,而 Astra 约 27,000——便宜来自单价低,不来自 token 效率。11 在网络安全基准 CWE-bench v1 的官方榜上,Argon 的每次 rollout(一次完整的跑分尝试)成本是 6.63 美元,而 Grok 4.7 是 2.75 美元、GPT-6 Astra 是 2.85 美元、Claude Opus 5.5 只要 0.79 美元。13
准入规则本身也是产品设计的一部分。Fairwind 对使用范围的写法——只授权给内部安全团队、禁止转售与共享、需要用户级认证与访问控制——是一份可以直接借用的「能力授权范围」模板;对做企业产品的团队来说,这套表述在采购与合规评审里比「我们保证安全」有用得多。5
还有一个容易被跳过的细节:这个模型发布时没有公开的 API 模型标识与模型卡。6 对要写技术方案的人,这意味着一件事——你无法在自己的评测环境里先跑一遍,只能引用别人的读数。
用户价值
对做长任务产品的团队,这次更新给出的是一组可直接用来算账的参照:单次上限、每任务 token 消耗、每任务成本、以及促销价与标准价之间的落差。
对要和供应商谈判的团队,值得记下的是开放顺序的写法。能力先给审核过的机构、再给付费客户与高价位订阅者,这套顺序本身就是供应商对能力分配的表态;把它读出来,比读基准分更能判断你能在什么时候拿到什么。15
对要写对外表述的人,这里有一组可以复用的说法:先说清「发布的是受限访问版本,不是通用可用」;再说清「100 万 token 是官方口径的输出上限,第三方看到的实现方式是跨请求续写」;最后说清「促销价没有公布结束日期」。三句话都能在一手页面上找到对应。111
产品经理如何落地
第一步,把「一次任务」定义成你能计量的单位。 至少要能回答三个问题:这个任务平均要几次请求、每次请求的状态从哪里恢复、失败之后从哪个断点重来。这三件事在单次请求的时代是不需要回答的。11
第二步,成本模型按两档价格各跑一次。 同一个长任务分别按促销价和标准价算一遍,把两个数字都放进报价单,而不是只留对自己有利的那一个。1
第三步,把验收点放在中间产物上。 当输出可以跨越多次请求,最终结果的可信度取决于中间步骤是否可核对;如果你只能验收最后那一段文字,你就无法区分「它一次做对了」和「它续写时补上了」。11
第四步,把授权范围写进自己的合规说明。 Fairwind 用的是「只授权给内部安全团队、禁止转售」这类可执行的表述;你自己产品里的能力分级,也可以照这个结构写:谁能用、用在哪些任务上、能不能往外传。5
可验证指标
- 输出上限的实现方式:官方称 100 万 token;第三方给出的是跨请求续写,且有一处实测配置写 262k。这三条口径必须同时写出来。11112
- 每任务成本与 token 消耗:促销价下 1.99 美元、标准价 3.98 美元;平均每任务输出约 62,000 token,对照组约 27,000。11
- 单次动作成本:CWE-bench v1 榜上 Argon 每次 rollout(一次跑分尝试)6.63 美元,竞品区间是 0.79 到 2.85 美元。13
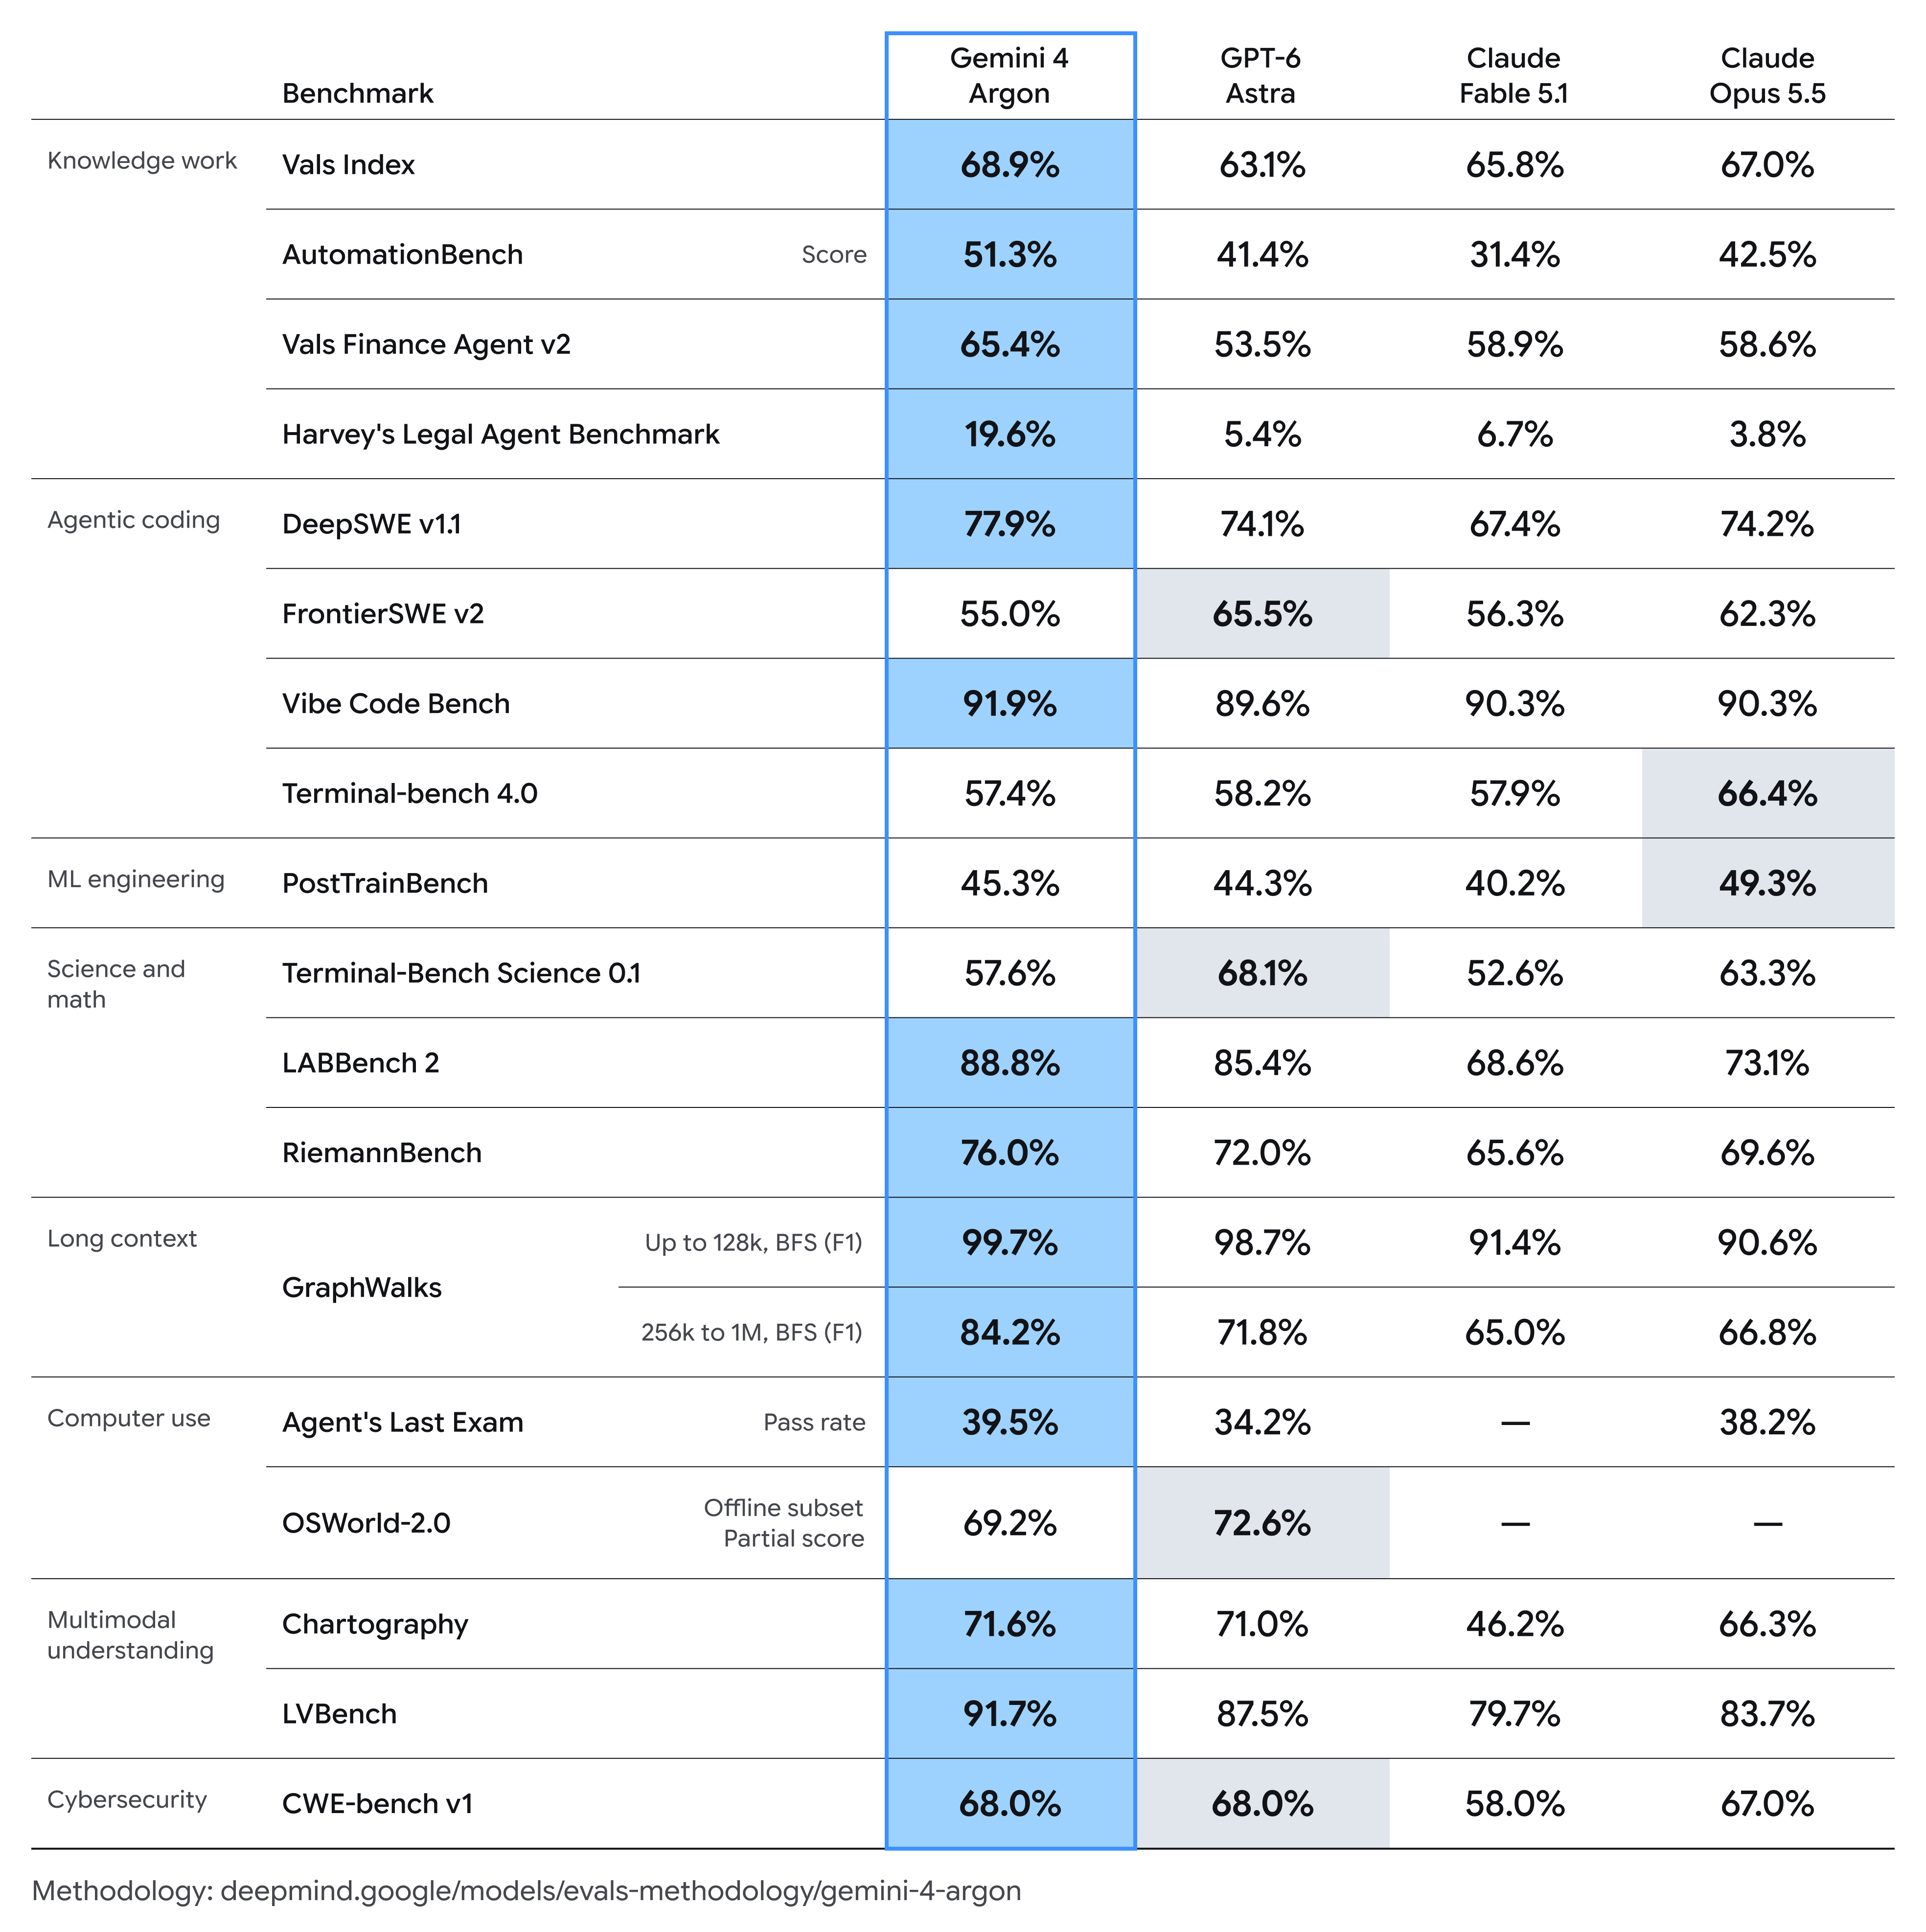
- 榜单位置(带范围):Vals Index 上 68.90%、在 43 个模型中第一;Zapier 的 AutomationBench 上 51.29%、第一;CWE-bench v1 与另外两个模型并列第一,均为 68%。131415
- 同一批基准上的反面读数:Harvey 法律智能体基准的完整榜上,Argon 排第 5,19.58%;Artificial Analysis 的综合指数上它是 53 分,与 GPT-6 Astra 持平。1116
- 自家表上的落后项:Google 自己的 19 行对比表里,Argon 在 FrontierSWE v2、Terminal-bench 4.0、PostTrainBench、Terminal-Bench Science 0.1、OSWorld-2.0 五行上落后。1
风险边界
100 万 token 目前只有官方口径,实现方式由第三方给出。 官方把它称作「业界领先的 100 万 token」输出上限;第三方指出的实现是跨请求续写,另有一处实测配置写 262k。说「单次响应可产出 100 万 token」超出了现有证据。11112
官方基准表不是统一条件的复跑。 Google 的评测方法文件自认,非 Gemini 模型的分数取自各厂商自报;其中 DeepSWE v1.1 的 Argon 分数由 Google 自算,竞品分数取自各自的官方榜单或系统卡。17
同一个「第一」在不同榜单上并不一致。 Vals Index 与 AutomationBench 上确实第一,Harvey 的完整榜上却是第 5,Artificial Analysis 的综合指数上只是与 GPT-6 Astra 持平。引用「第一」必须带上榜单名与对比范围。11141516
去掉网络护栏的具体内容没有公开。 官方确认对可信防御者与内部团队移除网络类护栏,但没有逐条公开被移除的拒绝策略类别,也没有说明这些能力在授权机构内部的审计如何执行。有安全媒体指出,官方在提到用该模型发现一处影响全球医院所用医疗软件的漏洞时,既没有点名该软件,也没有说明是否已修复。118
官方内部用例没有第三方验证。 量子算法优化比已发表基线好 40%、释放 300 TiB 内存(估计总量 500 TiB 至 1 PiB)、把 Fuchsia Zircon 内核 80 万行以上代码迁移到 Rust、libgav1 中替换 3.2 万行 SIMD 代码后快 2.7 倍,全部来自 Google 自己的分享。它们可以说明方向,不能当作可复现的性能结论。1
媒体叙事比官方口吻强。 路透的标题写「在数月延迟之后」,并称 Google 面临追赶压力;官方博客通篇只用「分阶段」这个说法,不出现「延迟」。引用时区分这两者。19
面试可直接说
9 月 30 日 Google 发布了 Gemini 4 Argon,输出上限从 64K 提到 100 万 token,促销价每百万输入 2 美元、输出 10 美元,之后回到 4 美元和 20 美元,促销结束日期没公布。要注意它当时不是通用可用:先给通过 Fairwind 审核的可信防御者,而且官方明确说对这批人和内部团队会移除网络类护栏,之后才从付费 API 客户和 Google AI Ultra 订阅者开始,没有时间表。我最关注的是那 100 万 token 怎么实现——第三方分析说它靠 API 的跨请求续写,另一家评测机构的实测配置写的是 262k。如果这件事成立,产品侧的含义是「一次请求」和「一次任务」被分开了:任务要按断点设计,成本要按每任务算,验收点要放在中间产物上。还有一个数字很能说明问题:促销价下每任务 1.99 美元、是同期对手的六成,但平均每任务输出 62,000 token,对手只有 27,000——便宜来自单价,不来自 token 效率。要说清的边界是,基准表是 Google 自己拼的,非 Gemini 模型的数字取自厂商自报,同一个模型在 Harvey 完整榜上只排第五。
面试官追问
- 供应商告诉你「单次输出上限一百万 token」,你会再问哪三个问题,才会把它写进你的架构方案?
- 如果同一个任务在促销价和标准价之间差一倍,你会怎么改产品的报价与额度设计?
- 一个模型对公司外部客户有护栏、对审核过的机构没有护栏,这种差别在你的产品里对应什么设计?
02 决策模型:让模型只做判断,不写字
发生了什么
Cloudflare 在 2026 年 10 月 1 日北京时间 23 时 34 分发布 Clef 与 Clef-flash,这是由 Cloudflare 的 Workers AI 团队训练并托管在该平台上的第一批模型。2
两个模型的形状是这样的:Clef 是 27B 的多模态决策模型,Clef-flash 是 9B 的快速版本,骨干分别冻结自 Qwen3.8-27B 与 Qwen3.5-9B,权重按 Apache 2.0 许可开放在 Hugging Face 上,同时托管在 Workers AI。两者上下文窗口均为 65,536 token,单次请求最多带 4 张图片,最多可以一次问 64 个问题。22021
单价写在 Workers AI 的计价页上:Clef 每百万输入 token 0.24 美元,Clef-flash 每百万输入 token 0.09 美元;两个模型都没有列出输出价。22 第三方在发布当天用真实账号跑通了接口,返回体里的用量字段显示输出 token 为 0。23
「决策模型」这个品类不是 Cloudflare 首创。按 Cloudflare 自己的说法,这个品类要对标的是 TypeSafe AI 的 Jev——这一类模型的共同点是产出「有界的结构化输出」,可以在工作流需要一个判断时被调用,而且换一批分类类别不需要重新训练。2 时间线上,TypeSafe 在 2026 年 9 月 15 日发布 System One 与 Jev,输入每百万 token 0.042 美元、输出不计费;OpenAI 在 9 月 29 日的开发者大会上宣布了 Decisions API,由 GPT-6 Luna 驱动、只对部分客户开放预览,请求与响应的结构、是否返回概率、价格都没有公布。242526
Cloudflare 同时发布了配套的强化学习微调服务:先把这项工作交给自家的前场工程师团队(指被派驻到客户现场、与客户一起把模型调到可用状态的工程师)做人工交付,之后再做自助平台;链路是把 AI Gateway 采集到的请求变成数据集,用 Workers AI 生成 rollout,在 Containers 里做强化学习沙箱与打分,用新的 Trainer 更新权重,再把微调后的模型部署回 Workers AI。2
产品机制:判断被拆成一个有界、带概率、可设阈值的部件
这个部件要解决的,是过去「让模型做判断」和「让模型写文章」被合在同一件事里做。
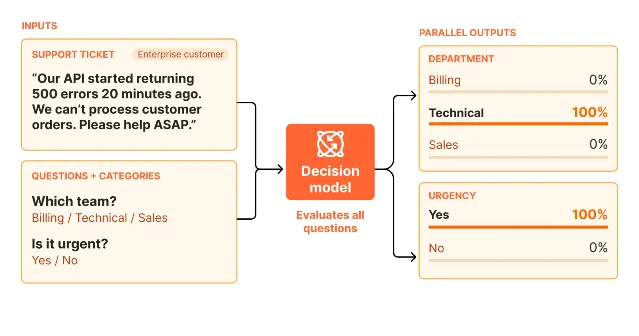
它的接口形状是固定的:你给它一段状态(文字、JSON、图片都行),再加一组类型化的问题,它对每个问题的每个合法答案给一个概率。问题分三类:第一类是非题,返回「是」的概率;第二类是选择题,返回被选中的选项、每个选项的概率和一个置信度;第三类是评分题,按你定义的有序量表返回概率加权的分数与每一档的概率。答案本身就是结构化数据,代码可以直接拿去分流、升级或转人工。2027
工程上的关键取舍在推理方式。官方说推理时先用骨干做一次只读入不生成的前向计算,再并行地对所有合法选项打分,决策步骤是非自回归的,因此没有逐 token 生成的中间文本;训练时冻结骨干,只优化一个路由头和秩为 256 的低秩适配器,并用带标签平滑的交叉熵配合 Brier 损失来校准概率。2 这类描述里,骨干、许可、权重形状与「单次前向即出全部分布」是可以在开源仓库里独立核对的;损失函数与强化学习部分只有官方叙述。21
这个形状为什么值得产品经理关注,看它在系统里的位置就清楚了。官方给的一个例子是客服工单分流:把工单文本和两个问题(该给哪个团队、是否紧急)交给模型,返回的是每个部门的概率与紧急与否的概率,代码据此路由或者升级。27 这类判断在过去要么用规则写、要么用一个通用大模型写一段话再解析;现在它变成一个返回数值的函数,阈值由你自己定。这对高频、短决策、需要审计的场景是结构性的变化。
用户价值
对在系统里做分流的团队,它砍掉的是两件事:一是解析自由文本的成本,二是等待生成的时间。
对要做审计与合规的团队,它留下的是可核查的痕迹:每次判断都带一组概率,你可以在事后回看「当时模型有多大把握」,而不是只能看一句结论。
对要控制成本的团队,它把「判断」这件事的价格单独标出来了:每百万输入 token 0.24 美元与 0.09 美元,且不计输出。22
产品经理如何落地
第一步,把系统里所有「需要判断但不输出内容」的节点列出来。 分流、打标、放行、升级、打分,这五类是最容易迁移的;它们共同的特点是有明确选项、有历史标签、错了有代价但可回退。27
第二步,阈值必须由你自己定,而且要写进文档。 模型只给概率,概率到动作的那一步在调用方的代码里。同一个问题在不同尺寸的模型上会给出差别很大的概率,第三方实测里同一个输入、Clef 与 Clef-flash 给出的概率差异明显,所以阈值的定法应当是先在自己数据上做一次校准,而不是照搬别处的数字。23
第三步,把「概率低时怎么办」设计成一条正常路径。 转人工、改问法、走规则兜底,都是可选动作;如果产品里没有这条路径,概率就白给了。第三方整理的工程建议里有一条值得记住:决策层不能悄悄变成权限层,也就是模型可以建议,但授权动作必须留在你自己的代码里。26
第四步,想清楚你要不要走微调。 官方给出的企业承诺是「不读取、不存储、不训练你的请求与响应」,但这句话后面有一个括号例外:如果你使用他们的微调产品则不适用。2 也就是说,判断数据的复用与模型的定制是绑在一起的商业选择。
可验证指标
- 延迟:官方称这些延迟取自其自行运行的 43 项评测(本节另外提到的「10 项决策基准」与「完整 38 行面板」是规模和范围都不同的另两套口径)。官方给出的中位延迟是 Clef 209.3 毫秒、Clef-flash 38.8 毫秒、Jev 524.1 毫秒,p95 分别是 238.6、122.4、536.0 毫秒;官方换算的「快 2.5 倍与 13 倍」在算术上成立。2
- 延迟口径的反面证据:Cloudflare 自建的榜单页自己标注延迟不在同一硬件上测量、Clef 的分数与延迟均为自报、上游社区榜单未复现;第三方在发布当天经公网接口实测,Clef-flash 中位 191 到 205 毫秒、Clef 中位 524 到 726 毫秒,比官方读数高约 3 到 5 倍。2328
- 完整面板上的强弱分布:在权重页公布的完整 38 行面板(Cloudflare 自己跑的那一次)里,这个家族在分类与路由类任务上领先,而在推理密集型基准上落后——GPQA Diamond 上 Jev 78.3、Clef 48.0,MMLU-Pro 上 Jev 82.7、Clef 65.9,BBH 上 Jev 92.9、Clef 73.7。21
- 竞品自己发布的评测:在 TypeSafe 官方评测站点的四项工作流评测里,Clef 家族赢下三项,输掉的一项是智能体轨迹可观测性(Jev 71.6、Clef-flash 69.8、Clef 68.5);Cloudflare 的博客只写了「赢下三项」,没有写出输的那一项是哪一项。21
- 价格与计费:每百万输入 token 0.24 美元与 0.09 美元,未列输出价;第三方实测返回体里输出 token 为 0。2223
- 校准与阈值的可检查项:模型返回每个选项的概率与置信度,因此可以直接度量「概率区间内的实际正确率」——这是这类模型相对生成式模型最容易被验证的地方。20
风险边界
官方那句「人不必再一直留在判断流程里」需要按条件读。 官方原文的意思是不再需要人对智能体的每一个决策逐条确认,而不是给出可靠性承诺。同赛道的开源实现 Kev-9B 在自己的模型卡里写明:校准后的概率可能带来没有根据的信任,温度是在公开的留出集上拟合的、不会迁移到每个工作负载,使用者应当先在自己的标注样本上测准确率与校准再设阈值;它还明确列出使用禁区——不得用于对人产生法律、医疗、财务或雇佣后果的全自动决策,除非有人工复核。30 另一家竞品 TypeSafe 的官方文档承认了三件事:选项顺序会改变答案,模型偏向排在前面的选项;状态里无关内容越多、准确率越低;状态被当作数据而不是敌意输入,注入式的指令可以移动答案。31
榜单是自评口径。 Cloudflare 自建榜单页自己写明:Clef 与 Clef-flash 的分数由模型作者自己跑、上游社区榜单未复现;榜上其他模型的分数同样出自 Cloudflare 的这次内部运行。上游的决策指数由社区维护,其说明里也写明与 TypeSafe 无关联。2832
官方自己在延迟表里留了一个例外。 官方写过,Clef 家族在延迟上胜过同类决策模型,「唯一的例外是 Laya」——Laya 的中位延迟 5.8 毫秒,快于 Clef-flash。2
图像能力没有基准支撑。 官方称模型带视觉编码器、最多可传四张图,但发布时的评测面板里没有视觉类基准;第三方实测发现图片请求每次需要 13 到 30 秒,且需要把图片压到很小的体积才能避免被判超上下文。223
这个品类现在没有中立裁决。 TypeSafe 选择不公开 Jev 的基准结果,Cloudflare 的跑分是自评,OpenAI 的接口结构还没公开;OpenAI 在 GPT-6.1 Sol 的发布页脚注里还写着,GPT-6 Luna 在「搜索工具损坏」测试中有 28.7% 的案例选择猜测而不是报告工具故障(同一测试里 GPT-6.1 Sol 是 2.1%)。2633
面试可直接说
10 月 1 日 Cloudflare 开源了两款决策模型,Clef 和 Clef-flash,一个 27B、一个 9B,Apache 2.0,托管在 Workers AI,价格是每百万输入 token 0.24 美元和 0.09 美元,没有输出价。它的机制值得记住:你给它一段状态和一组类型化的问题(是非、选择、评分三类),它返回每个合法选项的概率,全程没有自由文本、没有推理 token,推理是非自回归的,所以延迟能在几十到两百毫秒这个量级。我的判断是,这个品类真正的价值不是「更快的模型」,而是把产品里「判断」这一步从生成里拆出来,变成一个可以设阈值、可以事后回看把握程度的部件。要提醒两点:第一,概率到动作的阈值从来不在模型里,在你的代码里,所以先做校准再设阈值;第二,官方博客里那句「人不必再一直留在判断流程里」讲的是不用逐条确认,不是可靠性承诺——同赛道的开源模型卡自己写着校准不会迁移到你的工作负载,还明确禁止用于对人有法律或财务后果的全自动决策。还有,延迟和榜单都是自评口径,上游榜单没有复现,官方博客只挑了 10 项基准,完整面板里推理密集型任务它还是落后的。
面试官追问
- 你要给工单分流设一个概率阈值,怎么证明这个阈值在你的数据上是对的?
- 如果供应商说「这个模型不会幻觉」,你会怎么回他,并用什么指标验证?
- 把判断交给一个概率模型之后,出错时谁负责?你会在产品条款和审计日志里怎么体现?
03 算子迁移:工具链可以换硬件,经验不会跟着走
发生了什么
2026 年 9 月 30 日北京时间 10 时 1 分,DeepSeek 通过官方公众号发布开源公告,对象是面向华为昇腾算力平台的基础设施组件,包括高级语言编译工具、计算库与分布式通信库。官方给出的六项组件是:TileLang 的昇腾版本、负责通用矩阵运算的 DeepGEMM、负责大规模跨设备通信的 DeepEP、负责向量计算与访存算子的 TileKernels、负责稀疏注意力的 FlashMLA、负责数据筛选的 DeepSelect。3 六个仓库在当天都更新了发布说明,DeepGEMM-Ascend、DeepEP-Ascend、TileKernels、FlashMLA、DeepSelect 的说明里都写明昇腾支持是 2026 年 9 月 30 日新增,TileLang 主线也把昇腾 950 后端列为当天的更新。34353637
有一件事必须先纠正,因为它决定了这条新闻该怎么读。TileLang 不是 DeepSeek 开发的编译器。这个项目由北京大学计算机学院的杨智团队主导,2025 年 1 月 20 日在 GitHub 开源;DeepSeek 的角色是使用者,以及昇腾 950 后端的贡献方——TileLang 仓库里昇腾后端的说明文件致谢写明,该后端的初始版本主要由来自 DeepSeek 的开发者完成。3538 因此准确的表述是「DeepSeek 为自己的模型栈贡献了昇腾后端」,而不是「DeepSeek 自研了编译器」。
官方给出的技术说法有四句值得逐字看:所有组件与面向英伟达平台的开源组件一一对应;TileLang 已经承载了 DeepSeek V4 系列模型训练中大部分算子的实现;DeepSeek 训练中用到的每一个 TileLang 算子,在昇腾上都有对应的高性能实现;在多项关键测试用例中,这些组件的计算与通信性能已接近硬件上限。3 华为那侧同步说明,昇腾提供了 Ascend C 接口、PTO 指令集、超节点组网与通信库,双方共同推进基于昇腾 950 的 128 卡超节点方案。4
真正改变工程现实的是接口这一层。TileKernels 的发布说明写的是:这些算子现在带第二套后端,运行时会自动选择,同一套 Python 接口可以同时跑在英伟达 GPU 和华为 NPU 上;DeepGEMM-Ascend 写明与原有的 DeepGEMM 接口完全兼容;DeepEP-Ascend 的缓冲区接口也与英伟达版对齐。363940 换句话说,迁移的成本从「重写算子」变成了「换一个后端」。
需要说清的另一点是,这也不是从零开始。昇腾方向的适配分支更早就存在:tilelang-ascend 分支自 2025 年 9 月 29 日就已开源,并在 2026 年 4 月发布过 DeepSeek V4 的算子。41 这次的变化是把适配并进主线、并把六个方向一次性补齐。
产品机制:迁移成本被拆成了接口、性能、生态三层
这次开源的确定性增量只有一层,另外两层没动。
第一层是接口,它确实被拉平了。同一套 Python 接口、自动选择后端、接口完全兼容——这些是可以在仓库里直接读到的实现事实。3639 对一个要在两种硬件之间做选择的团队,这意味着原型阶段的迁移成本大幅下降:你的上层代码不必重写,先跑通再说。
第二层是性能,它没有被拉平。官方给出的性能数字全部附带条件:DeepGEMM-Ascend 的 BF16 利用率 99.8% 对应的是特定矩阵形状(例如 M4096、N7168、K16384)下的冷缓存测量;FlashMLA 在昇腾上的 prefill 410 TFlops、decode 360 TFlops 分别是硬件极限的 95% 与 83%,而它的融合算子与稠密注意力仍标注为「仅支持 CUDA,不支持昇腾」;DeepEP-Ascend 的带宽数字采自提供给 DeepSeek 的验证用硬件并经过额外人工配置,不是商用版本,商用硬件计划在 2026 年 10 月 15 日前后发布。363740 也就是说,利用率高说明对这块芯片用得省,不等于这块芯片的绝对性能如何。
第三层是生态,它完全不在这次开源里。多年积累的库、开发工具与工程师熟练度不会被一次开源搬走;有第三方分析把这一点总结成一句可以记住的话:开源工具可以搬走操作手册,搬不走熟练度。42
还有一处口径必须分清:开源的是工具链,不是「已经在昇腾上训练大模型」这件事。官方原话只说 V4 系列训练中大部分算子由 TileLang 实现、每个 TileLang 算子在昇腾上都有对应实现;至于训练本身是否已经跑在昇腾上,目前只有华为一侧向媒体表示过部分训练使用了昇腾芯片(这一说法见于第三方对路透报道的转述),DeepSeek 没有在自己的渠道确认过。彭博社 9 月 4 日的报道则称,DeepSeek 在内蒙古乌兰察布约 1 吉瓦的数据中心计划部署至少 16 万颗昇腾 950DT,但现阶段并不打算用这批芯片做训练,且因为产能限制,履约可能超过一年;这些数字均来自匿名信源。4344
最能说明当下处境的,其实是 DeepSeek 自己早前的一句话。在 2026 年 4 月 24 日 V4 系列发布页的价格图注里,官方写着:受限于高端算力,目前 Pro 的服务吞吐十分有限,预计下半年昇腾 950 超节点批量上市后,价格会大幅下调。45 供给不足在这家公司的官方文档里是有据可查的,而这次开源正是冲着那一层去的。
| 组件(官方定位) | 昇腾侧状态 | 明确写出的边界 |
|---|---|---|
| TileLang:高级语言编译工具3 | 昇腾 950 后端 2026-09-30 进入主线,需自行编译开启35 | 项目由北大团队主导,DeepSeek 贡献昇腾后端;不是 DeepSeek 自研38 |
| DeepGEMM:通用矩阵运算3 | DeepGEMM-Ascend 首发,接口与英伟达版完全兼容36 | 99.8% 利用率对应特定矩阵形状的冷缓存测量36 |
| DeepEP:大规模跨设备通信3 | DeepEP-Ascend 发布,缓冲区接口与英伟达版对齐40 | 带宽数字采自非商用的验证硬件并需额外配置;有功能仍在开发中40 |
| TileKernels:向量计算与访存算子3 | 同一套 Python 接口,运行时自动选择后端39 | 昇腾环境只承诺昇腾 950 与 CANN 9.2.0 及以上39 |
| FlashMLA:稀疏注意力算子3 | 昇腾注意力算子 2026-09-30 发布,含 950 与 CANN 9.2.0 以上要求37 | 融合算子与稠密注意力仍标注仅支持 CUDA37 |
| DeepSelect:数据筛选3 | 昇腾版 TopK 算子同日发布46 | 官方未给出与英伟达版的性能对照46 |
用户价值
对采购与架构决策,这次开源提供了一份可以照抄的验收清单:接口兼容了什么、哪些环境版本被承诺、哪些功能还没搬过去。把这三项写进验收清单,比听「替代」这类口号更能判断一条硬件路径现在能不能上生产。
对做成本模型的人,它给出一个新变量:如果同一套上层代码可以换后端,那么供应商谈判时的替换成本下降了,但下降的只是人力重写那一部分,性能磨合与团队熟练度仍然要重新投入。
对关心供给的人,它解释了为什么价格与吞吐会被算力卡住:官方自己在 V4 的价格图注里承认高端算力受限、吞吐有限,并预告昇腾超节点批量上市后价格会下调。45
产品经理如何落地
第一步,把迁移拆成可验收的三栏。 接口栏看兼容性(能不能不改上层代码就跑通),性能栏看条件(在什么矩阵形状、什么环境版本、什么硬件批次下测出来的),功能栏看缺口(哪些算子仍不支持)。这三栏都可以从仓库文档里直接读出来。363739
第三步,把环境版本当作硬约束写进方案。 昇腾侧的承诺是昇腾 950 与 CANN 9.2.0 及以上,这条约束会把排期与兼容性测试的范围一起框进来,而不只是一次驱动升级。39
可验证指标
- 组件与仓库:六个方向同批开源,仓库发布说明的时间戳均为 2026-09-30。34353637394046
- 接口兼容性:同一套 Python 接口在两种硬件上自动选择后端;矩阵运算库接口完全兼容;通信库缓冲区接口对齐。363940
- 官方自报的利用率:BF16 99.8%、FP8 与 FP8×FP4 99.5%、FP4 98.3%,对应特定矩阵形状的冷缓存测量。36
- 官方自报的注意力性能:昇腾上 prefill 410 TFlops(约为硬件极限的 95%)、decode 360 TFlops(约 83%),前提是昇腾 950。37
- 官方自报的通信带宽:跨设备通信在 EP8 下 dispatch 373 至 375 GB/s、combine 345 至 347 GB/s;EP128 下降到 313 至 320 与 272 至 278 GB/s。40
- 明确的缺口:融合算子与稠密注意力仍不支持昇腾;环境仅承诺昇腾 950 与 CANN 9.2.0 以上;通信库有若干功能标注为开发中。373940
- 供给侧的公开数字:官方 V4 价格图注承认高端算力受限、Pro 吞吐有限;媒体报道称其计划部署至少 16 万颗昇腾 950DT、但现阶段不用作训练,数字来自匿名信源。4445
风险边界
性能数字全部是厂商自报,且附硬条件。 99.8% 的利用率对应特定矩阵形状的冷缓存测量;通信带宽采自非商用的验证硬件并经过额外人工配置;华为一侧的推理数据是离线、不含服务调度与框架负载均衡的结果。截至发布时,没有任何非 DeepSeek、非华为的团队按仓库说明复现过这些数字。43640
「接近硬件上限」不等于「绝对性能领先」。 前者说明对这块芯片的利用效率高,后者要跟别的芯片比绝对算力——这次开源没有任何一方的绝对性能对照,第三方分析也明确提示不要把利用率读数当成跨芯片的比较。42
「替代 CUDA」是媒体加工,不是官方措辞。 官方原文只写「一一对应」;此外有中文分析称「官方承认不能复制 CUDA 的完整广度」,但在官方公众号原文、V4 发布页与六个仓库说明里都找不到这句话,它只能作为第三方观点引用。342
接口复用不等于性能可迁移。 有媒体在当天的分析里指出,接口能够复用,性能仍需要针对硬件重新打磨,而且这份公告没有披露 V4 是否已在昇腾上完成全流程的大规模训练。47
同批组件里有一个还没补齐的大项。 注意力部分的融合算子与稠密注意力仍标注为仅支持 CUDA,这意味着长上下文推理里最吃性能的一段,在昇腾上还没有走完。37
面试可直接说
9 月 30 日 DeepSeek 开源了六项面向华为昇腾的基础设施组件:TileLang 的昇腾后端、矩阵运算、跨设备通信、向量与访存算子、稀疏注意力、数据筛选,六个仓库当天都标了 2026-09-30,官方说它们与英伟达侧的组件一一对应。先说一个容易写错的点:TileLang 不是 DeepSeek 开发的,它由北京大学一个团队主导、2025 年 1 月开源,DeepSeek 是采用者并贡献了昇腾 950 后端。这件事真正的变化在接口层——同一套 Python 接口、自动选择后端、矩阵运算库接口完全兼容,迁移成本从重写算子降到换后端。但另外两层没变:性能层只承诺昇腾 950 加 CANN 9.2.0 以上,融合注意力算子仍写着仅支持 CUDA;生态层的库、工具和工程师熟练度完全没被搬走。还有一个口径要小心:所有漂亮数字都是厂商自报,99.8% 的利用率对应特定矩阵形状,通信带宽采自非商用的验证硬件,到现在没有任何第三方复现。至于「用昇腾训练大模型」,那是华为向媒体说的,DeepSeek 自己没有确认,彭博社还说这批芯片现阶段不用于训练。我的判断是,这次开源的确定增量是「上层代码不用重写」,不确定的是商用硬件上的真实性能。
面试官追问
- 供应商说「同一套代码换个后端就能跑」,你会把哪些项写进验收清单,才会同意切一部分流量过去?
- 一个利用率数字是 99.8%,你要问清哪些前提,才能判断它对你的负载有没有参考价值?
- 如果要给团队排一条国产算力的迁移计划,你会先迁推理还是先迁训练,为什么?
把三条串起来:三个默认假设被同时改写
三件事分别落在模型侧、系统侧和底座侧,改掉的都是默认值。
模型侧被改掉的是「一次回答能有多长」这个默认值:一次请求对应一次产出,这个假设支撑了计价、验收和重试的设计;当供应商把输出上限推到 100 万 token、而第三方看到的实现是跨请求续写时,任务就成了计量单位,断点、中间产物和每任务成本一起变成设计对象。这条的缺口在证据上:官方数字是自报,促销没有结束日期,而同一批基准里它在 Harvey 的完整榜上只排第五。11116
系统侧被改掉的是「判断由谁做出」这个默认值。过去要模型做判断,得让它写一段话,再把这段话解析回结构化字段;决策模型把这一步变成「输入状态加类型化问题、输出每个选项的概率」,接口本身对代码友好。这条的缺口在责任上:概率到动作的阈值由使用者确定,而同类模型的官方文档自己承认校准不会迁移到每个负载、选项顺序会改变答案、注入内容可以移动判断。23031
底座侧被改掉的是「代码跑在谁的芯片上」这笔账的算法。当两套硬件共用一套 Python 接口、只是运行时换后端,硬件选择就从一次大改造变成一次可逆的配置。这条的缺口在验证上:所有性能数字都带条件、且没有第三方复现,训练端还停在单方说法,而注意力部分最吃性能的算子仍标注仅支持 CUDA。373940
引用这三条时,证据的分量可以按三层分开。可以直接用的是结构类事实:输出上限从 64K 提到 100 万 token、促销价与标准价、开放顺序与授权范围、决策模型的三种问题类型与每百万输入 token 单价、六个组件与英伟达侧一一对应、同一套 Python 接口自动选后端。这些在一手页面上都能查到原文。135222739
References
- 1
- 2
- 3DeepSeek 开源昇腾基础组件,DeepSeek 官方公众号
mp.weixin.qq.com
- 4DeepSeek官方开源昇腾基础组件,与昇腾共建高效易用的AI芯片软件生态,华为计算
mp.weixin.qq.com
- 5Fairwind Program,Google DeepMind
deepmind.google
- 6Gemini API 模型列表,Google
ai.google.dev
- 7
- 8GPT-6 Astra,OpenAI
developers.openai.com
- 9Claude Opus 5.5 overview,Anthropic
platform.claude.com
- 10Securing the future of AI agents,Google DeepMind
deepmind.google
- 11Gemini 4 Argon: Google rejoins the top three labs,Artificial Analysis
artificialanalysis.ai
- 12Gemini 4 Argon,Vals AI
vals.ai
- 13CWE-bench leaderboard,Collinear AI
cwe-bench.com
- 14Vals Index,Vals AI
vals.ai
- 15AutomationBench leaderboard,Zapier
zapier.com
- 16
- 17Gemini 4 Argon model evaluation methodology,Google DeepMind
deepmind.google
- 18
- 19
- 20Clef 模型页,Cloudflare Workers AI
developers.cloudflare.com
- 21Cloudflare/clef,Hugging Face
huggingface.co
- 22Workers AI 计价,Cloudflare
developers.cloudflare.com
- 23
- 24
- 25DevDay 2026 Recap,OpenAI
openai.com
- 26
- 27Introducing Clef: Cloudflare's first open-source decision models, now on Workers AI,Cloudflare
developers.cloudflare.com
- 28Decision Model Leaderboard,Cloudflare
clef-evals.workers-ai-mle.workers.dev
- 29
- 30kev-9b model card,Hugging Face
huggingface.co
- 31Jev 1.13 model jaggedness,TypeSafe AI
docs.typesafe.ai
- 32jev-decision-index README,Hugging Face
huggingface.co
- 33Introducing GPT-6.1 Sol,OpenAI
openai.com
- 34deepseek-ai,GitHub
github.com
- 35tile-ai/tilelang,GitHub
github.com
- 36deepseek-ai/DeepGEMM-Ascend,GitHub
github.com
- 37deepseek-ai/FlashMLA,GitHub
github.com
- 38TileLang Ascend README,GitHub
github.com
- 39deepseek-ai/TileKernels,GitHub
github.com
- 40deepseek-ai/DeepEP-Ascend,GitHub
github.com
- 41tile-ai/tilelang-ascend,GitHub
github.com
- 42如何看待 DeepSeek 开源面向华为昇腾的全套基础设施组件,知乎(第三方分析)
zhuanlan.zhihu.com
- 43DeepSeek V4适配昇腾:黄仁勋最担心的“去英伟达化”走到哪一步?,MIT科技评论中文站
mittrchina.com
- 44
- 45DeepSeek-V4 系列发布,DeepSeek
api-docs.deepseek.com
- 46deepseek-ai/DeepSelect,GitHub
github.com
- 47DeepSeek加速向华为靠拢,36氪
36kr.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.