Karpathy 给 Jev 定了个坐标:被冷落的那一档,和隔天的半价
Karpathy 把 TypeSafe AI 的 Jev 读成成本—智能曲线上的一个坐标,说那一段有大量被压抑的需求;本期核对这条判断的证据、它查不到的部分,以及隔天 OpenAI 在同一档位上的半价。

北京时间 9 月 22 日凌晨 3 点 55 分,Andrej Karpathy 在 X 上回复了 Will Depue 的一条帖,回复全文只有一句:1
I see it as a point on the LLM pareto optimal curve in a regime that had a large revealed latent demand (no thinking, single token, low latency acceptable intelligence) that was under-invested into because of a race to higher intelligence.
直译:我把它看成 LLM 帕累托最优曲线上的一点,处在一个曾存在大量「被揭示的潜在需求」的区域——不思考、单 token、低延迟、可接受的智能——而它之所以投资不足,是因为大家都在竞赛追求更高的智能。
Depue 曾在 OpenAI 参与 Sora 与 o3、o4 的后训练。他当天凌晨发的帖讲的是一个叫 Jev 的东西:反响让他意外,回头看又觉得合理,「它当然只是个分类器,可它是带前沿级智能的零样本分类器。我惊讶之前没人做过。」2
Jev 是旧金山一家叫 TypeSafe AI 的公司在 9 月 15 日开放早访问的模型。3 发布帖在北京时间 9 月 16 日凌晨发出,4 到 Karpathy 回帖时刚过六天,早访问的等待名单则在不到一天前放完。5
说这句话的人需要交代一句。Karpathy 是 OpenAI 创始成员、特斯拉前 AI 负责人,2026 年 5 月 19 日公开说自己加入了 Anthropic,6 7 月 26 日否认过离职传言,7 此后没有新的说明。他评价的是别人家的产品。
这句话把 Jev 从一个新产品的热度,翻译成一条曲线上的一个坐标:它落在一段需求很大、却长期没人认真做的地方。
要读懂这个坐标,先得知道 Jev 是什么。
01 一个不生成文字的模型
TypeSafe AI 由 Diogo Almeida 创办。Almeida 在 OpenAI 参与的是让语言模型学会遵循指令、学会对话的那套方法,他自己的说法是这项工作后来成了 ChatGPT 背后的研究。4 公司在 9 月 15 日结束隐身状态,同期宣布的是一轮种子轮:转载通稿写金额约 4,000 万美元、由风投机构 DCVC 领投,数据库 Dealroom 记的却是 2,590 万美元。两个数字差近一半,本文只取其中能站住的一层——这是一家有机构投资的创业公司。89
Jev 的形态,用厂商自己的话说是一个「System One 模型」:只接受文本输入,不生成任何文字,返回的是类型受约束的答案和概率。10 调用方式是给它一个
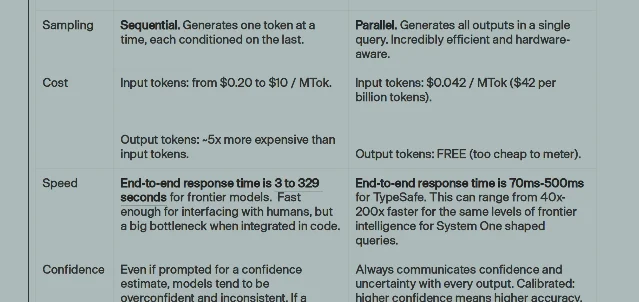
state(一段文本或一组键值对),加一批问题,每个问题属于三种原语之一:Choice(从给定选项里选一个)、Score(按你给的档位打分)、Noul(一个陈述为真的概率,取自伯努利分布)。11四个数字最要紧。输入按每 100 万 token 收 0.042 美元,输出不收费;端到端响应时间厂商写的是 70 到 500 毫秒;单次请求上下文上限 6.4 万 token;限速标注为「动态调整」,可随时变化。12
它的名字来自杰文斯悖论。这个悖论说的是,蒸汽机效率提高、单位煤耗下降之后,全社会烧掉的煤反而更多——后来被用来指「成本下降带来更大总需求」这一类现象。官方 FAQ 把它写成了产品逻辑:「智能的成本每下降一个数量级,就解锁多一个数量级的使用场景。」3
上线那一周的规模,能从几个侧面核到。Almeida 的发布帖到 9 月 23 日早上有 3,925 万次浏览、7.55 万个赞、8,162 次转发;4 技术媒体 Latent Space 在当日的汇总里记下,Jev 那一整天都挂在 Hacker News 首页,而当天同场发布的还有 Google 的 Gemini 3.8 Live 与 Periodic Labs 的新模型。13
平台侧的两个数字比浏览量硬。支付与路由平台 Vercel 在 9 月 19 日说,Jev 是 AI Gateway 历史上被采用最快的模型:上线首日覆盖约 13% 的团队,Anthropic 的 Fable 5.1 的 6 倍、GPT-5.6 系列的 2 倍——三个数字口径相同,都是首日使用过该模型的团队占比。14 模型路由平台 OpenRouter 用自家评测跑了它一轮,结论是比第二快的模型还快 5 倍以上,成本排在第二低,只比通义千问系列的 Qwen3.8 Flash 贵。15
两条都来自平台自己的观测:Vercel 报的是它平台上的团队占比,OpenRouter 报的是自家评测里的相对速度与实付成本,任务与分母都不一样。
厂商也写明,他们自己搭的那套以四个业务流程为样本的评测「不是随机挑选、也不在训练分布里」,同时提醒它「由团队里做模型能力的人构造,可能存在偏差」。3
02 「不思考、单 token、低延迟、可接受的智能」
这句话的括号里塞了四个条件。把四个条件拆开、逐条对着 Jev 的规格表读,能看清 Karpathy 说的是哪一种模型。
第一个条件:不思考。 官方文档的原话是,System One 模型「不写回复、不产出代码、也不生成对自己推理的解释」。10 它没有思维链,也没有思考档位可调。开发者的用法是把一个判断拆成若干原子问题,各自取一个概率,再在代码里合成结论。
第二个条件:单 token。 这个说法来自外部视角,厂商的措辞是另一套:对照表里,既有 LLM 一栏写的是「顺序采样,一次一个 token,每个都依赖上一个」,Jev 一栏写的是「并行采样,一次调用生成所有输出」。3 Jev 输出的本来就不是 token 序列。这一点在社区里被反过来验证过:有人做出一个「糟糕的聊天模型」,办法是在外层写循环,每轮只问 Jev 一个问题——给定问题和已写出的回复,下一个符号是什么。16 独立研究者用一千多次探针测出的架构描述也指向同一件事:一次前向,读出概率,不做生成。17
第三个条件:低延迟。 厂商自报 70 到 500 毫秒,并且承认自家评测「通常是在美西的笔记本上跑的」。3 到发稿为止,没有任何第三方给出过毫秒级的独立复测;OpenRouter 给的是相对倍数,不是绝对数字;15 第三方榜单 JevBench 的速度分里含一个「自托管端点按延迟乘二再加 0.15 秒」的假设换算,该站自己在脚注里写明这是假设而非测量。18
第四个条件:可接受的智能。 参照物在官方评测里写得清楚:他们拿 GPT-6 Astra 与 Claude Fable 5.1 这两个被官方称为最大、最强也最贵的外部模型,在同一批工作流上的平均答案当参考答案,比较各模型的答案与这个平均值的距离。3 厂商的原话是,Jev「在这些任务上与既有 LLM 达到相近的智能水平,同时快两个数量级、便宜两个数量级」;对照演示里,他们挑的同档参照是 GPT-5.6 Terra,理由是「平均来看智能最可比」。3
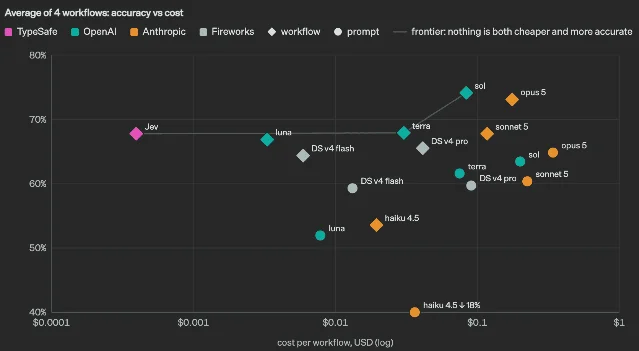
发布博文的日期是 9 月 15 日,图里 OpenAI 那一档的代表还是 GPT-5.6 的 sol、terra、luna。北京时间 9 月 23 日凌晨,OpenAI 用 GPT-6 的 Sol 和 Luna 把这一档重画了一遍。
后面几节里说的「这一档」,指的就是 Jev 所在的这一段:不生成文字、按每次判断计费、延迟以毫秒计、智能对标中档模型。
03 「被揭示的潜在需求」:查得到的和查不到的
需求这一半,方向上有多条互相独立的证据。
最直接的一条是供给端自己撑不住:TypeSafe 在 9 月 22 日 14 点 19 分宣布暂停新注册,理由是需求太大;19 创始人当天转述得更像人话——「满了,服务完全溢出来了」。20 在那之前,9 月 21 日北京时间的傍晚,它的 API 与控制台还出过一次故障,从 16 点 30 分持续到 17 点 53 分。21
第二条是平台侧看到的新面孔。OpenRouter 在 9 月 22 日说,在它平台上用 Jev 的人里有近一半,前一周没有用过它平台上的任何一个模型。22 媒体侧对同一现象的转述方向一致:TechCrunch 的报道写,这家公司「因为需求过高,一度失去通过 API 服务用户的能力」。23
「多少」这一层是空的。官方从始至终没有公布过任何一个绝对数字:没有调用量,没有用户数,没有付费转化,没有排队人数。第三方也没有补上——Artificial Analysis 的模型总览页里,到发稿时没有 Jev 或 TypeSafe 的任何条目。24
方向上有两条互相独立的观测——厂商自己的供给告急,和平台侧的新用户画像——指向同一件事;量级上一条证据都没有。拿这条判断去给一个市场估尺寸,现在只能靠猜。
价格能撑多久,厂商自己也没有答案。发布博文里主动写着:我们没法证明这个价格没有补贴,只能靠长期来证明它可持续。3
04 「因为大家都在竞赛更高智能」:这一半的证据
后半句把成因归给了行业的注意力分配。这一半最容易被读成一句漂亮话,值得单独核。
Karpathy 本人给过同一件事的解释。他 4 月 30 日那篇 Sequoia Ascent 2026 的总结里写,LLM 能力的「锯齿状」不只和某个领域的可验证性有关,还和经济学有关,因为「营收/TAM 决定了前沿实验室在强化学习期间选择把什么打包进训练数据分布」。25 他 4 月 9 日那条帖说得更直白:一些用例「没有被各公司在爬山过程中充分优先化,因为它们带来的钱没那么多。金矿在别处,注意力就跟着走」。26
与这个归因同时存在的,是另一组事实:Jev 出现的前后,这一档并不是无人投资。智谱 8 月 26 日发布 GLM-5.3-Flash,3200 亿总参数、激活 180 亿,官方说性能超过上一代而价格只有十分之一;27 Google 9 月 2 日发布 Gemini 3.8 Flash,六周内的第三个 Flash,「上市价与 3.7 Flash 相同」,每百万 token 0.75 美元输入、3.75 美元输出;28 Inception 9 月 8 日发布扩散语言模型 Mercury 2.5,标价每百万输入 0.20 美元,宣称每秒 1,107 token。29
这些模型有一个共同点:都是生成式 LLM 的便宜版本。Jev 让出的东西是字符串输出本身。照这个读法,Karpathy 说的「投资不足」落在形态上:便宜模型一直有人造,没人认真造的是一个不生成文字的。 他 2025 年 6 月描述过更极端的一版:一个几十亿参数的「认知内核」常驻在每台电脑上,用 Matryoshka 结构在测试时把能力上下调,靠超低交互延迟弥补知识量上的欠缺。30
需求的形状也确实在往便宜一侧偏。支付与费用管理平台 Ramp 的 9 月 AI 指数给出三个读数:有效单价从 3 月峰值每百万 token 1.15 美元降到 9 月 9 日的 0.68 美元,降幅 41%;前沿模型拿到的 token 份额是 45%,低于 8 月 53% 的峰值;排名前 1% 的企业,每员工月度 AI 支出从 7,976 美元降到 7,205 美元。这三个数的样本,是它平台上 7 万多家美国企业的支付记录。31 OpenRouter 的 token 榜前十名里,当期没有一个是前沿档模型。32
Ramp 在同一页写了这份数据的边界:它来自使用其 token 支出管理产品的企业,代表不了整个市场;OpenRouter 也在榜单页声明,这些排名描述的是经由它路由的流量,不是整个市场。到发稿时,也没有任何一家机构用「便宜档的增长快于前沿档」这句话做过正式表述——能查到的是份额与价格的走向,不是一句结论。
05 隔了一天,OpenAI 把中档砍了一半
北京时间 9 月 23 日凌晨 2 点 12 分,OpenAI 在 X 上发布 GPT-6 Sol 与 GPT-6 Luna。33 官网的定位句把这两款模型放进了同一套词汇:它们「通过在成本效率上推进前沿」,帮助把 GPT-6 的能力分发出去;GPT-6 系列「在成本—智能曲线上处于领先」。34
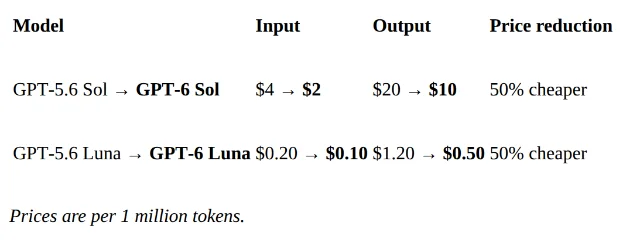
价格表是这样写的:Sol 的输入价从每百万 token 4 美元降到 2 美元,输出从 20 美元降到 10 美元;Luna 的输入从 0.20 美元降到 0.10 美元,输出从 1.20 美元降到 0.50 美元。官方给这两行的降价幅度都标了「便宜 50%」。34
Sam Altman 在同一天凌晨连发三条,把计价单位从每 token 换到每次任务。第一条说这两款模型「每 token 价格减半,每任务价格更低」;35 第二条说,「按每任务定价来比——这才是真正该看的指标——我认为市场上没有任何能竞争的东西」,并补了一句「我们希望人们能用海量的 AI」;36 第三条说,希望 OpenAI 的 API「在每一个价位上都有最好的模型」。37
两处口径需要留在这里。第一,这个 50% 的分母是促销价,不是标价:官方价目页写明,被拿来对比的 GPT-5.6 Sol 促销价「至少持续到 2026 年 11 月 21 日」。38 第二,同一批材料里给出的省成本手段不止降价:缓存读取的折扣在一处写「90%」,另一处写「最多 90%」,并附了两个限制——只限符合条件、可共享的前缀,且须在 30 分钟窗口内被重复使用;GitHub 报告说,过去几个月里「需要新处理的提示词 token 占比」下降了 50% 以上。3439
Jev 给这一档换了一个形状,OpenAI 给同一个形状换了一个价格。两条路都指向同一段曲线,一家要重新定义模型该输出什么,另一家只要继续把旧形状做便宜。
06 同一档位上的其他答案
把当期各家公开的价目摆在一起,这一档的价格带是能画出来的。
| 模型(厂牌) | 输入 / 输出(每 100 万 token) | 延迟或吞吐 | 口径 |
|---|---|---|---|
| Jev 1.13.0(TypeSafe AI) | $0.042 / 免费 | 厂商自报端到端 70–500 毫秒,无第三方毫秒级复测 | 厂商定价与自报 12 |
| Gemini 2.5 Flash-Lite(Google 当期最便宜的一档) | $0.10 / $0.40 | 首字 0.30 秒,为第三方记录里最快的一档 | 官方价目;延迟为第三方实测 40 |
| GPT-6 Luna(OpenAI) | $0.10 / $0.50 | 首字 0.76 秒(OpenRouter 上最快的供应商) | 官方价目;延迟为平台实测 41 |
| GLM-5.3-Flash(智谱) | $0.15 / $0.50 | 每秒 64 token | 第三方价目与实测 42 |
| Claude Haiku 4.5(Anthropic) | $1 / $5 | 未公布 | 官方定价页 43 |
| GPT-6 Sol(OpenAI) | $2 / $10 | 首字 1.47 秒(OpenRouter 上最快的供应商) | 官方价目;延迟为平台实测 44 |
四条路线,互不兼容。
一条是换形状。 TypeSafe 的赌注是,生产系统里大量的 LLM 调用本质上是分类,而行业一直在为分类付生成的钱。
一条是同形状降价。 OpenAI 的答案。把它和 Ramp 的数据放在一起看:行业有效单价在往下走,前沿档份额已经回落,对一家前沿实验室来说,把中档做到半价既能守住份额,又不损失前沿档。
一条是把便宜档直接做成旗舰。 智谱走得最前。清华大学的唐杰(@jietang,智谱 z.ai 的创始人)8 月 27 日说,Ox Alpha 就是 GLM-5.3 Flash——Ox Alpha 是这款模型上线前在 OpenRouter 与 OpenCode 上匿名测试时用的名字——Artificial Analysis 指数 57,「前沿价的百分之一」,在 OpenRouter 上拿到近 20% 的周 token 份额、排名第一。2745 这一说法有一处口径差异:Artificial Analysis 当前页面给 GLM-5.3-Flash 的是 42 分、每任务 0.25 美元,指数版本是 v4.3.2,与官方引用的 v4.1.1 不是同一版。42 唐杰 8 月 19 日的长帖给了这套打法的理论版本:「推理主导了全生命周期成本。把推理放进目标函数,最优点就会移向被训练得更久的小模型。」46 Google 走同一条线但节奏更快:Gemini 3.8 Flash 的上市价与上一代相同,官方脚注写明这个价格到 2026 年 12 月 31 日结束,2027 年 1 月 1 日起翻倍。28 Demis Hassabis 8 月 13 日介绍 3.7 Flash 时强调过同一件事:「上市价是 3.6 Flash 原价的一半。」47
一条是反方向。 Anthropic 在这一档上的公开动作最少:Haiku 4.5 的定位是「最快、最具成本效率的模型」,价格 1 美元输入、5 美元输出,比 Luna 贵十倍。43 而在 9 月 12 日,Anthropic 联合创始人兼 CEO Dario Amodei 那篇《We Must Pace the Frontier》给出的方向是给能力进展减速,文中把「由商业激励推动的逐底竞争」列为加剧风险的原因之一。48
四条路线的分歧不在价格,在问题定义。 换形状的一派认为行业优化错了目标;降价的一派认为目标没错、只要更便宜;把便宜档做成旗舰的一派认为便宜本身就是能力;减速的一派认为真正的变量是速度,不是单价。
07 这条档位的三处不利
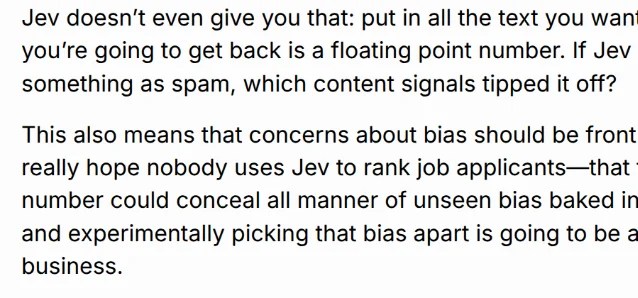
第一处是黑箱。 第三方评述里最不客气的一段来自 Simon Willison,他写 Jev「代表了一次朝着黑箱机器学习系统更深的倒退」:把任意文本放进去,换回来的只是一个浮点数,如果它把某样东西判成垃圾邮件,没有任何办法知道是哪个信号触发的。他还做了一次实验,让 Jev 给湾区城市按「是不是好城市」打分,库比蒂诺排第一,东帕洛阿尔托排最后;他没有给出解释,只写了一句「嗯」。16
第二处是能力天花板,而且厂商自己列了清单。 TypeSafe 的文档里有一页「已知缺陷」,最后修订日期 2026 年 9 月 17 日,列了九类失败模式:字面理解、计数与数学、日期比较、多层间接、无关细节过多的长输入、对抗性内容、互相矛盾的指令、常识性结构不变量,以及生成本身。49 第三方的实测也不是一面倒:招聘技术公司 Bryo 的 CTO 说,在他测的 1,565 封德英商务邮件上,Gemini 略准一些,而 Jev 在同等任务上便宜 10 到 20 倍;50 另一位开发者用 O*NET 岗位分类测出 Jev 80.5%、Luna 84.9%,延迟 200 毫秒对 2 秒,成本 122 美元对 482 美元(每百万条记录的判断成本)。51
代价转移到开发者身上,是这一档的另一面。模型不给理由,也不生成字符串,所有需要多步推导的判断都要自己拆成原子问题、在代码里合成——官方文档的建议就是「算术留在代码里」。49
第三处是价格和竞争。 厂商自己承认没法证明价格没有补贴,并预期价格会继续下降。3 与此同时,前沿实验室有能力把这一档直接吸收掉:OpenAI 在半价之外还加了缓存折扣与推理优化。3439 更根本的一层是,Jev 的架构、权重、技术论文都没有公开,外部只能猜它建在什么之上。23
三处不利指向同一个问题:这一档的护城河不在模型本身,而在校准与工程。 Willison 那句提醒也落在这里——正因为便宜,跑成百上千次实验只要几美分,评估本身反倒成了必须做的那件事。16
08 接下来看什么
一、独立的校准审计。 这个产品的全部主张建立在概率可信上,而外界至今没有一份基于人工标注、分布外数据的可靠性曲线。18
二、前沿实验室会不会推出同形态的端点。 日志概率、提示缓存、结构化输出这三样凑齐,任何一家大厂都离端点不远;同类端点一旦出现,这条路线就从一家创业公司的形态变成行业的一个常规选项。15
三、谁先给出绝对用量。 这一档目前只有份额与相对倍数,没有调用量、用户数或收入;任何一方先给出绝对数字,这条判断就能从方向变成量级。24
四、注册窗口什么时候重开、什么时候开始真的收钱。 暂停新注册发生在 9 月 22 日 14 点 19 分,19 官方对恢复时间只写了「尽快」。
五、有效单价的走向。 Ramp 的有效单价与前沿档份额是同一件事的两面:单价继续下行而前沿档份额不再回升,说明便宜的一档确实在吃掉增量。31
Karpathy 那句话是可以被检验的,检验它的不是转发数,是这一档的绝对用量什么时候第一次公布。在那之前,TypeSafe 的注册窗口还关着。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10System One 概念页(TypeSafe AI 官方文档)
docs.typesafe.ai
- 11Introduction(TypeSafe AI 官方文档)
docs.typesafe.ai
- 12Models(TypeSafe AI 官方文档)
docs.typesafe.ai
- 13
- 14
- 15
- 16
- 17Jev's Architecture Unmasked(Archer Hume,2026-09-17)
archerhume.com
- 18JevBench v1.3.0(Benchmark Heaven)
benchmarkheaven.com
- 19
- 20
- 21
- 22
- 23
- 24Artificial Analysis 模型总览页(抓取于北京时间 2026-09-23 07:41)
artificialanalysis.ai
- 25Sequoia Ascent 2026 summary(Andrej Karpathy 博客,2026-04-30)
karpathy.bearblog.dev
- 26
- 27
- 28
- 29Introducing Mercury 2.5(Inception Labs 官方博客,2026-09-08)
inceptionlabs.ai
- 30
- 31
- 32OpenRouter Rankings(数据截至 2026-09-21)
openrouter.ai
- 33
- 34
- 35
- 36
- 37
- 38API 定价(OpenAI 官方文档,抓取于北京时间 2026-09-23 07:40)
developers.openai.com
- 39
- 40Gemini API 定价(Google 官方文档)
ai.google.dev
- 41Models: GPT-6 Luna(OpenRouter 模型页)
openrouter.ai
- 42GLM 5.3 Flash(Artificial Analysis 模型页)
artificialanalysis.ai
- 43Claude 定价(Anthropic 官方定价页)
anthropic.com
- 44Models: GPT-6 Sol(OpenRouter 模型页)
openrouter.ai
- 45
- 46
- 47
- 48We Must Pace the Frontier(Dario Amodei,2026-09-12)
darioamodei.com
- 49Jev 1.13 jaggedness(TypeSafe AI 官方文档,最后修订 2026-09-17)
docs.typesafe.ai
- 50
- 51
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.