从 Cloudflare OS 到「可执行岗位」:AI 原生组织正在重写什么
用 Cloudflare 的内部平台案例,以及 X 和 YouTube 上关于共享上下文、可执行岗位与自我改进回路的讨论,分清 AI 原生组织已经落地的做法与仍停留在提案阶段的想法。
截至 2026 年 8 月 7 日 17:00,关于「AI 原生组织」的最新讨论,已经从「给员工配一个聊天机器人」移向三个更硬的问题:公司的知识怎样被记录,Agent 能做什么,谁对结果负责。
本期把 8 月 1 日至 8 月 7 日 17:00(Asia/Shanghai)内能核验发布时间的公开内容,和一条有独立参考价值的 5 月演讲分开处理。当前窗口里,能落到具体组织实践的材料主要来自 X 与 Cloudflare 官方博客;YouTube 的材料作为背景,Instagram 没有足够明确、且不带明显营销导向的同期内容进入正文。
先看四条线索
| 来源 | 核心说法 | 证据边界 |
|---|---|---|
| Cloudflare OS,8 月 5 日 | 用统一的上下文、技能文件和权限系统,把 AI 接入工程与非工程工作 | 有内部平台与使用数据,但数据来自 Cloudflare 自述 |
| Replit 工程团队成员 Niall O'Higgins,8 月 7 日 | 产品面可以很大,工程团队却可以很小 | 个人观察,没有披露团队规模与对照口径 |
| Nessie,8 月 7 日 | AI 原生公司需要共享上下文层,让每次 Agent 会话能被团队复用 | 创业团队的产品论点,不是独立验证过的行业结论 |
| Reginald M,8 月 7 日 | Agentic organization 里的岗位可以写成可执行规范 | 概念提案,没有给出落地案例 |
这些材料并没有证明「AI 原生组织」已经有一套统一模板。它们更像同一组问题的不同切面:知识要不要留下,权限能不能继承,岗位能不能被机器执行,人的责任边界是否还清楚。
1. Cloudflare:先做组织的上下文层,再谈 Agent 数量
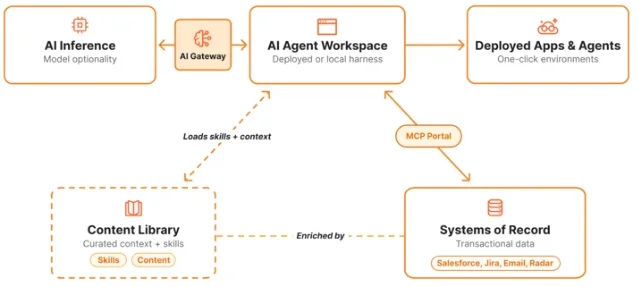
Cloudflare 的案例目前最接近「已经在公司内部运行的 AI 原生组织基础设施」。其官方文章介绍了 Cloudflare OS:工程团队通过 Engineering Codex 获得代码、设计和事故复盘所需的上下文;非工程团队则把常见工作先沉淀成 skills、context files 和 workflow,再交给 Agent 执行。Cloudflare 称,已有数千名员工每周使用这套平台,用户已经创建超过 4,000 个 apps 和 tools;销售团队在一个月内节省了超过 10,000 小时。这些数字是公司自报,不能直接当成外部审计结果。1
这套做法里,真正值得抄的不是界面,而是「工作如何被拆开」:
- 组织知识进入一个可复用的内容库,形式包括 skill 和 context,而不是散落在某个人的聊天记录里。
- Agent 通过 MCP Portal 连接系统记录;AI Gateway、DLP 规则和 gatekeeper 服务负责过滤、记录与范围控制。
- Agent 的权限不能超过使用者本人的权限。共享一个 Agent 时,接收者看到的仍应是自己的权限,而不是创建者的权限。
- 最终输出由人负责。Cloudflare 把这条原则写成「human owns the output」。1
X 上,TiDB 作者唐文斌把这篇文章转成了一个更尖锐的问题:当 Agent 数量超过员工数量,公司需要怎样管理它们的身份、运行环境、状态、记忆、文件、权限和可观测性?这是他的延伸判断,不是 Cloudflare 宣布的新产品路线,但它准确指出了组织设计的缺口:Agent 不是多开几个聊天窗口,而是新增了一类需要被授权、审计和回收的工作主体。2
2. X 上的三个提案:小团队、共享上下文、可执行岗位
小团队不等于小系统
Replit 的应用安全与基础设施工程师 Niall O'Higgins 写道,Replit 的工程团队规模「相较于其他公司只占很小一部分」,但产品面很大;他把这种杠杆归因于「self-driving AI-native company」。这条帖子没有提供具体人数、收入或产品数量,因此它不能单独证明 Replit 的组织效率,只能作为一名内部工程人员对工作方式的现场观察。3
它和 Cloudflare 的案例放在一起看,差异很清楚:Cloudflare 展示的是平台与治理,Replit 员工描述的是产出感受。前者能回答「系统怎么接入」,后者只能提示「团队可能变小」;中间还缺着成本、质量、维护和业务结果。
共享上下文可能比共享提示词更重要
Nessie 在 X 上提出,AI 原生公司需要一个由 AI 对话和 Agent 会话构成的共享上下文层,让一次工作留下的知识能被下一个人和 Agent 复用。因为 Nessie 本身就在做这类产品,这段话应读作产品团队的立场,而不是中立研究结论。4
这个提案和 Cloudflare 的内容库有一个共同点:组织资产不再只是最终文档,也包括完成任务时形成的过程、判断和约束。若这些东西不留痕,下一次 Agent 只能重新猜;若它们留痕但没有权限边界,复用又会变成越权传播。
岗位描述可能变成机器可执行的规范
Reginald M 的表述更激进:在 agentic organization 里,岗位是 executable specification,Markdown 文件就是助手或 Agent 执行的「工作」,新增一个岗位就等于新增一个数字员工。5
目前没有足够证据证明这种组织图已经普遍存在。它的价值在于把一个模糊词变成了可检查的对象:如果一个岗位真的能被执行,就应该能写清楚输入、权限、工具、验收标准、升级条件和责任人。缺一项,所谓「岗位」很可能只是换了名字的提示词。
3. 背景回看:YC 把公司想成一组自我改进的回路
5 月 21 日,Y Combinator 合伙人 Tom Blomfield 在演讲中提出,AI 原生公司不应只是把 AI 加到原有流程旁边,而应把每项工作做成能持续吸收反馈的闭环。他把一条典型回路拆成传感器、策略、工具、质量门和学习机制:系统从客户邮件、支持工单、产品数据等地方收集信号,按规则调用工具,通过测试或人工复核,再把失败样本送回下一轮改进。6
这场演讲里最有用的限制条件,是它没有把人从系统里抹掉。Blomfield 认为,人仍要处理新情况、伦理判断和高风险场景;机器更适合在边界清楚、反馈可测的环节里反复运行。这个判断与 Cloudflare 的「人对输出负责」相互呼应,也比「所有岗位都会消失」更接近当前能验证的实践。
Loading content card…
读者可以拿走的检查表
如果要判断一家公司是否真的在做 AI 原生组织,而不是给旧流程换一层宣传词,可以先问六个问题:
- 工作是否留下可复用的上下文? 只有最终报告,没有过程、判断和失败记录,Agent 很难持续变好。
- 权限是否跟着使用者走? Agent 不应因为被共享,就继承创建者的全部系统权限。
- 验收标准写在哪里? 代码、文档和决策都需要测试、复核或升级条件。
- 谁是结果责任人? 多 Agent 协作不能把责任稀释成「系统自动完成」。
- 失败会不会回到流程里? 没有反馈回路,自动化只能更快地重复错误。
- 团队变小后,维护成本去了哪里? 省下的人力可能转成模型调用、数据治理、审计和质量验证成本。
截至目前,Cloudflare 给出了一个较完整的内部平台案例;X 上的「共享上下文」「可执行岗位」和 Replit 的小团队观察,则更像正在成形的设计语言。把它们放在一起,能看到方向,却还不能据此宣布某一种组织结构已经胜出。
References
- 1How we’re rethinking work at Cloudflare with Cloudflare OS
blog.cloudflare.com
- 2siddontang 在 X 上的讨论
x.com
- 3
- 4Nessie 在 X 上的帖子
x.com
- 5Reginald M 在 X 上的帖子
x.com
- 6
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.