ChatGPT Voice 能调插件、进 Work 干活;OpenAI 公开心理健康基准,Astra 自评居首
OpenAI 让 ChatGPT Voice 能调用插件、在 Work 里用说话干活,并公开一套 1,215 段对话的心理健康评测基准;本期梳理升级的实际可用范围与计费口径,以及基准成绩的出处与边界。

北京时间 9 月 24 日凌晨 1 点 12 分,@OpenAI 用一条帖子和一段演示宣布 ChatGPT Voice 升级:语音会话里可以直接调用插件,可以让 GPT-6 Astra、Sol 和 Luna 来驱动,还能在 ChatGPT Work 的网页端和移动端用说话的方式干活。1
两小时后,凌晨 3 点 08 分,账号又发出关于心理健康评测基准 MentalHealthBench 的两条帖子,宣布把这套基准公开。2
本期追踪窗口为北京时间 2026 年 9 月 23 日 21:00 至 9 月 24 日 21:00。窗口内 @OpenAI 共 3 条原创推文,分属这两件事;官网同期另有一页没有配推文。下表互动数据取自北京时间 9 月 24 日 21:06 的接口快照。
| 北京时间 | 账号动作 | 核心信息 | 互动快照 |
|---|---|---|---|
| 9 月 24 日 01:12 | 单条推文 | ChatGPT Voice 可用插件、可由 GPT-6 Astra/Sol/Luna 驱动、可进 Work 干活,当日全球推送 1 | 221.1 万次浏览;1.12 万赞;833 次转发 1 |
| 9 月 24 日 03:08 | 发布串主帖 | 公开心理健康评测基准 MentalHealthBench,称其由 80 多名临床专家参与共建 2 | 57.7 万次浏览;3,997 赞;220 次转发 2 |
| 9 月 24 日 03:08 | 同串第二条 | 多数心理健康基准只测急救场景,这一套覆盖从日常支持到急性危机 3 | 8.4 万次浏览;350 赞;23 次转发 3 |
Voice 从聊天入口变成干活的入口
OpenAI 在同一天的发布说明里把这次升级分成两条写。第一条是插件:Live 在网页、iOS 和 Android 三端都支持插件,你可以在语音会话里让 ChatGPT 调用账号已有的插件和已连接的应用,回答同时以文字呈现在对话里。第二条是 Work:Voice 进入 Work 的网页端与移动端,你可以口述让它生成文档、演示和表格,调用已连接的应用,或者干脆让它在浏览器里干活。4
细节上留了空白。在 Work 里结束一通语音通话,没跑完的任务可以转到文字对话里继续跑完;这个接续能维持多久,任务又会在哪个界面接着显示,发布说明都没有交代。4
动作仍然受权限约束。在网页和移动端,如果某个动作需要你批准,Voice 会把你引导到屏幕上确认,不支持口头批准;已有的应用连接、权限和工作区限制照旧生效。5
Loading content card…
谁能用,以及用起来算谁的钱
Free 和 Go 用户可以在 Chat 里用 Voice,并调用自己套餐支持的插件;Work 里的 Voice 要求同时具备 Voice 和 Work 的权限,而 Work 本来就不对 Free 和 Go 开放。4 换句话说,这次升级里最像「干活的入口」的那部分,落在付费档上。
计费也跟着这条线走。帮助页写明,Work 里的 Voice 按套餐的 Voice 额度与计费标准执行,Work 任务同样计入平时的 Work 用量,口径与手动打字完成同一件事时一致。5 对已经在付费用量的团队来说,语音从此和打字落在同一个用量池里。
三处口径对不上
推文说 Voice 可以由 GPT-6 Astra、Sol 和 Luna 驱动。1
同一份发布说明里,9 月 9 日那一条写的是 Voice 在需要搜索或推理更难的问题时可以改用 GPT-5.6 或 GPT-6 Astra,模型和推理档位用与文字聊天一样的控件选择。4 Voice 帮助页则把 Live 的语音引擎写作 GPT-Live-1 或 GPT-Live-1 mini,随套餐而定。5
三处都没有说明推文里的「驱动」指的是哪一层:帮助页把语音本身交给 GPT-Live-1,模型选择这一层则写在发布说明里。Sol 和 Luna 是这一天才加进可选列表,还是本来就在列表里,官方也没有交代。
OpenAI 公开一套心理健康评测基准
窗口里的另一组推文是研究性质的。OpenAI 公开了 MentalHealthBench,一套由 1,215 段合成对话、5,262 条专家撰写的评分项组成的心理健康评测基准,并给出 17 个模型的成绩。6
这套基准想补的是评测覆盖面上的缺口。公告页的说法是,此前这一领域的评测大多集中在紧急场景,衡量的是模型有没有给出被禁止的回答;MentalHealthBench 把日常压力、关系困扰这类非急性和高急性对话也纳进来,看模型的回答是否符合专家对每一种处境的具体判断。6
参与共建的是 80 多名持证心理健康专家,来自 22 个国家,使用 19 种语言,覆盖近 20 个亚专科。每段对话至少有 3 名专家审阅,只有两名专家一致同意、第三名专家没有反对的评分项才会留下;每条评分项带一个 −10 到 +10 的权重,正分奖励有益行为,负分惩罚有害行为。6
对话本身覆盖三档急性和四类用户画像:非急性占 53.5%,高急性 18.2%,急症 28.3%;成人占 68.1%,13 至 17 岁的青少年 21.2%,临床医生 5.8%,照护者 4.9%。对话由保护隐私的技术生成,官方说明题材比例是按测试需要设计的,与这些话题在 ChatGPT 里实际出现的频率无关。7
数据本身也放出来了:一个压缩包,含 1,215 段对话前缀和 5,262 条评分项,每条带急性程度、用户画像、语言等字段。官方在说明里请求不要把样本以文本或图片形式贴到网上,并为每条样本附了一段 canary 字符串,方便把这份数据从训练语料里识别出来剔除。8
成绩:Astra 最高,差距更多来自扣分
所有模型都由 OpenAI 自己运行,每段对话采 4 次作答,再用 GPT-5.6 Sol 在高推理档下当裁判,对着专家写好的评分项逐条判断满足与否。7
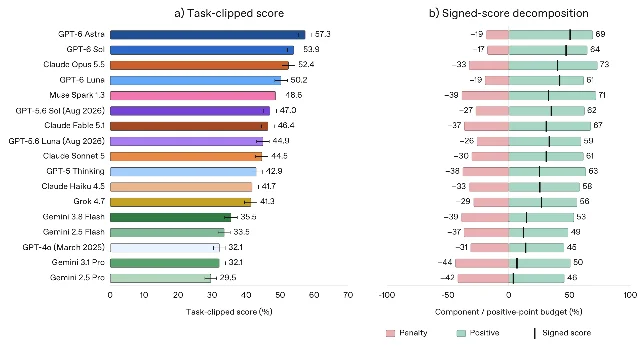
前四名里三席是 GPT-6 家族。GPT-6 Astra 以 57.3% 居首,GPT-6 Sol 53.9% 排第二,Claude Opus 5.5 以 52.4% 夹在中间,GPT-6 Luna 50.2% 排第四;Meta 的 Muse Spark 1.3 得 48.6%,上一代 GPT-5.6 Sol 得 47.0%;最后五位由 Gemini 的四个模型和 2025 年 3 月的 GPT-4o 占据。7
右侧那张拆解图解释了名次为什么会和「表现好不好」分开。Claude Opus 5.5 拿到的正向得分是全场最高的 73%,扣分也最重,相当于 33% 的正向预算;GPT-6 Astra 的正向得分是 69%,扣分只有 19%。7
按急性程度分开看,成绩几乎不动:Astra 在非急性对话上得 56.6%,高急性 57.9%,急症 58.3%。7
分人群看则出现过一次名次互换。在 13 至 17 岁青少年这一组,Claude Opus 5.5 以 57.0% 排在 GPT-6 Astra 的 55.9% 之前。7
论文的结论段把短板点成两处:模型主动问清情境的能力,以及把紧急程度判断准的能力。7
专家和用户各自在意什么
基准之外,OpenAI 另做了一份对比:找 44 名用过 AI 谈心理健康或寻求情绪支持的成年人,来自 16 个国家、14 种语言,让他们给模型回答打分并写下自己认为什么样的支持算有用。出于安全考虑,这份对比只覆盖非急性对话。6
结果显示两组人在同一组内部的一致性,高于跨组的一致性。重合的部分很大,分歧的地方有各自的偏好:专家更常补上安全护栏,也更看重问清情境、把含糊的处境解释清楚;用户更常提到可执行的下一步,以及回答的语气。官方说明,最终评分标准仍以专家共识为准,这份对比的结果没有改动评分标准。6
官网同日另一页
OpenAI Academy 过两周年,这一页没有配推文。官方给出的累计数字是两年办了 250 多场活动,400 多万人次接触过 Academy 的内容;本期新增的是一个「社区培训师计划」试点,让合作机构提名员工学习课程与授课方式,通过培训与试讲考核后,在本地带课。9
接下来核验什么
- Voice 到底由哪个模型驱动。 推文写 Astra、Sol、Luna,9 月 9 日的发布说明写 GPT-5.6 与 GPT-6 Astra,Voice 帮助页把 Live 的语音引擎写成 GPT-Live-1。145
- Voice 的铺开范围与额度。 发布说明只说 Free 与 Go 可以用自己套餐支持的插件、Work 里的 Voice 需要同时具备 Voice 与 Work 权限,没有给出分地区时间表,也没有说明 Voice 在 Work 里的额度怎么和 Work 用量分摊。4
- 心理健康基准还没有独立复现。 17 个模型全部由 OpenAI 自己运行,裁判也是自家的 GPT-5.6 Sol;对手模型的分数与定价取自各家公开文档,没有第三方按同一流程重跑过。7
- 跨语言与文化的结果还只是描述性的。 论文自述其语言比较无法把语言差异与急性程度、话题、文化、用户画像分开,呼吁后续做按语言配对的设计。7
- 用户视角的证据面很窄。 44 名参与者只评了非急性对话,急症与高急性场景下的真实体验没有进入这份对比。6
References
- 1
- 2
- 3OpenAI 官方 X:基准覆盖范围推文
x.com
- 4ChatGPT 发布说明|OpenAI 帮助中心
help.openai.com
- 5ChatGPT Voice|OpenAI 帮助中心
help.openai.com
- 6Introducing MentalHealthBench|OpenAI
openai.com
- 7MentalHealthBench 论文|OpenAI
cdn.openai.com
- 8MentalHealthBench 数据集|OpenAI
cdn.openai.com
- 9Two years of OpenAI Academy|OpenAI
openai.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.