华为汪涛:华为要打造AI算力底座,只做好一颗芯片远远不够
量子位报道华为全联接大会 2026 上汪涛公布的昇腾算力路线:昇腾960DT 提前三个季度并就绪时间锁定 2027 年一季度,昇腾960超节点以 4096 卡规模首发 NPO 光引擎,CANN 生态跨过拐点。

转载说明:本文转载自微信公众号「量子位」官方账号(biz_id:MzIzNjc1NzUzMw),原文发表于 2026 年 9 月 19 日 16:00,作者署名「乔不迟 发自 凹非寺 量子位 | 公众号 QbitAI」。原文链接:[量子位微信公众号原文](http://mp.weixin.qq.com/s?__biz=MzIzNjc1NzUzMw&mid=2247924665&idx=1&sn=31aa47a931c6da4a0f23a3e607ae3dd3),同题文章另见量子位官网 qbitai.com。
昇腾 960DT 的研发进度比原计划提前三个季度,单芯片算力实现倍增:支持 2 PFLOPS FP8、4 PFLOPS FP4,HBM 容量最高 288GB、访存带宽 9.6TB/s。按华为官方新闻稿的口径,960DT 在 2027 年第一季度就绪,960PR 比原计划提前一个季度,定在 2027 年第三季度 3。
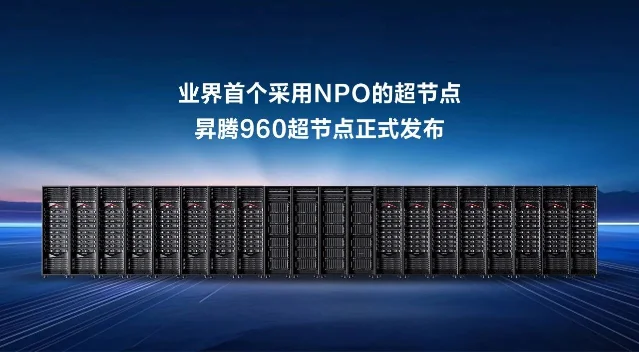
对应的昇腾 960 超节点做到 4096 张 NPU 卡,最高 8 EFLOPS FP8 算力、超过 1PB HBM 容量。汪涛把后续路线一并摊开:2028 年昇腾 970、2029 年昇腾 980,未来几年保持「一年一代」的演进节奏 2。
会后,汪涛接受量子位专访时把这个变化说得很直白:
从今年开始,950、960、970、980 连续几代,未来几年我们坚持一年一代,走入了快速演进的节奏。这也是国内半导体制造、封装的上下游配套全部打通之后才实现的。
华为这次想讲的,显然不只是一颗更快的芯片。围绕 960,华为把 NPO 光互联、超节点、CANN 生态和韬定律一起摆上台面 2。韬定律在华为官方材料里写作 τ 定律,主张用「时间缩微」替代「几何缩微」,靠压缩信号传播时延来延续半导体与电子系统的性能演进 4。
单芯片倍增,但华为押注的是整套系统
这次核心的新产品是昇腾 960。相比上一代,960 把算力、内存容量和带宽继续往上推,产品节奏也明显加快。按照华为披露,960DT 比原计划提前三个季度准备就绪,960PR 版本也将继续提前 2。
更值得注意的是昇腾芯片的研发周期。汪涛在专访中透露,960 芯片已经在实验室测了好几个月。
芯片从立项到产品化往往要三年,我们任何一次发布,都是产品已经在实验室反复测试、有准确交付时间之后才做。
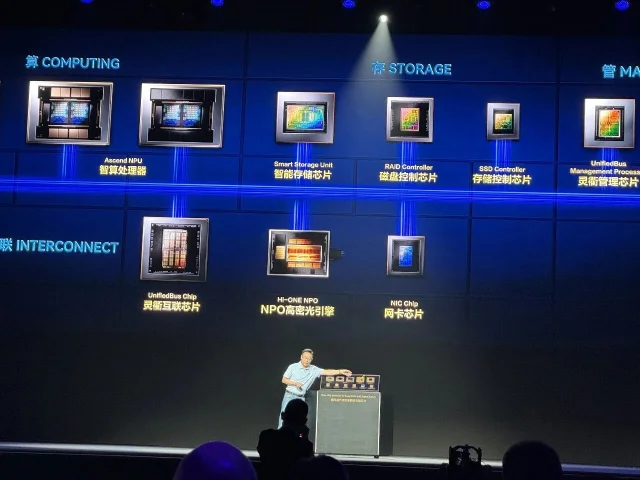
AI 大模型的训练和推理规模迅速扩大,单颗芯片再强,也很难独自承担万亿、十万亿参数模型的计算需求。华为把突破口放到了「规模算力」上:910C 是 384 卡,950 做到 1024 卡,960 进一步扩到 4096 卡,并通过跨物理节点的统一内存编址,让多颗 NPU 互联起来更接近一台逻辑计算机 2。
汪涛提到,华为从仿真训练里看到,在同样十万卡集群下,4096 卡超节点组成的集群相对传统八卡服务器组成的集群,MFU 可提升 2.75 倍 2。MFU 可以简单理解为大模型真正吃到多少理论算力;集群越大,通信、同步、故障越容易把峰值性能吃掉。
汪涛因此反复强调,AI 基础设施已经进入系统工程阶段。
只做好一颗芯片远远不够,只做一台服务器也不够,最后要交付一个高可用度的复杂系统才有价值。
这种系统工程能力,也是华为给自己总结的核心优势。一个大规模超节点同时涉及芯片、通信、IP 网络、光互联、供电、散热、软件和故障管理,系统能不能长期稳定运行,取决于这其中每一层 2。
谈到华为在这一轮算力竞争中的位置,汪涛的判断很鲜明:
要做好这么大的超节点集群,需要通信技术、IP、光模块、算力、系统,华为干了 30 年,每个领域都有长期大规模研发投资。把这些能力全部聚在一个团队里,似乎只有华为。
这也是昇腾 960 超节点值得关注的地方:当先进制程短期内仍然构成约束,华为选择继续提升单芯片,同时把竞争战线扩大到整个系统 2。
NPO 落地,华为把 30 年光技术融入超节点
960 超节点这一代最硬的新增技术,是 NPO(Near-Packaged Optics,近封装光学)1。
NPO 可以理解为一种用光来承担芯片间高速数据传输的技术。过去高速数据传输主要依赖电信号,距离一长,损耗和功耗都会上升。NPO 把负责光电转换的「光引擎」往芯片附近推进,相当于「让电少跑一点,让光早点接手」,从而降低高速互联的传输损耗和功耗 2。
这也是为什么 4096 卡超节点开始需要 NPO——卡越多,芯片之间的数据交换越频繁,互联能力就越容易从配角变成决定整个系统效率的关键。昇腾 960 是业界首个采用 NPO 光引擎的超节点。
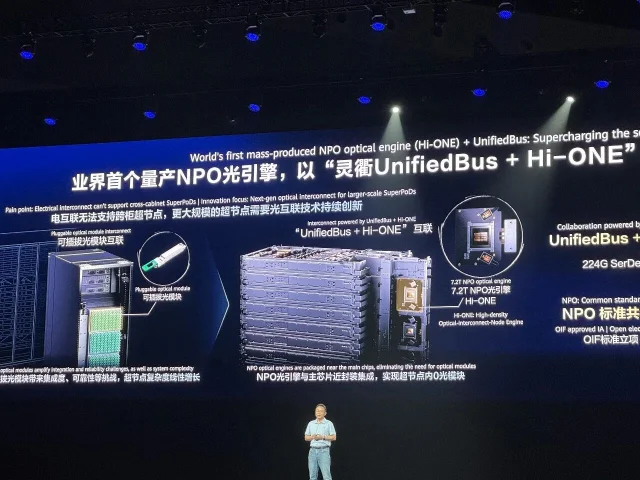
华为用这套 NPO 架构做的具体产品,就是 Hi-ONE 光引擎:单引擎集成 36 路 200G,总传输容量 7.2Tbps,并把光源直接内置。汪涛在圆桌上把 Hi-ONE 的领先性概括为「三个第一」:
第一个规模商用的,大家还在实验室阶段;第二个最大的带宽,36 路 200G 集成;第三个唯一内置光源的。
值得注意的是,华为没有直接一步走向 CPO(共封装光学)。CPO 把光引擎和主芯片封在一起,理论上还能进一步缩短距离,但今天可靠性、良率、成本和维护都还没到华为认为适合大规模商用的状态。汪涛解释得很具体:
CPO 把光引擎和主芯片放一起,光引擎坏了整个主芯片就报废,可用度差,故障成本极高,对封装厂要求也高。现在 NPO 的 TCO 至少比 CPO 低 40% 以上。当前 NPO 是工程、成本各方面综合最佳选择。
他对 CPO 的态度很开放:「未来 CPO 如果解决了可靠性、良率问题,华为也可能转向 CPO,以进一步降低高速信号传输损耗。」
昇腾 960 超节点用约 5500 个 Hi-ONE,替代原本约 4.8 万个 800G 光模块,功耗降低超过 550kW,系统无故障运行时间提升一倍,系统可用度为 99.8% 12。器件数量大幅减少,本身就意味着更少的故障点、更低的布线复杂度和更可控的系统功耗。
这也是「超节点 + 集群」路线能真正落地的前提之一:华为既要继续把更多芯片连起来,也要确保系统规模变大之后,光模块、供电、散热和故障率不会反过来吃掉效率。
CANN 跨过拐点,华为补上软件生态
硬件往前跑,生态要同步跟上。CANN 进入常态化开源社区运营,月活开发者超过 5200 人,外部开发者占比达到 61%;昇腾也进入 PyTorch 官方支持路线,开发者可以直接在 PyTorch 社区获得相关支持 2。
华为官方新闻稿给出的补充口径是:CANN 月活开发者突破 5200 名,外部开发者占比 61%,基于昇腾与 CANN 原生训练的模型已超过 40 个,昇腾覆盖 90 多个主流第三方社区 3。
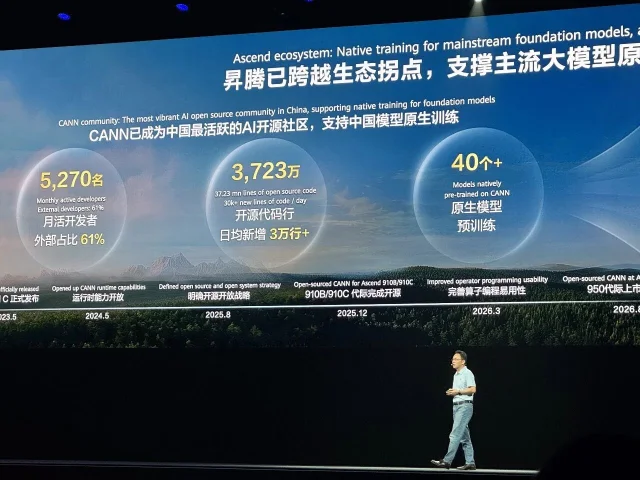
汪涛对此的表述反而很克制:
经过八年努力,我们今天只敢说 CANN 生态跨过了拐点。
华为下一步想把适配动作前置:在模型进入预训练阶段时就和模型厂商协同,把昇腾适配、性能优化等工作尽可能提前完成 2。
很高兴看到中国涌现出一批十分优秀的大模型企业,既有头部互联网,也有大模型初创企业,他们的优异产品和强大的创新能力显著提升了中国人工智能的全球影响力。华为的使命是为这些优秀企业构建坚实的算力底座,做好他们坚强的后盾和伙伴。
汪涛表示,未来会看到越来越多模型基于昇腾原生训练,这样模型开源发布走向千行万业之后,就基本不需要再做适配和优化。
华为给自己划的边界:只把算力底座做好
这背后对应的,是华为对自己在 AI 产业链中位置的一次明确划分。汪涛直言:
华为的核心使命是打造算力底座。
这句话给昇腾、超节点、CANN 乃至整个 AI 基础设施业务划出了一条边界:华为希望把更多资源放在芯片、互联、系统和软件底座上,为模型厂商和互联网公司提供算力支撑 2。
盘古会继续服务华为自身产品智能化,但华为并不打算在每一层都和伙伴竞争。灵衢协议已经开放,CANN 代码也持续开源,华为想把更多研发资源放在芯片、超节点和算力底座。
汪涛随后进一步表示,所有做大模型和训练的企业,无论头部互联网公司还是创新企业,都代表着中国科技的未来,华为希望做他们的「底座、后盾」:「我们把他们托得越高,中国 AI 竞争力越强」2。
对应到产品形态,就是用 4096 卡超节点作为更大的计算单元,再由多个超节点组成十万卡、数十万卡集群。华为披露,多超节点通过灵衢网络或 RoCE 继续扩展,二层 Clos 组网最大可到 51.2 万卡,结合多轨道拓扑,技术上限可支持百万卡。汪涛也强调,百万卡更多是技术指标,现实部署仍要看投资、电力和模型需求。
而华为真正重要的目标,是让算力「触手可及」。汪涛说:
我们不仅提供产品,还派很多技术专家团队,支持客户做昇腾原生的预训练,遇到技术问题一起解决。
汪涛在思量华为未来的路线:
到 2030 年甚至未来,我们必须做一个准备:中国最先进的制造工艺还没有取得完全突破,华为必须有一个创新路线,同时满足中国 AI 训练、推理、行业应用的需求。
而对于创新,汪涛说,这是华为没有退路才走出的「胜利之路」2。
这也解释了华为为什么一边继续提升单芯片性能,一边把大量资源投入到超节点、光互联和系统工程。先进制程依然重要,但华为不能等制造条件完全改善后再推进产品。它需要在现有工艺条件下,把性能提升的空间继续往芯片之外延伸,通过封装、互联、光通信、系统架构和软件协同等多层优化,尽可能放大整体算力效率。
在圆桌收尾时,汪涛补充道:
华为是一家产品公司,要做最好的产品给客户。任总常讲,每个人都要磨好自己的豆腐,各司其职,我们的豆腐就是把算力底座做好。
从昇腾 960、Hi-ONE,到 4096 卡超节点、CANN 和韬定律,这次全联接大会真正展开的,是一条更完整的 AI 基础设施路线:单芯片继续迭代,光和互联把系统做大,软件让模型原生跑起来,再用持续的产品化把算力稳定交付出去 2。华为想守住的位置,是为国内模型公司的训练、推理和持续迭代提供充足、稳定的算力支撑。
想自己核对的,原文是量子位公众号 2026 年 9 月 19 日 16:00 发布的《华为汪涛:华为要打造 AI 算力底座,只做好一颗芯片远远不够》,量子位官网有同题文章;华为官方新闻稿见《智启新未来,打造智能世界的硅基黑土地》和《华为发布全球首个采用 NPO 的超节点——昇腾 960 超节点》,大会信息见华为全联接大会 2026 官网。
References
- 1华为发布全球首个采用NPO的超节点——昇腾960超节点
huawei.com
- 2华为汪涛:华为要打造AI算力底座,只做好一颗芯片远远不够
mp.weixin.qq.com
- 3智启新未来,打造智能世界的硅基黑土地
huawei.com
- 4华为发布《智能世界2035》最新报告,首次提出通往智能世界的十大关键命题
huawei.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.