机器人世界模型的第一个缩放定律:10²² FLOPs 之前,没有一个模型学会推东西
Meta 用 8B 的 JEPA 给机器人世界模型算出第一条缩放定律,LeCun 转它时补了一句人事;本篇把论文的自报数字、它自己划的边界,以及那张被到处引用的成功率表逐项核了一遍。

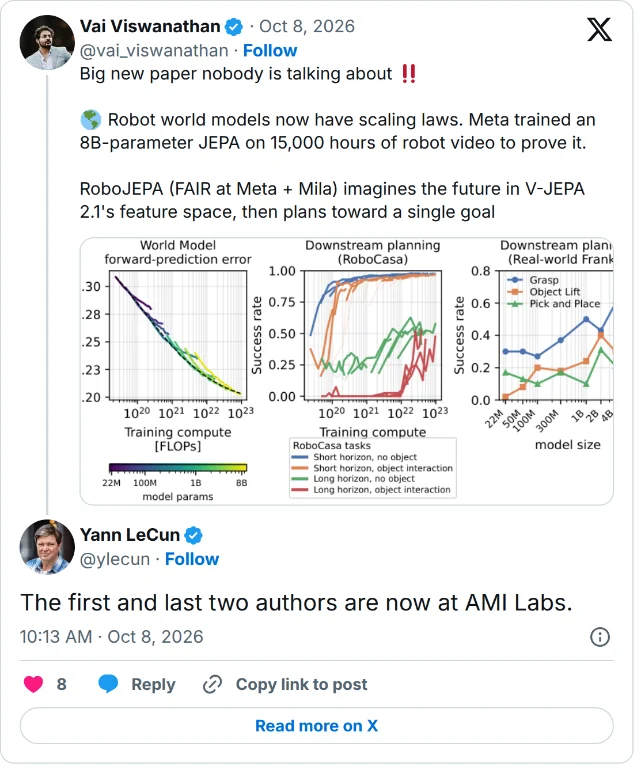
北京时间 10 月 8 日 18 时 11 分,Yann LeCun 转了一条帖;两分钟后,他在同一线程里补了一句话:「The first and last two authors are now at AMI Labs.」12
被转的那条帖写于当天上午 11 时 56 分。发帖人是在纽约做物理 AI 的 Vai Viswanathan,帖文三句话:机器人世界模型现在有缩放定律了;Meta 用一个 8B 参数的 JEPA、15,000 小时机器人视频把它证了出来;这篇论文叫 RoboJEPA,作者来自 Meta 的 FAIR 和蒙特利尔的 Mila。3
LeCun 自己不是这篇论文的作者。论文一共 12 位作者,署名机构写的是 FAIR at Meta 与 Mila,他不在名单里。4
这篇要做的事很具体:把论文里可以复核的数字、它自己承认的边界、那句人事补帖,以及同行此刻在哪,一项一项核到底。
01 一条帖,一句补帖
先看这条帖被多少人看见。
触发帖发布后 6 小时 28 分,也就是北京时间 18 时 24 分,它的数据是 97 个赞、7 次转推、5 条回复、5,290 次浏览。Viswanathan 的账号有 2,100 名粉丝。他在自己的帖下补了一条,贴出论文与项目页链接,并 @ 了论文的几位作者、Meta AI 与 Mila。35
到同一时刻(北京时间 18 时 24 分),LeCun 那条补帖只有 6 个赞。2
把 X 全站按「RoboJEPA」检索,这段时间只有 3 条帖:上面那条触发帖,加上一个 1,642 粉丝的账号连发的两条——一条复述摘要,一条在核对项目页是不是空的。6
媒体的反应同样清淡。这段时间里唯一一条有编辑署名的报道,是法语站 ActuIA 的每日简报《Veille IA du 8 octobre 2026》里约 130 词的一则,归类「新模型」。7 TechCrunch、The Decoder、Import AI 的站内检索都没有这篇;机器之心那边同样没有。8
中文侧唯一一条,是「贝果科技」的自动聚合摘要,页面自己声明「本条为 AI 依据下方公开信源自动整理生成的摘要」。它照抄论文摘要写了一句「团队已开源全部检查点与部署代码」——这句话在发稿时是不成立的,第 05 节会核。9
这条线程里的回复没有一条是质疑或追问,其中一条还是 X 推荐位混进来的无关广告。传播冷清是事实,但它只能说明传播冷清,不足以当成「没人挑得出毛病」。
02 论文说的三件事
论文 73 页,正文只占前 15 页,其余是附录;它的主张可以压成三件事。10
第一件是数据。作者把 23 个公开机器人操作数据集拼成一个混合体,覆盖 12 种本体(不同型号与形态的机器人)、26 种动作空间,合计 15,022 小时视频,其中 6,692 小时与动作同步。10
这个混合体并不均匀。单是 AgiBot World 一家就贡献 8,036 小时,占全部视频时长的一半以上;Open-X Embodiment 的 9 个数据集合计 4,298 小时排在第二;DROID 只有 414 小时。论文自己注明:这里报的是「我们能收集并核实的规模,可能小于原论文报出的数字」。10
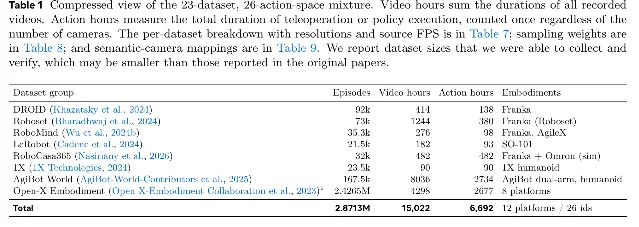
15,022 小时不是均匀铺开的:AgiBot World 一家占 8,036 小时。表格来自论文 arXiv:2610.10515v1 第 5 页
第二件是模型族。编码器固定用 V-JEPA 2.1,冻结不动,只放大它上面那个负责「预测下一帧表征」的预测器,从 22M 参数一路做到 8B,训练算力从 2×10¹⁹ 到 9.5×10²² FLOPs。8B 是作者所说「迄今训过的最大 JEPA 预测器」。10
第三件是缩放定律,也是这篇论文被转的原因。
作者先定义了一个量:想象误差,即模型在潜空间里往前滚若干步之后,预测出的表征与真实表征之间的差距。然后他们拿四类曲线去拟合——标准幂律、破损幂律、统一幂律,以及一个让指数本身随算力变化的版本。结果是最后一类赢:误差随算力走的是一条二阶幂律。10
关键在于怎么验。他们只用 22M 到 2B 这些小模型的点来拟合,把 4B 与 8B 扣下来当留出集。二阶幂律对这两个没见过的模型的预测误差是 0.6(DROID 真实数据)与 1.4×10⁻³(RoboCasa 仿真数据),比标准幂律低 2 到 3 倍。10
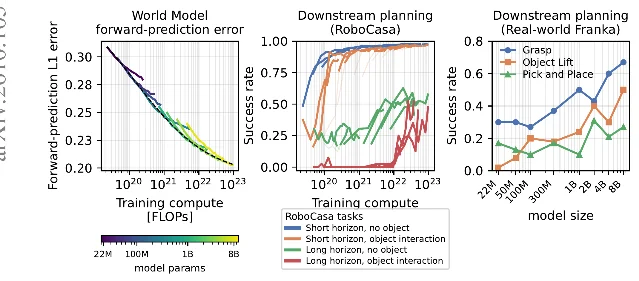
三栏分别对应三个主张:离线误差可预测、仿真规划随之提升、真机成功率随模型变大。图来自论文 arXiv:2610.10515v1 第 1 页
能提前算出来,是这条路线的价值所在:多花一个数量级的算力能换回多少,可以在花钱之前先估。
论文自己列出的边界同样具体,共三条。
编码器是冻结的,所以这套定律描述的是「固定表征之上的动力学模型」怎么缩放,不是表征与预测器一起缩放。10
训练数据是固定的语料、反复多轮,拟合出来的曲线已经贴着数据饱和走了——作者的原话是,要再往前推,靠的将是更多、更杂的交互数据,而不只是更多参数。10
RoboJEPA 不用文本,规划时只朝一张目标图像走;动作不是由学出来的策略提议的,而是从均匀分布里采样、再用世界模型排序。10
03 67% 对 5% 怎么读
这篇论文最抓人的一组数字是「8B 抓取 67%、π0.5 只有 5%」。它们出自论文表 3,值得连上下文一起看。
| 模型10 | 目标怎么给 | 抓取(进度/成功) | 举升(进度/成功) | 抓放(进度/成功) |
|---|---|---|---|---|
| π0-FAST10 | 文本指令 | 35 / 22 | 20 / 12 | 55 / 40 |
| π0.510 | 文本指令 | 25 / 5 | 12 / 0 | 69 / 53 |
| RoboJEPA-4B10 | 单张目标图像 | 60 / 60 | 54 / 30 | 49 / 21 |
| RoboJEPA-8B10 | 单张目标图像 | 67 / 67 | 65 / 50 | 42 / 27 |
表内数字来自论文表 3,均为真机 Franka 平台、每任务 10 次试验。10
有三处口径差异决定了这张表不能横着读。
第一处是目标:RoboJEPA 的输入是一张目标图像,π0.5 与 π0-FAST 的输入是文本指令。
第二处是训练数据:两个 VLA 基线做了 DROID 微调,RoboJEPA 用的是包含 DROID 在内的混合语料预训练。
第三处要一起记住:两组都没有做任务专属微调。10
把这几处差异逐条写下来的,是论文作者自己。论文的原话是:这些差异让 VLA 的结果「只是语境参照,而不是可以直接比较的基线」。10
于是「67% 对 5%」只在抓取这一行成立,而这一行两边用的根本不是同一种输入;换到抓放那一行,局势反过来——π0.5 的 53% 对 RoboJEPA-8B 的 27%。论文对 π0.5 在举升上得 0% 也给了解释:怀疑是训练数据里「lift」这个动词严重欠表征。10
第三方读数能把这件事说得更清楚。
Ai2 维护的开源榜单 MolmoSpaces 上,π₀.₅ DROID 的成功率是 17.8%(横跨 9 个任务,2026 年 2 月 22 日测),π₀ DROID 是 7.1%,π₀-FAST DROID 是 5.5%。11
另一个独立评测 RoboArena 走的是众包双盲真机 A/B:同一批机器人策略两两对比,由分布在各机构的评测者各自出任务。榜上排第一的是 NVIDIA 的 DreamZero(190 场 A/B),排第二的就是 π0.5 的 DROID 检查点,745 场 A/B 拿下 62.2% 的胜率(其余为平局,不计入)。12
同一个模型,在论文自测里是抓放 53%,在仿真榜单里是 17.8%,在真机 A/B 里是胜率第二。三个数字都对,因为它们量的不是同一件事。
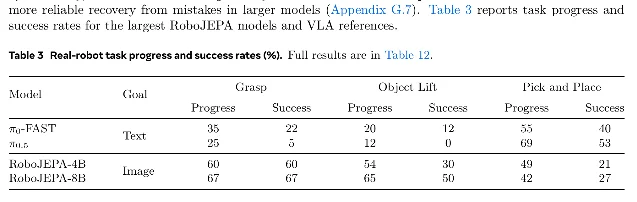
表 3 的完整上下文:两行 VLA 用的是文本指令,两行 RoboJEPA 用的是图像目标。截图取自论文 arXiv:2610.10515v1 第 13 页
所以看到任何一个机器人成功率,先问四件事:什么机器人、什么任务、目标怎么给、测了几次。这四个条件不写清的成功率,不能拿来比。
04 技能是分档解锁的
比缩放定律更有信息量的,是论文里那些「某件事要到某个算力才第一次发生」的记录。
作者在仿真环境 RoboCasa 里搭了几组环境,每组只测一种基本能力。结果是四段分开的门槛:
末端执行器的 3D 移动能力,大约 10²⁰ FLOPs 出现;握着物体移动,大约 3×10²⁰ FLOPs 出现——这两个门槛对应的是 50M 到 100M 参数的小模型。10
越过障碍要晚得多:绕过大件障碍物这项能力在约 10²¹ FLOPs 起飞,在 10²² FLOPs 附近饱和。10
推物最晚。在约 10²² FLOPs 之前,没有任何一个模型取得过正的成功率;过了这条线,所有规模的模型都开始成功。作者对此的判断是:对周围物体的细致理解,是在某个训练算力之后才出现的,与模型大小无关。10
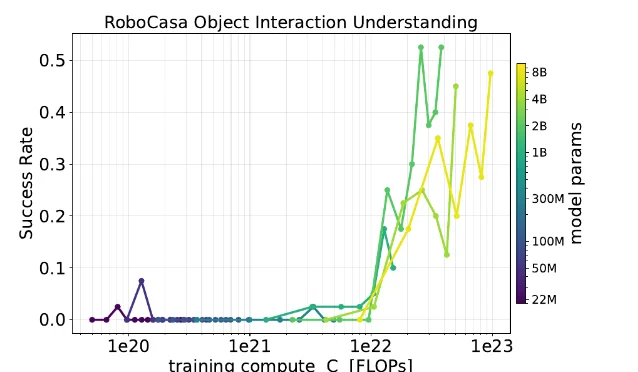
10²² FLOPs 之前全是零,之后所有规模的模型一起抬起来。图来自论文 arXiv:2610.10515v1 第 12 页
还有一处更值得记的细节:越障这一项,作者先用预测下一帧的短时程配方去训,结果没有出现干净的前沿——奖励(任务推进的程度)与算力只有弱相关,小模型常常打败大模型。换成把预测步长拉到 K=10 的长时程配方之后,趋势才变得可预测。10
这条经验可以直接搬走:模型变大并不自动换来长时程能力,训练目标里得先有长时程这件事。
05 承诺还没到
论文里有一句承诺,摘要与正文各说了一次:「We release all model checkpoints together with our training and robot deployment code.」410
截至北京时间 10 月 8 日 18 时 30 分,这些还没拿到。
论文页给出的代码地址是 facebookresearch/robo_jepa,访问返回 404。13
论文页给出的项目页,全文只有一句话:「Project page coming soon.」14
GitHub 上确实有个叫 robojepa 的组织,但它名下只有一个仓库,就是那个项目页;该仓库至今只提交过一次,提交信息是「Add placeholder project page」,时间戳为 2026-10-07T17:21:10Z,比论文在 arXiv 上出现的时间早 33 分钟。15
第三方平台 alphaXiv 上有这篇论文的条目和一段自动生成的概览,但讨论区是空的。16
这里要说清边界:论文上线到现在不足 17 小时,说「尚未公开」是事实,说「不会公开」是臆断。作者确实在论文上线前半小时就建好了组织与占位页,这更像准备中而不是放弃。
后果是直接的:到现在为止,没有任何第三方复现过这套缩放定律,也没有人在真机上跑过它发布的模型。
06 同行的四种答案
把这篇论文放回同行里,会看到四条路线:Meta 自己的上一代、Physical Intelligence、NVIDIA 与 Google DeepMind。
Meta 自己的上一代就在这条线上。V-JEPA 2 是 1.2B 的世界模型,第二阶段只用 62 小时 DROID 无标注机器人视频,就在实验室的 Franka 臂上完成拾放新物体,成功率 65% 到 80%。17 今年 3 月的 V-JEPA 2.1 把真机抓取成功率相对 V-JEPA 2-AC(V-JEPA 2 的动作条件化版本)提高了 20 个百分点,论文没有给出基准的绝对数字——RoboJEPA 冻结的正是 2.1 的编码器,作者给的理由是它的缩放「成功且可预测」,而 V-JEPA 2 不行。18
Physical Intelligence 走的是另一条:不做潜空间预测再规划,而是直接训「文本指令进去、动作出来」的 VLA。π0.5 的一手数据是约 400 小时移动机械臂家务数据、覆盖约 100 个家庭;但论文说第一阶段训练样本里 97.6% 并不来自这类数据,而来自其他本体与网页数据——它主张的是跨本体协同训练,而不是单一本体的数据量。19 它的权重走 openpi 开源。20 后续的 π0.6 能稳定叠衣、并有 20% 概率把纸箱完整装起来;π*0.6 加上真机强化学习后,最难的任务上吞吐翻倍、失败率约减半。2122
NVIDIA 则想两头都要:它最新的方向叫世界动作模型。GR00T N2 的预览版基于 DreamZero 的研究,官方称新环境新任务的成功率是领先 VLA 的两倍以上,并自述在 MolmoSpaces 与 RoboArena 上排名第一——而我们在 RoboArena 榜上看到的第一名是 DreamZero 本身,榜上没有 N2 的条目,N2 也还没发布。122324
Google DeepMind 的 Genie 3 走的是第三条:它给的是可实时交互的生成世界,720p、24 帧、一致性维持几分钟,官方明确它不直接驱动机器人,只用来训练智能体。25
这几条路线的数据基础正在合流:DROID、Open-X Embodiment、AgiBot World 是这一批工作共用的公开语料,RoboCasa 是共用的仿真评测台。2627 差别不在数据,而在目标怎么给、动作是搜出来的还是学出来的。
另一条产业信号来自 9 月 28 日:Fei-Fei Li 的 World Labs 宣布签署最终协议并入 AMD,她本人将出任 AMD 执行副总裁兼首席科学家,交易预计年底前交割。28 做世界模型的公司开始贴着硬件走。
07 那三位作者
LeCun 那句话,核下去比读起来复杂。
AMI Labs 的正式名称是 Advanced Machine Intelligence,官网自己的话是「Real World. Real Intelligence.」,做的是从真实世界传感器数据里学抽象表征、并在表征空间里做预测的世界模型,尤其是让智能体预判自己动作后果的动作条件化模型。落点写的是工业过程控制、自动化、可穿戴设备、机器人、医疗。总部在巴黎,官网标着巴黎、纽约、蒙特利尔、新加坡四地。29
现在逐人核他那句话。论文的第一作者是 Artem Zholus,最后两位是 Nicolas Ballas 与 Mahmoud Assran。4
Zholus 能核到。他的 X 简介写着「MTS @ AMI Labs」(Member of Technical Staff,技术团队成员),2026 年 8 月 15 日发过一条加入帖:「Excited to share that I've joined @amilabs as a Member of Technical Staff!」32
Assran 也能核到,但要绕一下。他的个人主页现在写着自己是 Advanced Machine Intelligence 的科学家、创始团队成员,此前是 Meta FAIR 的研究科学家,联系邮箱用的是 amilabs.xyz 域名;而这个主页的旧标题,以及他的 X 简介,都还写着 Meta。3334
第三位核不到。Nicolas Ballas 没有任何公开的加入证据:AMI Labs 官网首页署名的七个人——Alex LeBrun、Laurent Solly、Mike Rabbat、Min Lin、Pascale Fung、Saining Xie、Yann LeCun——里面没有他。29
还有一处更硬的旁证,方向相反。这篇论文自己的署名页上,Zholus、Ballas、Assran 三人的机构栏都还写着 FAIR at Meta;Zholus 名下另注 Mila 与蒙特利尔理工,Ballas 与 Assran 标注为共同末位作者。4
结论是:那句「第一位与最后两位作者现在都在 AMI Labs」,三个人里有两个能核到,第三个核不到。
能核到的那两位,就是这条路径的证据:论文的第一作者名下注着「Work done at Meta」,而他和另一位末位作者,如今都挂在 AMI Labs 的名册上。这批人最后一次联署的机构名,还停在 Meta。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8The Decoder 站内检索「RoboJEPA」返回无结果
the-decoder.com
- 9RoboJEPA提出多实体机器人世界模型缩放定律 · bigolab.com
bigolab.com
- 10RoboJEPA 全文(Table 1 数据构成)
arxiv.org
- 11MolmoSpaces 排行榜(抓取于 2026-10-08)
molmospaces.allen.ai
- 12RoboArena 排行榜(页面标注 last updated 10/8/2026, 10:23:59 AM)
robo-arena.github.io
- 13论文给出的代码地址(访问返回 404)
github.com
- 14RoboJEPA 项目页(全文为「Project page coming soon.」)
robojepa.github.io
- 15GitHub 组织 robojepa(名下仅项目页仓库)
github.com
- 16RoboJEPA · alphaXiv
alphaxiv.org
- 17
- 18
- 19
- 20
- 21π0.6 模型卡(Physical Intelligence)
website.pi-asset.com
- 22
- 23NVIDIA Expands Open Model Families(含 GR00T N2 预览,2026-03-16)
nvidianews.nvidia.com
- 24
- 25Genie 3: A new frontier for world models · Google DeepMind
deepmind.google
- 26DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset
droid-dataset.github.io
- 27RoboCasa(含 RoboCasa365)
robocasa.ai
- 28World Labs is Joining AMD(2026-09-28)
worldlabs.ai
- 29AMI Labs 官网(首页自述、四地布局与署名,抓取于 2026-10-08)
amilabs.xyz
- 30
- 31
- 32
- 33Mahmoud Assran 个人主页(自述为 AMI 创始团队成员)
midoassran.ca
- 34
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.