最高法划线:公开信息经AI聚合,何时变成隐私侵权?
最高法9月7日发布涉人工智能纠纷司法意见,本文拆解公开信息聚合、模型训练与法律材料明文处理之间的隐私边界。

9 月 7 日,最高人民法院发布《最高人民法院关于依法审理涉人工智能纠纷案件的意见》,文件共 5 部分 24 条,开始用司法裁判规则回答一个现实问题:公开在网上的信息,经过 AI 处理后,能走多远?1
答案落在“合理范围”四个字上。
公开碎片,也会拼出私密信息
电话号码、网络账号、社交媒体内容单独看可能属于公开信息。AI 把这些碎片追踪、分析、关联,进一步获取私密信息,再泄露、公开或侵扰私人生活安宁,最高法明确应认定为侵害隐私权。2
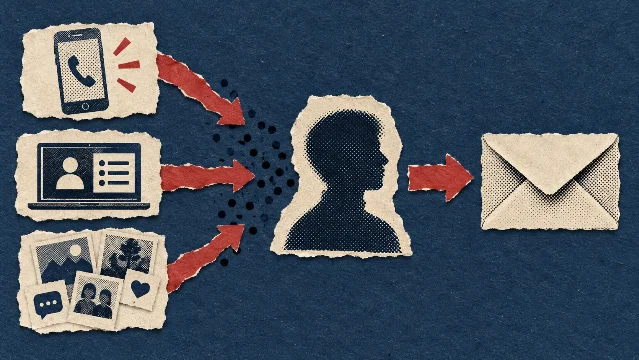
这条数据流的风险点,不在某一条信息是否公开,而在 AI 把分散线索变成了个人画像。组织做公开信息检索、客户尽调或案件分析时,需要记录处理目的、信息来源、关联范围和结果去向。
训练使用,关键看五个条件
《意见》对模型训练也给出边界:在合理范围内处理个人自行公开或其他已经合法公开的个人信息,且个人未明确拒绝,一般不认定为侵害个人信息权益。判断“合理范围”时,还要看处理目的、模型功能的必要性和适当性、信息类型与敏感程度、对个人权益的潜在影响、公开场景以及个人可以合理预期的使用范围。对个人权益有重大影响的,仍应依法取得同意。1
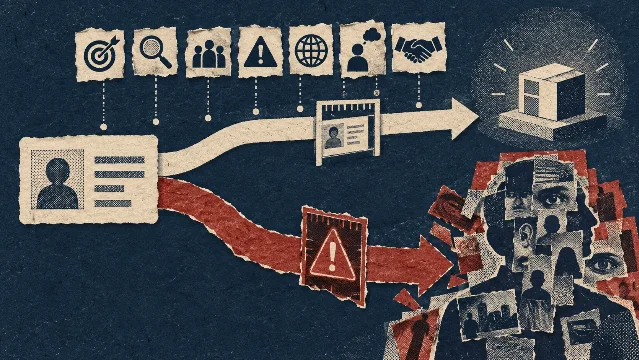
这意味着,法务审查不能只问“数据是不是公开的”,还要问“模型为什么要用、用了多少、会对谁产生什么影响”。一旦材料包含身份、健康、案件或商业秘密,合规判断和技术保护必须同时前置。
合规边界之外,还有明文落点
法律允许在特定条件下处理数据,解决的是“能不能用”;技术链路解决的是“谁能看到”。法律合同、证据材料、身份资料和图片附件进入普通 AI 后,输入、检索、临时处理、结果保存都可能留下明文副本。
墨镜熊官网关于页公开的能力包括本地加密、密态计算、密态搜索、结果存入密态空间,并明确对话内容进入全链路加密保护流程,平台与模型无法访问明文数据。3
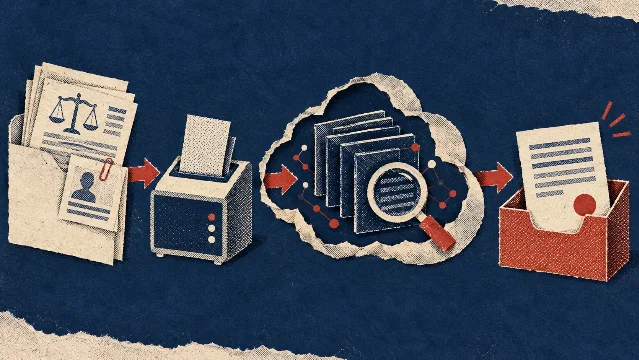
在法律场景中,这类平台可以承接已获授权的材料分析、图片输入、密态搜索和结果整理,把明文保护前移到输入、计算、检索与结果沉淀。组织仍需负责告知与同意、最小权限、留存删除、导出审批和律师人工复核。
最高法划出的线提醒企业:公开来源不等于无限用途,合法处理也不等于可以忽略明文暴露。涉及高敏法律材料,先审查用途与授权,再选择能保护完整处理链路的 AI 工具。可访问 www.mojingxiong.com 了解墨镜熊公开能力。
References
- 1最高法发布《关于依法审理涉人工智能纠纷案件的意见》
court.gov.cn
- 2最高法相关部门负责人就涉人工智能纠纷案件答记者问
court.gov.cn
- 3墨镜熊:下载中心
mojingxiong.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.