EmbeddingGemma 2:740M 参数装下文本、图像、视频、音频,截到 128 维后跨模态检索掉两成
解读 Google DeepMind 2026 年 10 月 6 日发布的开放权重多模态嵌入模型 EmbeddingGemma 2:740M 参数把文本、图像、视频与音频映射进同一个 768 维空间,本文拆开它的模块化加载、端上内存与延迟口径,交代「同尺寸最强」目前只在代码与图像上有跨厂商对照,并算清截断到 128 维时哪几个模态会掉两成。

2026 年 10 月 6 日,Google DeepMind 发布 EmbeddingGemma 2:一个 740M 参数、Apache 2.0 许可的开放权重嵌入模型,把文本(含代码)、图像、视频帧和音频映射进同一个 768 维向量空间1。官方说它来自与 Gemini Embedding 系列同一套技术1,前代只处理文本,下载量已超过 2000 万次1。
读这份发布时最需要自己判断的,是「同尺寸最强」这句宣称能兑现到什么程度。官方模型卡的评测表列了八行数字,带对照的只有文本和代码两行;图像、视觉文档、视频、音频四行是没有对照列的单独分数,跨厂商比较只出现在两张散点图上123。
四种模态进同一个 768 维空间
740M 总参数拆成三块:文本主干 270M(130M 的 transformer 加 140M 嵌入层),视觉编码器 170M,音频编码器 300M2。主干是改造过的 Gemma 4 解码器,24 层,模型维度 512,隐藏维度 2048,滑动窗口 1024 个 token,词表 262,144 项,局部层与全局层按 5:1 排布,池化用平均池化,输出前过一层 512 到 768 的投影2。
一次输入也可以混排。开发者指南给的写法是在文本里用
<|image|>、<|video|>、<|audio|> 三个占位符标出媒体的位置,调用时按键传入对应文件,模型返回一个把这段文字和这些媒体合在一起的向量23。四种模态共用 8,192 个 token 的上下文预算,各自汇率固定:一张图 280 个 token(约 29 张),一帧视频 140 个 token(约 58 帧),音频每秒 25 个 token(约 327 秒,合 5 分半)2。混排同时占用这几档额度,能装下的量会互相挤2。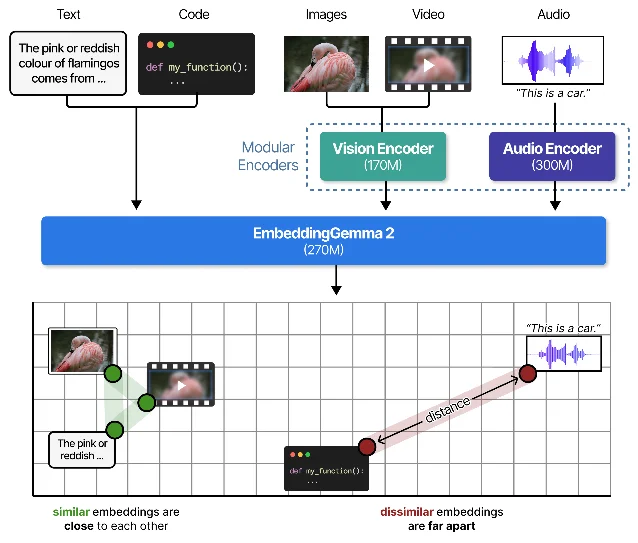
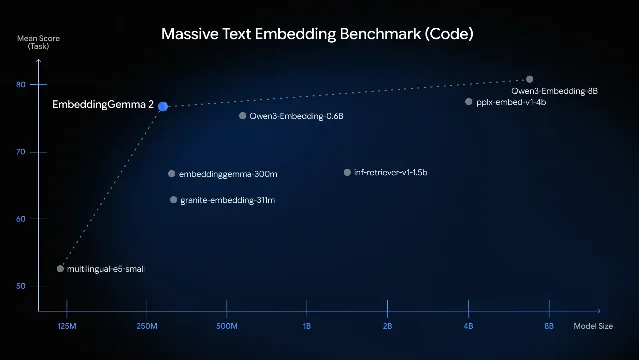
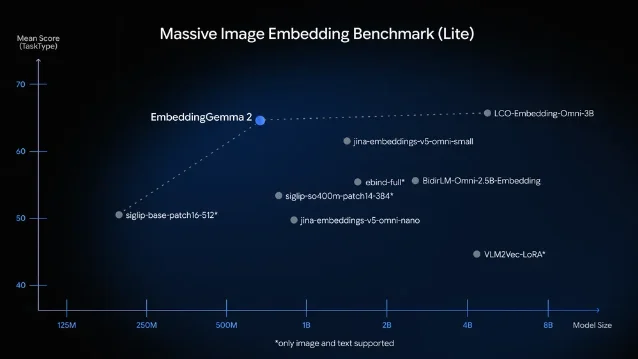
「同尺寸最强」的依据是两张散点图
模型卡那张表列了八行2:文本两行(MTEB 多语言 v2、MTEB 代码 v1)、图像两行(MIEB lite、MMEB v2 图像)、视觉文档一行、视频一行、音频两行(MSEB 检索、MAEB)。对照列只有 EmbeddingGemma 2 与前代两栏,所以后六行给出的是没有任何横向参照的单独数字2。
跨厂商的比较被放进两张散点图,横轴是模型参数量,纵轴是分数13。代码那张图上,EmbeddingGemma 2 落在 250M 附近、约 78 分的位置,同图还有 Qwen3-Embedding-0.6B、granite-embedding-311m、前代 embeddinggemma-300m(约 66 分)、inf-retriever-v1-1.5b、pplx-embed-v1-4b 和 Qwen3-Embedding-8B3。图像那张图上,位置比它高的一个是约 3B 的 LCO-Embedding-Omni-3B1。
音频这边官方只给了两个自评分数:MSEB 检索 69.54(MRR@10),MAEB 均分 49.392。MAEB 是 MTEB 生态里社区维护的音频嵌入榜,2026 年 2 月发布时评了 53 个模型,总榜第一是 7B 的 LCO-Embedding-Omni-7B,平均 52.2%;那篇文章的结论之一是没有哪个模型全面领先,聚类任务上所有模型都很差45。49.39 与 52.2 同为 Mean(Task) 均分,一个是 Google 自己跑的、一个是几个月前的榜单快照,只能当量级参照,当不了名次。
文本原地踏步,涨的是代码
MTEB 多语言 v2 上,前代 61.15 分,这一代 61.36 分,差了 0.21 分2,多语言文本能力基本没动。
代码是另一个量级:MTEB 代码 v1 从 68.76 升到 78.68,涨 9.92 分2。博客写「提升 9.92 分」,模型卡和开发者指南写「约 14%」123,两个数是同一件事——78.68 除以 68.76 约等于 1.144,只是用的单位不同。
一边是 0.21 分,一边是 9.92 分,这次升级买到的东西对两类人完全不同。做本地代码库索引、语义化代码搜索,或者给编码智能体接检索的人,涨幅落在自己身上;只做多语言文本检索的人,从前代换到这一代几乎没有收益。
装哪一档:270M、440M、570M、740M
| 配置 | 装入的编码器 | 参数规模 | 官方给的用法 |
|---|---|---|---|
| 纯文本 | 仅文本主干 | 270M | 本地代码库索引、文档检索 |
| 文本 + 图像 | 加视觉编码器 | 440M | 照片与视频帧检索、视觉文档问答 |
| 文本 + 音频 | 加音频编码器 | 570M | 语音备忘录、录音档检索 |
| 全模态 | 全部 | 740M | 混合媒体库检索、端上 RAG |
四个配置都从同一个检查点加载,投影到同一个向量空间3。开发者指南把这条写成了一条可以省事的工程事实:先用纯文本索引起步,之后想加图像或音频,重新加载模型并打开对应编码器即可,已经算好的嵌入不用重算3。
内存上,官方在 Google Pixel 11 Pro 上给的口径是量化之后纯文本权重约占 191MB 活跃内存,全模态约 567MB16。这两个数字是量化后的读数;权重仓给出的参数总量是 744,371,512 个 bf16 参数7,对应的原始权重大约 1.5GB,这是读者自己换算时要留意的一步。
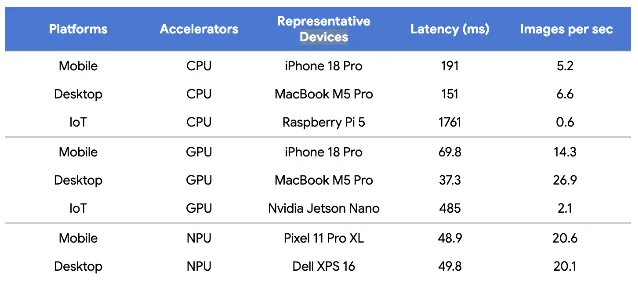
速度这边,AI Edge 博客给了一张按硬件分行的表,并注明该表按每张图最多 70 个视觉 token 的预算测6:MacBook M5 Pro 的 GPU 上单张图 37.3 毫秒(26.9 张/秒),iPhone 18 Pro 的 GPU 69.8 毫秒,Pixel 11 Pro XL 的 NPU 48.9 毫秒,树莓派 5 的 CPU 1761 毫秒6。70 个 token 是模型卡里视觉预算区间的下限,默认值是 2802,所以这张表测的是最省配置下的速度。
存哪一维:128 维的代价落在跨模态检索上
模型用了套娃表示学习(MRL),768 维的输出可以直接截成 512、256 或 128 维使用,向量库的存储因此最多能压到六分之一23。官方同时给出了每个维度的完整分数,这是这份材料里最实用的一张表2。
换算成相对各自满分的保留率,256 维在七个基准上的损失都没超过 5%,可以放心用;128 维开始按模态分化:多语言文本保留 94.3%,英文文本 95.9%,代码 90.8%,图像 91.4%,而 MMEB v2 总体(图像、视频、视觉文档)只剩 77.4%,MSEB 声音检索剩 81.6%2。开发者指南用另一套语言说同一件事:128 维下文本与代码大约留住九成,图像、视频和语音检索掉到七成半,用在多模态之前要拿自己的数据验证3。
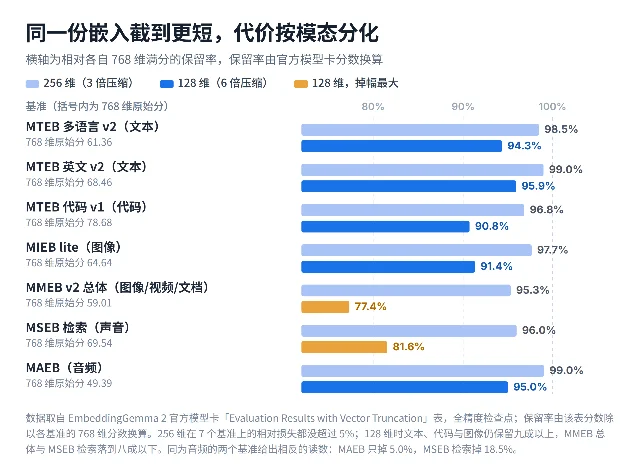
音频这一行有个不能忽略的矛盾。同为音频的两个基准,MSEB 检索掉 18.5%,MAEB 只掉 5.0%2。同一份材料里没有一句话解释这个差别,「128 维能不能用于音频」目前没有统一答案。
四个会让人踩坑的实现细节
- 精度:推理只能用 bfloat16 或 float32,不要用 float16。激活值范围超出 float16 的动态范围,模型会返回 NaN 或悄悄退化的嵌入,失败不会有任何提示2。
- 截断后重新归一化:单位向量切掉后半段之后不再是单位向量,截断维度后必须重新做 L2 归一化。跳过这一步,排序质量会悄悄变差2。
- 查询与文档同维:768 维的查询不能拿去和 128 维的语料算相似度2。
- 文本的任务前缀:文本输入前要加短指令,检索时查询用
SearchQuery、文档用Document,图像、视频、音频不加前缀23。文档有标题时写成title: {标题} | text: {正文}的格式,没有标题就写title: none2。省略前缀照样能跑,精度会降2。
边界:没有配套论文,全部数字是自评
训练数据的截止时间是 2025 年 1 月,文本语料覆盖 140 多种语言;官方称模型支持 100 种以上语言,同时写明各语种的表现可能不均衡2。这两个数字量的是不同的东西,前者是语料覆盖,后者是能力声明。
还有一条与部署直接相关:嵌入模型的训练流程里没有后训练对齐,也没有输出层的内容审核,官方的安全措施停在预训练数据过滤这一层,应用层的检索过滤与公平性测试由部署方负责2。权重仓标的是 Apache-2.0 许可7,使用另须遵守 Gemma 的禁止用途政策28。
今天就能拿到的东西
权重已经在 Hugging Face、Kaggle 和 LiteRT 社区上,后者提供量化好的端侧包;Gemini Enterprise Agent Platform 的 Model Garden 版本官方说「即将推出」1。
本地跑起来的路子有几条:sentence-transformers(6.1.0 或更高版本)、transformers、vLLM、llama.cpp、SGLang、Ollama、LM Studio、MLX;微调可以参考 Unsloth 的文档,向量库一侧 Qdrant 已经写了接入说明13。官方文档入口在 ai.google.dev 的 EmbeddingGemma 页1。
不想写代码的人有三个官方入口可以试:Google AI Edge Gallery 里新增的两个演示,Instant Media Search 按文字或示例图片搜本地照片视频、Video Moments Finder 用自然语言定位本地视频里的具体片段6;以及 Google AI Edge Foresight 的 Mac 版,一个完全本地运行的会议助手,边开会边把速记补全、会后按自然语言检索笔记与文件6。
做 Android 应用的人有一条更省事的路。MediaPipe Tasks 已经把 EmbeddingGemma 2 接进 Universal Embedder 与 Semantic Retriever:前者处理图像缩放、张量归一化和多模态分词,直接返回 768 维或截断到 128 至 512 维的归一化向量;后者在设备上建索引并跑近似最近邻检索,官方称能给出个位数毫秒级的排序结果6。ML Kit 的版本官方说会在接下来几周推出,带 NPU 加速6。
最后一个用法值得单独提一句,因为它不需要训练数据,也不需要微调:把用户输入直接和一批分类标签的描述做相似度匹配,就是一个零样本的意图路由。官方给 MediaPipe Decision Task 的演示是在棋局里以不到 100 毫秒的响应时间、每轮评估 500 个候选项6。
References
- 1
- 2EmbeddingGemma 2 model card
ai.google.dev
- 3EmbeddingGemma 2: The Developer Guide
developers.googleblog.com
- 4MAEB: Evaluating Audio Embeddings at Scale
huggingface.co
- 5
- 6Bring multimodal semantic search to the edge with EmbeddingGemma 2
developers.googleblog.com
- 7google/embeddinggemma-2
huggingface.co
- 8Gemma Prohibited Use Policy
ai.google.dev
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.