奇绩信号Alpha Sight 2026年8月12日【文字版】
本期精选 8 月 11 日 arXiv recent 分组的十二篇 AI 论文,观察推理置信度、动力学外推、机器人价值、像素证据与安全护栏如何被拆成可检查接口。

本期判断
2026 年 8 月 11 日 arXiv recent 分组里,一个比单点榜单更强的共同信号是:模型正在把「判断是否可靠」从隐含直觉拆成可计算的中间接口。
Consilience 把推理的置信度轨迹变成搜索信号;LDR 把视频预测改写成可外推的动力学积分;RynnValue 用时间距离替代偏好标签来学习机器人价值;SHE 则把 Agent 安全拆成能被归因和演化的四类运行时资产。医疗分割、GUI 定位和科学视频生成进一步说明,真正的压力不在于模型能否给出一个看起来合理的答案,而在于答案能否和像素、布局、因果机制或安全边界对齐。
本期从 cs.AI、cs.LG、cs.CL、cs.CV、cs.RO 的 2026 年 8 月 11 日 recent 分组中精选十二篇,覆盖九个板块。入选论文详情页的 v1 日期均显示为 2026 年 8 月 10 日;正文以下以列表分组日期界定「最新」范围,以详情页和原文 HTML 核实方法、数字与图表。
阅读顺序建议:先看头条里的 Consilience、LDR、XPolicyLab 和 RynnValue,再根据关注方向进入认知模型、多模态、具身、Infra、Agent、应用体系或 Benchmark。若要判断是否值得复现,优先看每篇的实验条件和最后一条局限,而不要只看提升幅度。
头条
1. 置信度不是越高越好:Consilience 用「先探索、后收敛」筛选无验证器推理 Consilience
信号源:亚马逊云科技人工智能实验室
🧭
认知提取
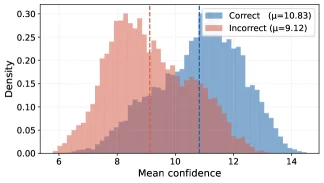
在没有编译器、测试用例或外部奖励模型时,测试时扩展只能依赖模型自身的信号。Consilience 的判断很反直觉:一条从开头就很自信的推理,可能只是很早锁定了错误方向;更可信的轨迹应当先保留分支,最后才形成高确定性。
论文摘要
• 论文针对无验证器测试时扩展中的置信度排序失效:复杂任务上,均匀偏高的置信度经常对应「没有探索」而不是「答案正确」。1
• 方法把每条推理的置信度序列看成一条轨迹,显式衡量前段与末段的时间不对称性;它惩罚过早的高置信度,同时要求最终状态保持足够确定。2
• 实验覆盖研究生级数学与自由形式代码生成,问题核心不是增加一个外部 verifier,而是从模型已有的 token-level confidence 中提取更有辨识力的组合信号。1
核心方法
• 先对同一问题采样多条推理,再对每条轨迹提取随时间变化的置信度;这一步不需要知道答案,也不要求调用外部执行器。
• combinatorial metric 将前缀探索和后缀确定性放进同一个评分:早期高置信度会被扣分,末端置信度则承担收敛约束。2
• 该设计把「搜索是否充分」作为 completion confidence 的一部分,因此更适合 verifier 不存在、昂贵或无法泛化的开放任务;但它仍然依赖模型内部置信度具有可比性。
实验成果
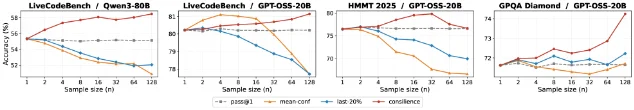
• 论文在数学和代码生成任务上报告 Consilience 超过现有无验证器基线;原文主张的证据是跨任务的相对提升,而不是某一个固定数据集上的单点特例。1
• Figure 4 的重点是轨迹形状:高置信度若从开头持续到结尾,并不等于更好;低开端、高收尾的轨迹更符合「先搜索、后确认」的认知过程。2
• 运行条件仍很重要:方法的额外成本主要来自多条 rollout,适用性取决于采样预算是否能抵消没有 verifier 的不确定性。
总结与反思
• 结果总结:Consilience 把置信度从单个终点分数改成一条搜索轨迹,在数学和代码生成上验证了「先低后高」比「始终很高」更有用。
• 局限性:论文依赖模型置信度和采样轨迹,未证明该模式在所有模型架构、语言或更长程 Agent 任务上都成立。
• 前沿见解:无验证器推理的下一步不是寻找一个万能自评器,而是识别一条候选答案经历了多少必要的探索。
2. 世界模型要学会动力学,而不是只记住像素:LDR 用隐空间积分做外推 LDR
信号源:加州大学圣迭戈分校、Adobe
🌐
认知提取
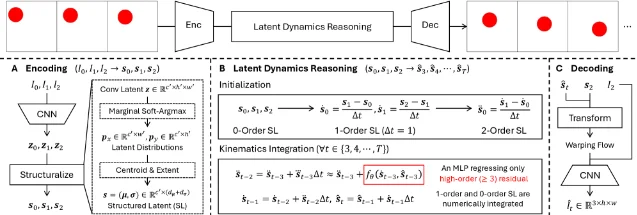
视频扩散模型可以生成看起来连续的画面,却不一定理解画面为何这样变化。LDR 把状态转移写成显式的运动学积分:低阶动力学由积分器处理,模型只学习三阶及更高阶残差,因此目标从「下一帧像不像」转向「离开训练分布后还能不能按规律运动」。
论文摘要
• LDR 针对视频扩散模型在 OOD 动力学上的脆弱性,把 latent transition 建模为结构化隐空间中的显式运动学积分。3
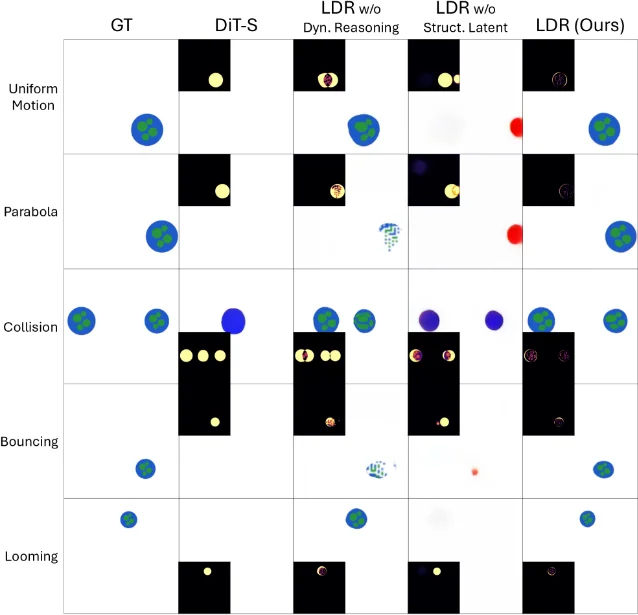
• 实验使用 PhyWorld 的五类受控物理任务:匀速运动、抛物线、碰撞、反弹和逼近;重点是检验模型是否学到规律,而非训练集内的像素拟合。4
• 论文报告 OOD 与 ID 误差间的差距比视频扩散基线小超过二十倍,同时参数量少二十六倍、运行速度快一百四十三倍。3
核心方法
• 将视频序列编码成结构化 latent state,再把状态的时间演化拆成低阶动力学和高阶 residual;积分器负责可解释的部分,网络负责难以手写的部分。
• 结构化 latent 不是普通卷积特征的简单压缩,而是为了让位置、速度和更高阶变化在滚动时保留可外推的组织形式。4
• 训练和评测同时包含单任务与联合任务,论文还测试从红球左向右迁移到蓝色方块右向左的严重外观与方向变化。
实验成果
• 相比视频扩散基线,LDR 的 OOD/ID error gap 缩小超过二十倍,参数量减少二十六倍,速度提高一百四十三倍;三组数字分别对应泛化、模型规模和推理效率。3
• 在红球左到右的训练条件下,LDR 能预测蓝色方块右到左的运动;这比同分布视频重建更接近世界模型需要承担的外推职责。4
• 五个任务都来自受控白盒物理环境,因而结果能清楚测量动力学误差,但不能直接等同于真实世界复杂遮挡、接触和多主体交互的泛化。
总结与反思
• 结果总结:LDR 用显式积分承担可预测的运动结构,只学习高阶残差,在受控物理外推上同时获得更小误差、更少参数和更低延迟。
• 局限性:当前证据主要来自白盒物理 benchmark;真实视频中的未知物体、遮挡和非刚体动力学仍未被证明同样有效。
• 前沿见解:视频世界模型的分水岭可能不是生成画面有多逼真,而是能否把画面变化压缩成可滚动、可外推的动力学状态。
3. 机器人生态需要标准接口:XPolicyLab 把策略—环境集成从乘法变成加法 XPolicyLab
信号源:香港大学多媒体实验室、清华大学
🔌
认知提取
机器人策略研究的隐性成本经常不在模型训练,而在把每个新策略接到每个新环境。XPolicyLab 不再让策略和环境两两定制适配,而是规定 observation、action、trajectory 和运行时接口,让异构性集中在一侧,另一侧可以复用。
论文摘要
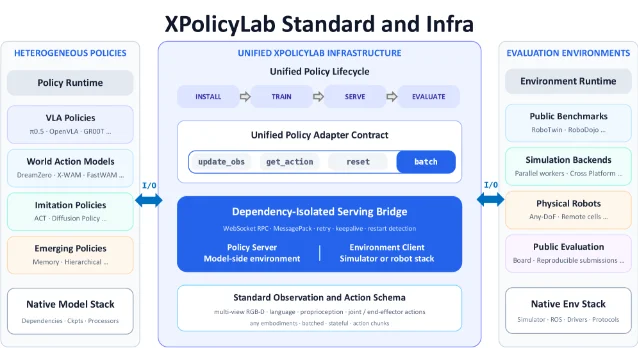
• 论文把机器人策略评测与部署的重复集成抽象为 N 个策略和 M 个环境之间的接口问题,目标是从 O(NM) 降到 O(N+M)。5
• 标准规定 observation、action、trajectory schema,以及 observation update、action prediction、batched execution 和 episode reset 等最小适配接口。6
• client/server 架构把 policy inference 与 environment execution 隔离,策略和环境可以保留各自的软件栈并在本地或远程运行。
核心方法
• 每个 policy adapter 负责把环境 observation 转成策略可用格式,再把策略 action 转回环境协议;环境侧不需要知道每个模型的内部依赖。
• server 负责启动、健康检查、推理和批量执行,client 负责环境交互;这让远程部署和本地调试使用同一套接口。6
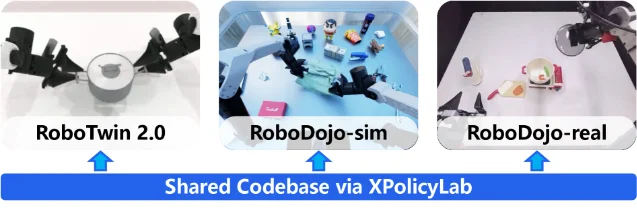
• 论文将同一 adapter 用于 RoboTwin、RoboDojo 仿真和标准化真实机器人评测,重点不是提出新 policy,而是减少复现实验中的工程分叉。
实验成果
• 生态已经集成四十二个 robot policies;在受控研究中,代表性 policy 的集成时间从超过五小时降到两小时,打包的 agent skills 再降到三十分钟。5
• 模型侧代码的差异缩小了一个数量级,而环境侧循环保持在几行固定参考实现内,说明标准确实把变化隔离在 adapter 一侧。6
• 三十分钟结果依赖已经封装好的 agent skill;第一次接入全新 policy 时,仍需处理依赖、权重、设备和动作空间等实际工程条件。
总结与反思
• 结果总结:XPolicyLab 用统一数据和运行时契约降低机器人策略的重复集成成本,并把仿真、真实机器人和远程服务放到同一接口下。
• 局限性:标准解决的是连接和评测可复现性,不自动解决不同策略的动作空间、传感器质量或任务定义是否真正可比。
• 前沿见解:具身智能的基础设施竞争,可能会从「谁有最多模型」转向「谁能让模型在更多环境里以同一协议被验证」。
4. 价值模型不再依赖偏好标签:RynnValue 用时间距离监督机器人奖励 RynnValue
信号源:阿里巴巴达摩院、湖畔实验室
⏱️
认知提取
机器人价值模型常常需要人工偏好或任务进度标注,而这些标注换一个 embodiment、视角或数据源就很难保持一致。RynnValue 改用「从当前观察走到语言目标还需要多久」作为统一监督,让时间戳本身成为跨数据集的 cost-to-go 信号。
论文摘要
• RynnValue 将 temporal distance 定义为 observation 到语言指定目标的有向时间距离,标签可以直接从时间戳构造,不需要偏好或归一化进度标注。7
• 训练规模超过七千小时、约三百万条 instruction-conditioned clips;作者通过随机时间采样、时间顺序打乱和 value-isolation attention 抑制时间位置捷径。8
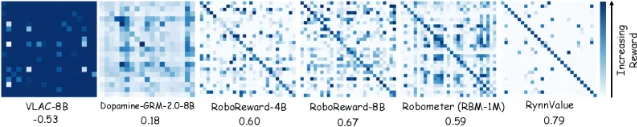
• 在 RBM-EVAL-OOD 上,RynnValue 的平均 Kendall tau-a 为零点六七五,高于完全偏好监督的零点六五五,也超过 progress-only 模型的零点二九二。7

核心方法
• random temporal sampling 避免模型把固定采样间隔当成进度线索;temporal-order shuffling 进一步切断序列位置与价值大小之间的捷径。
• value-isolation attention 让价值预测关注与目标进展有关的视觉状态,减少只看动作顺序、视频长度或数据集来源就能猜答案的机会。8
• 预测价值通过 potential-based shaping 转成奖励,既保留稀疏完成信号,也在轨迹中间提供连续反馈;这使模型可以接入 offline 和 online RL。
实验成果
• 四个真实世界操作任务的 online OOD 平均成功率为七十二点五%,高于 Robometer 的五十二点五%和 sparse reward 的四十八点八%;offline 平均成功率为八十二点五%,高于 Robometer 的六十三点八%。8
• 在 Bread Basket Placement 上,RynnValue 的 offline 成功率为一百%,平均使用十六点八个 action chunks;Robometer 为八十%、十八点九个 chunks,原始 SFT 为七十%、二十四点八个 chunks。8
• Box-in-Drawer Placement 仍是难点:从同一五十%成功率的 offline-RL checkpoint 出发,online RL 用 Robometer 达到六十五%,用 RynnValue 达到七十%,说明第三视角 RGB 对精确抓取和对齐仍然不够。
总结与反思
• 结果总结:RynnValue 用时间距离替代偏好标签,在跨任务、embodiment 和视角的价值排序上取得强信号,并显著改善真实机器人策略学习。
• 局限性:当前 temporal distance 更接近最短时间目标,尚未充分表达能耗、安全、精度或多目标代价;在线流式长时程预测也仍待扩展。
• 前沿见解:通用机器人奖励模型的关键不一定是更复杂的偏好标注,而是找到能把异构轨迹放进同一坐标系的自然监督。
认知模型
5. Token 一致不等于推理一致:TIDE 修正 on-policy distillation 的过量与缺失 token TIDE
信号源:香港大学、中国科学技术大学、香港中文大学
🧠
认知提取
学生模型可以通过重复循环,让自己生成的 token 看起来和教师高度一致,但整个回答仍然是坏的。TIDE 不再把 token agreement 当作唯一目标,而是把 mismatch 拆成两种方向:学生多生成了教师不认可的 excess,或没有生成教师偏好的 deficit。
论文摘要
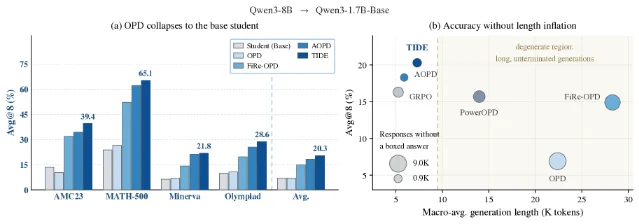
• degenerate agreement 指学生用重复前缀制造近乎完美的 token agreement,却得到全局错误的回答;论文将其作为标准 OPD 的失效模式。9
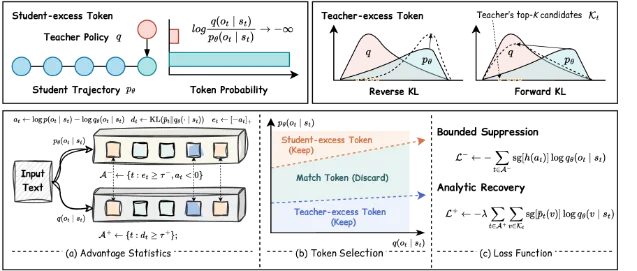
• student-excess token 的 teacher probability 接近零,直接使用 log-ratio 会产生无界且不稳定的修正;student-deficit token 则是教师偏好但学生很少采样到的 token。10
• TIDE 用有界 Hellinger shaping 压制 excess,用解析的 teacher top-K injection 补回 deficit,不要求 deficit token 必须先被学生采样。9
核心方法
• 先根据教师和学生的 token 分布识别 mismatch 方向,再分别处理 excess 与 deficit,而不是用一个对称的 KL 惩罚把两类问题混在一起。
• Hellinger shaping 给 sampled excess 的修正设上界,减少极端 log-ratio 对更新的破坏;top-K injection 则直接把教师缺失概率质量注入学生分布。10
• 训练目标仍然是 on-policy:学生在自己的分布上生成,再由教师提供分布信息;因此它针对的是部署时真实会遇到的偏移,而非只在 teacher-forcing 分布上拟合。
实验成果
• 在强 teacher–student mismatch 条件下,TIDE 将 Avg@八从六点九%提升到二十点三%,平均回答长度缩短三点六倍,并显著减少格式失败。9
• 论文报告 greedy teacher decoding 在九十三%的案例中保留学生诱导的循环;这解释了为什么表面 token agreement 会被重复前缀伪造。10
• 增益在教师和学生差距越大时越明显,说明 TIDE 的价值更接近「修正分布错位」,而不是为所有蒸馏任务增加一个固定正则项。
总结与反思
• 结果总结:TIDE 将 OPD 的对齐目标从 token agreement 细分为 excess 抑制和 deficit 恢复,在强 mismatch 条件下同时提高准确率、缩短回答并减少格式失败。
• 局限性:实验围绕 Qwen3 教师—学生对和数学推理展开,top-K 规模、教师质量和非推理任务上的稳定性仍需进一步验证。
• 前沿见解:蒸馏的关键问题不是学生说了多少相同 token,而是哪些教师认为重要的 token 从未进入学生的可选空间。
多模态
6. 医疗推理必须落到像素:MedPixel 用共享语言—掩码接口统一分割与问答 MedPixel
信号源:浙江大学、复旦大学、北京快手、华东师范大学、上海人工智能实验室
🩺
认知提取
医学 VLM 会描述图像,却可能指不准病灶;分割模型能画出轮廓,却通常不理解「为什么要找这个目标」。MedPixel 把语言生成和 mask 预测放进同一接口,并用 ground-truth mask 充当离线 verifier,让回答中的临床推理和像素边界彼此约束。
论文摘要
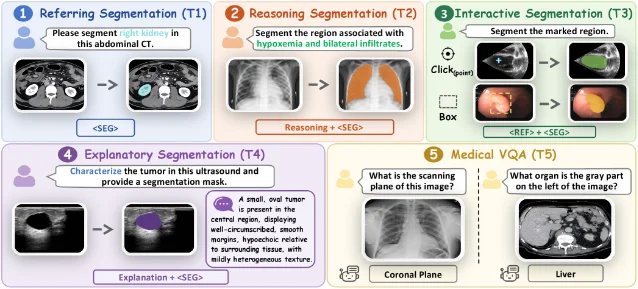
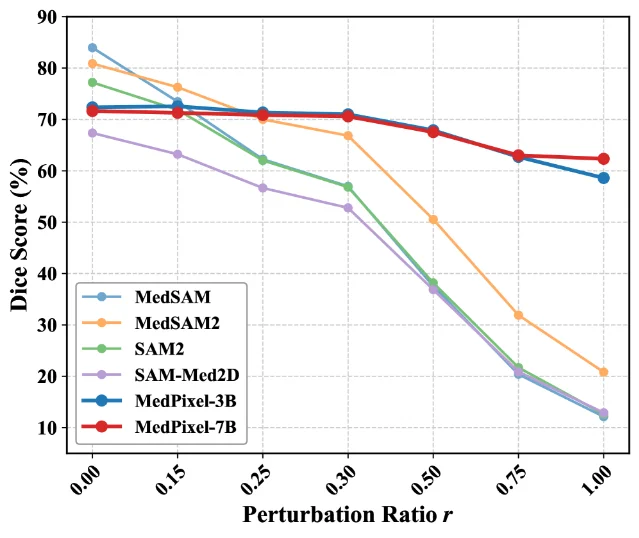
• MedPixel 覆盖五类接口:明确目标分割、隐式推理分割、点或框交互分割、解释性分割和医疗 VQA。11
• MedPLG-440K 包含约四十四万条 pixel-language task samples,通过临床动机驱动的合成流程构造,不依赖外部 LLM 标注;训练先做多任务 SFT,再做 Pixel-Level Preference Optimization。12
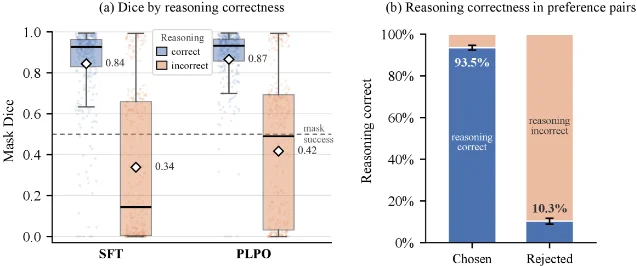
• PLPO 用 mask 质量从离线结果中推导偏好,把「说得对」和「画得准」的关系显式写入优化目标。
核心方法
• 语言模型生成响应,同时通过共享的 language–mask interface 预测分割结果;不同任务只改变目标描述和空间提示,不需要切换专用模型。
• Stage 1 用 MedPLG-440K 做多任务监督微调,Stage 2 固定分割投影和 mask decoder,用 PLPO 强化生成表示与像素质量的对齐。12
• 交互分割不把 bounding box 当作真实 mask 直接复制,而是结合图像内容和目标语义恢复边界,因此可以检验模型对不精确空间提示的鲁棒性。
实验成果
• T1 referring segmentation 上,MedPixel-7B 达到八十五点零 Dice 和六十一点七 NSD,分别超过 BiomedParse 五点零和六点七;T2 reasoning segmentation 与 T4 explanatory segmentation 相对最强基线分别提升二十九点二和四十点七 Dice。12
• 在 T3 原生交互接口中,MedPixel 达到七十六点零 Dice;T5 图像和文本多选题分别超过最强基线五点五和七点零。12
• 零样本 MeCoVQA-G+ 上,MedPixel-7B 相比 BiomedParse 在 slice-level Dice 提升五点三,在 modality-level Dice 提升三点四,HD95 从二百二十四点三/一百七十七点一降到一百五十二点三/一百二十三点零。12
总结与反思
• 结果总结:MedPixel 将医学语言推理、像素分割、空间交互和 VQA 放进统一模型,并用 mask verifier 改善推理—定位对齐。
• 局限性:严重框偏移可能直接移除目标区域;临床部署还需要更严格的病例级验证、校准和责任边界,不能把 benchmark Dice 当作诊断能力。
• 前沿见解:多模态医疗模型的可靠性接口不应停在文本解释,而要让解释能够被像素级结果反向检查。
具身智能
7. 不预测所有像素,只预测与动作有关的未来:SLIM-0.5B 做紧凑操控策略 SLIM
信号源:复旦大学、北京智源人工智能研究院、清华大学、中国人民大学
🦾
认知提取
通用 VLA 的大部分参数用来理解开放世界语义,但连续操控更需要知道「这个动作会让什么发生变化」。SLIM 不训练昂贵的像素级世界模型,而是学习 action-grounded predictive latents:用动作解释已经发生的变化,再预测动作之后与控制相关的未来状态。
论文摘要
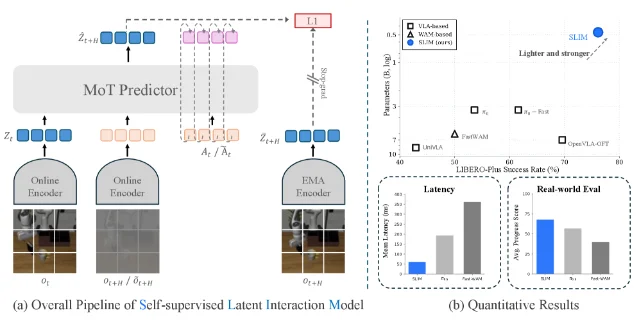
• SLIM 是零点五 B 参数的 latent interaction policy,通过 self-supervised masked trajectory prediction 学习 action reconstruction 和 future-latent prediction。13
• 紧凑的 Mixture-of-Transformers backbone 让 observation latents、连续 action tokens 和 predictive future slots 交互,最终用 flow matching 生成语言条件动作。14
• 论文在仿真和真实机器人上与更大规模 VLA、world-action-model 基线比较,重点观察参数量、推理延迟和 GPU memory,而不只看任务成功率。
核心方法
• inverse dynamics 根据当前和未来 observation 解释被加噪的 action;forward dynamics 根据当前 observation 和干净 action 预测未来 observation latent,两个目标分别约束「动作从哪里来」和「动作会带来什么」。
• objective-specific attention masks 控制信息流,避免 forward 目标偷看未来,也避免 inverse 目标退化成只记动作模板。14
• Stage 1 学 action-grounded latent,Stage 2 再训练语言条件动作生成;这让开域语义骨干不必承担所有连续控制细节。
实验成果
• 摘要报告 SLIM 在仿真与真实评测中达到或超过代表性大模型基线,同时使用更少参数、更低推理延迟和更少 GPU memory,且不需要额外 embodied pretraining。13
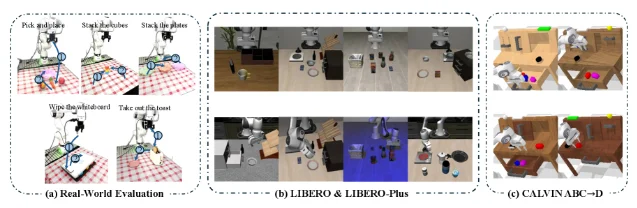
• 真实世界评测包含干扰物、背景纹理和光照变化;Figure 6 与 Figure 11 按设置和任务展示平均 progress,重点是动作相关 latent 是否在外观变化下保持控制信号。14
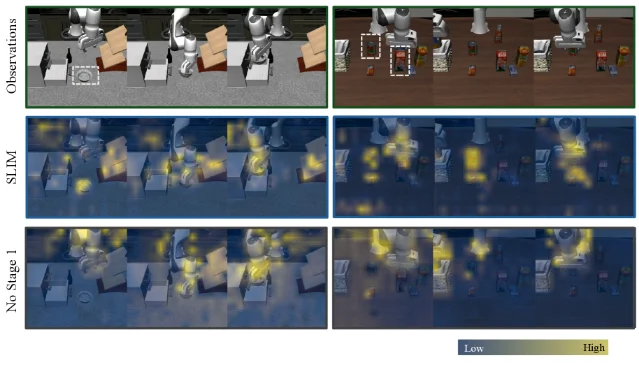
• Figure 8 的 attention analysis 显示,SLIM 更稳定地关注被操作物体、夹爪和交互区域;这是机制证据,但仍不能替代跨平台 success rate 的完整复现。
总结与反思
• 结果总结:SLIM 用零点五 B 参数的动作相关 latent 替代昂贵的像素未来预测,在仿真和真实操控中兼顾能力与部署成本。
• 局限性:摘要没有给出单一跨 benchmark 的统一成功率,真实任务进展还受平台、动作 chunk 和评测协议影响;要复现需完整核对附录设置。
• 前沿见解:具身模型的压缩方向不只是减少视觉 token,而是只保留那些能改变下一步动作判断的状态变量。
AI4Science
8. 用最优传输防止 latent token 塌缩:MoNo 在一般几何上求解 PDE MoNo
信号源:北京科技大学、北京工业光谱成像工程研究中心
🧮
认知提取
神经算子把空间观测压成 latent token 后,常见问题不是 token 太少,而是分配不均:有的 token 被过度使用,有的几乎没有信息,层层下采样后就出现 token collapse。MoNo 用熵正则最优传输构造平衡的双向投影,让多尺度空间真正保留不同范围的物理关系。
论文摘要
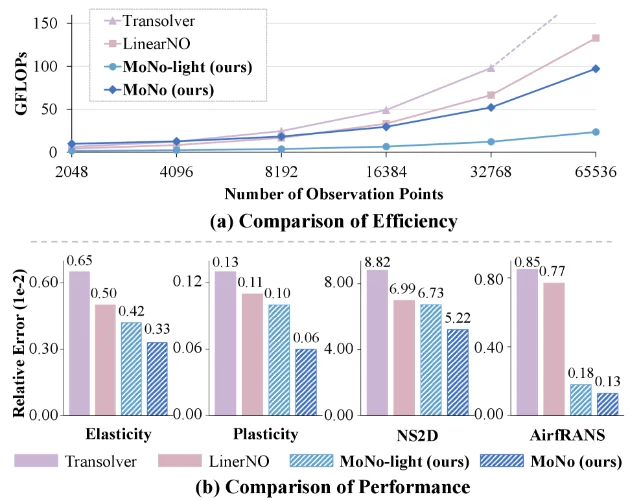
• MoNo 发现现有可学习投影无法稳定、均衡地把观测点分配到 latent token,失衡会在更深的 latent space 中继承并放大。15
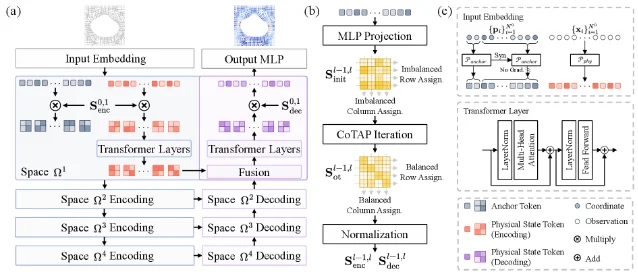
• CoTAP 将相邻 latent space 间的 assignment 写成熵正则最优传输问题,构造平衡的 encoding 与 decoding projection,并把该过程推广到渐进式多尺度架构。16
• 评测覆盖标准 PDE benchmark、AirfRANS 一般几何与 OOD 条件,同时比较 prediction error、参数量和 GFLOPs。
核心方法
• 给定物理场观测,模型先编码空间位置和输入值,再在多个 latent space 中学习长程物理交互;不同空间承担不同范围的结构。
• CoTAP 先构造初始 assignment matrix,再用 Sinkhorn 风格迭代得到平衡矩阵,随后归一化为 encoding 和 decoding projection。16
• progressive multiscale 建模让信息在不同分辨率之间稳定传递;其关键不是增加一个更深的 Transformer,而是改变观测点到 token 的分配几何。
实验成果
• Darcy、NS2D、Elasticity 和 AirfRANS 等任务上,论文报告 MoNo 超过现有神经算子,同时具有更低预测误差和更高计算效率。15
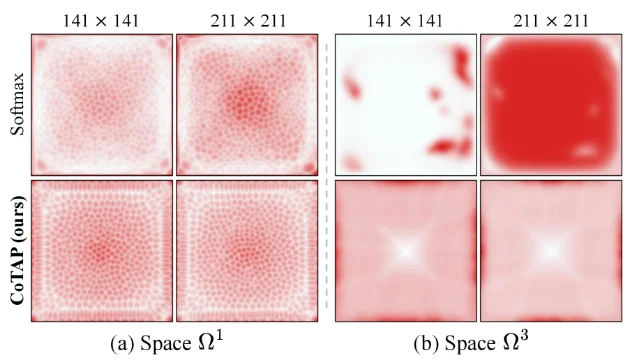
• assignment heatmap 显示,Softmax 投影在第一 latent space 就有不均衡,在深层出现严重 token collapse;MoNo 的 assignment 更平衡并保持跨空间一致。16
• 消融覆盖 CoTAP、progressive multiscale、token 数量和 Sinkhorn 迭代,说明误差下降不是单一更大 backbone 的结果;但不同几何和 Reynolds/OOD 协议仍需分别看表格条件。
总结与反思
• 结果总结:MoNo 把 latent token collapse 归因到投影分配失衡,并用最优传输构建适合一般几何的多尺度神经算子。
• 局限性:最优传输迭代本身会带来额外开销,具体效率优势依赖输入点数、token 数量和 GPU memory 协议。
• 前沿见解:科学模型的 token 化不能只追求压缩率,还要检查每个 token 是否真正承担了可区分的物理区域或尺度。
Infra
9. 私有数据不出客户端也能组合专家:DistMoE 做无 rehearsal 的分布式视觉指令调优 DistMoE
信号源:特伦托大学、布鲁诺·凯斯勒基金会、贝加莫大学
⚙️
认知提取
分布式多模态训练的矛盾是:每个客户端拥有有价值的领域数据,却不能把数据集中起来;独立训练出的专家又往往尺度不同、难以合并。DistMoE 不强迫客户端共享原始数据,而是用公共 FFN 做锚点,只在公共数据和本地数据上校准 router 与轻量 adapter,推理时再按 token 组合专家。
论文摘要
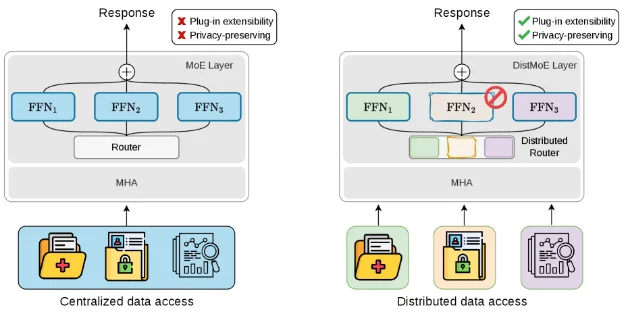
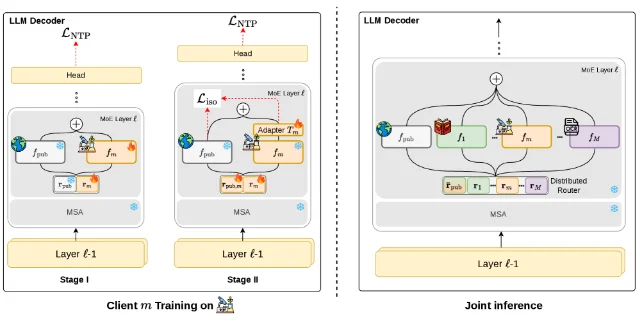
• DistMoE 在语言解码器每层的 public FFN 旁增加 client-specific private FFN expert,让私有领域知识保持在客户端侧。17
• Stage I 各客户端独立训练私有专家;Stage II 冻结专家,只用 isotropic residual regularization 和 next-token loss 校准 router 与轻量 projection adapter。18
• 推理时采用 sparse routing,在没有显式 domain label 的情况下按 token 组合 public 与 private experts,支持专家的添加、移除和复用。
核心方法
• public FFN 作为共同坐标系,减少不同私有专家在表示尺度和方向上的 drift;客户端只上传或共享组合所需的参数接口,不交出原始样本。
• Stage II 使用少量 public calibration data 与本地数据做 rehearsal-free composition;它并非完全无数据,而是不需要跨客户端重新收集私有训练数据。18
• inference router 通过 top-k 稀疏选择激活专家;实验还逐个移除 client expert,检查系统是否过度依赖某一个领域模块。
实验成果
• 在多项视觉语言 benchmark 上,DistMoE 超过 distributed merging 与 routing 基线,并保留模块化控制;论文同时提供 DistMoE-LoRA 作为参数高效替代。18
• Qwen-1.8B、Phi-2.7B 和 StableLM-1.6B 的 routing mass 图显示,经过 Stage II 后模型在激活 private experts 的同时保留更高 public-expert 权重,支持「公共锚定」这一机制解释。18
• 移除单个 client expert 后,多数设置仍强于 public model,但某些指标反而上升,提示领域专家之间存在负迁移;因此可复用不等于所有专家都应同时启用。
总结与反思
• 结果总结:DistMoE 用公共 FFN 作为锚点,把私有专家的训练和推理组合解耦,在不 rehearsal 跨客户端私有数据的前提下完成视觉领域适配。
• 局限性:集中式或带 rehearsal 的 MoE 在部分 benchmark 仍更强;Stage II 依赖一小组公共校准数据,完全没有公共数据的场景还未解决。
• 前沿见解:分布式专家系统的关键接口不是「把所有专家平均混合」,而是让路由器知道何时保留公共能力、何时调用私有知识。
Agent
10. 安全护栏也需要进化:SHE 从轨迹失败中学习四类 Agent 运行时边界 SHE
信号源:上海人工智能实验室、复旦大学、上海交通大学、香港科技大学
🛡️
认知提取
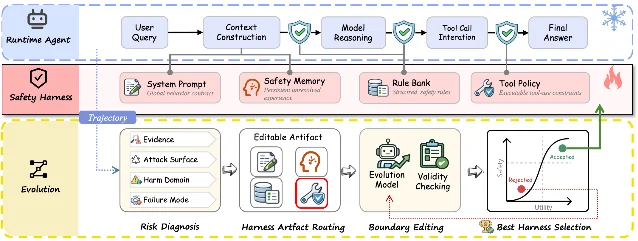
Agent 的风险不只来自模型参数,也来自 system prompt、规则、记忆、工具权限和运行时控制如何共同工作。SHE 把安全 harness 拆成四种责任边界,再从 rollout trajectory 中诊断失败属于哪一类资产,局部更新后用安全—效用验证决定是否保留。
论文摘要
• SHE 将 harness 分解为 System Prompt、Rule Bank、Safety Memory 和 Tool Policy 四类 artifact,明确每类组件的安全职责。19
• attribution-guided evolution loop 将轨迹失败转成结构化 diagnosis,再产生 artifact-specific boundary refinement,并用 safety–utility validation 选择新版本。20
• 在 Agent-SafetyBench 上,SHE evolved 相比 static SafeHarness 将 ASR 从八点六%降到五点五%,同时把 average UA 从三十三点五%提高到四十七点六%。20
核心方法
• 失败诊断同时记录 harm domain、attack surface 和 failure mode,让「模型拒绝错了」与「工具策略放行错了」进入不同修复路径。
• 演化候选不是自动覆盖旧版本,而是与 seed harness 做 safety、clean utility 和 attack utility 的联合验证;候选若只改善单一指标,会被拒绝。20
• 最优版本可跨模型迁移:在 DeepSeek-V3.2 上演化出的 harness 被直接应用到 Kimi K2.6、GLM-5.2 和 MiniMax M2.7,无需额外 evolution。
实验成果
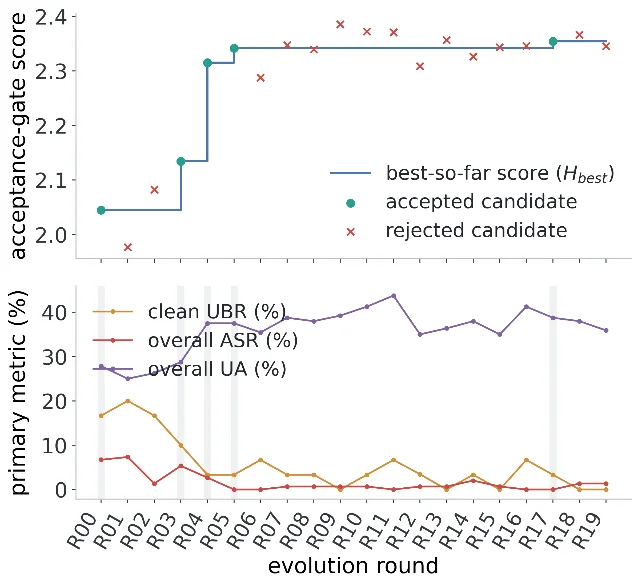
• Agent-SafetyBench 上,SHE evolved 将平均 ASR 从八点六%降至五点五%,Clean UBR 从二十五点七%降至十九点八%,平均 UA 从三十三点五%升至四十七点六%。20
• 在未参与演化的 AgentHarm 上,SHE evolved 的 Harm Score 为九点八%、Harm Refusal 为八十六点四%,在对比方法中同时取得较低伤害和较高拒答。20
• 演化历史显示,系统在 R00、R03、R04、R05 和 R17 接受更新,其余候选被保留为负证据;这说明「不更新」本身也是安全演化的一部分。
总结与反思
• 结果总结:SHE 把 Agent 安全从固定部署配置改成可归因、可演化、可回滚的架构属性,并在 held-in、held-out 与跨模型迁移上给出证据。
• 局限性:演化依赖轨迹诊断器、评测集和安全—效用目标;当新风险没有进入 rollout 分布时,护栏仍可能没有可学习的边界。
• 前沿见解:Agent 安全的最小可维护单元可能不是一条总规则,而是能被定位、更新和验证的运行时 artifact。
应用体系
11. GUI 定位不必回归坐标:Layout-Aware Matching 把语义理解和精确落点拆开 GUI Grounding
信号源:北京大学电子与计算机工程学院
🖱️
认知提取
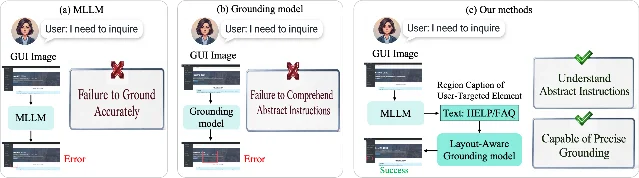
GUI Agent 的难点不是只认出「关闭按钮」,而是根据「File Explorer 窗口右上角的关闭按钮」找到正确实例。端到端 MLLM 擅长理解抽象指令,却容易幻觉坐标;传统 grounding 模型能找局部区域,却缺少文本和布局语义。论文将两者拆成冻结 MLLM 的指令解释和专门模型的布局匹配。
论文摘要
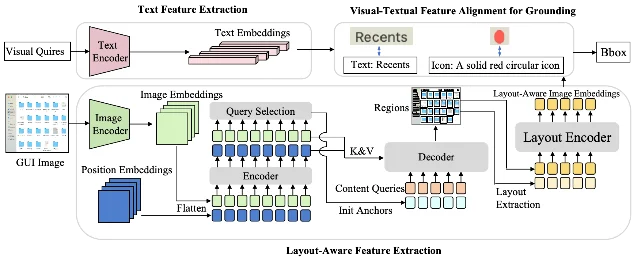
• 冻结 MLLM 先把抽象用户指令扩展成包含文字、图标和空间布局线索的 structured visual caption,再交给 layout-aware grounding model。21
• grounding model 不学习 coordinate regression,而是基于 layout-prior candidates 做回归无关的匹配;训练只需要 Text/Icon binary labels。22
• 论文用源码包核验作者机构为北京大学电子与计算机工程学院;正文 HTML 本身未完整展开机构,因此机构信息以原始 TeX 为准。23
核心方法
• text feature extraction 将视觉 query 编成同时承载文字和图标语义的 embedding;layout-aware image feature extraction 将 GUI image embedding 与 position embedding 融合。
• decoder 以 content queries 和 initial anchors 生成候选区域,再由 layout encoder 形成布局感知特征,最终做 visual-textual feature alignment。22
• 训练数据从二十万张 GUI 图像中抽取文字和图标区域,再用 Qwen3-VL 生成 region caption;这使监督重点从精确坐标标注转向文字/图标类别和布局关系。
实验成果
• ScreenSpot-Pro 上,方法相对端到端系统的 grounding accuracy 提升超过二十%;Mind2Web 上,success rate 和 element selection rate 均提升超过十五%。21
• Figure 4 展示 instruction elaboration、icon detection、text recognition 和最终 localization 的链条,说明收益来自语义解释与布局匹配的解耦,而不只是更强的视觉 backbone。22
• ScreenSpot、ScreenSpot-Pro、AITW 和 Mind2Web 的任务口径不同,提升不能直接折算成一个通用 GUI Agent 成功率;部署还需要处理分辨率、窗口缩放和点击安全策略。
总结与反思
• 结果总结:GUI Grounding 用冻结 MLLM 负责理解,用布局感知匹配负责精确定位,在不做坐标回归的条件下减少坐标幻觉。
• 局限性:训练数据仍需要区域解析和生成式 caption,且方法对布局先验和候选区域质量敏感;复杂动态界面上的持续交互尚未充分验证。
• 前沿见解:GUI Agent 的可靠执行可能需要把「我理解了指令」与「我知道该点哪里」作为两个可独立审计的接口。
Benchmark
12. 科学视频生成的瓶颈不是画质,而是机制:Sci-VBench 用专家规格评测因果正确性 Sci-VBench
信号源:浙江大学、中国科学院大学、同济大学、耶鲁大学
🔬
认知提取
视频生成模型可以让物体运动得很流畅,却仍然把膝跳反射、折射或因果触发机制做错。Sci-VBench 把科学视频评价从「看起来像不像」推进到「是否遵守题目指定的知识和动力学」,并为每个样例发布 reference guide 与评分 rubric,使非专家和 MLLM judge 也能沿着同一标准复核。
论文摘要
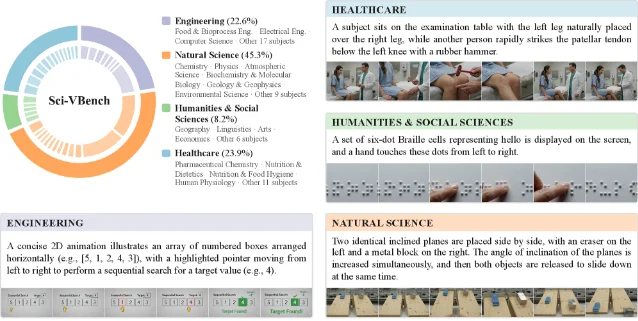
• Sci-VBench 含一千二百五十三个专家标注样例,覆盖六十个 subject、自然科学、医疗、社会科学与人文、工程四大领域。24
• 每个样例配有高层 reference guide 和按维度拆开的五级 rubric,评测 Prompt Grounding、Scientific and Causal Correctness、Spatiotemporal Consistency 和 Low-level Perceptual Fidelity。25
• benchmark 提供 full 的一千二百五十三例和用于低成本迭代的 testmini 一百五十例,并测试专家、非专家和 MLLM-based judge 之间的可迁移性。

核心方法
• 构造流程由领域专家设计 prompt、reference guide 和 rubric,第二位专家逐条检查机制是否可在视频中观察、三者是否一致;随后对随机样本做独立重写和复评分。
• 自动协议中,VBench-based Vision Tools 负责低层感知质量,其余三个维度由带 rubric 的 MLLM judge 评分;每个 video–dimension pair 独立评三次取均值。25
• 源码包核验作者机构为浙江大学、中国科学院大学、同济大学和耶鲁大学;HTML 首页与原始 TeX 的机构信息一致。26

实验成果
• 提供 evaluation specification 后,非专家与专家的 Pearson correlation 在四个维度都提高:LPF 从八十三点二升至八十四点七,PG 从七十四点一升至八十三点三,SCC 从六十八点二升至八十二点五,SC 从七十点三升至七十九点六。25
• 十六个视频生成模型的自动 VT 分数集中在三点七九至四点一二,但自动 Scientific and Causal Correctness 横跨一点二四至三点三四;视觉画质已经相对饱和,机制正确性仍能显著拉开差距。25
• Gemini-Omni-Flash 的自动平均为三点三八、人工平均为三点一八;开源组中 MiniMax-H3 在 SCC 上为一点六三,而 Wan2.2-5B 在 Spatiotemporal Consistency 自动评分上达到二点七九,说明不同模型的强项并不统一。25
总结与反思
• 结果总结:Sci-VBench 用专家规格把科学视频生成的评测重心从外观质量移到指令、机制和时空因果,并证明规格能提高非专家复核的一致性。
• 局限性:商业模型只在 testmini 上评测,部分服务还存在 prompt 过滤和时长差异;自动 judge 仍可能难以识别细粒度时序瑕疵。
• 前沿见解:生成模型的「真实性」需要领域条件来定义;没有 reference guide 的漂亮视频,不能证明它理解了科学过程。
结尾:把中间状态变成可检查接口
今天的十二篇论文并不是一份简单的模型榜单,而是从不同层级回答同一个问题:当系统无法依赖一个完美 verifier 时,什么中间状态可以帮助我们判断它是否真的可靠?
Consilience 检查推理置信度的时间形状,TIDE 检查教师—学生分布的缺口;LDR 和 RynnValue 把世界演化与任务进展写成可学习的时间结构;SLIM 和 MoNo 则分别在机器人动作与 PDE latent 中寻找不必保留全部像素、但不能丢掉的关键状态。
XPolicyLab、DistMoE、SHE 和 GUI Grounding 将接口放到系统层:策略与环境、公共与私有专家、安全 artifact、语义理解与坐标定位都被拆成可以单独验证的组件。MedPixel 和 Sci-VBench 最后把同一原则推进到多模态证据:文本结论要和 mask、机制和 rubric 对齐。
读者可以据此决定下一步:要复现模型,先核对图表对应的训练规模、OOD 协议和运行成本;要部署系统,优先检查失败是否能被归因到一个可更新接口;要做技术跟踪或投资判断,则重点看提升是否绑定在清晰的证据结构上,而不是只看一次性的榜单数字。
References
- 1Consilience 原文摘要
arxiv.org
- 2Consilience HTML 正文
arxiv.org
- 3LDR 原文摘要
arxiv.org
- 4LDR HTML 正文
arxiv.org
- 5XPolicyLab 原文摘要
arxiv.org
- 6XPolicyLab HTML 正文
arxiv.org
- 7RynnValue 原文摘要
arxiv.org
- 8RynnValue HTML 正文
arxiv.org
- 9TIDE 原文摘要
arxiv.org
- 10TIDE HTML 正文
arxiv.org
- 11MedPixel 原文摘要
arxiv.org
- 12MedPixel HTML 正文
arxiv.org
- 13SLIM 原文摘要
arxiv.org
- 14SLIM HTML 正文
arxiv.org
- 15MoNo 原文摘要
arxiv.org
- 16MoNo HTML 正文
arxiv.org
- 17DistMoE 原文摘要
arxiv.org
- 18DistMoE HTML 正文
arxiv.org
- 19SHE 原文摘要
arxiv.org
- 20SHE HTML 正文
arxiv.org
- 21GUI Grounding 原文摘要
arxiv.org
- 22GUI Grounding HTML 正文
arxiv.org
- 23GUI Grounding 原始 arXiv 源码
arxiv.org
- 24Sci-VBench 原文摘要
arxiv.org
- 25Sci-VBench HTML 正文
arxiv.org
- 26Sci-VBench 原始 arXiv 源码
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.