快 4 倍、单台 8 卡节点容纳上万 token:Claude 优化了 30 多个开源生物模型的推理
解读 Anthropic 2026 年 9 月 17 日的官方研究:Claude 把 30 多个开源生物模型的推理压快约 4 倍,并让单台 8 卡节点承担上万 token 的体系预测,而设计端那笔「约 100 倍算力削减」的账只算到了 in silico。

Anthropic 在 2026 年 9 月 17 日公开了一份针对生物分子建模的官方研究:让 Claude 去优化科研人员日常使用的开源模型在推理时的时间与显存开销。不到四周,Claude 为 36 个模型实现产出了优化包,覆盖 30 多个开源模型,官方给出的平均加速约为 4 倍;它同时做出一个低显存模式,让超过 10,000 token 的生物分子体系能在一台 8 卡 NVIDIA 节点上被准确预测1。全部优化代码当天开源2。
这些数字量的是运行成本。每一个优化包都沿用原作者的权重,改的只是计算怎样执行,模型能预测什么保持不变3。
与技术报告一起出现的还有一件赛事:Anthropic 与 Adaptyv Bio 联合主办一场蛋白设计竞赛,出至多 100 万美元的 Claude 额度和至多 100 万美元的湿实验验证,合计测 5,000 条以上设计14。它在整份材料里的位置很关键:这次工作没有做的那一步验证,被明确安排在了那里。
三角操作是瓶颈,FlashPairformer 改的就是这一层
现代结构预测模型——AlphaFold3、OpenFold3、Boltz-2——把大部分运行时间和显存花在两个操作上:三角注意力(triangle attention)与三角乘法(triangle multiplication)。这两个操作让模型能推理生物分子的几何关系,代价是对 token 数的三次方:体系规模翻一倍,时间和显存各涨约 8 倍3。
降低这个代价的标准办法是写 kernel。报告把它定义为「面向 GPU 这类加速硬件的低层软件转换层」,也就是把大量小算子融合、调度成少数效率更高的算子。NVIDIA 为这两个操作专门写过 kernel,先是 cuEquivariance,更近期是 BioNeMo Inference Runtime(BioNeMo-IR)356。
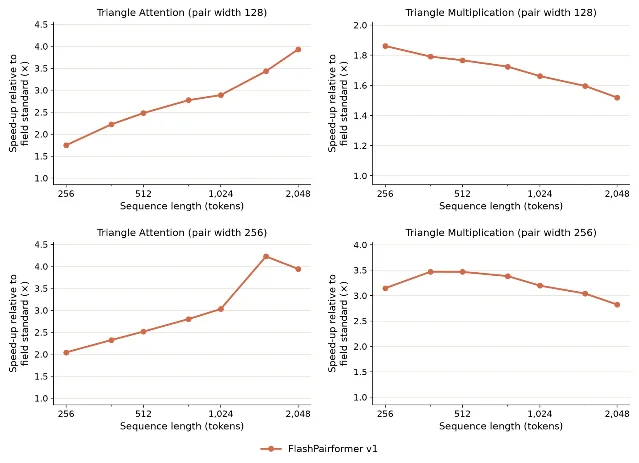
Anthropic 与 Claude 一起写出了 FlashPairformer v1。在 AlphaFold3 与 Boltz-2 使用的 pair width 128 上,它的三角注意力比 cuEquivariance 快 2.7 倍、三角乘法快 1.7 倍;在 Protenix v2 使用的 pair width 256 上,两个数字是 2.9 倍与 3.2 倍。这些是 7 个输入尺寸(256 到 2048 token)上的几何平均,单张 H100,而且 v1 在每一个尺寸上都更快3。
基线这一处要单独记住:报告把 cuEquivariance 称作 field standard 并拿它作对照,它自己在引言里也点名了更新近的 BioNeMo-IR,但没有解释为什么不用后者作基线3。
36 个包、三种模式,各自承诺什么
跨模型通用的 kernel 只覆盖一部分收益。报告还让 Claude 针对每个模型单独找优化,常见的改动有几类:把原代码反复重复计算的中间结果缓存下来;把结果恒定的分支折叠成常量;把 GPU 操作捕获成 CUDA graph 一次性回放,省掉 Python 逐次调用的开销;把小算子链融合成单个 kernel;把张量留在 GPU 上,避免主机与设备之间来回搬运;把数据加载和输出写回改成异步,让 GPU 不必等 CPU3。
这些改动被封装成最多三个模式:
| 模式 | 承诺 | 检查方式 |
|---|---|---|
| Exact | 输出与未修改的模型逐位相同,只改计算怎样执行 | 与原模型逐位比对;11 个配置中的 10 个在确定性设置下通过了这项检查3 |
| Fast | 允许改动结果,例如更低精度算术、舍入不同的融合 kernel | 要求输出落在 default 自身的种子间波动范围内3 |
| Big | 降低峰值显存,让更大的输入装得下 | 检查方式与 Fast 相同3 |
Big 的做法是把最大的中间张量分块处理,或者在多卡上把 pair representation 拆到同一台机器的多张卡上3。
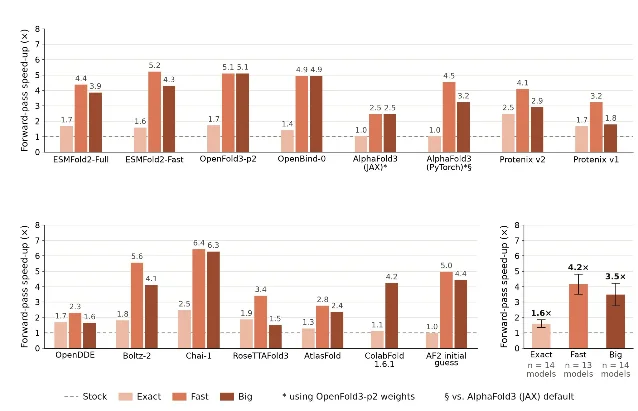
速度读数是:Fast 在 13 个结构预测模型上平均快 4.1 倍,区间从 2.3 倍(OpenDDE)到 6.4 倍(Chai-1);Exact 在 14 个模型上平均快 1.6 倍;Big 是 3.4 倍。基因组模型与蛋白语言模型的 Exact 模式快 1.2 到 5.0 倍3。
那个 4 倍对照的「default」需要单独说明。报告给 baseline 起的这个名字,指的是一个内行用户在同一张 GPU 上能拿到的最快的正确配置——打开模型自带的可选融合 kernel、用能跑满 GPU 的 batch size,或者让多个进程共用一张卡。报告把完全按原样跑的那一份另称作 base,两者有差异的地方逐条写在补充材料里3。
两处口径要一起记下。官方博客的正文把 Exact 的加速写成「接近 2 倍」,同一篇博客那张柱状图的图注写的是「约 1.6 倍」,报告正文也是 1.6 倍(14 个模型)13。另外,Exact 与 Fast 的峰值显存可能高于 default,最多到 3.2 倍;显存是限制条件时该用 Big,而不是这两个更快的模式3。
1,925 个模型–目标对:精度变化测到了什么程度
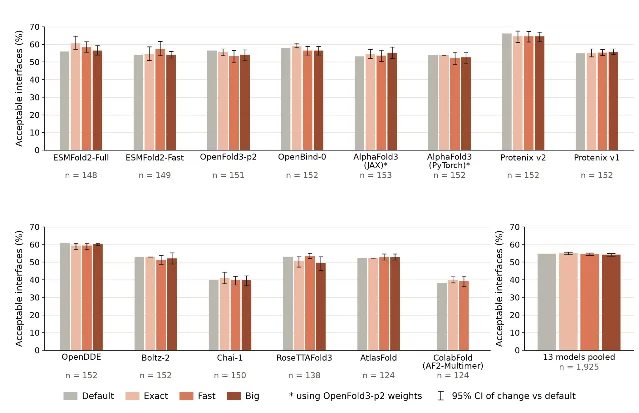
精度这一边,报告对除 AF2 initial guess 以外的每一个结构预测模型都做了检查。基准是 FoldBench-Lite,界面用 DockQ 打分,DockQ 不低于 0.23 判为可接受,这正是 CAPRI 可接受档的门槛;单链用 lDDT3。
池化到 13 个模型配置、1,925 个「模型–目标」对之后,可接受界面的比例是 default 54.8%、Exact 55.0%、Fast 54.5%、Big 54.2%。三个变化分别是 +0.2、−0.4、−0.6 个百分点(按四舍五入前的数值计算),95% 置信区间都不排除零3。
「没有可测量的变化」这句话在逐模型那一层要打个折。41 个与 default 的逐模型比较里,只有 ESMFold2 的 Exact 一项让置信区间排除了零(+4.6 个百分点);同时有六个区间正好落在零上,其中包括四个最大降幅里的三个,降幅在 2.2 到 3.5 个百分点之间。举例来说,RoseTTAFold3 的 Big 是 −3.5 个百分点,95% 置信区间是 −7.7 到 0.03。区间贴着零的含义是:这个样本量还不足以把这几处降幅与零区分开,逐模型的「等价」并没有被测出来。
Big 模式把可计算的规模推到哪一步
大分子机器——核糖体、呼吸链复合物、分子伴侣——由几十个亚基拼成,功能取决于它们装配得对不对。预测这类体系过去需要跨多台 GPU 节点推理,这是大多数分子生物学家拿不到的资源。Big 模式针对的就是这一段:它让单台 8 卡节点能准确预测超过 10,000 token 的体系,被准确预测的包括人线粒体复合物 I、TRiC 分子伴侣复合物、一个蛋白酶体和一个细菌核糖体,与实验结构的 TM-score 在 0.92 到 0.997 之间3。
参照点选得很明确:AlphaFold3 论文里准确预测的人 40S 核糖体亚基是 7,663 个残基;报告里单台节点上准确预测的上限是 10,761 token37。报告自己补了两条限制:六条规模最大且被准确预测的体系全都用了结构模板,它们的规模超过 AlphaFold3 最大训练裁剪(768 token)的 13 倍以上;五个被准确预测的条目早于 AlphaFold3 的训练截止日期,因此可能已经在训练数据里3。
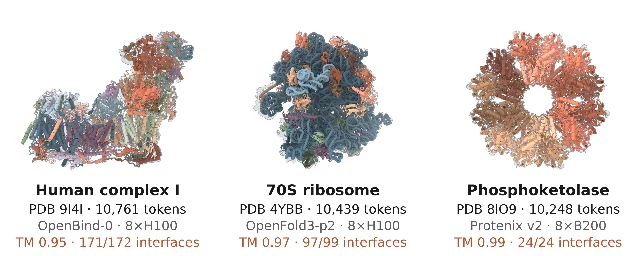
反方向的读数更能说明边界在哪。为了试探极限,报告让 Claude 去预测整颗病毒衣壳与蛋白腔室,规模约 31,000 到 70,000 个残基(最大 70,320),用一台 8 卡 B300 节点。七次运行全部跑完,七次预测全部不准确:预测塌缩成一个紧凑互穿的球,直径约为真实组装体的四分之一,已计分的三次 TM-score 是 0.14、0.08、0.08。报告把原因归到泛化——这些组装体比 AlphaFold3 最大的训练裁剪大 40 到 90 倍;被缩短的协议(单次 trunk pass、不做 recycling)可能有贡献,但用满 recycling 与模板的 AAV2 那一次同样塌缩3。Big 模式改的是这些模型在什么尺度上算得动;再往上的预测对不对,仍然由训练分布决定。
设计端:约 100 倍算力削减这个比较的形状
这份工作的另一半是蛋白设计。上一轮里,Claude 拿到的是一个约 16,000 词的提示,可以调动子智能体,每个靶点在 24 小时内最多能花 10,000 美元的 Modal 云 GPU,报告折算约 2,500 个 H100 卡时38。
这一轮把条件收窄成一个 Claude 模型、一张 H200、24 小时墙钟。提示词换成了约 1,100 词的 brief(每个靶点在 1,071 到 1,359 词之间),只给两个工具:一个 shell 和一个文件编辑器;没有网络,没有子智能体,也没有人在设计上做干预。模型拿到的东西包括靶点描述与其 UniProt 条目、预计算的多序列比对、被用于打分的固定靶点链、最多 40 个含该靶点的 PDB 条目,以及一个装着 46 篇蛋白设计、结构预测与界面指标相关论文和方法文档的目录。它要交付 30 条设计,每条 50 到 120 个残基3。
对照来自 Claude Mythos 5.1 在 2026 年 8 月 8 到 11 日跑的 16 个单靶点战役:那些战役可以用子智能体,可以花到 10,000 美元 GPU 时间,它们的最终 30 条设计被用同一套方法重新计分3。
打分的指标是 ipSAE,取值 0 到 1,含义是结构预测器对预测出的结合界面的置信度。一条设计的分数取复合物两个方向 ipSAE 里较低的那个(5 个种子里最好的一次),再对 ESMFold2、ESMFold2-Fast 与 Protenix v2 求平均;两个 GDF-8 靶点还要减去对相关蛋白 GDF-11 的一半分数39。
结果是这样的:24 小时后,中位数是 0.785(Opus 5)、0.781(Mythos 5.1)、0.739(Mythos 5),参照线 0.749;最好一条分别是 0.833、0.825、0.813,参照 0.817。按小时记录看,Opus 5 在 12 小时、Mythos 5.1 在 13 小时达到参照线的中位数,对应的 GPU 加 token 合计花费约 117–136 美元与 157–196 美元3。
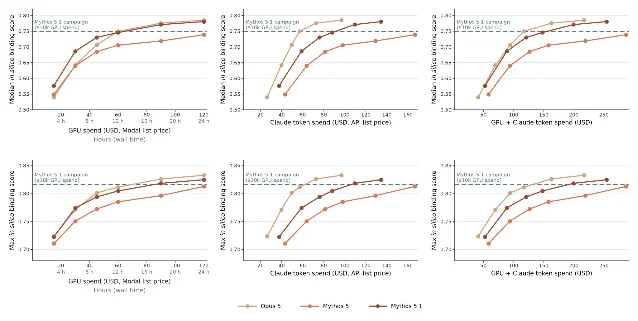
这个比较的形状需要摊开来说。参照侧的上限是一个预算——最多可以花 10,000 美元;新设置侧是一个给定的额度——一张 H200 加 24 小时。一边是能花多少,一边是实际拿到多少机器,两者不是同一种量。报告自己的限定句更直白:他们没有拆分加速模型与更简单协议各自的贡献,token 成本也按标价估算3。
补充材料里有一个更接近对照的设置。三个模型各跑 5 次、每个靶点在「有加速模型」与「没有加速模型」两套配置下各跑一遍,合计 480 次运行。24 小时后,有加速的那一组都更高:中位数 0.781 对 0.753(Mythos 5.1)、0.739 对 0.727(Mythos 5)、0.785 对 0.765(Opus 5);最好一条是 0.825 对 0.807、0.813 对 0.805、0.833 对 0.822。逐靶点看,16 个靶点里分别有 10、11、12 个的中位数更高,最大差异出现在 Cas9(Mythos 5.1,最高 0.260),除 Cas9 外差异不超过 0.075。同一段里还有一句:两套配置的 reference sheet 与代码版本并不相同,所以这些差异不能只归因于加速模型3。
还有两件事要带上。这批设计没有做过实验验证3。打分用的三个预测器里,ESMFold2-Fast 本身就是这次被优化的构建之一;报告对参照战役的设计做了同一套重新计分,比较的两侧用的是同一个打分器,比较因此在内部是一致的——但 ipSAE 始终是模型给出的置信度,报告也只把它称作「已被证明能预测实验结合」的 in silico 分数3。
缺的那块读数,被安排在一场竞赛里
上一次同类工作是有湿实验读数的。2026 年 8 月 18 日那篇里,Claude 对 15 个靶点中的 14 个设计成功;多靶点 48 小时会话的命中率是 26.7%(Mythos Preview)与 22.6%(Opus 4.8),单靶点多次 24 小时会话下 Mythos Preview 达到 35.1%,而行业典型水平是 10% 到 15%;单个设计的结合成功率在 22% 到 35% 之间,Adaptyv Bio 与 Twist Bioscience 独立完成了制作与检测10。这一次的读数只有 ipSAE。
补上这一环的安排是竞赛。五个赛题从 9 月 28 日起每周放出一个,五个窗口一直排到 10 月 31 日;官方点名的方向包括种属交叉反应性、pH 敏感性、肽–MHC 特异性,以及 GPCR 这类难靶点。Anthropic 出至多 100 万美元 Claude 额度,Anthropic 与 Adaptyv 联合出资至多 100 万美元做湿实验验证,Modal 提供至多 25 万美元算力额度,Twist Bioscience 提供 DNA;合计在 Adaptyv 的自动化实验室里测 5,000 条以上设计,参赛免费14。
赛道分三条:研究实验室与公司、个人与至多三人的小团队、以及自备工具与算力的开放赛道。前两条需要机构或公司邮箱,申请在 9 月 24 日截止;入选的研究实验室每赛题有约 18 条设计的预留测试额度,个人与小团队没有保证额度。实验验证在 11 月 30 日前完成,结果 12 月 15 日公布在 Proteinbase4。
竞赛页的 FAQ 里有两条决定了这批数据的性质。提交的设计不会全部被测,选哪一条送进实验室由 Anthropic 与 Adaptyv 用一个基于 Claude 的工作流决定,该流程赛后会公开,选择也不只依赖单一的 in silico 指标。参与者保留自己设计的全部权利,但被测设计的序列、预测结构、设计方法与实验测量都会公开,负结果同样公开4。
现在能拿到什么,以及这份结果的适用范围
代码现在就在仓库里:36 个 drop-in 优化包,一个上游工具一个目录,每个目录带着该工具在固定版本上的原样副本。模式在启动时通过命令行参数或环境变量指定,某个模式在这台机器上装不起来时,它打印 NOT ACTIVE 并以状态码 3 退出,不会静默退回原版。34 个包在上游自己的 Python 环境里生效,另外两个(rfdiffusion3 与 rosettafold3)改为往第二个解释器装一层小文件。许可为 Apache-2.0,上游副本保持各自的许可;仓库自述不维护、不接受贡献,定位是随博客发布的定版,预构建的 Docker 与 Apptainer 镜像计划在发布后一周内提供2。
适用范围报告写得清楚:速度与显存数据全部来自 NVIDIA H100 80GB、补充材料里写明的 batch size 与输入尺寸、以及各工具的上游版本,换到别的设置上可能不同。ColabFold 的加速是对 1.6.1 版本测的,之后陆续发布的融合 kernel 没有列入基准,报告只注明 ColabFold 1.6.3 并发放出的可选 fast kernel 尚未纳入311。补充材料里还有少数检查没有通过,报告在各模型的小节里逐条写明了是哪一项3。
开源生物模型的运行成本被压下来这件事,今天就能在自己的机器上验证:装一个 kit,对着自己的输入量一遍速度和峰值显存。而它想换来的那个更重的结论——这样便宜地设计出来的分子能不能真的结合——有一个明确的时间点:12 月 15 日,Adaptyv 实验室里那 5,000 条以上设计的实验结果。
References
- 1How Claude is uplifting biomolecular modeling
anthropic.com
- 2
- 3Accelerating open-source biomolecular models with Claude(技术报告)
www-cdn.anthropic.com
- 4Anthropic × Adaptyv Protein Design Competition
proteinbase.com
- 5NVIDIA/cuEquivariance
github.com
- 6NVIDIA-BioNeMo/BioNeMo-Inference-Runtime
github.com
- 7
- 8Autonomous de novo protein binder design with Claude(技术报告,2026 年 8 月)
www-cdn.anthropic.com
- 9
- 10
- 11ColabFold v1.6.3 release notes
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.