GPT-Rosalind 开放给美国大学实验室:30 席免费一年,准入靠 PI 和一位生物安全联系人
OpenAI 把 GPT-Rosalind 的学术通道开到美国大学实验室:最多 30 个 Business 席位、12 个月 0 美元,但要过受信访问审查。本文拆开模型为何被训练成不拒答、审查具体查什么、四个基准的绝对分与「每 token」口径的差别,以及责任落在实验室与大学之间的哪一头。

10 月 15 日(北京时间 10 月 16 日凌晨),OpenAI 给 GPT-Rosalind 开了一条学术通道。1
美国大学的实验室可以以 PI 或实验室负责人的名义申请,通过后拿到最多 30 个 Business 标准席位,12 个月内每人每月 0 美元,另含全部商业可用的前沿模型。GPT-Rosalind 本体要单独过 trusted access(受信访问)审查。1
这两条限制把大部分读者挡在门外。对能申请的人来说,价格是最不值钱的那部分;值得判断的是这道门怎么开,门后拿到的是什么。
这道门为什么存在
GPT-Rosalind 是专做生命科学研究的模型系列,2026 年 4 月 16 日首发,名字取自罗莎琳德·富兰克林。3 6 月更新到 GPT-Rosalind-5.5,从 GPT-5.5 增量训练,加了生物领域的数据。4
9 月 11 日,它走出研究预览,向符合条件的机构全球开放,公布的价格从 10 月 5 日起生效。3
系统卡把这套模型的生物与化学能力定在 OpenAI《准备框架》的 High 档,低于 Critical。5
同一份系统卡里有一句关键的话:与 GPT-5.5 不同,它被训练成不拒绝复杂的生物学提问,并把受信访问与负责任部署当作主要防线。5
广泛分发的旗舰模型靠两层保护:模型自己拒答,加上实时分类器拦截。这套模型放弃了第一层。
系统卡还写明,这次部署没有启用用于实时阻断的自动监控。5
事后监控仍然在:自动安全分类器、账号与组织层面的信号、客户提供的信息、对高风险活动的专家复核;确认违规可以限制或撤销访问。5
这两条合起来,准入就成了这套安全设计里最关键的一环。学术计划改的正是这一环:把原本只对企业与政府开放的入口,下移到实验室。6
准入具体查什么
发布页给了四步。1
- 核实机构的合法性,以及 PI 或实验室负责人的身份;
- 审查负责人的专业背景、机构任命,以及他是否有权监督实验室的访问;
- 评估实验室的机构隶属、研究活动与预期用途;
- 明确负责人的责任,并指定一名机构的生物安全联系人。
帮助中心把流程写得更细。申请人要用机构邮箱登录,完成 Persona 身份核验。
表格里要填机构与实验室信息、预期用途、需要访问的人员名单与邮箱、数据处置要求,还要提交生物安全联系人的姓名、职务、邮箱与电话。2
生物安全联系人必须是机构指定、对拟开展研究有管辖权的角色:EHS 或科研安全部门的生物安全官、机构生物安全项目负责人、select-agent 项目的 Responsible Official,或同等的合规负责人。2
核准之后,PI 是工作区唯一的 owner,不能再指定其他 owner 或管理员。成员加入工作区也不自动获得模型权限,要由 PI 在后台逐个开启。2
管理权收在一个人身上,责任也跟着落在一个人身上。
30 个席位包含什么
| 项目 | 官方口径 |
|---|---|
| 席位 | 最多 30 个 Business 标准席位,含 ChatGPT 与 Codex,用量上限不因免费取消 2 |
| 期限 | 最长 12 个月,设置时要绑支付卡 2 |
| 模型 | 全部商业可用的前沿模型;GPT-Rosalind 需另过受信访问 1 |
| API | 不含 API 访问与 API credits 2 |
| 数据 | 默认不用于训练;标准保留策略适用;不提供零数据保留 12 |
| 地域 | 仅美国大学实验室 2 |
| 人员 | 成员须与 PI 同一机构邮箱域名,跨机构访问者不能加入 2 |
Business 标准席位的公开价是每月每席 25 美元(月付)、20 美元(年付)。7 30 席乘 12 个月,按公开价折算是 7,200 到 9,000 美元。计划页没有给现金价值,这个数是我按公开席位价算的。
席位里装的是一个带科研工具的工作台。Life Sciences Research 插件把 50 多个公开多组学数据库、文献来源与生物工具接进 Codex。3
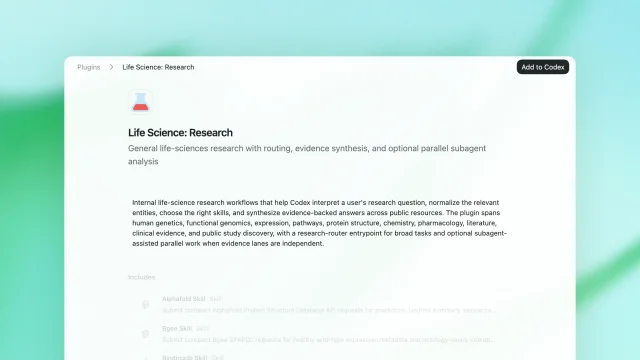
官方截图。插件把 AlphaFold、Bgee、BindingDB 这类技能打包给 Codex 调用;模型权限与工作区成员权限分开管理。
影响用法的两行是模型与 API。
席位给的是带界面的产品。计算实验室要批量跑基准、把模型接进自己的流程,都得走 API;这条通道里没有。2
界面本身也是最好用的控制面:成员权限、用量上限、工作区审计,全都长在席位里。官方没有把「不给 API」解释成控制手段,这一句是我的推断。
四个基准的两种口径
系统卡给了四个基准的绝对分,都是 GPT-Rosalind-5.5 对 GPT-5.5。5
| 基准 | 测什么 | GPT-Rosalind-5.5 | GPT-5.5 | 平均输出 token |
|---|---|---|---|---|
| MedChemBench | 药物化学的多模态理解、构效关系、成药性预测、逆合成 | 27.5% | 25.1% | 27,133.5 / 29,231.8 |
| GeneBench | 基因组学与定量生物学的长链条分析 | 21.6% | 20.4% | 16,721 / 24,270 |
| LifeSciBench | 外部专家判分的端到端科研任务 | 63.4% | 58.8% | 34,439 / 33,351 |
| LabWorkBench | 真实湿实验流程的排障与优化,数据为专有 | 63.2% | 55.8% | 45,390.8 / 47,950.8 |
产品页给的是另一组数:GeneBench 提升 53.7%、LabWorkBench 19.6%、MedChemBench 18.0%、LifeSciBench 4.42%,都标着「每 token 性能提升」。10
这两组数可以互相验算。用分数比除以 token 比再减一,GeneBench 是 (21.6/20.4)/(16,721/24,270)−1 = 53.7%,MedChemBench 18.0%,LabWorkBench 19.6%,LifeSciBench 4.42%。四个数都对得上。
53.7% 的来源于是清楚了:GeneBench 的准确率从 20.4% 涨到 21.6%,涨 1.2 个百分点;输出 token 少了 31%;两项合起来才是 53.7%。
LifeSciBench 反过来:准确率涨 4.6 个百分点,token 多了 3.2%,每 token 只剩 4.42%。
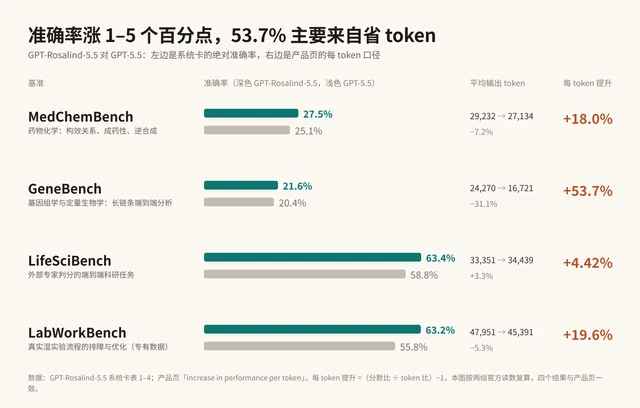
这是同档能力、更省 token 的领域模型。值得读原文的地方在工具与工作流;分数上还看不到跨代。
官方自己也写了例外:多选病毒学排障一项,GPT-Rosalind-5.5 是 51.2%,低于 GPT-5.5 的 53.7%;系统卡说它没有针对病毒学或生物威胁创造做专门训练。5
外部验证都是官方口径。BixBench 上官方称在有公开成绩的模型里领先;LABBench2 在 11 项里 6 项优于 GPT-5.4,提升最大的是 CloningQA。4
与 Dyno Therapeutics 合作的 RNA 序列—功能任务,best-of-ten 在预测任务上高于人类专家第 95 百分位,生成任务约第 84 百分位,对照的是 57 个历史人类成绩。4
官方自己放的那段对照
发布页上有一段演示,值得单独读。同一句关于尼帕病毒融合蛋白脂肽候选的提问,分别给 GPT-Rosalind 和主线的 Astra。1
Rosalind 交出了候选比较矩阵、需要建模的界面、配套的假病毒与真病毒实验计划,以及一组排除干扰的检查项。1
Astra 的思考被摘录出来:需要把安全放在这个优化矩阵之前;随后说明不能提供序列级设计或实施级实验方案,只给了一个不涉及操作的框架。1
页面脚注写明,这些评估只看回答是否完成了被请求的交付物,不验证科学正确性、可行性,也不验证方法是否有效。1
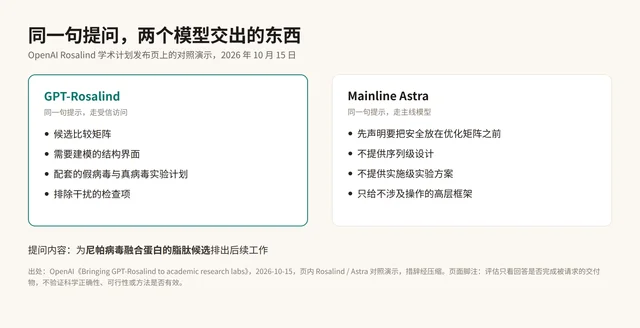
准入换来的是那段可操作的内容:学术用户拿到的,正是主线模型拒绝交出的部分。
官方在宣布向大学开放的同一页上放了这段对照。这个选择说明,官方认为在受审的研究语境里,这部分内容可以给。
责任落在谁头上
计划的申请单位是实验室,责任单位却是大学。
生物安全联系人必须由机构指定、对研究有管辖权;他要协调生物安全监督、确认培训与人员准入要求、与 OpenAI 一起处理安全事件和访问复核。2
与此同时,PI 是工作区唯一的 owner,成员权限、模型开关都由他一个人管。2
责任就这样分成两半:合规责任挂在学校的 EHS,操作责任挂在 PI。
帮助中心还要求申请人先确认,学校是否允许开设独立的 Business 工作区;如果学校已有 OpenAI 的企业协议,就必须走学校那条通道。2
对 PI 来说,这一步比填表重要。先问学校,再提交申请。
数据条款要两句一起读。发布页写的是「通过该计划共享的研究数据默认不用于训练我们的模型」。1 帮助中心写的是「标准数据保留策略默认适用」「本计划不提供零数据保留」,以及管理员可能可以访问、导出、保留或删除工作区数据。2
默认不用于训练、不保留、管理员看不到,是三件事。放未发表数据之前,这三件事都要跟学校的口径对上。
缺口与接下来
没有公开的数字有五个:申请量、批准率、被拒的原因分布、审查的漏判率,以及事后监控的召回。
12 个月之后的价格也没写,以接受的要约为准。2
学术产出目前只有三句引语:UCSF 的 Zhao 实验室说它收集药物理化参数更快;Bourdenx 实验室说迭代想法的速度变快;斯坦福与 Arc 研究所的 Brian Hie 说能把发现与设计任务放到更大的规模上。1
四个基准都由 OpenAI 自己发布;LifeSciBench 的判分由外部专家完成,样本与判分规则没有公开。5
不在美国的读者能拿走什么
这份计划只对美国大学实验室开放,其他地区的读者用不上。2
可迁移的是判断结构。一次「向学术开放」值不值得跟,看三件事。
准入开在哪一级:机构、实验室,还是个人。这一级决定了谁被审查、谁承担后果。
证据是绝对分还是每 token:前者说能力,后者说成本。两组都读,才知道自己在看什么。
责任落在谁头上:厂商、学校,还是 PI。落点越靠下,实验室越需要有对应的流程。
References
- 1
- 2Rosalind Academic Plan
help.openai.com
- 3
- 4
- 5GPT-Rosalind-5.5 System Card
deploymentsafety.openai.com
- 6
- 7ChatGPT Business – Overview
help.openai.com
- 8GPT-Rosalind for life sciences research
help.openai.com
- 9Meet Rosalind Workbench
developers.openai.com
- 10Rosalind
openai.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.