8月25日 AI 早报:五条要闻,英乌共享战场数据,阿里与 OpenAI 接连更新模型产品
英国与乌克兰签署 AI 防务合作,阿里发布 Wan3.0,OpenAI 将 GPT-5.6 接入 Kiro,Thomson Reuters 发布自有模型,论文则提出为 AI 解读医学证据加上结构化边界。
本期覆盖北京时间 2026 年 8 月 24 日 07:15 至 8 月 25 日 07:15 的公开进展,按对 AI 产业、模型产品、政策与研究的影响排序。每条先交代发生了什么,再说明它改变了哪一部分行业判断。
1. 英国与乌克兰签署 AI 防务合作,英方获得战场数据平台访问权
发生了什么: 英国与乌克兰于 8 月 24 日签署防务与安全人工智能合作协议。英国成为第一个获得乌克兰 Avengers AI Labs 访问权的国际合作方。这个平台建立在约 500 万张带标注的战场图像上,数据主要来自乌克兰自行开发的 DELTA 战场管理系统。1
乌克兰国防部此前向 Reuters 表示,平台收集坦克、火炮、无人机等目标的摄像头和传感器数据;相关目标检测模型每月分析超过 10 万路无人机视频,实时识别率约为 70%。这些数字属于乌克兰方面的公开口径。双方首批试点包括用光纤作为 AI 传感器保护军事设施,以及为无人机和自主系统研究低功耗 AI 芯片。1
为什么重要: 这份协议把 AI 防务合作从模型采购推进到数据、传感器和芯片的共同开发。英国研究人员获得真实战场数据平台的访问权,后续合作的重点也落在目标识别、设施保护和无人系统上;这比单独展示一个模型的性能,更接近军用 AI 的实际部署链条。
2. 阿里巴巴正式发布 Wan3.0,可把文档和网页生成 30 秒视频
发生了什么: 阿里巴巴云在 8 月 24 日正式推出视频生成模型 Wan3.0。阿里云称,新模型可以根据文档、电子表格、演示文稿和网页生成最长 30 秒的视频。模型的公开测试版已于 8 月 6 日上线,阿里云还称它已经用于短剧和电影制作、广告营销、旅游推广与音乐视频创作。2
为什么重要: Wan3.0 把视频生成的输入范围从文字和图片扩展到企业日常文件。产品价值因此落在资料理解、脚本组织和视觉生成的连续流程上,而不只是单条提示词的画面效果。阿里云披露了应用方向和输入类型,公开报道暂未提供独立评测结果;实际效果仍要看用户在长文档、复杂表格和连续镜头中的使用反馈。
3. OpenAI 将 GPT-5.6 家族接入 Kiro,面向开发流程重新分配模型成本
发生了什么: OpenAI 8 月 24 日宣布,GPT-5.6 家族已经接入 AWS 的软件开发智能体 Kiro,包含 Sol、Terra 和 Luna 三个系列。Kiro 把产品需求整理成技术设计和可执行任务,再让模型参与编码、审查和测试;开发者可以把代码库、团队规范和属性测试纳入同一套开发流程。3
OpenAI 与 AWS 表示,在 Kiro 环境中测试 GPT-5.6 Terra 完成 Terminal-Bench 2.1 任务时,成本约下降 82%。这个数字来自双方的联合测试,属于发布方口径;页面没有给出足以复现全部比较条件的独立评测报告。3
为什么重要: GPT-5.6 在这里的变化主要是可用范围和工作流位置。OpenAI 正把模型从单独的聊天或 API 调用,推进到需求拆解、代码修改、检查和回归测试组成的连续开发流程。对开发团队来说,真正需要比较的是每项任务的完成质量、人工复核时间和总成本,而不是单看模型名称或单项基准分数。
4. Thomson Reuters 发布自有大模型 Thomson,先服务法律文档分析
发生了什么: Thomson Reuters 8 月 24 日宣布推出首个自研大语言模型 Thomson。公司称,模型从开源基础模型出发,投入约 4000 万美元训练,并使用 Westlaw、Practical Law、Checkpoint 和 Reuters 等自有内容,以及法律和其他专业领域专家参与的训练目标与评测。公司还表示,目前使用的 Thomson Reuters 内容不到其内容总量的 10%。4
Thomson 的首次部署计划放在 CoCounsel Legal 的 Tabular Analysis 功能中,面向律师事务所和企业法务部门;公司同时计划把一个小型版本以开放权重形式放到 Hugging Face,供学术和非商业用途验证。Thomson Reuters 的早期评测称,模型在一组任务上接近最新 frontier 模型,外部法律学者也在公司公告中评价了它的引证质量。上述性能判断仍处于发布方组织的早期验证阶段。4
为什么重要: Thomson Reuters 选择用专有内容、领域专家和自有工具训练模型,押注的是专业场景里的可控性、引用质量和数据主权。这个案例也提供了另一条模型路线:公司可以从开源基础模型出发,把成本集中在领域训练与验证上。后续是否能在真实法律任务中稳定优于通用模型,需要等开放权重版本和独立评测结果出现。
5. 论文提出 SIMcard 与 FACTS,给 AI 解读医学证据加上结构化边界
发生了什么: npj Digital Medicine 于 8 月 24 日在线发表论文《When machines misread science: creating guardrails for human and AI interpretation of biomedical research》。论文作者认为,医学研究越来越常经过 AI 摘要、检索和解释后才到达医生、患者、记者或政策制定者手中,因此研究报告本身需要提供更明确的解释边界。5
论文提出两种配套形式:面向机器的 SIMcard,用 XML 或 JSON 等机器可读格式记录研究设计、主要结论、适用范围、因果或相关关系、局限和禁止推断;面向普通读者的 FACTS 标签,则用自然语言说明核心主张、研究语境、不确定性、可能的误读和推荐解释。论文把这两种形式定位为提案,后续仍需通过对抗性提示测试和实际工作流验证它们能否提高解释准确度。5
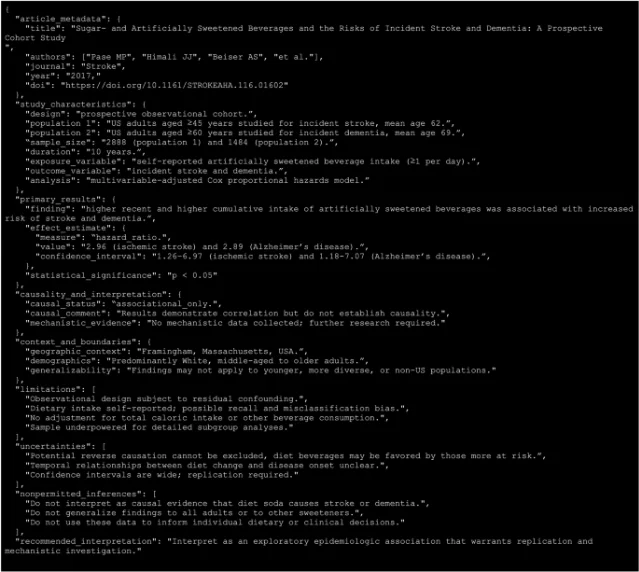
为什么重要: 这项工作把可靠性问题往前移了一层。模型训练和检索系统之外,论文怎样写清楚「这项研究到底支持什么」同样会影响 AI 的摘要和后续判断。SIMcard 与 FACTS 目前提供的是可检验的设计方向,医学出版机构和 AI 产品是否采用,还要看实证效果与维护成本。
References
- 1
- 2
- 3
- 4
- 5
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.