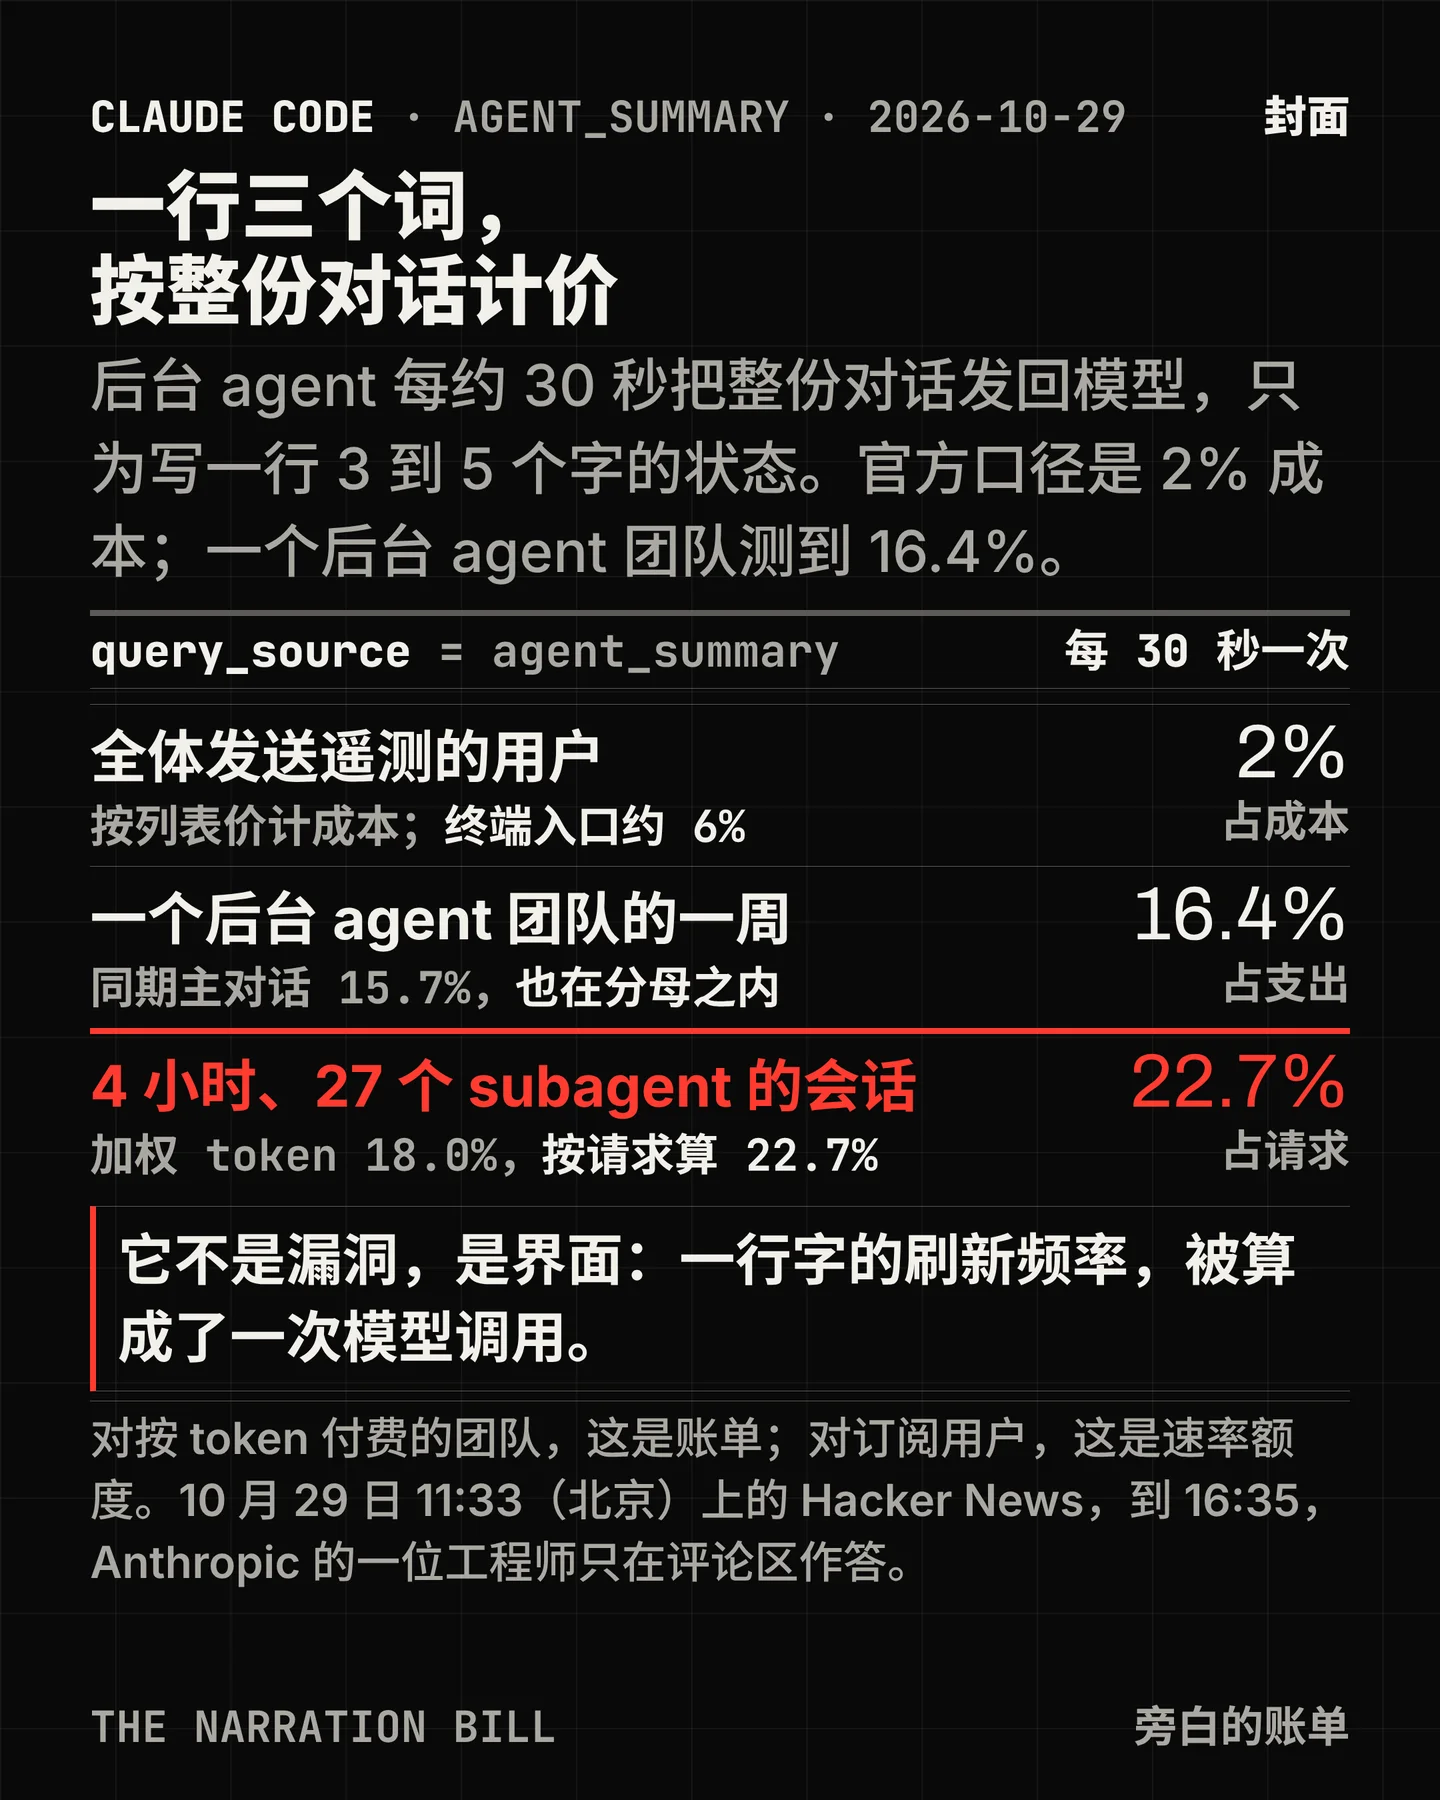

10 月 29 日 11:33(北京),一份 gist 被提交到 Hacker News,标题很直白:Claude Code 会定期把每个后台 agent 的整份对话发给它自己的模型。到 16:34,这条讨论有 325 分、100 条评论,Anthropic 的一位工程师在楼里回了话。12
事情的形状是这样的:后台 agent 每约 30 秒发一次模型请求,带进去的是它当时的整份上下文,换回来的是面板上那行 3 到 5 个字的状态。这一行只给你看,不回到对话里,也不写进会话记录。
值不值得管,取决于一个很具体的问题:这笔开销落在谁的账上、由谁决定。
一次请求的四个部分
代码里的名字是
agent_summary。issue #86879 贴出了调用片段:forkLabel: "agent_summary"、maxTurns: 1、skipTranscript: true,工具全部拒绝,摘要不会回到 agent 的上下文里。3Anthropic 自己的文档在 agent view 页的「行摘要」一节写得更正式:这一行由 Haiku 级模型生成;会话活跃时最多每 15 秒用会话自己的输出本地刷新一次、不发请求;每个回合结束时写一次新摘要;长回合里「每隔几分钟」再重写一次。文档还明说,回合结束与中途重写这两类请求「会计费」。4
同一位工程师在 Hacker News 上把频率说成「约每 30 秒」,并说自己正在做一个更便宜的版本:把短笔记发给更小的模型,「而不是整份 transcript」。5 这句话反过来确认了现行版本发出去的是什么。
输出确实很短。issue 里那次四小时、27 个 subagent 的会话中,这类请求 339 次,输出合计 21,966 个 token,平均每次约 65 个。3
为什么它不在你的记录里
因为它被排除在 transcript 之外。任何按会话记录统计成本的工具——包括用户自己写的脚本——都会因此少算。同一批人 10 月 22 日又开了一个 issue,用 14 个会话对比:把全部 transcript 加起来,比 Claude Code 自己记的
cost-state 低 1.35 到 2.13 倍。6cost-state 也不是随时可读的账本:它只在进程正常退出时写一次,进程被杀就什么都不剩。所以这类请求的可见痕迹实际只有一个地方——OpenTelemetry 的导出,按 query_source 分组时能看到那个叫 agent_summary 的值。顺带说清一句被广泛引用的话。文档 statusline 页写着「状态行在本地运行、不消耗 API token」,说的是用户自己配一个脚本、由本地 shell 执行、把结果打印到屏幕的那种状态行。7 它和 agent 面板里这行由模型生成的摘要,不是同一个东西。讨论里有人把两者当成矛盾,其实是两个功能同名。
六个数,五层分母
公开材料里出现过的读数,从 2% 到 26%。它们不互相否证,因为分母不同。
工程师给的平台口径是:上周,在所有向 Anthropic 发送遥测的 Claude Code 用户里,
agent_summary 约占按 API 列表价计算的成本 2%、请求数略低于 4%;在终端这个几乎全部此类调用发生的入口,占成本约 6%。5 这是唯一一个覆盖全平台的数字,但它是一句陈述,没有方法学与样本量可复核。gist 的数字是另一个尺度:一个后台 agent 密集的团队,一周内占该团队全部 Claude Code 支出 16.4%、占全部 API 请求 19.7%,主对话同期是 15.7%——主对话就在分母里。1
issue 里的数字是第三种:单个 subagent 密集的会话,按加权 token 是 18.0%,按原始 token 是 22.2%,按请求数是 22.7%;另一位在 2.1.276 上测了一个 1 小时 45 分、四个 subagent 的会话,说这类请求占了那次会话缓存读 token 的 26%。3
最后一个来自同一天的一次对照测试:同一版本,三十秒能跑完的快任务里占会话成本 1.3%,跑三分钟的慢任务里占 15.7%。10
这五个分母分别是:谁被统计、按什么单位、算不算主对话、是估算还是发票、以及任务有多长。把 gist 的分子摊到全体用户,就是 2%;把它放进一个 subagent 密集的会话,就是 18 到 26%;把同一个会话里的快任务与慢任务分开看,就是从 1.3% 到 15.7%。gist 自己的时间序列也说明了同一件事:同一个组织、同一套口径,7 月是 3.5–7%,10 月中旬到约 16%。1
还有一个不该被当成事实的数字。gist 说输入与输出的 token 比约 9,000:1,但它没写清输入是否包含缓存读。用 issue 同一张表复算:未缓存的输入对输出约 42:1;把缓存读按 1 倍计入约 2,844:1。两者都远低于 9,000。3
96% 的 Opus,是自己配出来的
gist 说这类支出有 96% 走 Opus。这听起来像厂商在用小任务烧大模型,但官方文档给了另一半解释:请求走你配置的 provider,模型是 Haiku 级;「如果第三方 provider 或网关没有配置 Haiku 级模型,请求会改用会话的主模型」。4
也就是说,凡是没有把这一档映射到小模型的网关,每一行状态都按主模型计价。而输入侧才是大头:一位用户在 2.1.276 上算过,一个上下文涨到 38 万的 agent,「光这一行字,一小时要付约 4,500 万缓存读 token」。3
把这两件事合起来看:一行字的成本约等于上下文长度、刷新次数与模型单价三者的乘积。三个因子分别由任务、服务端和你的网关决定,产品默认值只决定其中一个。
官方是什么时候知道的
公开 changelog 里查不到「开启」这一条。能查到的是两次修复,都在 2.1.128(5 月 4 日):一次修的是「sub-agent 进度摘要缺 prompt cache」,另一次写得更直接——「修掉 sub-agent 摘要在 transcript 静止时反复触发的问题,给空闲 sub-agent 的 token 成本封顶」。11
对「什么时候变成默认」这个问题,公开材料只有第三方的时间线:摘要定时器在 2.1.32(2 月 5 日)第一次进包,2.1.72(3 月 9 日)作为 SDK 选项可达,2.1.232(8 月 13 日)对交互式后台 agent 默认开启,2.1.300(10 月 14 日)把间隔改成服务端按模型族下发、夹在 30–240 秒。1 这些版本号的发布时间能从 npm 核到秒,但「这一版改了什么」在公开 changelog 里没有对应条目。12
开关的情况更绕。SDK 选项
agentProgressSummaries 在文档里默认 false,但读过包的人说它只是条件表达式里的一项,每条写它的路径都写成 true,所以写 false 没用;后来出现的环境变量 CLAUDE_CODE_AGENT_PROGRESS_SUMMARIES 只能打开、不能关闭。真能停的只有两种:CLAUDE_CODE_FORK_SUBAGENT=0,或者跑非交互的 -p——前者会连 fork 模式一起关掉,后者本来就没有后台 agent。3到发稿,那个「这有没有写进文档」的追问在 Hacker News 上没有官方回答;issue #86879 开了两个半月,没有 maintainer 回复。工程师说的「2.1.311+ 修掉了未命中缓存这一最贵情形」,在公开 changelog 里也找不到条目。5
你要查的四件事
第一,分母。在 OTel 导出里按
query_source 分组,取 agent_summary 这一组,看它在你自己的账上占多少。注意两个已知的坑:query_source 的取值可能带着 outputStyle 后缀(repl_main_thread:outputStyle:Concise),精确匹配会得 0 条;13 另有报告说约三分之一含文本响应的请求根本不发 api_request 事件,其中就点名了 agent_summary。14 分子和分母都可能被少计。第二,路由。查你的网关有没有把这一档映射到 Haiku 级模型。这是四个检查里最省钱的一项,因为它同时降低单价,又不牺牲任何功能。
第三,账本。分清楚你在订阅还是按 token 付费:订阅用户损失的是速率额度,
cost_usd 是客户端按列表价估算的数字,不是发票;按 token 付费的,才真的是钱。1第四,覆盖。任务越长它越贵,因为每一次重发都带着当时的全部上下文。三十秒的快任务与三分钟的慢任务差了十二倍,就是这条机制的直接后果。10
把四件事放在一起,结论其实只有一句:这不是一个「谁多花了几个点」的问题,而是一个采购问题。按 token 计价的合同里,你买的不只是 agent 干活,还有 agent 被讲述;而讲述的单价,取决于你有没有给它配一个小模型。
还没有答案的部分
官方从未说明这条请求带的是整段上下文还是其中一部分——工程师那句「而不是整份 transcript」是目前最接近的表述,但它不是文档。5 30 秒这个间隔在官方文档里没有,文档只写「每隔几分钟」。4 平台口径的 2% 与 4% 没有方法学与样本量。5 2.1.311 的修复没有公开条目。11
已经能确定的是另一半:这行字在界面上,账在上下文里;你的会话记录里没有它,你的遥测里可能有;关掉它的开关,写着另一个功能的名字。
References
- 1
- 2Hacker News · 条目 50284255(2026-10-29T03:33:42Z)
news.ycombinator.com
- 3
- 4
- 5Hacker News · edwinarbus 的回复(2026-10-29T04:52:07Z,自述在 Claude Code 团队工作)
news.ycombinator.com
- 6GitHub · issue #104358(2026-10-22)
github.com
- 7Anthropic · Customize your status line
code.claude.com
- 8Hacker News · jakozaur 的回复(2026-10-29T04:48:32Z)
news.ycombinator.com
- 9Hacker News · _boffin_ 的回复(2026-10-29T05:13:51Z)
news.ycombinator.com
- 10
- 11Claude Code · CHANGELOG(2.1.128)
raw.githubusercontent.com
- 12npm registry · @anthropic-ai/claude-code
registry.npmjs.org
- 13GitHub · issue #92057
github.com
- 14GitHub · issue #98193
github.com
Comments