MiniMax M3.1 Flash:智能指数 29→43,价格砍半,速度只有宣称的六成
MiniMax 10 月 19 日上线的 M3.1 Flash,三个宣称拆开看:智能指数 29 升到 43 有交叉证据,输出速度第三方只量到 93 token/秒,成本降幅随分母在 75%、50%、57% 之间。

10 月 19 日,MiniMax 上线 M3.1 Flash,挂牌价 $0.15 输入 / $0.60 输出 / $0.015 缓存读,不按输入长度分档。1
同一次发布给它安排的位置是"下一代 Flash":1M 上下文,最大输出 524,288 token,文本、图像、视频都能进。2
官方的三句宣称是:agentic 任务、编码、Computer Use 与网络安全的代际跃升;在线推理快近 3 倍;使用成本降约 70%。1
这三句落在不同的地方,能核的程度差得很远。
同一家测出的输出速度是 93.1 token/秒,约为官方 P50 的五成半。3
公开榜上查得到的分数只出现在 Agents' Last Exam(真实职业任务的 agent 评测):第 9 名,通过率 29.6%,估算总成本 $91.44。5
匿名跑了 26 天的 Space Bunny
9 月 23 日,OpenRouter 上架一个匿名模型 Space Bunny Alpha,写明 1M 上下文、文本图像视频输入、可调思考力度。6
页面描述只说它"推理快、编码强"。揭名之后,同一个页面改成了 MiniMax M3.1 Flash,并注明匿名期已结束,中间隔了 26 天。
官方博客补了一句:它在匿名期间处理了超过 200 万亿 token。1
这个总量没有分平台计量可以逐项核对。能核的是它跑在什么场景里:OpenRouter 把 Kilo Code、Hermes Agent、Claude Code 列为流量最大的三个调用方。2
换句话说,这套权重在挂牌之前,先在编码 agent 的真实流量里跑了两周多。官方结尾还留了一句:Pro 稍后到。
产品面上,它同时在 MiniMax API、M Plan 与 MiniMax Code 三处可用。OpenRouter 的免费期到 10 月 22 日 20:00(北京时间)结束,之后按官方价计费,免费变体下架。2
权重还停在"稍后"。Hugging Face 上 MiniMax 组织的仓库最新是 6 月的 M3、7 月的 H3、8 月的 Music3,没有 M3.1 的仓。7
16 项分数里,公开榜只认一项
官方给了一张 7 个模型 × 16 项基准的对照表,每一项都标了评测框架。M3.1 Flash 在表里领先三项,其余十三项都有更高的模型;读它的价值在差值。
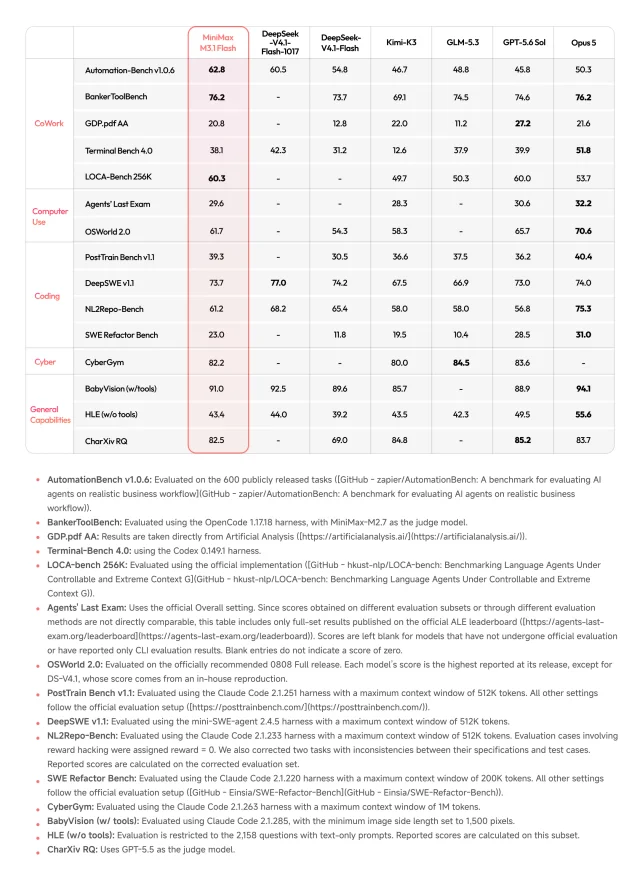
MiniMax 随发布给出的 16 项对照。GDP.pdf 一行直接取自 Artificial Analysis,其余为 MiniMax 自跑;每一项的 harness 不同,逐条写在原图脚注里。
领先的是三项。Automation-Bench v1.0.6 得 62.8,同表第二名 60.5;BankerToolBench 76.2,与 Opus 5 并列;LOCA-Bench 256K 得 60.3,比 GPT-5.6 Sol 的 60.0 高 0.3。1
落后项更密。GDP.pdf 20.8,GPT-5.6 Sol 是 27.2;Terminal-Bench 4.0 得 38.1,Opus 5 是 51.8。1
NL2Repo-Bench 61.2 对 75.3,SWE Refactor 23.0 对 31.0,HLE 43.4 对 55.6。
网络安全那一项的措辞要收着读。CyberGym 得 82.2,在自家的表里就低于 GLM-5.3 的 84.5 与 GPT-5.6 Sol 的 83.6。1
官方说它在中国模型里两项第一,一项是 Agents' Last Exam,一项是 OSWorld V2。前者能在榜上核到,后者只有自测数。5
脚注比数字更值得看。BankerToolBench 的裁判是 MiniMax 自家的 M2.7;Automation-Bench 用 600 道公开题;DeepSWE 用 mini-swe-agent,Terminal-Bench 用 Codex 0.14.9。1
唯一从外部直接取数的一行,正好是它明确落后的一项。GDP.pdf 的 20.8 来自 Artificial Analysis。
公开榜这边,Agents' Last Exam 收了这个模型,榜上两行都是 High 档。Claude Code 一行通过率 29.6%、估算成本 $91.44;Codex 一行 27.0%、$67.72。5
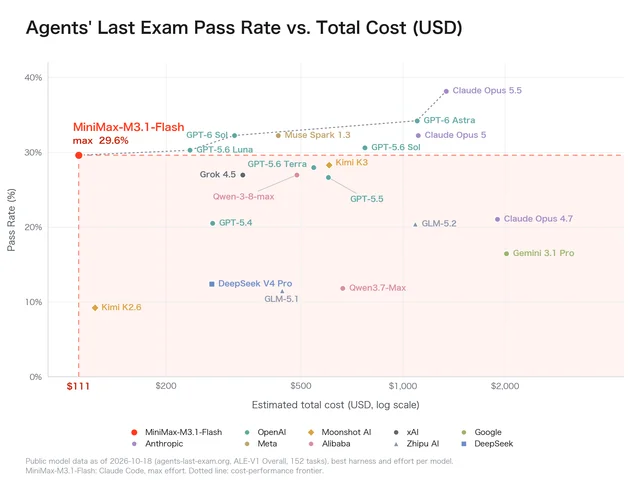
官方发布图里的 Agents' Last Exam 通过率—总成本平面,M3.1 Flash 标在 29.6%、$111。榜上同一行是 High 档、$91.44;官方图注写 max effort。
官方图与榜单有两处对不上。图上把它画在 $111 与 max effort,榜上是 $91.44 与 High,榜上没有 max 档的 M3.1 Flash。通过率 29.6% 两边一致。
另外两项基准的情况不同。DeepSWE v1.1 榜停在 9 月 22 日更新,上面没有 M3.1 Flash;榜首 74% 一档有三个模型,每任务成本从 Gemini 3.8 Flash 的 $2.36 到 Claude Opus 5 的 $11.84。8
官方图给它的位置是 73.7%、每题不到 $0.3。这组读数若成立,是榜外最划算的一点;代价是它属于自跑,没有第三方复现。
Zapier 的 AutomationBench 榜同样没有它。那边 1.0.6 版榜首是 Gemini 4 Argon 的 51.29%,因为榜上分数跑在留出的私有集上;官方用的 62.8 来自 600 道公开题。9
两个数来自两批不同的题,摆在一起比较会失真。
速度:官方 170+,第三方 93
官方把速度归因于"更激进的稀疏化",说日常输出能到 200+ TPS,中位数稳定在 170+。1
"快近 3 倍"的基线官方没有写。同一家机构测上一代 M3 是 88.0,M3.1 Flash 是 93.1,两者差 6%。4
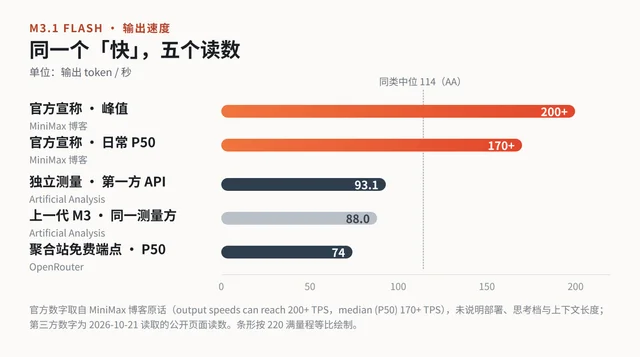
差距有合理的解释空间。TPS 随部署、思考档、上下文长度和是否计入首 token 变化,官方没有写在哪测。
一种可能是,官方测的是短上下文、低思考档的峰值;第三方测的是完整请求的稳定输出。
对要下单的人,这个差别很实际。容量规划按 93 算还是按 170 算,机器数量差近一倍。
成本:同一刀降价,三种算法给出 75%、50%、57%
先看价目。M3 的挂牌价(输入 / 输出 / 缓存读)是 $0.60 / $2.40 / $0.12,现行永久五折后是 $0.30 / $1.20 / $0.06;输入超过 512K 时另有一档更高的价。10
M3.1 Flash 是 $0.15 / $0.60 / $0.015,全档同价,与输入长度无关。
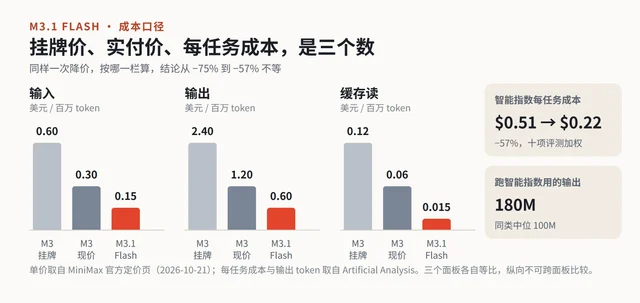
"便宜 70%" 落在哪一档,取决于跟谁比:
- 对 M3 的挂牌价:输入与输出都降 75%,缓存降 87.5%。
- 对 M3 的实付价(永久五折):输入与输出都降 50%,缓存降 75%。
- 对 Artificial Analysis 的每任务成本:$0.51 降到 $0.22,降 57%。
三个数都对得上,只是分母不同。官方原话是 agentic 任务的整体使用成本,这个口径还含 token 消耗量与缓存命中率。
长上下文负载会放大这个优势。输入过 512K 时 M3 实付 $0.60 / $2.40,与 M3.1 Flash 的差距回到 75%。10
反过来,输出量会吃掉一部分优势。Artificial Analysis 记录它跑完智能指数用了 180M 输出 token,同类中位是 100M。3
一套 agent 循环里最贵的通常是输入。Agents' Last Exam 的 Claude Code 那一行,用了 4.9B 输入 token、21.8M 输出 token,比例约 225 比 1。5
按这个比例算,$0.015 的缓存读价才是主战场。缓存命中率掉一个档,单价再便宜也追不回来。
接进流水线要处理的几件事
M3.1 Flash 同时提供 OpenAI 与 Anthropic 两套兼容端点,Anthropic 那套的 base URL 是
https://api.minimax.io/anthropic。11它默认带交错思考:每次调用工具之前,先看环境与上一轮结果,再决定下一步。官方评测统一用 Claude Code、OpenCode 这类 harness,也是为这个场景准备的。11
多轮工具调用时,
thinking 与 reasoning_content 必须原样回传,否则推理链断在中间。简单调用可能不产生思考字段,读之前要先判断存在。权重还在"稍后"这一栏。它决定了这款模型现在只能按 API 用,自部署要等。
谁现在试,谁再等
值得现在就试的有三类:长上下文的多轮工具任务、成本敏感的批量 agent、需要并行跑大量编码任务的场景。
它在 Agents' Last Exam 上用 $67–91 的全套成本拿到 27–29.6% 的通过率。通过率 27% 以上的模型里,它的全套成本最低。5
该再等的也有三类。要公开可复现编码分数的,等 DeepSWE 榜收录或权重放出;要做容量规划的,先用自己负载量 P50;要做知识型问答的,看 HLE 43.4、GDP.pdf 20.8。3
最后一条最容易被忽略。Artificial Analysis 记它的 AA-Omniscience 准确率 56.2%,非幻觉率 7.2%。
两个数并列时说的是同一件事:它答对的题不少,遇到不知道的题时很少选择不作答。3
还没答案的四个数
$111 与 $91.44 的差,官方没有解释;3 倍与 93.1 的差,官方没有给测法;200 万亿 token 没有分平台账目;73.7% 与 76.2 都还没有第三方复跑,BankerToolBench 连公开入口都没给。1
这四项改不了一个基本判断。M3.1 Flash 在便宜一档上真正能跑长程 agent,代价是它在知识、终端长任务与部分编码重构上明显落后。
把它当"便宜的主力 agent"来用,这次发布的数字就都对得上了。
References
- 1
- 2MiniMax M3.1 Flash(OpenRouter 模型页)
openrouter.ai
- 3MiniMax-M3.1-Flash Intelligence, Performance & Price Analysis
artificialanalysis.ai
- 4MiniMax-M3 Intelligence, Performance & Price Analysis
artificialanalysis.ai
- 5Leaderboard - Agents' Last Exam
agents-last-exam.org
- 6Space Bunny Alpha(OpenRouter)
openrouter.ai
- 7MiniMaxAI(Hugging Face 组织主页)
huggingface.co
- 8DeepSWE Leaderboard
deepswe.datacurve.ai
- 9AutomationBench: AI Agent Benchmarks
zapier.com
- 10Pricing Overview(MiniMax API 文档)
platform.minimax.io
- 11Tool Use & Interleaved Thinking(MiniMax API 文档)
platform.minimax.io
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.