8月20日论文雷达:10篇直接命中、14篇邻近,先把信用放回选择、环境与评判器
从8月20日三栏144篇中筛出10篇直接命中与14篇邻近工作,重点比较技能选择信用、可学习环境、确定性长程评估、评判器门槛和严格流式TTS。

这批新条目里,最值得先读的不是又一个更大的模型,而是三个更具体的问题:长程训练到底把反馈给了哪一个决策,环境是否能随能力一起变难,评判器在进入自进化闭环前是否真的有资格当门。8 月 20 日的三个允许栏目共收录 144 篇论文:人工智能 67 篇、自然语言处理 72 篇、语音与音频 5 篇。本文保留 10 篇直接命中、14 篇有明确迁移机制的邻近工作;没有播客生成与评估的直接命中。
先看什么
| 阅读顺序 | 论文 | 先看哪一个问题 | 证据和结论 | 建议 |
|---|---|---|---|---|
| 1 | SkillGate | 技能选择为什么被长轨迹的结果奖励淹没 | 5 个智能体基准、16 候选技能、9B 策略;成功率 40.8%→53.2%,并减少误导技能暴露 | 精读 |
| 2 | FM-Bench | 长程评估能不能不用 LLM judge | 20 个游戏年、3 个种子、确定性引擎累计分;模型差距更像管理行为差距 | 精读 |
| 3 | SPADE | 自进化能否同时改变训练环境和学习者 | 环境设计器与推理智能体自博弈;30B 模型在 8 个留出基准平均 +5.3 | 精读 |
| 4 | X2Streaming-TTS | 严格 token 级流式 TTS 怎样保持边界连续 | 单请求 TTFT 中位 15.8 ms,128 并发为 260.8 ms;代码公开 | 精读 |
| 5 | RTPO | 多轮 agentic RL 的信用如何逆序传播 | 用稀疏反向树做回合级更新;相对轨迹级、回合级基线分别报告 +21.50%、+10.76% | 值得扫读 |
| 6 | Governance Records as Supervision | 验证器能否选择训练目标 | 160 个新用例中,VAL 选择达到 102/160,自选目标 69/160;但只适用于可机器检查的能力 | 值得扫读 |
| 7 | What is Missing from AI Post-Training AI | AI 训练智能体为何只会局部调参 | 经验脚手架能提高 GSM8K 与 HumanEval,却不改变开局锁定的训练策略 | 值得扫读 |
| 8 | Test-Time Scaling in the Wild | 候选变多后,真正的瓶颈是不是选择 | 5 类测试时缩放、5 个开放基准;候选融合只恢复约 40% 的可用质量 | 邻近跟踪 |
上表的顺序不是论文质量的绝对排名,而是原文阅读对研发判断的边际价值:先读能改变训练信号、评估接口和闭环门槛的工作,再读具体任务或组件。
这一批是怎样筛出来的
候选只来自公众号「arXiv 每日学术速递」在 2026 年 8 月 20 日 12:15:28 发布的三个允许栏目:人工智能学术速递[8.20]、自然语言处理学术速递[8.20] 和 语音与音频学术速递[8.20]。arXiv 原文用于核验候选的标题、方法、数字和限制;代码、项目页与数据页只在论文原文明确链接时使用。
「直接命中」指论文自身研究长程任务训练或评估、轨迹学习、自进化、TTS 生成或评估。邻近项必须能指出可迁移的机制,而不是只共享 agent、LLM 或 audio 关键词。公众号正文把没有量化值的论文写成「提升」时,本文保留为「作者报告优于基线」,并把原文未报告的数字明确写出来。另有 6 个 arXiv 页面显示的提交日期早于 2608 编号通常对应的月份,本文按页面显示值保留,不把编号月份当成日期证据。
一、长程训练:先问反馈落在了哪一步
这组论文的共同问题不是奖励够不够大,而是奖励究竟在评价选择、执行、环境难度,还是训练目标本身。四种信号不能互相替代。
1. SkillGate:技能选择需要自己的信用通道
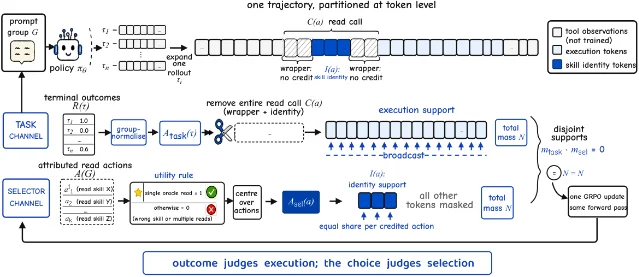
SkillGate: Training In-Policy Skill Selection in Long-Horizon Agents 研究的是一个常被结果指标遮住的动作:智能体在中途从候选技能列表里读哪一个技能。作者把问题命名为 selector credit starvation:在广播式序列级 advantage 下,命名技能的少量 token 只分到极小的损失份额;如果后续执行失败,正确选择还会继承负信用。作者在 12,800 条训练轨迹上观察到,选择 token 的中位数只占一条轨迹的 0.14%,约五分之二的选择 token 得到负 advantage,而且轨迹越长,这个问题越严重。
SkillGate 把训练 token 分成两个互不重叠的通道。task channel 只把终局结果的信用给执行 token;selector channel 只给命名技能的 identity token 一个 action-local advantage,而且只在一次读取且读取正确时为正。这样,任务做坏不会自动把选择动作判成错,选择本身也不再被长执行段稀释。
论文在 5 个智能体基准上使用一个包含 16 项的候选技能池,其中有 1 个 oracle 技能、5 个误导性硬负样本、5 个相关候选和 5 个无关候选;主评估包含 385 次试验。Qwen3.5-9B SFT/RL 初始化的成功率为 40.8%,SkillGate 为 53.2%,同等预算的 outcome-only SkillRL 为 47.0%;误导技能暴露降到 21.8%,oracle 技能暴露为 83.9%。训练设置包括 491 个训练任务、on-policy GRPO 100 步、每提示 8 条 rollout、全局 batch 128 条轨迹和 16 张 H800。论文同时公开 代码 与 SkillGate-9B 模型。
证据边界。 论文的基准覆盖代码、终端和工具调用;上面的训练配置来自作者公开的 HTML 全文。它证明的是在这类候选技能选择协议中拆分信用有效,不等于所有长程任务都应采用相同的 selector utility。
结论:精读。 如果研发系统把工具、技能或 workflow 当成可选择模块,这篇论文最值得先读的是信用切分的定义,而不是 53.2% 这个结果数字。
2. RTPO:多轮 RL 需要按回合逆序更新
RTPO: Reverse-Turn Policy Optimization for Stabilizing Agentic RL Training 将多轮 agentic RL 的不稳定拆成三个相互耦合的问题:rollout 与训练上下文不匹配,稀疏终局奖励下的回合级信用分配不足,以及不同长度轨迹在不同策略版本下带来的异步漂移。
方法把多轮 rollout 组织成稀疏反向树,沿时间逆序做回合级策略更新。作者的理论主张是,这样可以消除上下文不匹配和异步漂移,减少信用分配偏差,并收敛到递归最优。实验报告相对轨迹级基线提升 21.50%,相对回合级基线提升 10.76%;arXiv 摘要没有给出基准名称和基线实现名称,因此这里不能把百分比改写成某个具体 benchmark 的绝对分数。
结论:值得扫读。 它与 SkillGate 的差异很关键:SkillGate 在空间上切开选择与执行,RTPO 在时间上改变回合信用的传播方向。两者不是同一套方法的不同实现。
3. SPADE:让训练环境也成为可学习对象
SPADE: Self-Play in Adaptive Synthetic Executable Environments 让同一个 LLM 扮演两个角色。Environment Designer 把完整的长程训练环境写成可执行代码,暴露 OpenAI Gym 风格的
reset()/step() 接口,并同时生成状态转移、奖励函数和验证代码;Reasoning Agent 则在这些环境里学习行动。作者用智能体在有、无特权提示时的 reward 差估计 regret,让环境设计器把任务推到智能体能力边缘,同时保持可执行。实验中,设计器需要大规模预训练语料文档作 grounding,并维护累积的环境记忆。扩展到 30B 参数模型后,SPADE 在 8 个留出的数学、科学、代码和推理基准上平均超过最强固定环境基线 5.3 分;工具调用设置在 BFCL-v4 多轮上提升 5.7,在 ACEBench-Agent 上提升 13.9。游戏设置中的优势还随模型规模增加。
证据边界。 这些数字来自作者报告的跨基准平均和特定工具调用设置。论文摘要没有列出 8 个基准的逐项分数、环境生成失败率和更细的训练预算。论文明确给出 项目页 和 代码,但开放仓库不等于复现结果已经得到独立确认。
结论:精读。 SPADE 把「自进化」从修改模型参数扩展到修改任务分布,但读者需要重点检查环境设计器是否会制造可验证却不代表真实研发难度的任务。
4. DART-SD:只蒸馏恢复步骤,不要蒸馏整条轨迹
DART-SD: Diamond-topology Aware Retrieval and Tuning for Self-Distillation of Multi-Turn Tool-Calling Agents 关注多轮工具调用中存在多个顺序无关子目标的情况。合法解不是一条线,而是带分叉和合流的「钻石」拓扑;整条轨迹模仿训练会把合法替代路径压平,既惩罚正确的不同顺序,也减少策略多样性。
DART-SD 用 Interaction-State Transition Graph 表示执行状态,定位 Critical Topological Breakpoint,再检索成功的恢复参考,只对恢复步骤做自蒸馏,同时保护已经有效的推理前缀。作者报告它在复杂多轮工具调用基准上优于全轨迹基线,但摘要没有给出基准名、绝对分数和消融细节。
结论:值得扫读。 它给轨迹学习提供了一个明确的过滤条件:先判断失败发生在拓扑断点,之后再决定蒸馏哪一段;当前量化证据不足以支持更强的效果判断。
5. Governance Records as Supervision:让验证器选训练目标
Governance Records as Supervision: Verifier-Selected Self-Training for Structured Workflow Repair 不使用 oracle 目标或更强教师,而是把任务契约、模型尝试、验证器判定、被接受输出和目标来源组成治理记录。实验让 Qwen3-14B thinking 生成计划,再由独立 VAL 验证器选择 24 个被接受的计划,训练同一 checkpoint 做 non-thinking 一次性执行。
在 PlanBench 重规划的 80 个未开封用例上,VAL 选择的计划有 57 个被接受,其中 56 个是配对增益且没有回归;thinking 版本为 30 个。160 个新用例的匹配消融中,base、schema、模型自选和 VAL 目标分别得到 1、55、69、102 个被接受的计划;作者报告 VAL 相对自选的配对净增益为 33,
p=0.0000019647。适配器延迟约为 thinking 的 1/56。证据边界。 论文明确把边界限定在有界、机器可检查的能力,不支持任意规划、企业级有效性或无限制自我改进。论文摘要没有交代 VAL verifier 的完整实现细节和更广泛任务分布,因此不能把 102/160 外推到开放世界。
结论:值得扫读。 这篇工作把「谁来挑训练样本」单独暴露出来,适合和 SkillGate 放在一起读:前者选择的是目标,后者选择的是技能。
6. What is Missing from AI Post-Training AI:策略在开局就锁死
What is Missing from AI Post-Training AI: An Empirical Analysis 把 AI 训练智能体的能力分成两层:执行级能力是在既定训练策略内迭代,策略级能力是随着实验结果改变高层判断。作者分析公开的后训练轨迹后发现,智能体通常在最开始就锁定训练策略,剩下预算都用于策略内部的局部调整。
三个干预没有改变这个结论。经验驱动脚手架让 GSM8K 提升 12.6 分、HumanEval 提升 40.8 分,却没有改变策略;人类指导能改变初始策略,但训练开始后仍回到局部调整循环;增加推理计算对较容易任务有帮助,对最难任务几乎没有收益。作者因此把缺口定位为执行中的自发策略再评估,而不是经验、指导或推理算力本身。
结论:值得扫读。 这是一篇诊断性实证,不是一个已经解决 strategy lock 的训练算法;它更适合作为自进化系统的反例检查表。
7. 这一组论文不能合成一个「更好训练」结论
把 5 篇论文并排,监督信号的落点分别是:SkillGate 的技能身份 token、RTPO 的逆序回合、DART-SD 的拓扑恢复步骤、Governance Records 的验证器选目标、SPADE 的 regret 驱动环境设计。它们解决的对象不同:选择、传播、恢复、目标和任务分布。把它们都概括成「改进奖励」会丢掉方法的可迁移边界。
更实用的阅读顺序是:先检查自己的训练日志能否区分「选择错」「执行错」「环境太容易」「目标被选错」和「策略从未重新评估」。如果日志只有一条终局分数,以上五种失败会被混在一起,任何一个方法都很难直接对症。
二、长程评估:把行为放回可重复的环境
8. FM-Bench:20 个游戏年比一场短任务更能暴露管理行为
FM-Bench: A Benchmark for Long-Horizon Management with Competing Agents 让 LLM 智能体作为足球俱乐部经理经营 20 个游戏年。智能体要通过 26 个工具,在约 340—400 个决策节点完成选秀、转会、合同、设施与青训投资、阵容安排等决策,董事会可以解雇经理。世界由确定性游戏引擎推进,最终分数由累计荣誉、净资产增值和阵容价值组成,不使用 LLM judge 或人工评分。
作者测试 15 个模型,每个模型在 Solo 轨运行 3 个种子;Arena 轨让 15 个模型和脚本锚点进入同一个 20 年世界。Solo 轨固定种子为 1、1024、2026,Arena 轨种子为 7。高分模型更晚削减慢回报投资,更愿意保留现金继续投资,更早开启续约;这些行为指标与分数的 Spearman 相关分别为 −0.58、−0.50 和 +0.45,而 token 花费、模型价格和供应商不能预测排名。论文还报告冠军在 10 个模型间轮换,说明单一总分不能替代行为解释。
论文固定模型 ID、提示、温度和完整推理配置,并记录引擎 commit、参数 hash、分数版本和配置;作者明确给出 FM-Bench 代码。论文没有说明数据集是否另行公开发布。
结论:精读。 这篇论文的真正价值不是足球题材,而是确定性累积环境、长时段行为指标和可复现配置。它适合用来反问自己的长程 benchmark:模型是否能从被拒报价中更新策略,还是只会重复局部动作?
9. FinSkillBench:先控制技能包,再比较模型
FinSkillBench: Evaluating AI Agents and Domain Skills for Investment Management 是邻近工作,但它把长程技能评估的对照设计做得很清楚。基准覆盖组合构建、风险管理和基本面分析 3 个领域、12 个子任务和 2,603 个 episode;每个 episode 都包含 point-in-time 输入、隐藏真值和任务特定验证器。
论文比较无技能、精选技能包和智能体在 episode 内自生成技能三种条件。9 个模型的平均分从 0.366 提升到 0.528;自生成技能收益很小,却有更高计算成本。独立 Hermes Agent 框架用 8 个模型、5,280 个 episode 复现了方向一致的结果。迁移到本频道关注的长程智能体时,最可复用的是「技能包质量 vs 模型选择」的交叉对照,而不是金融任务本身。
结论:值得扫读。 如果一个长程 benchmark 不报告 point-in-time 输入、隐藏真值和验证器,读者很难判断它测到的是模型能力,还是信息泄漏和评判器偏好。
10. FACET:训练任务先要可执行,再谈数据规模
FACET: Preserving Source Intent and Executable State in Terminal Task Synthesis 是邻近工作。它把一个终端任务视为四件耦合的东西:指令、初始化环境、参考解和可执行验证器。若四者依赖的状态不一致,任务会变得不可解,或者验证器会把合法答案判错。FACET 先重建相关技能和连贯场景,再实现并修复环境,最后生成任务四件套;容器状态同时给指令、参考解和验证器提供 grounding,并用执行验证和定向修复减少整任务重生成。
作者报告,FACET 生成了带密集可执行检查的复杂终端任务,成功轨迹可以提供数据高效监督,多尺度微调在 Terminal-Bench 2.1 上持续提升。但摘要没有给出具体提升数值,训练任务规模和成本也需要打开全文后再判断。迁移价值很明确:长程训练数据合成必须同时保存 source intent 与 executable state。
结论:值得扫读。 它更像训练数据管线的设计规范,而不是已经充分量化的模型方法。
11. 评估接口的三层补充
- Self-Evolving Agents as Dynamic Graph Transformation: A Survey and New Perspective 是直接命中的自进化综述。它把记忆、工具、技能、工作流和智能体间关系表示成带类型的节点、边和子图,用 schema 约束的重写描述进化;论文提出节点/特征、边/拓扑、子图激活、跨组件协同进化四类方法,并映射 9 个动态图子领域和 5 类图感知评估与治理协议。它没有实验数字,适合作为术语地图,而不是效果证据。来源:arXiv · 公众号
- Eureka: Task-Conditioned Meta-Agent Orchestration for Scientific Discovery 属于邻近跟踪。它把长程任务编译为带接受语义的动态义务图,并在瓶颈反复出现时做成本收益门控的局部架构演化。作者报告 170/170 个递归任务完成、生成 3,948 个证书且没有错误接受,中位 active context 从 9,490 压到 4,005 token,12,000 个任务避免 65.38% 的重复计算。科学发现部分的数学主张仍应回到论文逐项审计;系统结果与数学结论不能混为一个证据等级。来源:arXiv · 公众号
结论:前者值得扫读,后者邻近跟踪。 两篇论文分别提供工作流状态表示与架构编排接口,但都不能替代 FM-Bench 这类可重复的长期行为评估。
三、TTS 与音频生成:延迟、连续性和编解码器要分开看
12. X2Streaming-TTS:真正消费不确定的文本前缀
X2Streaming-TTS: Causal Token-Level Text-to-Speech from Streaming Text with Speech-State Inheritance 指出,许多所谓流式 TTS 仍然等到句子级文本,因此只是伪流式。X2Streaming-TTS 消费异步到达的文本 token,不访问未来输入就输出语音。
它用 causal commitment 处理不确定前缀:通过不确定性感知缓冲、容量自适应和标点感知分段,让表达先保持 provisional;再用 causal speech-state inheritance 跨段传递完整 Code2Wav 状态和选定的历史 Talker 状态,配合 attention prior 约束阻断未来位置。作者报告系统在多数主观和客观指标上优于伪流式模型,质量接近所评离线基线;单请求 TTFT 中位数为 15.8 ms,128 并发时为 260.8 ms。原文明确链接 代码仓库,但仓库公开不等于复现结果已经得到独立确认。
证据边界。 摘要没有列出全部评测数据集、基线名单、音质分数和并发硬件配置,因此 TTFT 不能直接等同于端到端首音延迟,也不能据此推断所有播客场景都能达到同样时延。
结论:精读。 读者应把它拆成两个可复用问题:前缀不确定时何时承诺文本,以及承诺之后怎样继承声学状态;不要只看 15.8 ms 的宣传数字。
13. Geometric Iterative Retrieval:把 RVQ 层级变成恢复过程
Geometric Iterative Retrieval for Neural Audio Codec Resynthesis 处理的是 TTS 和通用音频生成的底层保真度瓶颈:从粗 codec token 重合成高质量音频。作者认为「离散 token 预测 vs 连续回归」的二分法不完整,改用 RVQ 层级作为连续 codebook space 里的迭代分解,在几何空间中做对比检索。
论文在语音和音乐编解码器恢复任务上报告优于单次 token 预测和一步回归基线,但摘要没有给出数据集名和具体数值,也没有论文明确链接的代码仓库。它对本频道是直接命中音频生成基础组件,而不是一篇完整的 TTS 系统评估。
结论:值得扫读。 这篇论文直接命中音频生成基础组件,但当前证据只有摘要级方向和相对基线判断,原文阅读优先级低于 X2Streaming-TTS。
四、邻近但值得跟踪:每篇为什么能迁移
下面集中列出其余 11 篇邻近工作;加上前文的 FinSkillBench、FACET 和 Eureka,共 14 篇。它们没有直接回答本频道的四条主线,但每篇都提供一个可以迁移的评估、搜索或自验证机制。迁移关系写在每个条目里,读者不需要把它们误认成 TTS 或长程 agent 的直接结果。
评估器与验证器
Competence, Not Accuracy: A Diagnostic for Reference-Free Judge Gates in Skill Optimization 把无参考 LLM judge 看成一个潜在求解器,给出可分辨性的必要条件
c > 1/k,其中 c 是评判器能力,k 是答案空间大小。作者还指出,基准准确率会高估评判器在优化闭环里真正有用的能力,并提出不改变门控决策的非干预探针。迁移点是自进化管线的上线前检查:先测 judge 是否够格当门,再让它筛技能或轨迹。没有给出一个适用于所有任务的统一阈值。来源:arXiv · 公众号Metrics That Write Themselves: Evolving an Evaluator from Its Own Blind Spots(公众号题名对应论文 EvalCEGAR)把评估器表示成 Python 算子池,寻找「一正一误却得到相同分数」的 collision,再用碰撞请求扩展算子信息。论文在 MBPP+/HumanEval+ 的 428 个未见任务上把与理想过滤器的差距缩小 15.4%,报告增益 +0.0065、
p=0.0010;8 次运行有 6 次涌现且样本外改善。迁移点是为 TTS 或播客质量开发自动指标时,主动寻找同分异质的音频对,而不是只扩大标注集。来源:arXiv · 公众号SESSE: Sketch, Expand, Sort, Summarize, Evaluate -- LLM-as-Judge Evaluation via Structured Decomposition 把整体 A/B 偏好拆成从评判器错误案例中挖掘的结构化子问题,不需要 oracle 响应、任务 rubric 或微调。在 RewardBench 1,000 个样本上,作者报告其结果接近 chain-of-thought 基线,并与 92.7% 的微调 RISE-Judge-32B 竞争,但没有给出 SESSE 自身的精确分数。迁移点是把 TTS/播客整体偏好拆成自然度、说话人一致性、内容忠实度和时序等可审计维度;证据仍是文本 judge 侧的结果。来源:arXiv · 公众号
Grading the Graders: Verification Autonomy Levels (L0-L5) for LLM Reasoning 按验证规范的来源和结论保证什么,把验证自主性分成 L0-L5,并指出替换或采样式验证器能确认候选满足某性质,却不能证明没有漏掉合法候选。迁移点是给长程任务的验证器标注「能保证什么、不能保证什么」,避免把局部正确性当成完备性。它是元标准和跨领域比较,不是一个新的长程训练基准。来源:arXiv · 公众号
搜索、长上下文与环境难度
Test-Time Scaling in the Wild: Why Exploitation, Not Exploration, Is the Bottleneck 在医学、法律、金融、通用对话和创意写作 5 个基准上比较 5 类测试时缩放,把候选池生成拆成 exploration,把最终选择或综合拆成 exploitation。候选池最优质量会随算力稳定提升,但奖励模型和真实质量的相关性只有约 0.12;Fusion 是唯一一致有效的方法,却只恢复候选池可用质量的约 40%。迁移点是长程自进化和 TTS 候选生成都不能把「产生更多候选」当成闭环完成,选择器和综合器应单独评估。来源:arXiv · 公众号
Compiler-Guided Adaptive Proof Search with Cross-Model Synergy on Context-Dependent Theorem Proving 在 7 个真实 Lean 4 项目上,用双模型生成和停滞触发重采样探索不同起点,再用编译器反馈利用当前最优证明状态;作者报告 pass@32 平均通过率提升 12.8 个百分点、LLM 调用减少 21.9%,但未报告绝对通过率。迁移点是长程轨迹搜索的探索—利用控制:失败轨迹只有在保持可验证状态时才值得复用。来源:arXiv · 公众号
Position: Profiling Game Worlds by Transition Complexity 提出 Transition Complexity Profile,用内在单步分支、交互诱导不确定性、对手影响和时空依赖跨度描述环境难度,并要求报告参考分布、协议随机性和版本化测量预算。迁移点是把环境复杂度作为长程 benchmark 元数据,解释同一智能体为何在不同环境出现相反结果;论文是 position 工作,没有给出统一模型排行榜。来源:arXiv · 公众号
LongNovel: A Multi-Scale Benchmark for Hallucination Detection in Long-Context Novel Summarization 用 29 部、每部 16k—100k token 的中英双语小说和 BookSum 章级数据,定义 8 类幻觉,并用 Multi-Model Arbitration 与 Entity-Referenced Hallucination Generation 保持类别覆盖,测试集经过人工修订。迁移点是把长程 agent 或播客长文的忠实度评估拆成多尺度、实体关联的检查,而不是只算一个整体分数。论文报告数据集有挑战性并发布供后续研究,但摘要没有给出完整模型分数。来源:arXiv · 公众号
音频和内容侧迁移
Assessing Quality of Experience in Natural Language Generation of German Text(公众号题名为 TextQ-German)为德语摘要和机器翻译建立 QoE 人工评估套件,再训练 transformer、语言学特征和混合模型预测感知质量。作者报告混合模型在几乎所有设置优于纯 transformer,语言学特征模型接近微调 LLM。迁移点是为 TTS 或播客评估建立人工感知维度、自动预测和 held-out 泛化三段式管线;文本 QoE 结果不能直接当作音频质量结果。论文明确链接 TextQ 数据仓库。来源:arXiv · 公众号
Finetuning Strategies for Querying Sounds by Vocal Imitation 是 AES AIMLA 2025 音效语音模仿查询挑战赛的获胜方案技术报告,比较冻结预训练 CED 编码器的对比学习,以及 MobileNetV3 编码器的联合对比—三元组学习和半硬负样本。摘要未提供挑战赛量化分数和排名细节。迁移点是把语音查询、音频检索和半硬负样本策略用于播客素材检索或 TTS 评估中的相似声音采样;它不是 TTS 生成论文。来源:arXiv · 公众号
Alignment Is All You Need: Instruction-Free Training for General Audio-Language Models(公众号简称 LALM)冻结音频编码器和 LLM,只训练轻量投影器;LLM 把 caption 扩展为无任务指令的自由响应,用来构造音频—响应训练对。作者报告在 MMAU、MMAR、MMSU、MMAU-Pro 上以更少数据达到或超过重度后训练基线。迁移点是播客内容理解和音频检索的低成本对齐,但它没有直接评估播客生成质量。来源:arXiv · 公众号
研发判断落点
这批论文可以压缩成四个可执行的检查问题。
- 选择和执行是否分开记账? 如果技能、工具或 workflow 的选择只有终局奖励,SkillGate 的 selector credit starvation 就可能发生。日志至少要能还原选择 token、选择是否正确、后续执行结果和轨迹长度。
- 训练是否能重新考虑策略? RTPO 处理信用传播,DART-SD 处理合法路径的局部恢复,What is Missing from AI Post-Training AI 则提醒读者:更多经验、指导和推理算力都不保证策略会重选。三者应在不同实验里分别测量。
- 环境和验证器是否真的可重复? FM-Bench 的确定性累计分、FACET 的任务四件套、FinSkillBench 的隐藏真值与验证器,分别对应环境状态、训练任务和技能评估的可复现约束。自进化环境还要额外报告难度如何随模型变化,不能只报告最终分数。
- 音频系统有没有把质量和时延分开? X2Streaming-TTS 提供 TTFT 与边界连续性的直接问题;TextQ-German、SESSE、EvalCEGAR 和 Competence, Not Accuracy 则提供感知维度、评判分解、评估器盲点和 judge 上线前诊断的迁移线索。它们能帮助设计评测,但不能把文本或代码 benchmark 的数字直接改写成 TTS 或播客质量。
本批最清楚的主线是:长程系统的瓶颈越来越像「谁在什么时候得到什么证据」,而不只是模型有没有更多参数。直接命中的 10 篇负责给出训练、环境、评估和 TTS 基础组件的具体答案;14 篇邻近工作负责提醒读者,候选选择、评判器资格、环境难度和感知质量不能被一个总分吞掉。播客生成与评估本批没有直接命中,读者若要沿这条线继续追踪,应先从 X2Streaming-TTS 的低延迟语音链路和 TextQ/SESSE 的可审计质量维度接上,而不要把邻近项当成已经完成的播客方案。
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.