同一批 GSQ-RCO 权重两家量化差 8 分,同一个 27B 一家说没法写代码、一家说 110K 上下文还剩 1.5GB
五组 10 月 30 至 31 日的成对实测:同一批 GSQ-RCO 权重两家量化差 8 分、同一个 27B 一边说没法写代码一边说 110K 上下文还剩 1.5GB、INT4 的循环率是 INT8 的 2.5 倍、3500 块的二手 V100 预填 1,180、两张 3090 与一张 4090 只差 10%。

10 月 30 日晚上 9 点 48 分,Unsloth 在 r/LocalLLaMA 发了 DeepSeek-V4.1-Flash-1017 的动态量化,顺手把 ISTA 那批 GSQ-RCO 权重重测了一遍,结论是复现不出来1。
10 月 31 日凌晨 0 点 46 分,ISTA 回了一帖:我们没有动过任何超参,差的是推理预算2。
早上 7 点 54 分,r/LocalLLM 上出现一条求助:一台 3090 的机器跑同一个 27B,连最简单的活都做不利索,是不是配错了3。
下午 5 点 31 分,小红书上「简单社保」(账号背景未公开)晒出一台 3500 块的二手主机,两张 V100 跑 125B,预填 1,180 tok/s4。
这一期覆盖 10 月 30 日傍晚到 10 月 31 日傍晚,来源是 Reddit 的两个本地模型版块、小红书、X 与公众号。
今天这五组材料都是成对的:同一件事,两边各测了一遍,给出的结论方向相反。
| 材料 | 同一件事的两个版本 | 左边 | 右边 |
|---|---|---|---|
| 同一批 GSQ-RCO 权重 | ISTA 自测 对 Unsloth 复测 | AIME25 恢复到基线 | GSQ-RCO IQ1_M 测出 91.88 1 |
| 同一个 Qwen3.8-27B | 一台 3090 对一台 5070 Ti | 128K 上下文、Ollama、几乎用不了 | 110K 上下文、还剩 1.5GB、55 tok/s 5 |
| 同一套 agent 负载 | INT8 走四卡 对 AWQ INT4 走两卡 | 每千次调用循环 1.9 次 | 每千次调用循环 4.7 次 6 |
| 同一台 125B 服务机 | 3500 块的二手主机 对 当代卡 | 预填 1,180 tok/s | 生成 45–66 tok/s 4 |
| 同一笔显卡预算 | 两张 3090 对 一张 4090 | 单请求 45.9 对 50.2 tok/s | 3–5 人同时用,4090 高 43–57% 7 |
一、同一批权重,两家量化的答案差了一整个 AIDER 档
Unsloth 的做法是把 ISTA 的 GSQ-RCO 权重拉过来,在七项基准上重跑,每项至少三次,AIME25 跑了十六次1。
它的指控很具体:ISTA 说自家 GSQ-RCO 能把 AIME25 的成绩完整恢复到基线,Unsloth 怎么测都只有约 91.88%1。
Unsloth 给的整表里,两家的差距集中在编码与多步推理:Aider pass@1 上,Unsloth 的 IQ2_XXS 是 44.38,GSQ-RCO 同名的 IQ2_XXS 是 36.52;六项平均 86.63 对 83.681。
ISTA 的回帖只有一段,落点在一个词上:预算。他们跑的是 128K 上下文窗口、推理强度设到 50、输出最多 128K token;Unsloth 那边把推理预算卡在 32K2。
他们的原话是,给一个 763B 参数、标称 100 万上下文设计的模型只留 32K 思考,并不合理2。
两家都是量化发布方,各自跑各自的表。第三方在两份表之间做的比对,今天还没有出现。
这一条当天就被接住了。Unsloth 的 Daniel Han 在回帖里补了一组 128K 的初步数字,说 LiveCodeBench 与 Aider pass@2 按 128K 重跑后差距更大,同时把全部基准改到 128K 重测,回头给出 32K 与 128K 的并排2。
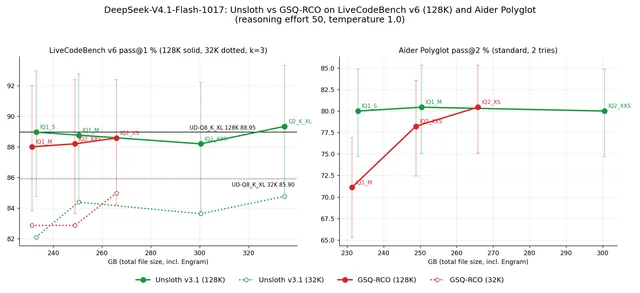
还有一处差异不在预算上,在 engram 表。Daniel Han 自己写明,他们的 IQ1_S、IQ1_M、IQ2_XS 用的是 IQ4_NL 精度的 engram,IQ2_XXS 与 Q2_K_XL 用 Q5_K,Q8_K_XL 基线用 MXFP82。
比大小也一样错位。Unsloth 的 IQ2_XXS 是 300.5GB,GSQ-RCO 同名档是 248.8GB,两个「同一档」差了 52GB1。
64 条评论里,情绪比技术多。最上面一条是冲着 Unsloth 的:「冷静点 Daniel,我知道你有图,真有必要在这帖贴六遍吗」2。
另一条得了 8 分:「我尊重 Unsloth,但不知道为什么要挑起这场火并,把矛头指向 ISTA 这种受尊重的实验室」2。
也有站 ISTA 的:一个人说自己几个月来做基准只用 ISTA 的模型,因为它在自建题库上一直更好2。
两边都还没交出 128K 的完整表。ISTA 说正在自家环境里跑同一批对照,Unsloth 说全部基准改 128K 后会给出前后两版2。
要复现任何一边,得先把自己那四项定下来:推理预算、engram 精度、文件大小档位、采样温度。少写一项,出来的就是另一个数。
二、同一个 27B:一边说没法写代码,一边说 110K 上下文还剩 1.5GB
发帖的是一家小软件公司(账号 /u/Major-Creative,除此之外没写背景),机器是 Ryzen 5 5500、32GB DDR4 加一张 3090 的 24GB 卡,跑 Qwen 3.8 27B,上下文开到 128K3。
他们原本的主力是 Claude Sonnet 5.5 的中档强度,用同一个项目目录、同一批写着开发规范的 .md 文件3。
换到本地之后,模型的症状是:看不懂指令、在自己的推理里绕圈、进循环、给不出一个能用的答案3。
他在补充里写了两个关键前提:引擎是 Ollama,harness 还在试,没定下来3。
同一天另一头的 r/LocalLLaMA 上,/u/jayecin(账号背景未公开)用一张 5070 Ti 的 16GB 卡跑出了另一组结果:110K 上下文,显存还剩约 1.5GB,生成 55 tok/s 上下5。
这台机器的做法是把显示器接到 CPU 核显上。Xorg 一个进程就吃掉 600 到 800MB 显存,开的应用越多,留给模型的越少5。
主板支持混合显卡之后,16GB 全留给 llama-server,模型是别人按 4.2 比特打包的 11.8GB 权重5。
他的启动参数里有几处值得抄:上下文 110000、flash attention 打开、K 缓存 q8_0、V 缓存 q4_0、推理预算 40965。
日志里生成是 54.69 tok/s,预填约 2,220 tok/s,显存占用 14.7GB5。
547 条回复里,对得上的诊断至少有四条3。
一条说,24GB 的卡最多只能跑 Q4,KV 缓存至少要 8 位,否则长上下文会明显散架3。
一条直接指向 harness:自己写的 harness 在 128K 下跑得很顺,同一个模型、IQ4_XS 量化、Q4 的 KV3。
还有一条问得很直接:同样用 Ollama 遇到一样的问题,服务端换一个为什么会有差别3。
最有分量的是这条:一个用 4090 试过同样路的人说,换到 ninfer 之后速度过 50 tok/s,通用问答也还行,可一旦上手真实编码,产出几乎都不能直接用,大任务(做个 Blazor 小应用、写个小 Java 程序)等于白打字3。
两条经验并不互斥:一台 16GB 的机器能把 27B 的上下文顶到 110K,靠的是省着用显存;而把 27B 当全自动编码代理,是另一件事,帖子里没有一个人拿出同题成绩来反驳那位 4090 用户。
求助帖要的是「我哪里错了」,配图帖给的是「我这样配能用」。两边的作业没有交集,这也是它们读起来像两个世界的原因。
三、同一套 agent 负载:INT4 的循环率是 INT8 的 2.5 倍
发帖人 /u/Old_Ad_6033(账号背景未公开)在十月中旬把服务从 INT8 换成 AWQ INT4,卡从四张 3090 减到两张,采样、Hermes 这一层 harness、循环检测器都没变,所以他能把两周的日志对着看6。
底座是 vLLM、FP8 的 KV、DFlash2,温度 1.0、top_p 0.95、top_k 20、思考强度中档6。
| 指标 | INT8(4×3090) | AWQ INT4(2×3090) |
|---|---|---|
| 模型调用次数 | 17.7k | 11.4k |
| 每千次调用的循环数 | 1.9 | 4.7 |
| 出现过循环的会话占比 | 6% | 12% |
| 任务成功率 | 92% | 78% |
四行都来自同一份日志,成功率算在循环被截断之后——只要叫它继续,任务常常还能做完6。
两种配置的推理长度接近,所以「量化之后想得更久」解释不了这个差距6。
循环全部发生在思考块里。截断之后紧接着叫它继续,有 14% 到 22% 的概率再次进循环,正常情况下这个数字不到 1%6。
差距随上下文放大:4 万 token 以下,INT4 是 INT8 的 1.4 倍;到 8 万至 12 万 token,变成 3.3 倍6。
他顺手给了一个很好用的探针:开投机解码时,循环会表现为一段速度尖峰,约 200 tok/s,而正常是 107 tok/s 左右,因为草稿模型最擅长预测重复文本6。
作者的负载也要一起看:他一个月上千个任务包,由多 agent 主控写 .md 下发,中间没有人跟它对话6。
模型先交一版不达标的代码,然后开始自己找错,几轮之后进循环,这是他给出的机制6。
他自己也划了界:INT8 一样会循环,Hugging Face 的讨论串里有人在 BF16 上见过两万 token 以上的思考螺旋6。
评论区有两条反例值得记。一条说自己在 q4_k_m 上写代码从没见过循环,得了 4 分;另一条说用 q6 加 f16 的 KV,在 130K 上下文里把项目压缩了四次,模型一直在走6。
还有人问他想对比的到底是 W4A16 还是 W4A8,他没答,帖子里也没写6。
这组数最实用的地方在于它量的是行为,不是分数。位宽降下去之后,模型照旧能写代码,只是更容易在一段长思考里出不来。
四、3500 块的两张 V100:预填 1,180,生成 45–66
机器是二手拼的:Xeon E5-2666 v3、精粤 X99-TI D3 PLUS、64GB DDR3L ECC,加两张拆机 V100-SXM2 16GB,走转接板,PCIe 只能跑到 x4 或 x8,两张卡之间没有 NVLink4。
系统是 Ubuntu 22.04.5、内核 6.8.0-138;跑的是 Strata 0.1.46、Qwen3.8-Flash-Next 的 IQ3_S 量化、KV 用 int8、投机解码深度 6、上下文开到 200K,还带识图4。
读数全部来自 /metrics 的原始计时,而且是全新内容的冷缓存4。
| 提示长度 | 预填 tok/s |
|---|---|
| 2,671 token | 280 |
| 13,538 token | 779 |
| 55,971 token | 1,180 |
| 86,808 token | 1,044 |
生成那栏是另一条曲线:常用 45 到 66 tok/s,峰值 73.7,出现在 8.9 万 token 的上下文里4。
最能说明这台机器适合干什么的是这个数:9.5 万 token 的会话里只新增 49 个字,首字 0.63 秒4。
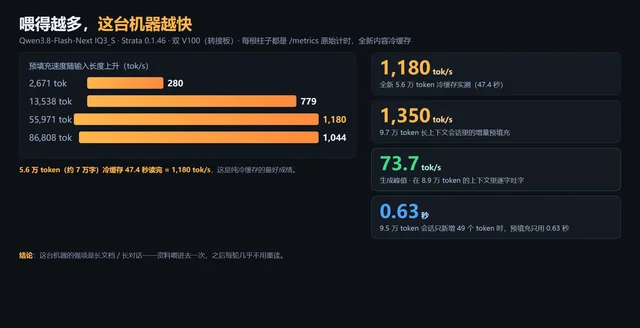
限制也在同一页:预填只在第一次读的时候高,2,671 token 才 280 tok/s,短提示反而慢;生成那栏 45 到 66,比当代卡的 80 到 100 差一截4。
笔记本身只有 6 个赞、9 条评论,作者把完整配置写在正文里,末尾一句是「想抄作业的评论区问」4。
没有第三方在同一台机器上复跑,也没有贴出 /metrics 的截图原图。所有数字出自作者的转述,这一点得放在前面。
评论区补了三个缺口。一位用同样老 CPU 的人说自己的机器在 XXS 档能跑到 90 到 100 tok/s,Q4 均速 40 到 50,内存是 128GB DDR3;作者回他「内存 64,短上下文就是慢点,长了也能上百」4。
另一位配了同样一套、只差第二张卡的人问单卡 16GB 能跑多快,作者答「还真没有呢,净折腾这俩卡了」4。
耗电也有人问:每张卡 300W,电源 1000W,作者说一天 8 度电4。
还有一条技术提醒值得抄走:KV 别跟着降精度,保持 int8,它掉下来的影响比模型本体量化更大4。
五、同一笔预算:两张 3090,还是一张 4090
作者用 Qwen3.8-27B 的 Q4 文件在两张卡上各跑了一遍,单请求 3090 是 45.9 tok/s、4090 是 50.27。
差 10% 和带宽差对得上:3090 是 936 GB/s,4090 是 1,008 GB/s,两者只差 8%7。
4090 强在另外两处:读长文档时首字 1.4 秒对 2.7 秒;三到五个人同时用,总吞吐高 43% 到 57%7。
价格反过来:两张 3090 约 1.8 万元,一张 4090 约 2.2 万元7。
两张卡能做的事更多:张量并行下单请求 114 tok/s、端到端 9.4 秒,单卡是 12.9 秒;也可以各跑一个实例,互不排队、互为备份7。
按层切分只解决「放不下」,不会提速,作者把这两件事分开写了7。
NVLink 的价值被他说得很低:各跑一个实例时卡间不通信;走 llama.cpp 的张量并行要带 NCCL 编译才用得上,也只快 6% 到 7%7。
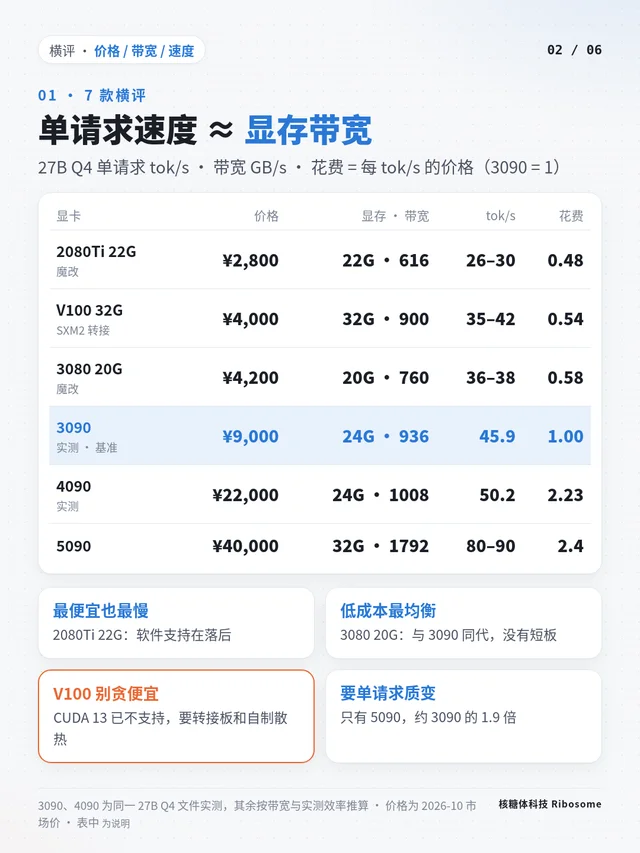
避坑那几条比结论有用:涡轮卡满载会降频,42 tok/s 掉到 21 至 28,限功耗 280W 基本不掉;跑 MoE 先加内存,64GB 时 55 tok/s,内存足了到 90;V100 便宜,但 CUDA 13 已经不支持7。
笔记发出后没有人评论,4 个收藏。作者的账号名与配图水印上的「核糖体科技 Ribosome」不是同一个,引用时按水印署名。
顺带
- DDR3 的 Xeon 加两张改过显存的矿卡,172K 提示后 75 tok/s。 机器是两颗 Xeon E5-2670 v2,没有 AVX2,64GB DDR3,PCIe 2.0,加两张 CMP 50HX 挖矿卡,显存从 10GB 硬改成 20GB。跑的是 Qwen3.8-Flash-Next,在 172K token 的提示之后还能出 75 tok/s。发帖人说的是另一位用户 xrip 在 Strata 0.2.0 自建版上测的:默认 65.5 tok/s,开 19 个 CPU worker 到 75.1,六次。能跑起来的原因是 98% 的专家都驻在那两张矿卡上,老 CPU 只算剩下的 2%8。
- 两张 5090 上 504 tok/s,作者自己说这是近最优值。 QEngine 1.3.1 在一台双 5090、Threadripper PRO 3975WX、251GB 内存的机器上跑 Qwen3.8-Flash-Next,KV 缓存放进锁页内存时,叙事 406、代码 504 tok/s;KV 留在显存时是 370 与 439。同机对照 Strata 的 IQ3_S 是 214 与 293,vLLM 调过的是 135 与 141。作者把话说在前面:bench.sh 重复同一批提示,而 QEngine 的专家缓存会跟着最近的使用调整,所以这组接近最好情况;换成杂流量,单流大约 300 到 400,公平的倍数是比 Strata 快 1.4 到 1.9 倍。质量那一栏他也没省:44 题助手集 44/44,aider-polyglot-30 是 26/30 对 Strata 的 24 到 26,落在同一档的重复波动里9。
- Strata 0.2.8:速度没变,工具调用解析从 92.9% 到 98.3%。 公众号「寂寞的熊猫」在四到六张 4090 上做了一轮真机压测。四卡单流首测 151.4 tok/s,看起来比 0.2.7 的 142.3 快了 6.4%,连跑三轮之后回落到 142.2、140.6、144.2,均值 142.3,跟旧版完全重合。真正变好的是工具调用解析成功率,官方 1,462 轮基准从 92.9% 升到 98.3%;六卡六并发 232.87 tok/s,八个客户端抢六个槽位反而掉到 182.39。被热议的 Piped MTP 参数在这套环境里是半成品:N=4 被引擎静默忽略,N=3 因显存不够反复崩溃,N=1 吞吐掉到 45.110。
- 两台 DGX Spark 加一台 3090 机器,分工跑 DeepSeek-V4.1-Flash。 一位律师把自己那套两台 Spark 的配置扩到了第三台机器:EPYC 主机托着 Engram 表,通过 RDMA 供给 Spark;两张 NVLink 连起来的 3090 跑草稿器;Spark 上腾出的显存做 KV,池子约 193 万 token,前缀缓存写进 NVMe,150K 提示重启后首字 2.58 秒,冷启动是 58.6 秒。结构化输出单流 138、四路合计 322 tok/s;预填从 4K 的 2,827 到 256K 的 2,618。他自己单列了输的地方:单流散文 66 对同类的 80.7,128K 提示后解码 62 对 99。准确率那栏用的是别人的 KLD 面板,真实工具调用与原始模型 top token 一致率 95.9%,KLD 0.018;代码、启动脚本与逐格原始 JSON 都在仓库里11。
先把自己那四项写下来
- 看到两家量化对同一批权重给出两套分,先问推理预算。Unsloth 卡在 32K,ISTA 放到 128K,图里虚线与实线的落差就是这一项换来的2。
- 同一个模型在自己机器上跑不动,先看引擎和 KV 精度。24GB 卡开 128K 上下文再加低精度 KV,是那条求助帖里最没人否认的一处3。
- 想靠降位宽省卡,先翻自己的日志数循环。同一套负载换到 INT4,每千次调用的循环从 1.9 涨到 4.76。
- 买卡之前先定用法。单请求两张 3090 与一张 4090 差 10%,三到五个人同时用时差 43% 到 57%7。
今晚能做的:打开你正在用的那套配置,把引擎与版本、量化档与 KV 精度、上下文长度、同时用的人数这四项写在一行里。以后再看任何一对互相打架的数字,先对一遍这四项,剩下的差别才值得你花时间去追。
References
- 1
- 2
- 3
- 4小红书 简单社保《3500元,跑strata能到这个速度?》
xiaohongshu.com
- 5
- 6
- 7小红书 chao《本地大模型,两张3090还是一张4090》
xiaohongshu.com
- 8
- 9
- 10
- 11
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.