自费一千美元跑完的路由更贵更慢、一个 4B 模型赢了俄罗斯方块输了考卷、一个脚本 bug 值 47 个百分点
自费 1000 美元实测的模型路由器比它要替代的档位更贵更慢,一个 4B 决策模型在俄罗斯方块上赢过对手却在知识题上输 29 分,一个验收脚本的 bug 值 47 个百分点:八组材料把决定账面的那一档指出来。

OpenRouter 在 9 月 25 日上线了 Jev Router:用 Jev 做决策的模型路由器,按每个请求挑模型和推理档位。官方说法是它在四个 agent 基准上比自家的 Auto 多解决了 82% 的任务。
十几个小时后,一位开发者给出了另一种读法。Theo 自费 1000 美元、熬到凌晨两点跑完 DeepSWE,结论写在帖子里:性能大约等于 GPT-6 Astra 的低档,成本略高,耗时接近五倍。
同一批材料里,另一个 4B 模型的故事反过来。Mica v0.1 4B 是一份 Apache-2.0 的决策模型,全部实验加训练花掉不到 30 美元的租卡时间。作者让它和另一位开发者做的 Kev 4B 玩同一批俄罗斯方块,三个种子下来 Mica 清掉 33、97、93 行,Kev 是 27、17、11。同一份权重在 MMLU-Pro 上拿 53.0 分,Jev 是 82.3。
国内这边,一位做本地模型横评的作者碰到第三种情况。他的新模型第一次出榜只有 25%,九道题里八道被判「不可执行」,按原计划该删掉它腾出 10GB。他把验收脚本的围栏剥离逻辑查了一遍,修好之后同一个模型是 71.9%。
这一期覆盖 2026 年 9 月 25 日至 9 月 26 日,来源为 X、Reddit、小红书与公众号,另含一个模型页面、一份模型卡与两处代码仓库。八组材料按「任务与运行条件 → 具体数字 → 分歧或反例 → 作者自陈的限制 → 原帖」逐条给出,供正在选模型、自己部署和报账的读者核对。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 给每个请求挑模型和推理档位 | Jev Router(typesafe/jev-router,9 月 25 日上线,调用免费、100 万 token 上下文);Theo 自费 1000 美元跑 DeepSWE 12 | 官方称比 Auto 多解决 82% 的任务;实测性能约等于 GPT-6 Astra 低档、成本略高、耗时近 5 倍 | 官方未公布基准名、每题成本与完整对照;实测只跑了 DeepSWE 一个基准 |
| 4B 决策模型打真人游戏 | Mica v0.1 4B(Qwen3.5-4B 全 32 层 rank-16 LoRA)对 Kev 4B,RTX 3090、Q5_K_M、俄罗斯方块三种子 3 | 清行 33/97/93 对 27/17/11;最佳落点约 75% 对 50% | 作者评的是自己的模型;单卡单次 |
| 同一个端点上的两个决策模型 | Kev 4B 对 Jev,同一端点;362 条在两个模型上线之后才发布的题 4 | 精度差 2 分以内;PAWS 87.0% 对 74.5%;Jev 每请求多算约 257 个输入 token,短请求最多贵 12 倍 | 题量 362 条;评测方是其中一方的创始团队 |
| 8GB 显存跑 177B | Qwen3.8-Flash-Next UD-IQ1_S,8GB 显存加 32GB 内存,Windows 虚拟内存上限改到 98304MB 5 | 6 token/s、6 项考试 56/60;加载 113 秒(dio)对 59 秒(默认)对 37 秒(二次启动) | 单机单次;作者自陈不适合聊天;ngl 加到 20 反而掉到 3.1 token/s |
| 挑本地编码模型 | 9 道独立短函数,Ollama 0.34.0、RTX 3060 Laptop 6GB,严格交付口径 6 | 脚本修好后 71.9%(修前 25%,差 47 个点);七个模型里冠军 69.6% | 题量 9 道;分母随跑通的题数变化(61 到 69) |
| 砍掉多余思考 | Swift-1.5-Qwen3.8-Flash-Next 对基础 Flash-Next,同一套 Aider 题,两边都在 xhigh 档 7 | token 中位 17,646→6,991、每例 1542→608 秒;首答 40.2%→41.1%,配对检验 p≈0.29 | 一套自建 Aider 题;两边量化档不同(Q5_K_L 对 Q5_K_XL) |
| 把半路的工作记忆交给另一个量化档 | Qwen3.8-27B 的两条动态策略对三条静态策略,180 次 NIAH 运行,24GB 显存 8 | 动态策略在 50k 上下文以上与 Q6/f16 的答案一致数高于静态低比特;总耗时 14 小时 26 分 | 图里量的是「答案是否与 Q6/f16 相同」;分叉过的 llama.cpp 分支 |
| 8 卡 H200 买还是租 | 8 卡 HGX H200 整机 32 万到 42 万美元,按需租用 34 家中位 4.40 美元每 GPU 小时 9 | 盈亏平衡:100% 利用率 14.4 个月、60% 24 个月、40% 36 个月 | 只算硬件;电费制冷、折旧、自己的时间与闲置都没进去;作者所在公司卖并托管 GPU 系统 |
把小决策模型放到路由位上
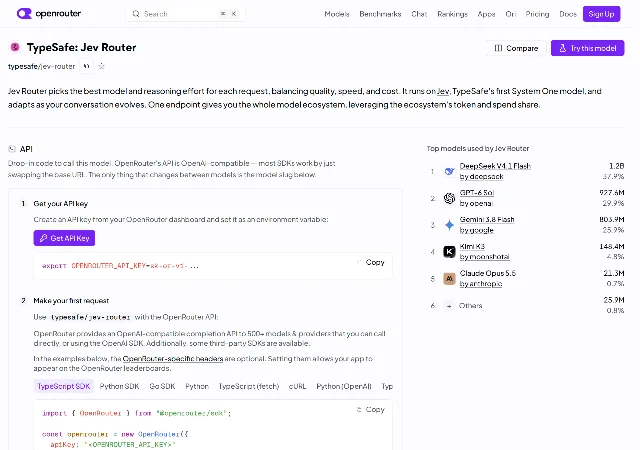
OpenRouter 给 Jev Router 的写法是:它按每个请求挑最合适的模型和推理档位,在质量、速度与成本之间取平衡,运行在 TypeSafe 的 Jev 上,会随对话演进调整;页面标注调用免费、上下文 100 万 token 1。同一个页面的右侧栏还列了它实际把 token 花在哪些模型上,这是官方贴里没说的部分。
该说的争议从缓存开始。换模型会让提示词缓存作废,下一个模型要把整段对话重读一遍;Jev Router 因此把「切过去值不值」也算进决策,另外它能在同一个模型上改推理档位,不必换模型 10。同一篇长评把官方口径写成绝对数:423 道 agent 任务里解决 237 道,Auto 是 130 道,也就是多 82%;他同时指出基准名、每题成本和完整对照当时都还没公开。
Theo 的实测落在这套说法上。他花 1000 美元在 DeepSWE 上跑完,写下的结论是性能大约等于 GPT-6 Astra 的低档,成本略高,耗时接近五倍 2。前一天他只写了四个字:「这是个坏主意」11。另一位开发者的复跑更小:他自制的 jev router 在几个 codex 模型之间切换,结果是更差,而且如果没撞上时间上限会更贵 12。
缓存这条反过来也有代价。长评里引了 Zach Moskow 的四轮对话:路由器先给「法国的首都是哪里」配了便宜模型,遇到数论证明升到高价模型,然后停在上面回答「7×8」和「香蕉是什么颜色」,香蕉那一轮的成本大约是首轮的 140 倍。降档同样要牺牲缓存,这条防止乱切的规则最后变成一个向上的单向棘轮 10。
长评把质疑放在路由器这个位置上,对 Jev 本身给的评价是正面的。它给出的对照是:Banking77 分类上 Jev 81.0%,Claude Opus 5 是 84.4%,而 Jev 大约快 13 倍、便宜 22 倍 10。分类做得住,说明它擅长的是有明确选项的判断;一个路由器要判断的却是「这道题有多难」,而这句话在提示词里往往看不出来。
Loading content card…
一个 4B 决策模型把自己摆上游戏桌
Mica v0.1 4B 做的是 agent 循环里那种小判断:门禁、路由、「该问用户还是直接做」。你给它状态、问题和允许的答案,它返回每个答案的校准概率,支持是非题、2 到 255 个选项的选择题、2 到 10 级的打分题。它从不生成文本,只跑一次预填,然后在答案位置直接读选项标签的 logits。接口跟 TypeSafe 的
/v1/systemone 一致,写给 Jev 的代码可以直接拿它跑 13。做法写得很细:基座是 Qwen3.5-4B,在全部 32 层合并一个 rank-16 的 LoRA,不加新头;约 3.4 万条源决策扩成 77,732 条训练行(约 3,470 万 token),英文与韩文各半,覆盖编码 agent、代码评审、computer use、用户请求、文档、策略规则、日期与数量、路由、状态跟踪、游戏与常识等 12 个领域;全部实验加最终一次训练,花掉不到 30 美元的租用 3090 时间 13。
分数在考场和游戏桌上分成两半。7,328 条 held-out 决策的英文子集上,Jev 1.13 是 74.1、Mica 67.0、JevK5 4B 61.0、Kev 4B 57.0、Qwen3.5-4B 基座用同一套读取方式 55.0;公开集上换一个样子,JevBench hard 111 条是 Mica 69.5、Jev 74.3、JevK5 76.2、Kev 52.4,SemIf 94.4 对 98.4,而 MMLU-Pro 是 53.0 对 82.3 13。模型卡里补了一句:走 JevBench 官方 runner 加 llama.cpp server,hard 档是 64.9,低于 PyTorch 下的 69.5 14。
游戏桌上它反过来。在真实的 Minecraft 1.20.4 服务器里,它用 23 次决策从空背包走到铁镐——原木、木板、工作台、木镐、石头、石镐、熔炉、铁矿、冶炼、铁镐,每次决策约 90 到 150 毫秒,输出 token 为 0;视频右侧那几根条是它对每个候选指令的实际概率 15。俄罗斯方块更直接:和 Kev 4B 用同样的种子、同样的方块顺序玩三局,每回合双方都拿到棋盘和四个候选落点,没有搜索也没有前瞻;三种子下 Mica 清掉 33、97、93 行,Kev 是 27、17、11,Kev 三局都顶死,Mica 在其中两局走完 250 个方块,选到当前最优落点的比例约 75%,Kev 约 50% 3。
作者也把不舒服的地方列了出来。知识题它答不好,MMLU-Pro 53.0 对 Jev 的 82.3;长英文政策文档是它最差的公开集;状态里植入的指令仍然推动答案,提示它选错项时它仍有 69.1% 答对,提示指向正确答案则升到 88.7%;超过 8,192 token 的输入直接返回 HTTP 400,不截断 14。速度那一栏他还主动降了温:Mica 走 GGUF 加 llama.cpp 直接读 logits,中位 47 毫秒(Q4_K_M),而 Kev 4B 的 76 毫秒、JevK5 的 99 毫秒是在各自的 PyTorch 代码里测的,三个 4B 模型同架构,这点差距大半来自服务路径 13。
Loading content card…
同一个端点上的 Jev 与 Kev,短请求贵 12 倍
第三组把这两个模型放进同一个端点,用同一道裁判。评测方搭了一套 362 条的全新题目,特意选在两个模型都上线之后才发布的东西——新的 arXiv 论文、Stack Exchange 问题、GitHub issue,答案取自来源本身,跑完把代码、题和结果一起放上 GitHub 4。
结论是精度上没有分出胜负:每个任务上两者准确率相差 2 分以内,按这个样本量落在噪声里。差别出在另外两栏。Jev 的校准更好,转述检测(PAWS)上 87.0% 对 Kev 的 74.5%。更实用的一条是计费:两边标价相同,但 Jev 每次请求固定多算约 257 个输入 token——直接调 TypeSafe 也是这个数——所以短请求的成本最多贵到 12 倍 4。
这条对写代码的人比对评测的人更有用。按次计费的判断类调用大多很短,257 个 token 的固定开销平摊到短请求上就是十几倍;等到请求变长,这一栏又被摊薄,两边回到同一张价目表。Kev 4B 上车的方式也记一笔:它是 Jared Palmer 用 Qwen3.5-4B-Base 做的 LoRA 适配器加指针头,走同一套
/v1/systemone 契约,输入 0.042 美元每百万 token、输出免费、上下文 8K 16。Loading content card…
177B 的模型挤进 8GB 显存,代价写在速度上
小红书上一位专做小显存的作者把自己那台 8GB 显存、32GB 内存的机器拿来跑 Qwen3.8-Flash-Next:177B 参数、模型文件 72.5GB。他在测试方案里预写了「预加载失败也能测」,结果加载成功——6 token/s,6 项考试 56/60,数学题全对 5。
中间的三处姿势比结果更值得抄。Windows 的虚拟内存上限默认 47GB,模型 72.5GB,他把上限改到 96GB 之后才过;加载方式走
dio 要 113 秒,默认 mmap 是 59 秒,第二次启动 37 秒,差三倍;ngl 开到 8 可以用,加到 20 反而掉到 3.1 token/s 5。他在评论区贴了完整配置:虚拟内存初始 16384MB、最大 98304MB,llama-server -m Qwen3.8-Flash-Next-UD-IQ1_S.gguf --mmproj mmproj-F16.gguf -ngl 8 --ctx-size 8192,并且提前把预期压到 5.7 到 6.1 token/s。他自己把这台机器的用途划了界:6 token/s 不适合聊天,一问一答要等半分钟,适合挂机写长稿、啃长文档、读图核数。评论区有人替他算电费,他的回话是「一个一个的不眠夜,除非断电绝不关机」5。
本地编码模型:一个脚本 bug 值 47 分
公众号「星空知笕」的本地模型实测用九道独立短函数出题:嵌套字典拍平、受限环境改名、深合并字典、解析一行 CSV、渲染 HTML 表格行、双函数协同、迷你模板引擎、合并时间区间,第九道是 18 项检查的综合校验。评分用的是严格交付口径——代码原样执行、不预览、不补依赖、围栏照样扣分、每题独立进程 45 秒超时。机器是 i7-12700H 加 32GB 内存和一块 RTX 3060 Laptop 6GB,跑在 Ollama 0.34.0 上,采样温度 0.2、
num_predict 1536,三个模型严格串行,总耗时 12 分 19 秒 6。第一版榜单上,新上场的 deepseek-coder-v2-lite 只有 25%,九题里八题被判「不可执行」,按原计划要删掉它腾出 10GB。作者顺着这条线查下去,问题在验收脚本自己:撕围栏的代码用的是锚定行首匹配,而这个模型的输出恰好是「前导空格 + ```python」并且换行是 CRLF,两个条件叠在一起,一个围栏都撕不掉。他第一次修得更糟,先去掉每行两端空白再判断围栏,把 Python 的缩进一起剥掉,三个模型全部 0/9;第二次改成只判断、不改原行,缩进完整保留之后真值浮出来:71.9% 6。
差的这 47 个百分点跟模型水平无关。同一批题在宽松口径下三个模型都在 85% 上下,严格口径才把差距拉开;第九道综合题上三个模型是 3 分、1 分、13 分,作者另做了对照实验,给 yi-coder 注入
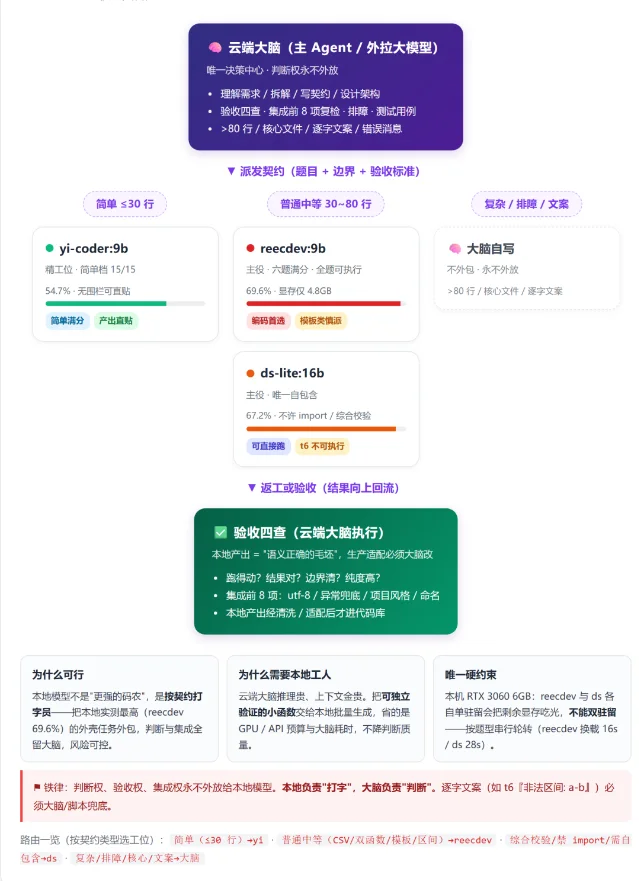
re 之后纯逻辑分是 17/15/13,说明它「会做这道题,只是多交了一行 import」6。第二天他把模型扩到七个,同一个账号给出总榜:reecdev/qwen3.5-lowvram:9b 以 69.6% 排第一,上一期的 deepseek-coder-v2-lite 67.2% 第二,prism-coder:9b 57.4%、yi-coder:9b 54.7%、qwen2.5-coder 47.8%、glm4:9b 43.5%、deepseek-r1:8b 0%(只输出思考不交代码)17。逐题拆开看,总分第一的那份在模板引擎题上拿 5/9,而模板引擎是 ds-lite 最差的一栏(1/9);综合校验题上冠军 17/18,ds-lite 13/18 17。
于是他把总分第一的那个模型排除在最多的活之外,按题型分三个工位:30 行以下的小活给 yi-coder,中等题给冠军,需要自包含、不许引依赖的硬活给 ds-lite,逐字文案和核心判断留在自己手里。硬约束是显存:冠军独驻要 5530MiB,ds-lite 独驻 5418MiB,而可用显存只有约 4646MiB,两个一起上直接爆,只能串行轮转(换载 16 秒和 28 秒)17。
把「想太多」砍掉四成之后
同一个作者前一期跑过 Swift 系列在 27B 上的表现,这一期换成了 Flash-Next 的版本。他把 Swift-1.5-Qwen3.8-Flash-Next(Q5_K_L,带 Q8_0 engrams)和基础的 Qwen3.8-Flash-Next(Unsloth Q5_K_XL,同样 Q8_0 engrams)放在同一套 Aider 题上,两边都在 xhigh 档 7。
质量这一栏两边基本并排:首答通过率 40.2% 对 41.1%,重试后 90.7% 对 86.9%。成本那一栏差得很远:完成 token 的中位数 17,646 对 6,991,每例墙钟 1542 秒对 608 秒,每解出题目的 token 是 24.8K 对 10.5K,well-formed diff 比例 98.1% 对 100% 7。配对的 107 例里,99 例两边结果一致、Swift 赢 2 例、输 6 例,McNemar 精确检验 p≈0.29。
两处细节值得单独记。基础模型最耗 token 的 20 例上,Swift 只用了 29% 的 token 并解出 16 例,基础模型解出 17 例;Swift 单例最多用 44k token,基础模型最多 203k。分语言看,C++ 上 Swift 只用基础模型 29% 的 token,Python 和 JavaScript 约 46%,而它在 C++ 上的 6 次输局里占了 3 次 7。
作者自己给了这份对照的边界:题目是他自建的一套 Aider 案例,两边量化档并不完全相同,而按这个数据规模,5% 的差距才算显著,他看到的差异在 4% 以内 7。同一天还有人贴了 27B 版本的 Swift 1.5,除了「更快了」没有给出任何数字 18。
把半路的工作记忆交给另一个量化档
这条是一个人的周末实验。他读到一篇把不同模型之间的缓存直接融合的论文,于是想问一个更窄的问题:同一个模型的三个量化档之间能不能直接搬 KV 缓存,如果先用高精度档起个头、显存不够时再换成低精度档接手,结果会不会比一开始就用低精度档更好 8。
他把这条思路做成两种排法。第一种用 Q6_K 起手(f16 KV、最大上下文 54,272),中途换成 Q4_K_XL(109,312),再换成 IQ3_S(192,096);第二种在换权重之外还把 KV 从 f16 量化成 q8_0,一路走到 Q4/q8(183,296)。三条静态策略留作对照——IQ3_S、Q4_K_XL、Q6_K 各自从头跑到尾,其中 Q6_K 那档需要超过 24GB 显存 8。
题目是几十道自造的「大海捞针」:让模型读一大段干扰文字,按散在其中的步骤取出一个秘密值。一共 180 次运行,在那块 GPU 上用了 14 小时 26 分。最难受的是 IQ3_S 那条静态策略,重题上经常生成 5 万以上的推理 token,还常常把约 196k 的上下文吃满也没给出答案 8。
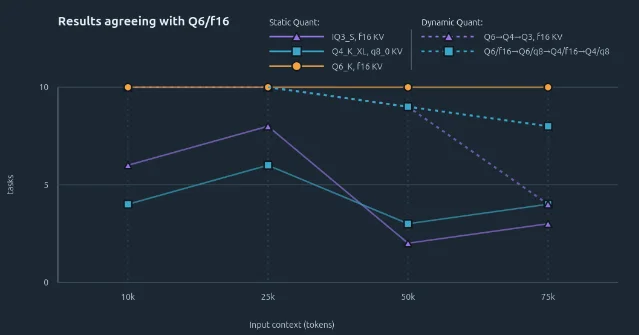
作者也交代了这张图的口径:它量的是逼近高精度参考的程度,与答对与否是两件事;整套东西跑在他自己分叉过的 llama.cpp 上,中途换档用的是他上一帖的热重载方法 8。换句话说,读者能拿走的是「同架构不同量化档之间缓存可以接力」这条结论,以及接一次省下的重算,具体数字换成别的模型就得重测。
Loading content card…
8 卡 H200:买还是租,取决于利用率
最后是一组把账算到桌面上的材料。发帖人为自己公司的决策算了这笔账:一台 8 卡 HGX H200 整机的落地价在 32 万到 42 万美元之间,取 37 万当中间值;租用一侧,34 家供应商的按需 H200 价格中位数约 4.40 美元每 GPU 小时(9 月 18 日),常见的那种 2 到 3 美元更接近竞价价;按整机算就是 35.20 美元每小时 9。
把两边摊平,硬件层面的平衡点是:100% 利用率下 14.4 个月、60% 下 24 个月、40% 下 36 个月。作者的结论分成两半——两年里稳定跑到约 60% 的利用率,自己买划算;低于 40%,租更划算 9。
他在同一段里点了四项没算进去的东西:电费与制冷(他说自己被报的机笼价格超过原预算)、折旧(他的建议是把你估的值减半,因为上一代数据中心卡的二手市场很薄)、自己的时间,以及闲置小时。他还主动说明了身份:他在 B3 Labs 工作,那家公司销售并托管 NVIDIA GPU 系统、也帮机主把闲置算力变现,所以这笔账对他有商业理由,他在帖子里写自己尽量保持假设中立,并反问社区实际看到的利用率是多少 9。
用一个数字之前,先看它是在哪一档上量的
今天这八组给不出一个统一的名次,能带走的是一套动作,三句话够用。
第一句,先问这个数字是在哪一栏里量的。Jev Router 的 423 道里解决 237 道,缺的是成本栏和耗时栏,而补上这两栏的实测把结论翻了过来;KV 缓存移植那张图量的是「与高精度参考答案相同」,答对率是另一栏。
第二句,再问这个东西放在这个位置上合不合适。同一份 Mica 权重,在俄罗斯方块上把对手的 27、17、11 行打到 33、97、93,在 MMLU-Pro 上 53.0 对 82.3。它在有明确选项、能直接读 logits 的场合站得住,换到需要外带知识的判断上就掉了下来。
第三句,最后看把什么交给了谁。本地模型负责打字、判断和验收留在自己手里;半路的工作记忆交给下一个量化档,接一次省下重算;6 token/s 换来一张不用再买的卡;两年 60% 的利用率换来不必租卡。
留一个能自己动手的核对项:拿你手上正在比的那一档配置,只换一处再跑一次。把判断门限提到 0.9 以上看误判率有没有变,或者把量化档只降一级,或者在同一台机器上把
ngl 从 8 调到 20——在一台 8GB 显存的机器上,这一处就是 6 token/s 与 3.1 token/s 的差别。然后把速度、质量和这一趟的账单一起记下来。References
- 1Jev Router - API Pricing & Providers\
openrouter.ai
- 2
- 3
- 4
- 5小红书 跑通为止:Qwen3.8 177B,8GB卡跑通了\
xiaohongshu.com
- 6公众号 星空知笕:最强本地编码模型,花落谁家\
mp.weixin.qq.com
- 7
- 8
- 9
- 10
- 11
- 12X:Kevin Kern 的复跑
x.com
- 13
- 14sky7350/Mica-v0.1-4B 模型卡
huggingface.co
- 15
- 16
- 17公众号 星空知笕:新冠军总分第一,为什么还要三工位分流?
mp.weixin.qq.com
- 18
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.