内存还会跌吗?KV Cache砍掉99%,单卡吞吐飙6倍,港科大、CMU联手岩山科技开源新模型
岩山科技旗下岩芯矩阵与港科大、CMU 等机构开源的 EdgeRock-4B 把每条序列的 KV 缓存固定成 72 MiB,256K 上下文下比源模型少 99.1%,单张 80GB 卡跑 512 路长推理吞吐 6.42 倍,AIME 三年均值 82.9%。

本文转载自微信公众号「量子位」2026 年 10 月 19 日 18:30 推送,作者:允中(发自 凹非寺 量子位 | 公众号 QbitAI)。原文:《内存还会跌吗?KV Cache 砍掉 99%,单卡吞吐飙 6 倍,港科大、CMU 联手岩山科技开源新模型》
谷歌今年的一篇论文说,KV Cache 至少能压缩 6 倍,存储芯片巨头的股价跟着动了一轮1。
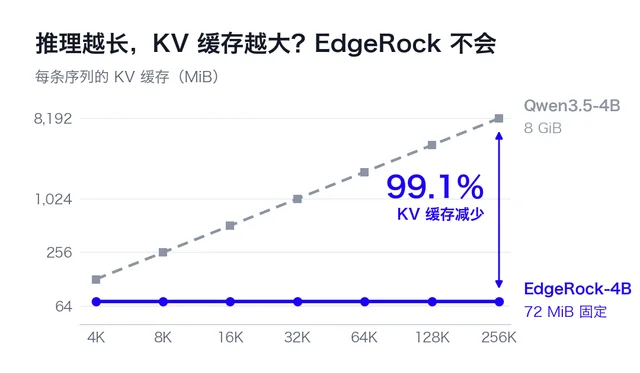
几个月后,有人把这件事推到了另一个量级:上下文从 4K 涨到 256K,KV Cache 的占用一直停在 72 MiB。
这就是岩山科技旗下岩芯矩阵联合港科大、CMU 等机构开源的 EdgeRock-4B,权重与推理代码都已公开2。
在 256K 上下文下,它的注意力 KV 比源模型 Qwen3.5-4B 少 99.1%3。
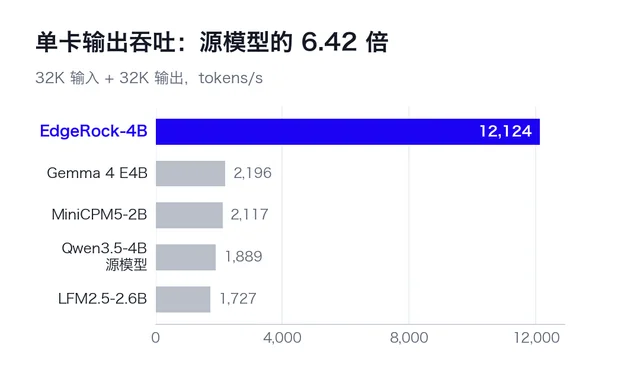
单张 80GB 显卡上,它同时跑 512 路 32K 输入、32K 输出的长推理,输出吞吐 12,124 tokens/s,是 Qwen3.5-4B 的 6.42 倍3。
省下内存的同时,推理分数守住了。AIME 2024–2026 三年平均一次通过率 82.9%,参评的 16 个有界状态模型里最强的 RWKV-7 G1j 13.3B 只有 18.8%4。
论文 10 月 7 日提交到 arXiv,10 月 16 日更新第二版,标题《EdgeRock: Strong Reasoning at Constant Memory》3。
推理越长,为什么越贵
现在多数模型把推理历史存在 KV Cache 里,每生成一个 token 就多存一些4。
以 Qwen3.5-4B 为例,每个 token 新增 32 KiB,跑到 64K,一条序列就是 2 GiB;跑到 256K,就是 8 GiB1。
推理模型动辄想几万 token,Agent 一跑几十轮工具调用,搜索结果、代码和调用记录不断往上下文里塞,缓存跟着一起涨4。
显存被占满,一张卡能同时服务的请求就少;到了端侧,缓存还要和感知、控制模块抢同一块内存4。
业界走了两条路。一条给单个 token 瘦身:多头潜在注意力(MLA)压 KV,KIVI 这类量化方法降精度,谷歌的 TurboQuant 也在这条路上1。
这条路只降低单个 token 的成本,缓存本身照样随推理变长4。
另一条是有界状态模型:循环模型、状态空间模型、滑动窗口模型,内存天生固定3。
它们的短板是留不住后面推理还要用的远处细节,分数随之掉下去3。
真正难的问题于是变成:固定容量的记忆里,怎么留住推理要用的关键细节。
一张卡,512 路长推理
先把测试口径摆清:32K 输入、32K 输出,所有模型跑在单张 Hopper 80GB 显卡上,各自取实测最快的批大小;吞吐只数输出 token,耗时包含预填充5。
| 模型(输出均为 32K) | 4K 输入 | 8K 输入 | 16K 输入 | 32K 输入 |
|---|---|---|---|---|
| EdgeRock-4B | 12,479(批 512) | 12,325(批 512) | 12,330(批 512) | 12,124(批 512)5 |
| Qwen3.5-4B(源模型) | 3,103(批 64) | 2,853(批 64) | 2,472(批 64) | 1,889(批 64)5 |
| Gemma 4 E4B | 3,940(批 128) | 3,432(批 128) | 2,880(批 128) | 2,196(批 64)5 |
| MiniCPM5-2B | 3,152(批 64) | 2,938(批 64) | 2,575(批 32) | 2,117(批 32)5 |
| LFM2.5-2.6B | 1,673(批 64) | 1,771(批 64) | 1,695(批 32) | 1,727(批 64)5 |
差距出在显存的账上。Qwen3.5-4B 跑完 32K 输入加 32K 输出,每条序列的 KV 是 2 GiB,80GB 卡并发几十条就见底1。
EdgeRock-4B 每条序列要保存的全部历史状态是常数 97.76 MiB,长度再长也保持这个数5。
512 条一起跑,含模型权重在内的显存峰值 61.26 GiB4。
换成 Qwen3.5-4B 跑完这 512 条,光是生成结束时的 KV 就要 1 TiB,约等于 13 张 80GB 显卡1。
单条请求也不慢。128K 输入再生成 128K token,EdgeRock 全程稳在 233.7 tokens/s,Qwen3.5-4B 是 151.35。
换成成本的说法:4K 输入时它只用 Qwen3.5-4B 24.9% 的 GPU 时间,32K 输入时 15.6%;四档输入平均,吞吐是 4.94 倍,对 LFM2.5-2.6B 是 7.18 倍1。
固定内存还带来一件容易被忽略的好处:容量能提前算清。推理服务按请求数规划显存,端侧一次分配到位,Agent 的历史内存不随工具调用轮次涨4。
省了内存,推理没降级
恒定内存不稀奇,RNN、Mamba 早把它做成了常数,这次要比的是推理分数1。
团队拉了 16 个有界状态基线,覆盖 GDN、RWKV、Mamba 几条路线,其中三个在 14B 级别1。
AIME 2024–2026 平均一次通过率,EdgeRock-4B 是 82.9%,RWKV-7 G1j 13.3B 为 18.8%,AHN-GDN Qwen2.5 14B 为 11.4%5。
29 项文本基准里它 24 项排第一,等权均值 77.2%,比该指标上最强的 AHN-GDN Qwen2.5 14B 高 23.8 个百分点5。
对源模型,能力保住了大部分。AIME 三年均值是 Qwen3.5-4B 的 96.3%,MATH-500 拿到 97.5%,29 项里有 8 项反超5。
反超的包括 MMLU-Pro(79.8 对 77.7)、SuperGPQA(60.0 对 52.8)、HumanEval(96.7 对 86.0)和 MBPP(87.8 对 71.0)5。
让出去的分数集中在知识题与竞赛级代码:GPQA-Diamond 64.6 对 77.3,LiveCodeBench v6 61.6 对 75.7;中文基准上,C-Eval 74.6 对 84.0,CMMLU 73.3 对 83.95。
六项视觉基准平均 84.9%,保住 Qwen3.5-4B 的 95.3%5。
三段记忆,只记值得记的
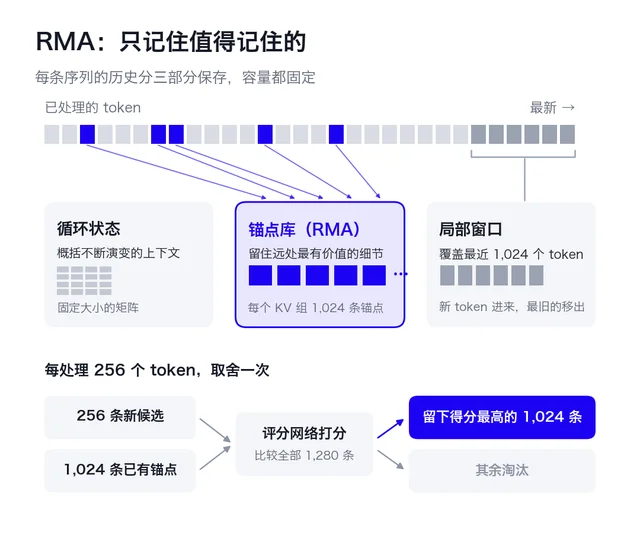
机制叫记忆岩锚(Rock Memory Anchors,RMA),把每条序列的历史切成三份,每份容量都固定4。
循环状态概括不断演变的上下文,抓大意;局部窗口覆盖最近 1,024 个 token,管眼前;锚点库从更早的历史里留住最有价值的细节4。
锚点的取舍是这样:写入器为每个 token 生成一条候选记录,评分网络给它打分。每攒够 256 条,就和库里已有的锚点放在一起比,只留得分最高的 1,024 条,四个 KV 组各算各的5。
留下的锚点彼此独立、内容不变,来源早已滑出局部窗口,后面的推理仍能直接读到4。
架构上做的是改造:24 个 Gated DeltaNet 层保留,8 个全注意力层换成 1,024 窗口的滑动窗口注意力,外加独立的 RMA 模块4。
转换分四阶段:RMA 适配、与骨干联合适配、监督后训练、可验证奖励的强化学习,全程无需从头预训练4。
锚点有没有用,团队做了个直接实验:推理时把 8 个 RMA 模块全部关掉,循环层和局部注意力照常工作1。
在 256 段 16K 到 130K token 的上下文上每段问 4 个问题,共 1,024 题:开着 RMA 答对 964 题,94.1%;关掉只答对 4 题,0.4%5。
四题全对的上下文占 80.1%,四个题型里变量绑定最弱,只有 53.1%5。
开源到哪一步
六位作者分属四家机构:岩芯矩阵(邮箱域名 stonehill-tech.com)、CMU、KAUST 与港科大4。
许可的底子是 Apache 2.0,另加一条补充条款:可商用、可做付费 API 与 SaaS、可微调蒸馏再分发,唯一多出来的限制是不许把权重物理固化进芯片的非可重编程结构6。
发行版本铺得比较全:BF16 原始权重,NF4、INT8、FP8、AWQ、GPTQ、NVFP4 量化版,MLX、GGUF、ONNX,以及 LiteRT 的移动端预览5。
部署有个前提:GGUF 必须配它自带的 RMA 后端,原生 llama.cpp 和 Ollama 跑不了;移动预览的完整长记忆检查与 Android 真机验证还在进行5。
团队说更多参数规模的 EdgeRock 在路上,这套转换方法也能迁到别的混合架构4。
对要连续跑几个小时的机器人,这套机制的现实意义在这里:一边感知环境一边规划动作,历史缓存不能跟着无限膨胀1。
原文里的话
它给长推理带来的一个变化是:推理再长,内存不涨。
每条请求要多少内存,推理开始前就能算清楚。
至于内存还会不会跌,交给市场去回答。
三句都出自量子位原文1。
References
- 1量子位原文
mp.weixin.qq.com
- 2GitHub:rockmatrix-ai/EdgeRock
github.com
- 3arXiv:2610.10118 摘要
arxiv.org
- 4技术报告 §6.1
rockmatrix.ai
- 5模型卡:推理效率
huggingface.co
- 6EdgeRock Model License 1.0
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.