Ripple-65B 放出:65B 稠密模型在 Terminal-Bench 2.1 拿 80.52,权重 Apache 2.0,官方推理脚本默认只开 16K
Ricursive 放出 65B 稠密模型 Ripple-65B Preview:Terminal-Bench 2.1 得 80.52,压过 501B 到 975B 的美国开放权重模型,权重 Apache 2.0,API 每百万 token 输入 $0.20、输出 $0.60,但官方推理脚本默认只开 16K 上下文。

北京时间 11 月 4 日上午 10 点 41 分,Hugging Face 上的
ricursiveAI/Ripple-65B-Preview 收到第一次提交。1一分钟后,16 个权重分片跟着传了上去,仓库合计 129.6 GB。2
对外公告晚了将近 16 小时:11 月 5 日凌晨 2 点 24 分,官方账号才发出发布帖。3
再过 39 分钟,OpenRouter 上出现这条模型,标价每百万 token 输入 0.20 美元、输出 0.60 美元。4
发布它的是 Ricursive Intelligence,一家做芯片设计的 AI 公司。Ripple 是它内部设计平台所用模型的通用版。5
三件事值得先看。它是 65B 的全激活稠密模型,权重是 Apache 2.0;官方拿 Terminal-Bench 2.1 的 80.52 说自己刷新了美国开放权重的纪录;但官方自己给的推理脚本,默认只开 16K 上下文。67
快速核对
| 项目 | 情况 |
|---|---|
| 模型 | Ripple-65B Preview,65B 稠密 Transformer,Ricursive 第一个对外模型 5 |
| 时点 | 权重仓 11 月 4 日 10:41 建仓;公告帖 11 月 5 日 02:24;OpenRouter 上架 03:03(均为北京时间)134 |
| 参数 | 64.8B,80 层,d_model 5120,80 个注意力头配 8 个 KV 头,词表 100,352 28 |
| 训练 | 12T token 预训练,序列长度 8K;中训 200B token、长上下文 6.5B token、SFT 183B token、RL 700 步 6 |
| 上下文 | 官方口径最高 1M;位置编码上限 2,097,152;官方推理脚本默认 16K 678 |
| 模态 | 文本输入、文本输出 4 |
| 可用范围 | 权重可下载;GMI Cloud 与 OpenRouter 已上线;Together 页面写「即将上线」;Fireworks 尚无条目 910 |
| 权重 | BF16 指令版 129.6 GB、NVFP4 实验版 57.2 GB、BF16 基础版 129.6 GB、DFlash2 草稿模型 8.1 GB 21112 |
| 许可证 | Apache 2.0 13 |
| 价格 | 输入 $0.20、输出 $0.60、缓存读 $0.05(每百万 token),GMI 与 OpenRouter 同价 49 |
| 基准 | Terminal-Bench 2.1 得 80.5,自报与统一复跑同分 6 |
| 第三方 | Artificial Analysis 与 Vals 都还没有条目 1415 |
| 时效窗口 | 权重与 API 现在就能用;正式版、技术报告、系统卡都没有时间表 |
80.52 分,跟谁比
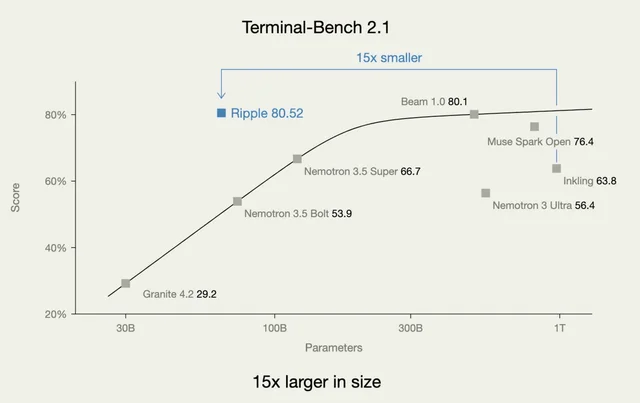
官方对照表里只有四个模型,全是美国的开放权重模型:Reflection Beam 501B、Meta Muse Spark Open 816B、Thinking Machines Inkling 975B、NVIDIA Nemotron 3 Ultra 550B。6
最小的对手 501B,最大的 975B。Ripple 是 65B,还全是激活参数。6
所以「全球开放权重第一」现在无从核实,能站住的只有官方那句「美国开放权重」。
同口径复跑:差距变大了
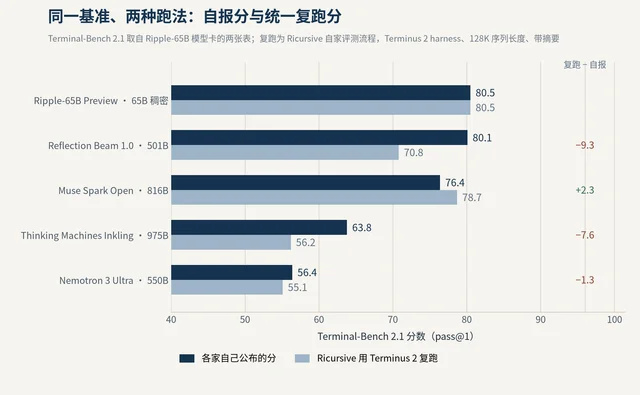
模型卡做了件少见的事:不只贴各家自报的分,还用统一流程把四个对手重跑了一遍。6
流程是 Terminus 2 harness、128K 序列长度、带摘要。6
结果是 Beam 从 80.1 掉到 70.8,Inkling 从 63.8 掉到 56.2,Nemotron 从 56.4 掉到 55.1。6
Muse Spark Open 反而升了,从 76.4 到 78.7。Ripple 两列都是 80.5。6
换成统一流程后,它和第二名的差距从 0.4 分变成 1.8 分,第二名换成 Muse Spark Open。6
但「第一」只在一个基准上成立。模型卡那张表共 22 行分数,Ripple 拿第一的是 3 行。6
三行里两行是 Terminal-Bench 2.1 的两种跑法,另一行是 SWE-bench Pro v2.0 Hard,79.1 对 76.5。6
其余多半归 816B 的 Muse Spark Open:DeepSWE 1.1 是 60.0 对 44.3,MCP Atlas 是 89.2 对 71.67。6
在 SWE-bench Verified 上它 76.5,输给 Beam 的 81.6;长上下文 AA-LCR 是 75.0,输给 Muse 的 80.7。6
对手大它 7.7 到 15 倍,输掉多数行不奇怪。把 80.52 当成「全面第一」会看错,当成「小模型在终端任务上追平」才准。6
3200 万美元与 16 倍
官方给的训练账是 3200 万美元,含从零开始的全部研发。这笔钱覆盖预训练阶梯、数据配比、评测、合成数据与后训练配方,加最后一次正式训练。5
这是自估数,不是审计过的账单;对比对象是「上一个开放权重 SOTA 的训练成本」,不是任何一家的财报。5
技术侧的数更硬一点:在 4B 规模上,同样的代码能力最多只要 Olmo 3 阶梯的 1/16 算力。6
到正式训练那一版,官方说这个倍率涨到 55 倍。6
后训练只用了 140 万次 rollout,官方称约为 Beam 的 1/70。5
预训练与后训练全程 MFU 40%,没有自定义 kernel,也没做量化,团队从 1 人长到 5 人。6
为什么不做 MoE
官方说这是刻意选择:稠密结构降低训练与推理的工程复杂度,代价是每个 token 都要过全部 65B 参数。5
形状被压成「窄而深」:d_model 5120,80 层;注意力头给到 80 个,KV 头只有 8 个。8
80 层里每 5 层有 1 层全注意力,其余是 1024 token 的滑动窗。8
全注意力层不用旋转位置编码,也就是 global NoPE;另外加了门控注意力、value residual 与 FFN 激活裁剪。8
这些选择直接影响显存。BF16 权重 129.6 GB,摊在 16 个分片里。2
官方的 NVFP4 版是 57.2 GB,不到一半:它只把 MLP 压到 4 位,注意力仍留在 BF16。11
速度的官方数是 250 token/s:两台 B200、batch=8、量化和自定义 kernel 之前。6
现在能怎么用
DFlash2 是投机解码用的草稿——先用小模型猜 16 个 token,再让主模型校验;它自己 4.04B。12
基础版不是今天才有的:它的权重在 10 月 16 日就传过一批,比公告早三周。16
API 侧只有第三方,官方没有自己的推理服务。5
GMI Cloud 已经上线:输入 $0.20、输出 $0.60、缓存读 $0.05,控制台写 1M 上下文。9
OpenRouter 也是同一个供应商、同一组价格,但上下文写 16,384,最大输出 14,745。4
价格在这一档算低。DeepSeek-V4.1-Flash-1017 的官方价是峰值输入 $0.30、输出 $1.20。17
官方博客写「Fireworks 今天晚些时候上线」。11 月 5 日凌晨查它模型库,还没有这条。5
OpenRouter 上只有一个端点。11 月 5 日凌晨 5 点 45 分读这个接口时,它近 30 分钟成功率 31.6%,近 5 分钟为 0。4
自建:官方脚本默认 16K
官方没给 vLLM 配方,也没有 SGLang cookbook 条目,只在仓库里放了四个文件。7
跑法是 SGLang 0.5.19、CUDA 13、一台机器两张 B200、张量并行 2。7
默认值写得很直白:BF16 权重与 KV 缓存、16 个草稿 token、16K 上下文。7
想开更长要自己改。DFlash2 草稿只在 16K 的行上训过,草稿窗口不能小于 16K。7
社区刚跟上:11 月 5 日凌晨 5 点 11 分,有人建了 GGUF 仓。18
该不该试
做选型:Terminal-Bench 2.1 与 SWE-bench Pro v2.0 Hard 算它的强项。SWE-bench Verified、DeepSWE 1.1、MCP Atlas 算弱项,拿自己的任务各跑一遍再定。6
关注「开放权重追不追得上闭源」:这个模型的意思在 65B 稠密加 12T token 这个位置,不在它的单项分。6
还没有的数字
技术报告没有,仓库里只有模型卡。6
系统卡没有。安全只有三项自测:FORTRESS 对抗 83.8、FORTRESS 良性 95.5、StrongREJECT 97.5。6
中文能力没测。语料以英文和代码为主,指令版那 22 行评测里没有一项中文基准;基础版表里只有 C-Eval 69.6。6
算力明细没给:只有 12T token 与 40% MFU,没写用了多少卡、多少天。6
正式版没时间表。官方自己说这次后训练「相对轻」,重点放在 agentic coding。6
References
- 1Hugging Face:ricursiveAI/Ripple-65B-Preview 提交记录
huggingface.co
- 2Hugging Face 模型 API:ricursiveAI/Ripple-65B-Preview
huggingface.co
- 3
- 4OpenRouter:ricursiveai/ripple-65b-preview 端点信息
openrouter.ai
- 5Ricursive:Introducing Ripple-65B Preview
ricursive.com
- 6Hugging Face:Ripple-65B Preview 模型卡
huggingface.co
- 7Hugging Face:Ripple-65B Preview 官方推理脚本说明
huggingface.co
- 8config.json:Ripple-65B Preview
huggingface.co
- 9GMI Cloud:Ripple-65B-Preview
console.gmicloud.ai
- 10Together AI:Ripple-65B Preview
together.ai
- 11Hugging Face:Ripple-65B-Preview-NVFP4
huggingface.co
- 12Hugging Face:Ripple-65B-Preview-DFlash2
huggingface.co
- 13Ripple-65B Preview 许可证
huggingface.co
- 14Artificial Analysis:LLM 榜单
artificialanalysis.ai
- 15Vals:Vals Index
vals.ai
- 16Hugging Face:ricursiveAI/Ripple-65B-Base-Preview
huggingface.co
- 17DeepSeek:Models & Pricing
api-docs.deepseek.com
- 18Hugging Face 搜索:Ripple-65B
huggingface.co
- 19Artificial Analysis:Ripple 模型页(尚未建档)
artificialanalysis.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.