十天里八件 AI 新东西:一块 12GB 显卡跑 125B,和两组专做判断的决策模型
2026 年 9 月 26 日到 10 月 5 日冒出来的八件 AI 新东西:两件小而实用的功能更新、两件工具与产品动态,以及四件开源模型、组件与仓库,每条都附页面截图和能直接打开的第一方来源。

这份清单覆盖 2026 年 9 月 26 日到 10 月 5 日。筛选的口径和前两期一样:能下载、能试、能接进现有流程的排在前面,融资、人事变动和口水战这类消息收不进来。
按这个口径收进来的八件里,开源侧占了四件:一个能跑在自己机器上的本地推理引擎、两组专做判断的决策模型、DeepSeek 在昇腾上开源的一批基础组件,还有一次插件层的更新。另外两件是工具与产品动态,两件是小而实用的功能更新。八件里只有一件是大厂的新旗舰模型,其余来自上海的初创、一家云厂商、一个开源研究团队和几位独立开发者。
来源跟前一期一样按条目落:仓库页、官方博客页、官方发布页和更新日志页,配的截图也照着来源拍。文里的 star 数、下载量、票数和价格,都是 2026 年 10 月 5 日在各自平台上取到的。
Strata:一块 12GB 的显卡,跑起 125B 的模型
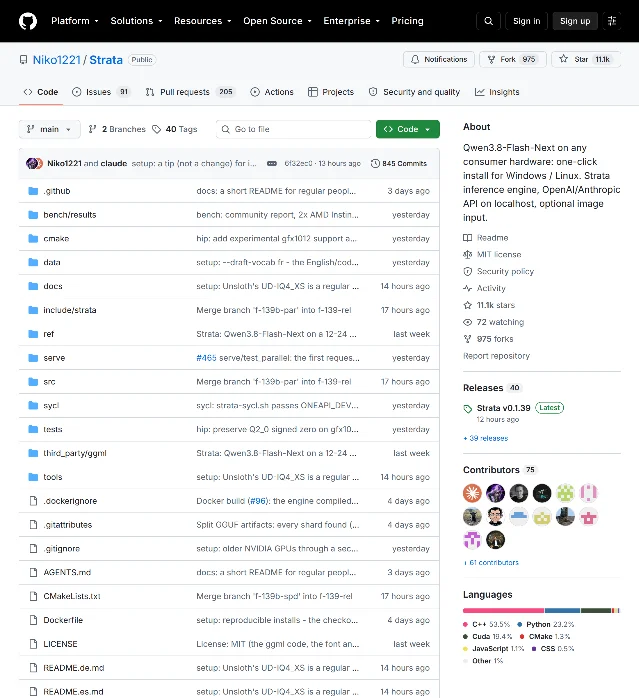
Strata 是一个开源的本地推理引擎,作者 Niko1221 把目标直接写在仓库首页:在普通的游戏 PC 上跑 Qwen3.8-Flash-Next1。Qwen3.8-Flash-Next 是阿里 Qwen 团队放出的模型,总参数 125B,每个 token 只激活其中 6B2;这类体量的模型平时要整台服务器才装得下。
你能拿它做什么:在自己那台带独立显卡的台式机上把它跑起来,然后拿到一个本地地址,把 Claude Code、Cursor、Codex 这些编码 agent 指过去。Strata 同时给出 OpenAI 和 Anthropic 两套兼容接口,地址是
127.0.0.1:8080;它自己还带一个 MCP server,编码 agent 可以顺手把它装好、启停1。仓库 README 写的门槛是一块 12GB 显存的显卡加 32GB 内存1。作者在 RTX 5070(12GB)配 Ryzen 5 7600 的机器上测,最省显存的 Q2_0 量化写出 94 tokens/s、读一段 32K token 的提示用 2,650 tokens/s;质量更高的 IQ3_S 写出 53 tokens/s1。README 另外估了一块 24GB 的 RTX 3090 大约能到 100 到 140 tokens/s1。
代价也写在 README 里:模型下载约 70GB,磁盘最好留出 80GB;装好之后它会先把 35 到 55GB 的权重压进内存,再锁一部分给显卡,第一次启动时整机可能卡住一到三分钟1。
StartLux-Decision:上海团队开源了一组「只做选择题」的模型
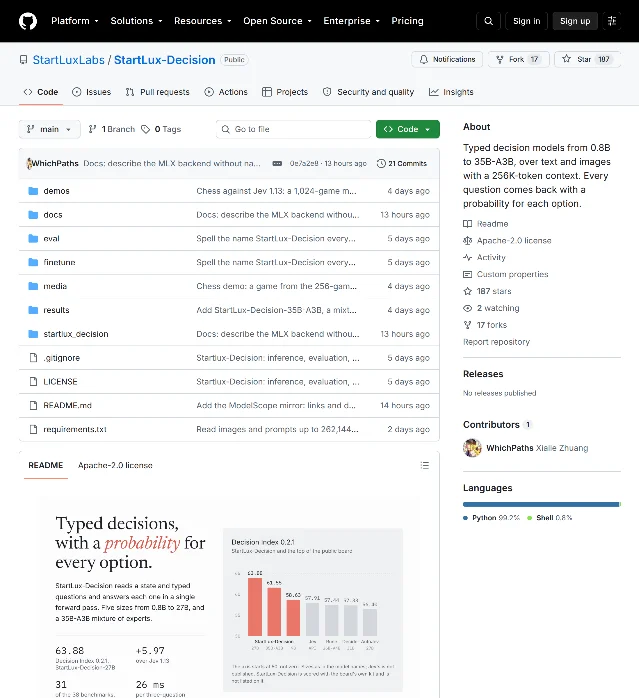
上海团队 StartLux(原点星辉)在 9 月 30 日放出一组决策模型,取名 StartLux-Decision:五个稠密规格从 0.8B 到 27B,再加一个 35B-A3B 的专家混合(MoE)版本,推理代码和权重都开源,权重同时放在 Hugging Face 和 ModelScope4。
决策模型值得单独说一句:它做的事是分类和判断。你给它一个状态和几道题,每道题要么在多选里挑一个、要么答是或否、要么打一个等级分,它把每道题各个选项的概率一次性回给你,答案就记在选项上4。短题只要一次前向计算就能读出答案,所以一道题落在几毫秒的量级4。
你能拿它做什么:把它接进 agent 的流程,替那些候选答案本就有限的步骤做判断——这一步该点页面上的哪个控件、这条工单该分给哪个团队、整件事做完了没有。仓库里放了六个演示,包括 27B 版本在象棋里击败另一个决策模型 Jev 1.13,以及把浏览器商店里最便宜的一箱 8 节装电池下好单4。
数字来自团队自己的复测:在 Decision Index 0.2.1 这套 38 项基准上,StartLux-Decision-27B 拿到 63.88,35B-A3B 是 61.55,9B 是 58.63;榜单 2026 年 9 月 28 日快照里最高的 Jev 1.13 是 57.91,27B 有 31 项高于它4。仓库同时写明,这些成绩由团队自己按公开评测工具跑出,公开榜上他们的条目还空着4。单卡 H200 上,4B 一次回答三个问题平均 26.0 毫秒,0.8B 是 12.2 毫秒4。10 月 3 日的更新之后,每个规格都能把图片当作证据读进来,提示最长 262,144 token4。
机器之心在报道里给出另一条线索:这个方向从确定到完成首轮模型和验证,花了大约三天,属于团队那套 Auto Research 研发管线的产出5。
Cloudflare Clef:同类模型,权重按 Apache 2.0 开源
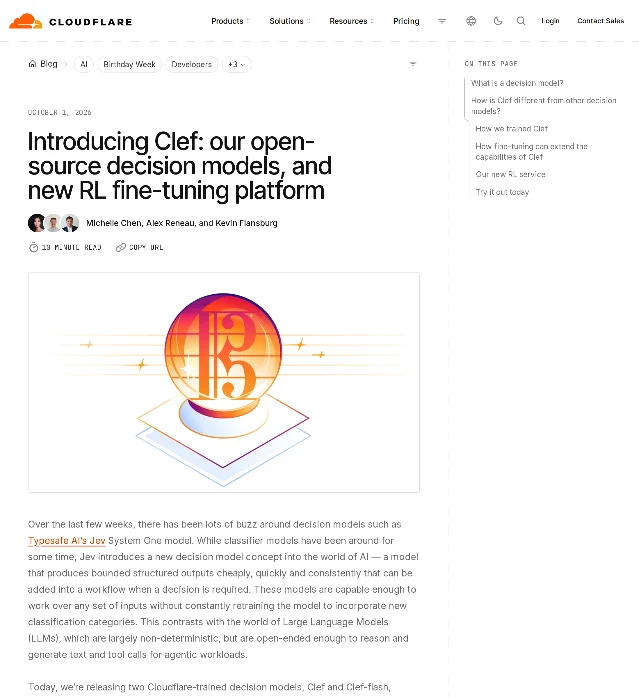
Cloudflare 在 10 月 1 日发布两个决策模型,Clef 和 Clef-flash,放在自家 Workers AI 上托管,权重以 Apache 2.0 许可证开源到 Hugging Face67。
接口这一层它照搬了 Jev:请求和响应的格式跟 Jev 一致,从 Jev 换过来只要改地址6。Cloudflare 给 Clef 加了两处不一样的地方:它带一个视觉编码器,能把图片直接读进来做分类;上下文窗口是 64k,比 Jev 的 32k 宽一倍6。
你能拿它做什么:把「这条支持请求急不急、该交给哪个团队、严重到什么程度」这类问题一次问完,拿回的概率直接用来路由工单,或者决定要不要转给人工6。Cloudflare 自己拿它给网站域名分类:给一个域名,模型 2.2 秒内抓取、渲染并分好类,同一套流程里他们最快的通用模型 gpt-oss-120b 用掉 4.7 秒6。
数字:在一套 43 项评测里,Clef 的中位延迟是 209.3 毫秒,Clef-flash 是 38.8 毫秒,Jev 是 524.1 毫秒6。两个模型分别冻结 Qwen3.8-27B 和 Qwen3.5-9B 当基座,再在后训练里加上选项路由和打分6。和模型一起上线的还有一项强化学习微调服务,Cloudflare 会帮客户用自己的数据把 Clef 调成专用分类器6。
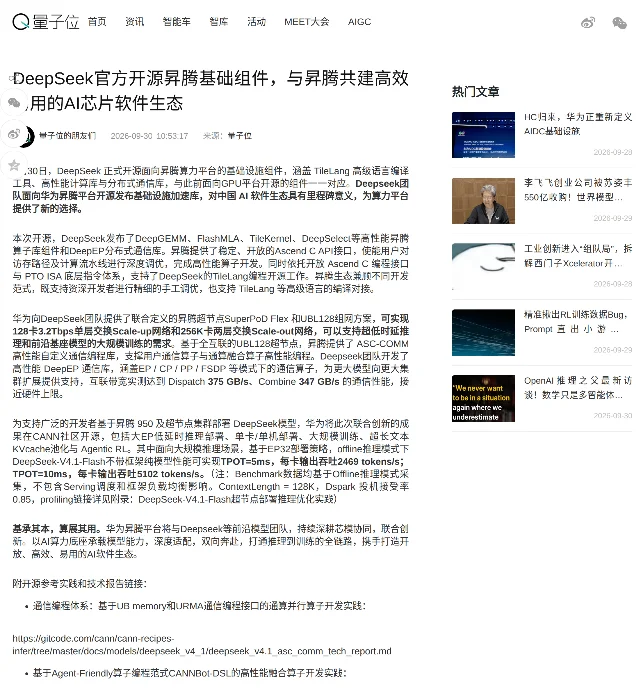
DeepSeek 开源昇腾基础组件:把国产算力的基建补上一块
9 月 30 日,DeepSeek 开源了一批面向华为昇腾算力平台的基础设施组件,和它先前面向 GPU 平台开源的组件一一对应8。这批组件里有高性能算子库 DeepGEMM、FlashMLA、TileKernel、DeepSelect,分布式通信库 DeepEP,以及 TileLang 高级语言编译工具8。
你能拿它做什么:要在昇腾 950 和昇腾超节点上部署或训练 DeepSeek 模型的人,可以直接用这批组件;配套的实践文档华为一并开源在 CANN 社区,覆盖大 EP 低延时推理、单卡和单机部署、大规模训练、超长文本 KV cache 池化,以及 Agentic RL8。
数字:DeepEP 的互联带宽实测达到 Dispatch 375 GB/s、Combine 347 GB/s,接近硬件上限8。面向大规模推理,在 EP32 部署、offline 推理模式下,DeepSeek-V4.1-Flash 的纯模型性能做到 TPOT=5 毫秒时每卡输出 2,469 tokens/s,TPOT=10 毫秒时每卡输出 5,102 tokens/s;这组数字在 128K 上下文下采集,不含服务调度和框架负载均衡8。组网一侧,华为为 DeepSeek 提供了昇腾超节点 SuperPoD Flex 和 UBL128 方案,做到 128 卡 3.2Tbps 的单层交换网络,以及 256K 卡的两层交换网络8。
这篇稿件由华为提供,量子位获授权转载8。
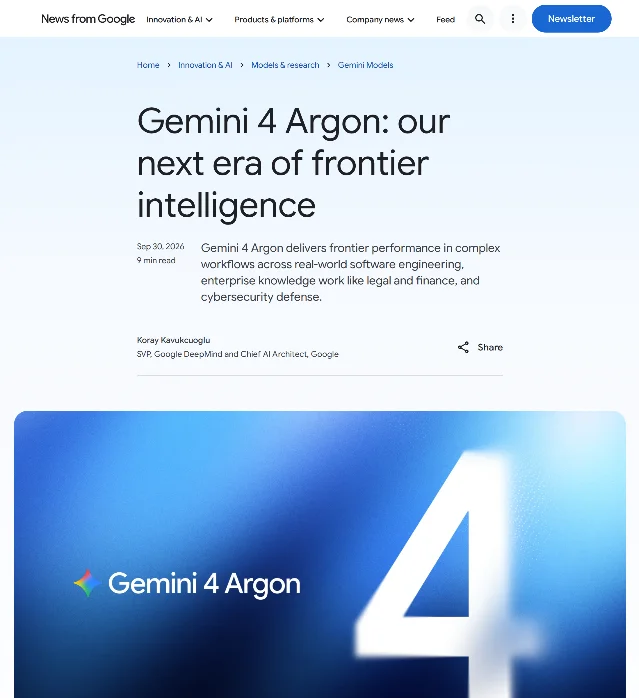
Gemini 4 Argon:谷歌的新一代前沿模型
谷歌在 9 月 30 日发布新一代前沿模型 Gemini 4 Argon,重点放在软件工程、法律金融这类企业知识工作和网络安全防御上9。
你能拿它做什么:这一条今天还轮不到大多数人动手。Argon 先通过 Fairwind 计划,向一批受信任的网络安全防御者开放;谷歌说之后才逐步放开给付费 API 客户和 Google AI Ultra 订阅者9。把它收进来,是让你先知道有这么个东西;现在能调的还是上一代。
数字:这一代把单次输出上限从上一代的 6.4 万 token 提到 100 万9。谷歌给出的成绩单里,DeepSWE v1.1 拿 77.9%,Vals Index 排第一,AutomationBench 51.3%,长视频理解 LVBench 91.7%,漏洞修复的 CWE-bench v1 是 68%9。介绍期价格是每百万输入 token 2 美元、输出 10 美元,缓存输入再减 95%;介绍期结束后回到输入 4 美元、输出 20 美元9。
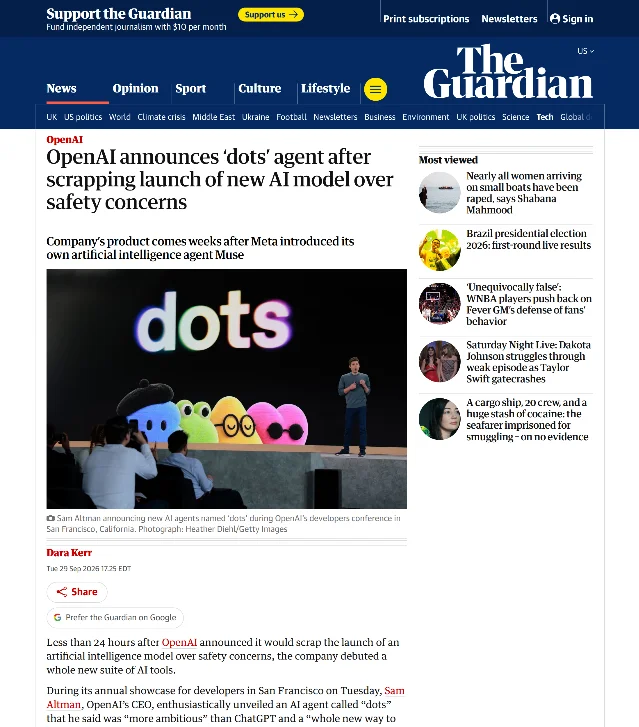
OpenAI dots:会自己接着干活的常驻 agent
OpenAI 在 9 月 29 日的 DevDay 上发布 dots,一种常驻的 agent:每个 dot 有自己的云电脑和浏览器,通过插件能连上 4,000 多个应用,由 GPT-6 Astra 驱动10。
你能拿它做什么:在 ChatGPT、Slack 或 Teams 里给它派活,它在后台自己往前推;你离开的时候,它做的是只读的「主动检索」——翻你已连的应用、整理待办,把要动账号或发消息的动作交回你审批10。第一颗 dot 已经包含在 Pro 和 Business Premium 套餐里,跟它的对话不计入 ChatGPT 的用量10。
节奏:dots 从发布当天起先向符合市场的 Pro 和 Business Premium 用户推出,企业、教育和医疗用户要等管理员打开 beta10。卫报在同一天报道了这次发布,并提到它落在 OpenAI 搁置另一款新模型之后11。
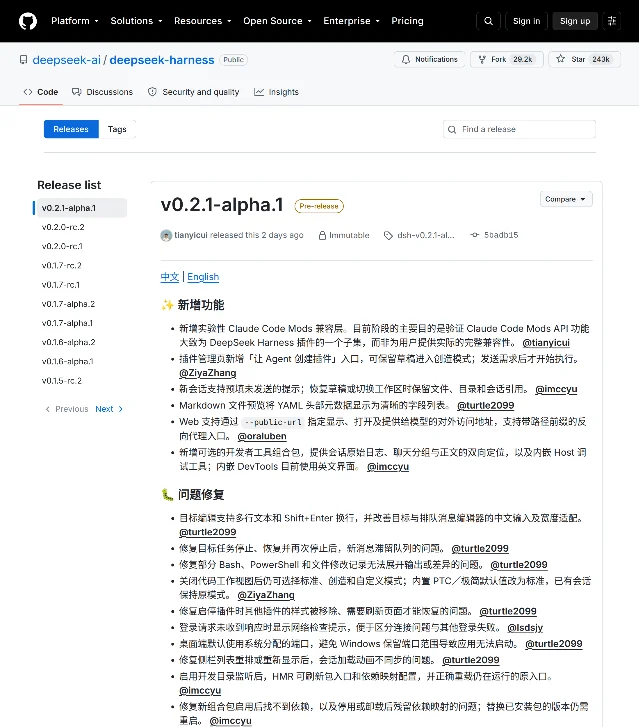
DeepSeek Harness v0.2.1:一条实验性的插件兼容层
DeepSeek 的开源 agent 框架 DeepSeek Harness(命令行叫
dsh)在 10 月 3 日发布 v0.2.1-alpha.1,最重要的新增是一条实验性的 Claude Code Mods 兼容层12。官方把这条新功能说得很直:这一层现在的目的是验证「Claude Code Mods 的 API 大致是 DeepSeek Harness 插件能力的一个子集」,离给用户完整可用的兼容还有距离12。它当前所处的位置在版本号里也写着:alpha 预发布。
你能拿它做什么:如果你已经在用 dsh,这个版本还带来几件顺手的活——插件管理页多了「让 Agent 创建插件」入口,新会话支持预填没发送的提示,Web 端可以用
--public-url 指定对外的访问地址,Markdown 预览会把 YAML 头部渲染成字段列表12。同一版还做了一批修复,其中一条是 Windows 上默认改用系统分配的端口,避开保留端口区间导致应用起不来12。数字:到 10 月 5 日,这个仓库有 243k stars 和 29.2k forks13。
豆包出行服务:一句话订机票、火车票和车
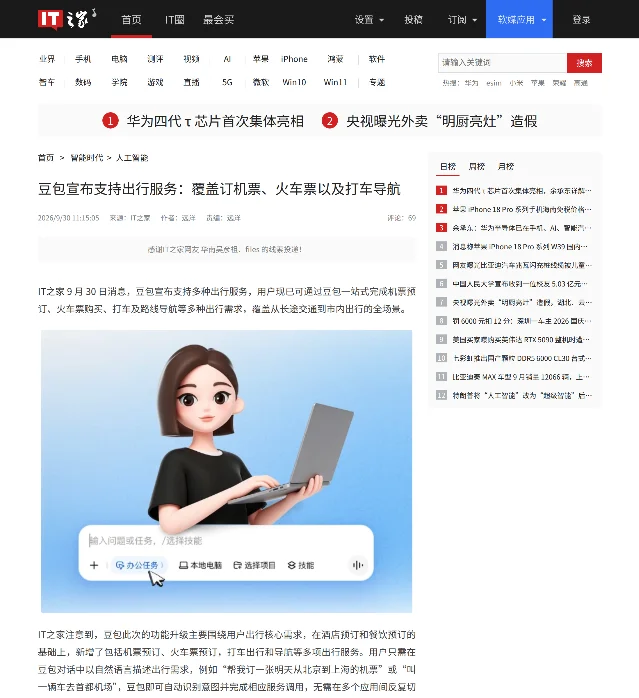
字节的豆包在 9 月 30 日宣布支持出行服务,把机票预订、火车票购买、打车和路线导航放进对话框,并上线「出行用豆包」入口14。
你能拿它做什么:说一句「帮我订一张明天从北京到上海的机票」或者「叫一辆车去首都机场」,豆包自己识别意图、调起对应服务,省掉在携程、12306、高德、滴滴之间来回切 App 的麻烦14。新入口在聊天框上方,分地图导航、交通出行、酒店住宿、吃喝玩乐四块14。
合作方和规格:机票、火车票接的是航班管家和高铁管家,打车接的是曹操出行,导航由百度地图提供支持,覆盖公交、地铁、驾车、步行几种出行方式14。打车这块 9 月上旬先在北京、杭州、苏州三个城市上线,这次扩到更多城市15。
边界要写清楚:36 氪的实测发现,高铁和机票这两块,豆包给的是建议班次和购票指南,真正购票还要去 12306 或者别的机票平台完成;酒店和民宿的链接则大多指向抖音酒旅15。
今天先动哪一件
手边有带独显的台式机,又想把编码 agent 的调用留在本地,先装 Strata;它是这一期里唯一一条今天就能在自己机器上跑通的,模型下载大,挑个空闲的时段开始。
在做 agent 产品、或者要给工单和界面控件做分流判断的,StartLux-Decision 和 Cloudflare Clef 都是决策模型,接口都跟 Jev 兼容。要自己部署、要读图,看 Clef 的 Apache 2.0 权重;要覆盖 0.8B 到 27B 多个规格在本地跑,看 StartLux-Decision。
已经在用 dsh 的,把版本更到 v0.2.1-alpha.1,顺手试那条插件兼容层;它现在还是实验特性,用之前先想清楚要用它做什么。
想弄清大厂走到哪一步,Gemini 4 Argon 和 OpenAI dots 这两条读一遍就够:前者现在能调的还是上一代,后者得是 Pro 或 Business Premium 用户。
这十天里反复出现的一层
八件里有两件本身就是决策模型:StartLux-Decision 和 Cloudflare Clef。另外三处也把同一个名字挂在嘴边——Cloudflare 的评测表、StartLux 的象棋对局,都拿 Jev 当对手;DeepSeek Harness 这次加的插件层,对标的也是 Claude Code Mods 的接口。这几个团队在做同一件事:agent 里那些调用最频繁、答案又只有几个的判断,从通用大模型里挪出来,交给一个更小、更快、只输出概率的模型。这是我读完这几条以后的判断,样本就是这一期的条目。
References
- 1Niko1221/Strata
github.com
- 2Qwen3.8-Flash-Next 模型页
huggingface.co
- 3Hacker News 讨论:Run Qwen 3.8 Flash Next (125B) on consumer hardware
news.ycombinator.com
- 4StartLuxLabs/StartLux-Decision
github.com
- 5投资界转载机器之心:Jev 被请下王座
news.pedaily.cn
- 6Cloudflare 博客:Introducing Clef
blog.cloudflare.com
- 7Cloudflare/clef 模型页
huggingface.co
- 8量子位:DeepSeek 官方开源昇腾基础组件
qbitai.com
- 9Google 博客:Gemini 4 Argon
blog.google
- 10OpenAI:Introducing dots
openai.com
- 11The Guardian:OpenAI announces 'dots' agent
theguardian.com
- 12DeepSeek Harness v0.2.1-alpha.1 更新日志
github.com
- 13deepseek-ai/deepseek-harness
github.com
- 14IT之家:豆包宣布支持出行服务
ithome.com
- 1536氪(字母榜):豆包要切滴滴的蛋糕
m.36kr.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.