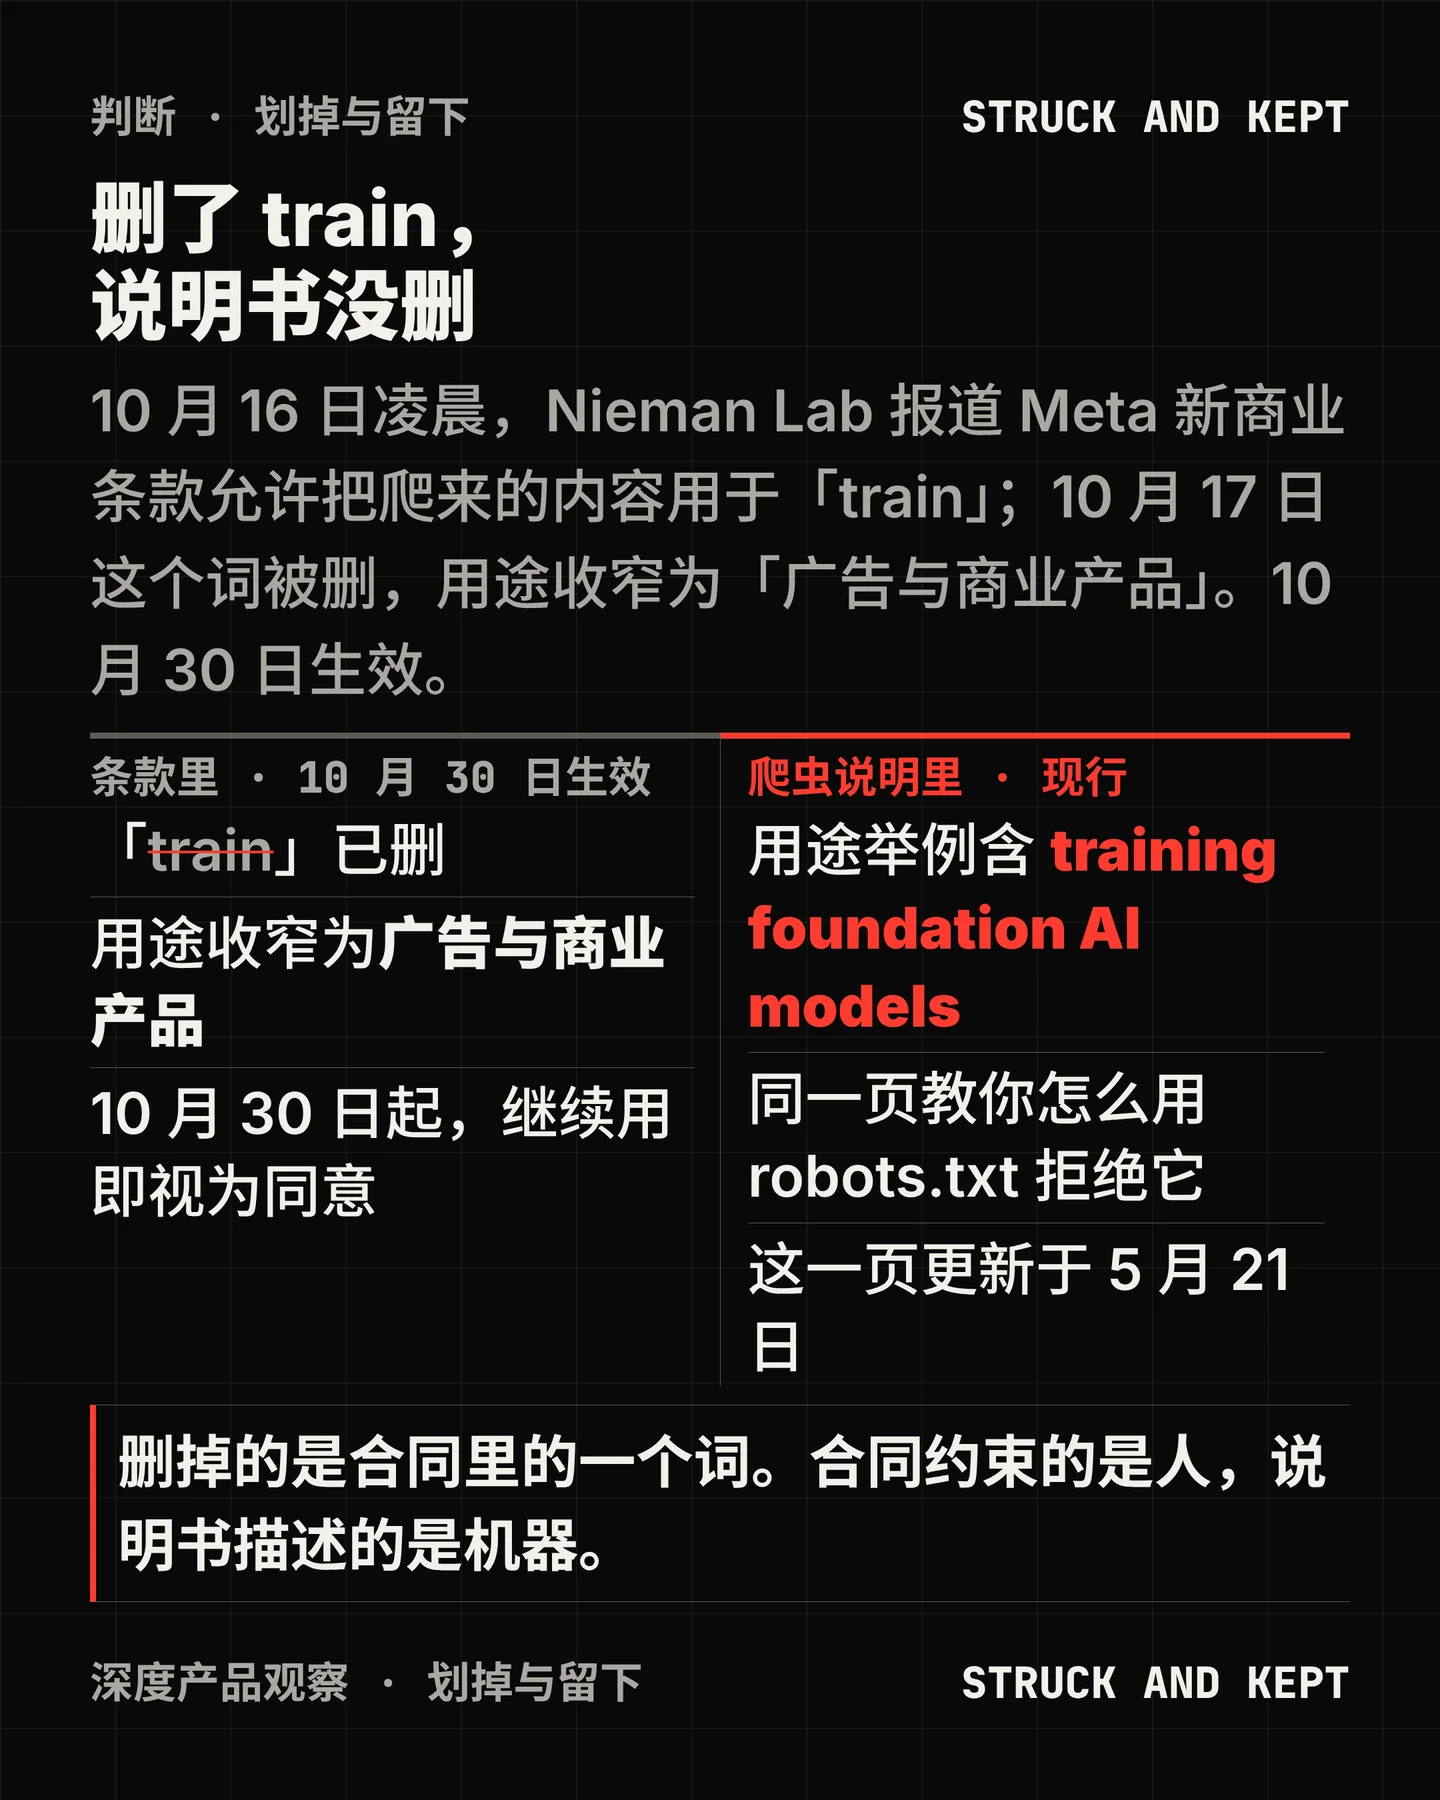

10 月 16 日凌晨,Nieman Lab 报道了一件当时没多少人注意到的事:Meta 更新后的商业条款里有一段授权它用爬虫抓取商业账户关联的网站,并写明抓来的内容可以用来「train」1。当晚 22 时 28 分,Meta 通讯副总裁 Andy Stone 在 X 上回复一条聚合帖:「This is false. There's no change to how Meta uses web crawlers.」2。第二天,那段话被改掉了:train 消失,用途收窄成「广告与商业产品」34。
生效日是 10 月 30 日5,还有十二天。改后的文本值得读;但更值得读的是它没改的那几句,以及它旁边一份没有被改的文件。
一、这个词的来路
线索不是媒体找到的。10 月 2 日,独立出版人 Stephen Beale 在 Meta Business Suite 里看到条款更新通知,读完后在 r/facebook 发了帖,把那段话整段贴出;帖子的时间戳是 10 月 4 日凌晨(北京时间)6。那条帖到 10 月 18 日是 2 分、13 条评论。十二天后,Nieman Lab 的 Andrew Deck 与 Hanaa' Tameez 请三位法律专家读了同一段话,10 月 16 日 0 时 59 分(以下均为北京时间)发稿1。Hacker News 上的转载帖在 16 日 7 时 37 分出现,到 10 月 18 日上午是 466 分、169 条评论7。
接下来的四十八小时可以按小时排。
10 月 16 日 22 时 28 分,Stone 发出那条否认。他说的原话是:抓取方式没有变化,内容方一直可以用 robots.txt 表达偏好,这次更新是为了在站内广告与内容推荐里取到第三方网站上的商品信息,「not about scraping news sites」2。
一个多小时之后,10 月 17 日 0 时 20 分的网页存档里,预览页还是旧版,train 还在3。
到 10 月 17 日 11 时 19 分,同一个地址已经换成了新版,train 不见了4。17 日的四张存档(含这一张)与今天的页面逐字一致。也就是说,改动作发生在 17 日 0 时 20 分之后、11 时 19 分之前,前后不到十一小时;网页本身没有版本号,也没有「最后更新」这一行,能确定的时间边界只有这两张存档。
换句话说,否认在前,改词在后。
二、改掉的与没改的
先看旧版那一段。它是两句3。
第一句是授权:Meta 可以用自动软件,包括爬虫、机器人、蜘蛛、用户代理,并可以「create test credentials」,去访问、索引、缓存、分析、收集、取回或抓取「与你的产品或服务相关的域名、网页或 URL」以及通过它们可取到的任何内容,并定期从这些地址拉更新。
第二句是用途:Meta 可以把这些内容用于「provide, develop, improve, research, train, and maintain the integrity of, the Meta Company Products, services, and features」,也就是全部 Meta 公司产品、服务与功能。
新版把两句并成了一句。用途从句被搬进了授权句里:Meta 可以抓,抓来「in order to provide, develop, improve, research, and maintain advertising and business products」——为了提供、开发、改进、研究和维护「广告与商业产品」;后面还挂着一整个括号,说明这类产品包括帮你投放广告与商业内容、向用户介绍你的产品与服务、把你和可能感兴趣的用户连起来。结尾那句从「maintain the integrity of」变成了「maintain the integrity and security of」8。
三处变化:train 删了;用途的范围从「全部 Meta 产品、服务与功能」收窄到「广告与商业产品」;原本单独的用途句并入了授权句,于是「为了什么」从「内容怎么用」变成了「授权到哪」——这是这次改动里唯一一处真正意义上的收窄。
没变的是三样。
对象没变。新旧两版的授权句逐字相同:「the domains, web pages, or URLs (and any content available through them) that are associated with your products or services, or that is made available through your or users' use of Meta Company Products and services」。两张存档的正文指纹不同,但这一句一字不差34。
动词没变。develop(开发)还在。这一条是后面所有争议的支点。
三、「business products」有定义吗
Matt Topic 是 Loevy & Loevy 的媒体与知识产权律师。他读完改后版本说:新版本仍然允许 Meta 把抓来的内容用于开发任何「business product」,「That doesn't seem to be a defined term, and presumably Meta is developing AI business products. I think 'develop' is broad enough to include 'train.'」9
这个判断可以核。把 Meta 的相关文件逐一检索,结果是这样的:
商业条款预览版里「business product」出现三次,三次都是「使用」而不是「定义」——一次在开头的适用范围(「using any business product, such as Ads Manager or Meta Business Suite」),一次就在这条授权句里,一次在 Meta AI 商业助理条款的说明里8。通用服务条款(2025 年 1 月 1 日生效)里一次都没有10。现行的商业条款里没有11,自助广告条款里也没有19;商务工具条款、数据处理条款与广告标准同样没有。
唯一接近定义的是 Meta 自己那张产品清单:「Business products, such as ads, Meta Business Tools and Meta Business Suite」——注意它用的是「such as」,是举例,不是封闭清单;而且同一页把「AI at Meta」单列为另一类产品12。
于是争议的落点很清楚:如果「广告与商业产品」不包含「AI at Meta」,那么把抓来的内容拿去训练一个用于广告排序的基础模型,算不算「开发广告与商业产品」?条款没有回答,Meta 也没有在公开表态里回答。Stone 给的说法比条款窄得多:他说这次更新是为了取第三方网站上的「商品信息」,用于站内推荐2。发言人 Daniel Roberts 对 The Verge 的说法也窄:「the crawling terms we consolidated only applied to our ads and business products」13。
一个词的用途,在条款里写得比在发言人嘴里宽,这是这一期最该被记住的一处落差。
四、机器那一边没有被改
Meta 自己有一页爬虫说明,页面上写着「Updated: May 21, 2026」。那一页对 Meta-ExternalAgent 的描述是:「The Meta-ExternalAgent crawler crawls the web for use cases such as training foundation AI models or improving products by indexing content directly.」14
合同里删掉了 train,爬虫的说明书里还留着 training。这两句话并不矛盾:合同说的是 Meta 可以拿这些内容做什么,说明书说的是这个爬虫出去干什么。但一份被用来证明「已经收窄」的文件,必须和另一份一起读;否则读者拿到的只是半个事实。
同一页还写着两件对内容方更实际的事。第一,拒绝的方法是往 robots.txt 里加 disallow,文档给了 meta-externalagent 与 meta-externalads 两个例子,并说改动最长 24 小时生效。第二,有两处官方写明的例外:Meta-ExternalFetcher 因为执行的是用户请求的抓取,可以绕过 robots.txt;FacebookExternalHit 在做安全或完整性检查时也可以绕过14。
robots.txt 到底管不管用,有实测。2024 年的一篇论文自建站点、主动向各家的爬虫提交地址、检查它们是否遵守 robots.txt,测试持续两个月。结论是:Amazonbot、Applebot、CCBot、ClaudeBot、GPTBot 遵守;Meta-ExternalAgent 有延迟——在被 disallow 的情况下仍先抓了内容,之后才遵守;Bytespider 读 robots.txt 但不遵守。论文的表格里,Meta-ExternalAgent 的「claims to respect robots.txt」一栏是空的15。
这不是说 Meta 不遵守协议,而是说:内容方手里那根唯一的杠杆,官方自己写了两个例外,第三方实测里还出现过延迟。
规模上,Meta-ExternalAgent 不是小角色。Cloudflare 在 2026 年 3 月抽样解析了 4,047 份 robots.txt,其中 3.82% 的「针对 AI 爬虫的 disallow 规则」里出现了 meta-externalagent,排在 GPTBot(5.52%)、CCBot(5.08%)、ClaudeBot(4.88%)与 Google-Extended(4.44%)之后;这个 token 从未出现在任何一条 allow 规则里。TollBit 的另一组统计是:欧洲 15% 的 AI 抓取请求触达了被 disallow 的地址——它把「任何对被禁路径的请求」都算作越界,不区分是哪一家16。这两组数不是合规实测,只能说明两件事:屏蔽它的站点在变多,而被屏蔽的地址仍会被请求。
五、「没有新权利」这句话,要看对谁说
被并进来的是两份:商品目录条款并进商业条款,广告创意生成式 AI 条款并进自助广告条款5。
广告创意生成式 AI 条款(2024 年 5 月 6 日生效)里,抓取写在这一段:Meta 可以用自动软件去「access, index, cache, analyze, or crawl the domains, webpages or URLs provided by you」——对象是「你提供的 URL」,用途是「for your use in connection with your ads」或者这些条款里写明的目的17。
商品目录条款(2015 年最后修订)写得更窄:你提供一个 URL,Meta 才可以定期从那个 URL 拉更新,用来更新你的商品目录18。
还有一份没被点名、但更重要的:现行的自助广告条款,2025 年 8 月 22 日生效。它写着「By placing an Order, you grant us the right to access, index, cache, analyze or crawl the content available through your domains, webpages or URLs ... for developing and improving advertising and other business-related products and related uses, research and training」19。
这句话很关键。它说明:对投放广告的人来说,抓取权与「research and training」2025 年 8 月就已经在条款里了,代价是「下广告单」。10 月 17 日删掉 train,对这群人是一次文本上的收窄。
而现行的商业条款——也就是约束每一个把 Meta 产品用于商业目的的账户的那一份——全文没有抓取条款11。10 月 30 日之后,这条授权第一次写进这份文件,跟着「继续使用」一起生效,不再要求你下过广告单。
所以「没有新权利」这句话,对投放广告的人大体成立(除了 create test credentials 这个词,三份旧条款里都没有,Ars Technica 也独立核到了这一点20);对只管理 Page、群组、商品目录或应用、不投放广告的账户,它是新的。
受影响的正是后一群人里的绝大多数。条款对「商业或经营目的」的定义宽到几乎无法回避:投放广告或营销消息、售卖或上架商品、开发应用、创建或使用商品目录、管理 Page、为商业目的管理群组、使用任何商业产品(例如 Ads Manager 或 Meta Business Suite)、使用测量服务——「regardless of the entity type」8。一家媒体、一家餐厅、一个独立开发者,只要有一个商业账户,就落在里面。
六、不同意的人能做什么
条款给的出路只有一句:「If you do not agree to the updated terms, you may stop all access or use of our Products for business or commercial purposes.」8 没有单独点击同意的窗口,也没有在 10 月 30 日之前退出的选项;继续使用就是同意9。
条款之外还有三层,每一层管的不是同一件事。
爬虫层。 在自家域名放 robots.txt,拒绝 meta-externalagent。这是唯一直接作用在抓取上的技术动作,官方说最长 24 小时生效,并写明两处例外(见上一节)。这一层由你单方面决定,不需要 Meta 同意。
对象层。 条款的授权对象是「与你的产品或服务相关的域名、网页或 URL」,以及「通过你或用户使用 Meta 产品与服务而取得的」内容。前者要求你先知道自己名下有哪些域名被算作「与产品相关」——子品牌、门店页、商品站都在内;后者更宽,它把你在 Meta 产品里放出去的链接也纳入了。
第三方层。 商业条款要求你保证代你操作的第三方——投放代理、管理 Page 的服务商——遵守同一套条款,并声明你有权约束他们8。这一条可以写进你自己的委托合同,但它约束的是你和代理,不是 Meta。
账号层。 不同意,就停止一切商业用途。这是唯一的、真正的退出。
威斯康星大学法学院的 Benjamin Sobel 给这件事起了个 antitrust 的名字:搭售。「If you want to use the Meta products that require acceptance of the commercial terms, you have to also acquiesce to the scraping and crawling permissions exacted in those terms.」9 这句话解释了这个结构为什么难拒绝:要留在 Facebook、Instagram、WhatsApp 上做生意,就得同时接受一条与做生意无关的授权。Meta 的说法是:这条授权本来就只覆盖广告与商业产品,这次只是把它写清楚13。两种说法对应的是同一份文本,差别在于你把「使用商业账户」和「投放广告」看成是不是同一件事。
欧洲与英国还有一条 GDPR 的反对权,但它覆盖的是「与你的账号关联的个人信息」,不是你的网站内容;Meta 的说明页写得很清楚,它只能处理「linked to a Meta account or stored in a way that allows Meta to identify which information relates to a particular person」的信息21。网站主想就「我的站被爬」提反对,这条路径不适用。
七、反应面
三家新闻业组织在两天内表态。美国的 News/Media Alliance 总裁 Danielle Coffey 称这份条款「outrageous and probably illegal」,并说「It cannot be allowed to be implemented on October 30.」22。英国 News Media Association 的 Theo Bamber 称其为「shameless landgrab attempt」「the worst kind of arrogant tech platform bullying」23。欧洲出版商理事会表示将致函欧盟委员会,要求审查这些条款在版权、合同公平与市场力量滥用上的问题9。
还有一层背景让出版业更难接受这件事。Nieman Lab 在同一天的报道里提到,Meta 9 月上线了付费订阅 Meta One,其中一项是限制部分账号在 Facebook 与 Instagram 上可发布的外链数量——不订阅就少发链接。于是出现了一个顺序:先向你收发布链接的钱,再取得免费抓取这些链接指向的内容的授权1。Meta 拒答了关于这项订阅服务的问题。
技术媒体的反应分了两种。Ars Technica 自己去比对了新旧条款,指出「streamlining」这个词掩盖了新语言与新授权20。The Verge 在 10 月 17 日跟进了「删词」这一步13。The Register 在 10 月 17 日凌晨的稿子里引的还是旧版,并引了圣克拉拉大学法学院的 Eric Goldman24。
中文侧从 10 月 16 日傍晚开始出现转述,到 10 月 18 日已有十余篇,全部没有自有采访:专家意见来自 Nieman Lab,删词的消息来自 The Verge 或 Ars Technica。其中一篇把生效日写成「11 月 3 日」,与 Meta 官方和所有英文报道都不符。
八、还没定的事
Meta 没有回答「create test credentials 是否会绕过付费墙」,也没有说明这些凭据在什么场景下使用9。
Meta 是否真的在用这些内容训练基础模型,没有公开材料能证明;能证明的只有两点:条款的旧版写过 train,爬虫的说明书今天还写着 training。
「AI at Meta」算不算「广告与商业产品」,条款没有定义,Meta 的公开表态也没有回答。这是整条授权里最宽的一个口子。
还有一个细节值得记下来:Nieman Lab 引用的退出句写作「please stop all access or use」,而 Meta 的三个版本——改版前、改版后、现行——原文都是「you may stop」89。一个词的转述偏差,说明这类争议里最该做的动作,是把原文调出来自己读一遍。
(以上查证截至北京时间 10 月 18 日 19 时。)
References
- 1
- 2Andy Stone · X
x.com
- 3Meta Commercial Terms 预览页 · Wayback 2026-10-16
web.archive.org
- 4Meta Commercial Terms 预览页 · Wayback 2026-10-17
web.archive.org
- 5
- 6
- 7HN item 50111852
hn.algolia.com
- 8Meta Commercial Terms 预览页
facebook.com
- 9
- 10Meta Terms of Service
facebook.com
- 11Meta Commercial Terms(现行)
facebook.com
- 12What are the Meta Products
facebook.com
- 13
- 14Web Crawlers · Meta for Developers
developers.facebook.com
- 15
- 16
- 17Ad Creative Generative AI Terms
facebook.com
- 18Product Catalog Terms
facebook.com
- 19Self-Serve Ad Terms(现行)
facebook.com
- 20
- 21
- 22Changes to Meta Commercial Terms of Use · News/Media Alliance
newsmediaalliance.org
- 23
- 24
Comments